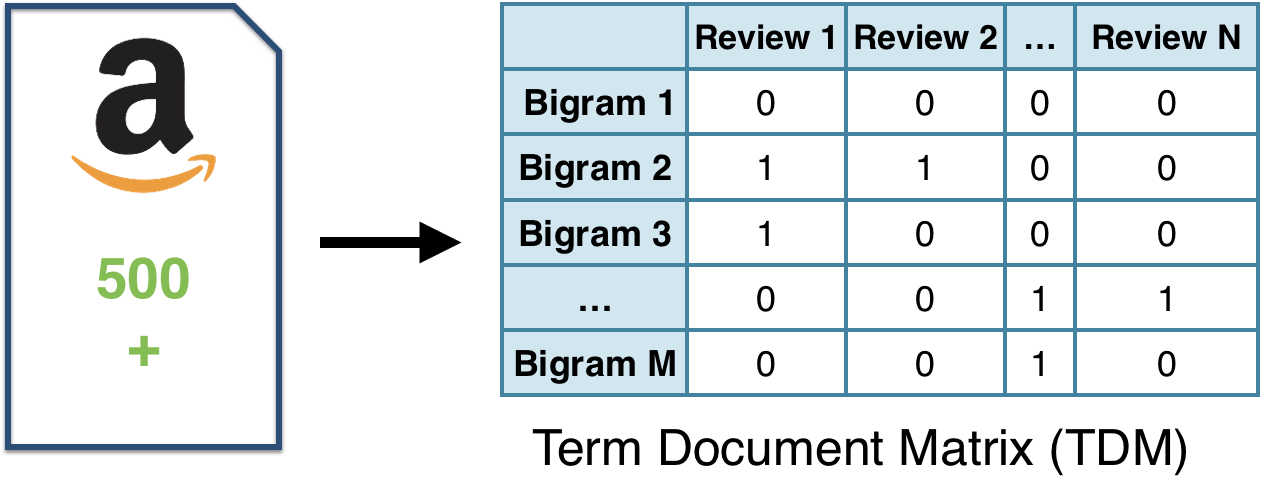
Étapes 4 et 5 : extraction et analyse des caractéristiques

Extraction de texte avec sac de mots en R

Ted Kwartler

Instructor

Extraction des caractéristiques

# Créer une TDM de bigrammes
amzn_p_tdm <- TermDocumentMatrix(
  amzn_pros_corp, 
   control = list(tokenize = tokenizer)
)

Extraction des caractéristiques

Extraction de texte avec sac de mots en R

Obtenir les fréquences des termes

# Convertir la TDM en matrice
amzn_p_m <- as.matrix(amzn_p_tdm)

# Calculer les fréquences des termes amzn_p_freq <- rowSums(amzn_p_m)
# Trier par fréquence décroissante term_frequency <- sort(amzn_p_freq, decreasing = TRUE)
# Afficher les 5 bigrammes les plus fréquents term_frequency[1:5]
      good pay great benefits   smart people 
            25             24             20 
    place work     fast paced 
            17             16
Extraction de texte avec sac de mots en R

Créer des visuels avec plotrix

# Repérer les mots communs
common_words <- subset(all_tdm_m, all_tdm_m[, 1] > 0 & all_tdm_m[, 2] > 0)
difference <- abs(common_words[, 1] - common_words[, 2])
common_words <- cbind(common_words, difference)
common_words <- common_words[order(common_words[, 3], decreasing = TRUE), ]

# Créer une trame de données : 15 principaux mots top15_df <- data.frame(x = common_words[1:15, 1], y = common_words[1:15, 2], labels = rownames(common_words[1:15, ]))
# Générer un diagramme en pyramide pyramid.plot(top15_df$x, top15_df$y, labels = top15_df$labels, gap = 12, main = "Mots en commun", unit = NULL, top.labels = c("Amzn", "Mots négatifs", "Google"))
Extraction de texte avec sac de mots en R

Passons à la pratique !

Extraction de texte avec sac de mots en R

Preparing Video For Download...