Microsoft Fabric में Data Ingestion और Semantic Models
Fiodar Sazanavets
Senior Software Engineer


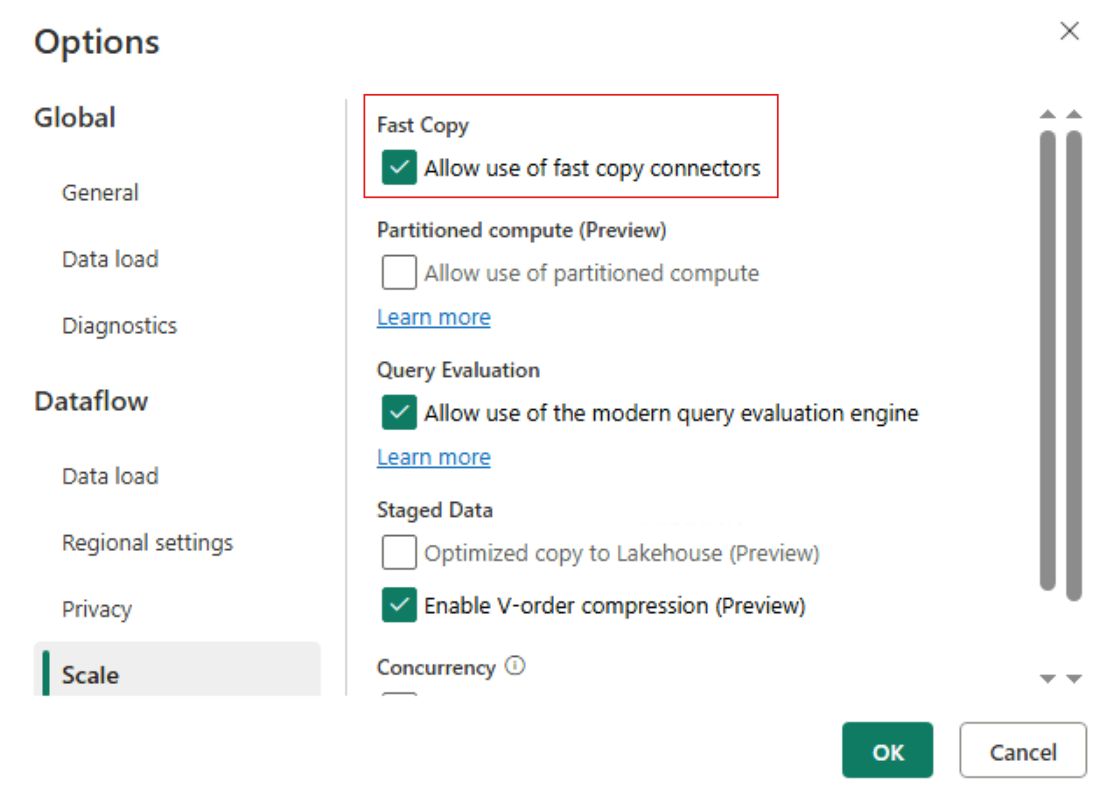
| शर्त | Fast Copy को चाहिए |
|---|---|
| क्षमता | Fabric capacity |
| कनेक्टर | Supported, जैसे Lakehouse, SQL, Snowflake, ADLS Gen2 |
| ट्रांसफॉर्मेशन | केवल compatible स्टेप; Group by या merge को referencing क्वेरी में शिफ्ट करें |
| साइज | डिफॉल्ट से 100 MB+ फाइलें या 5M+ रोज़ |
| डेस्टिनेशन | केवल Lakehouse |


| कारण | उपाय |
|---|---|
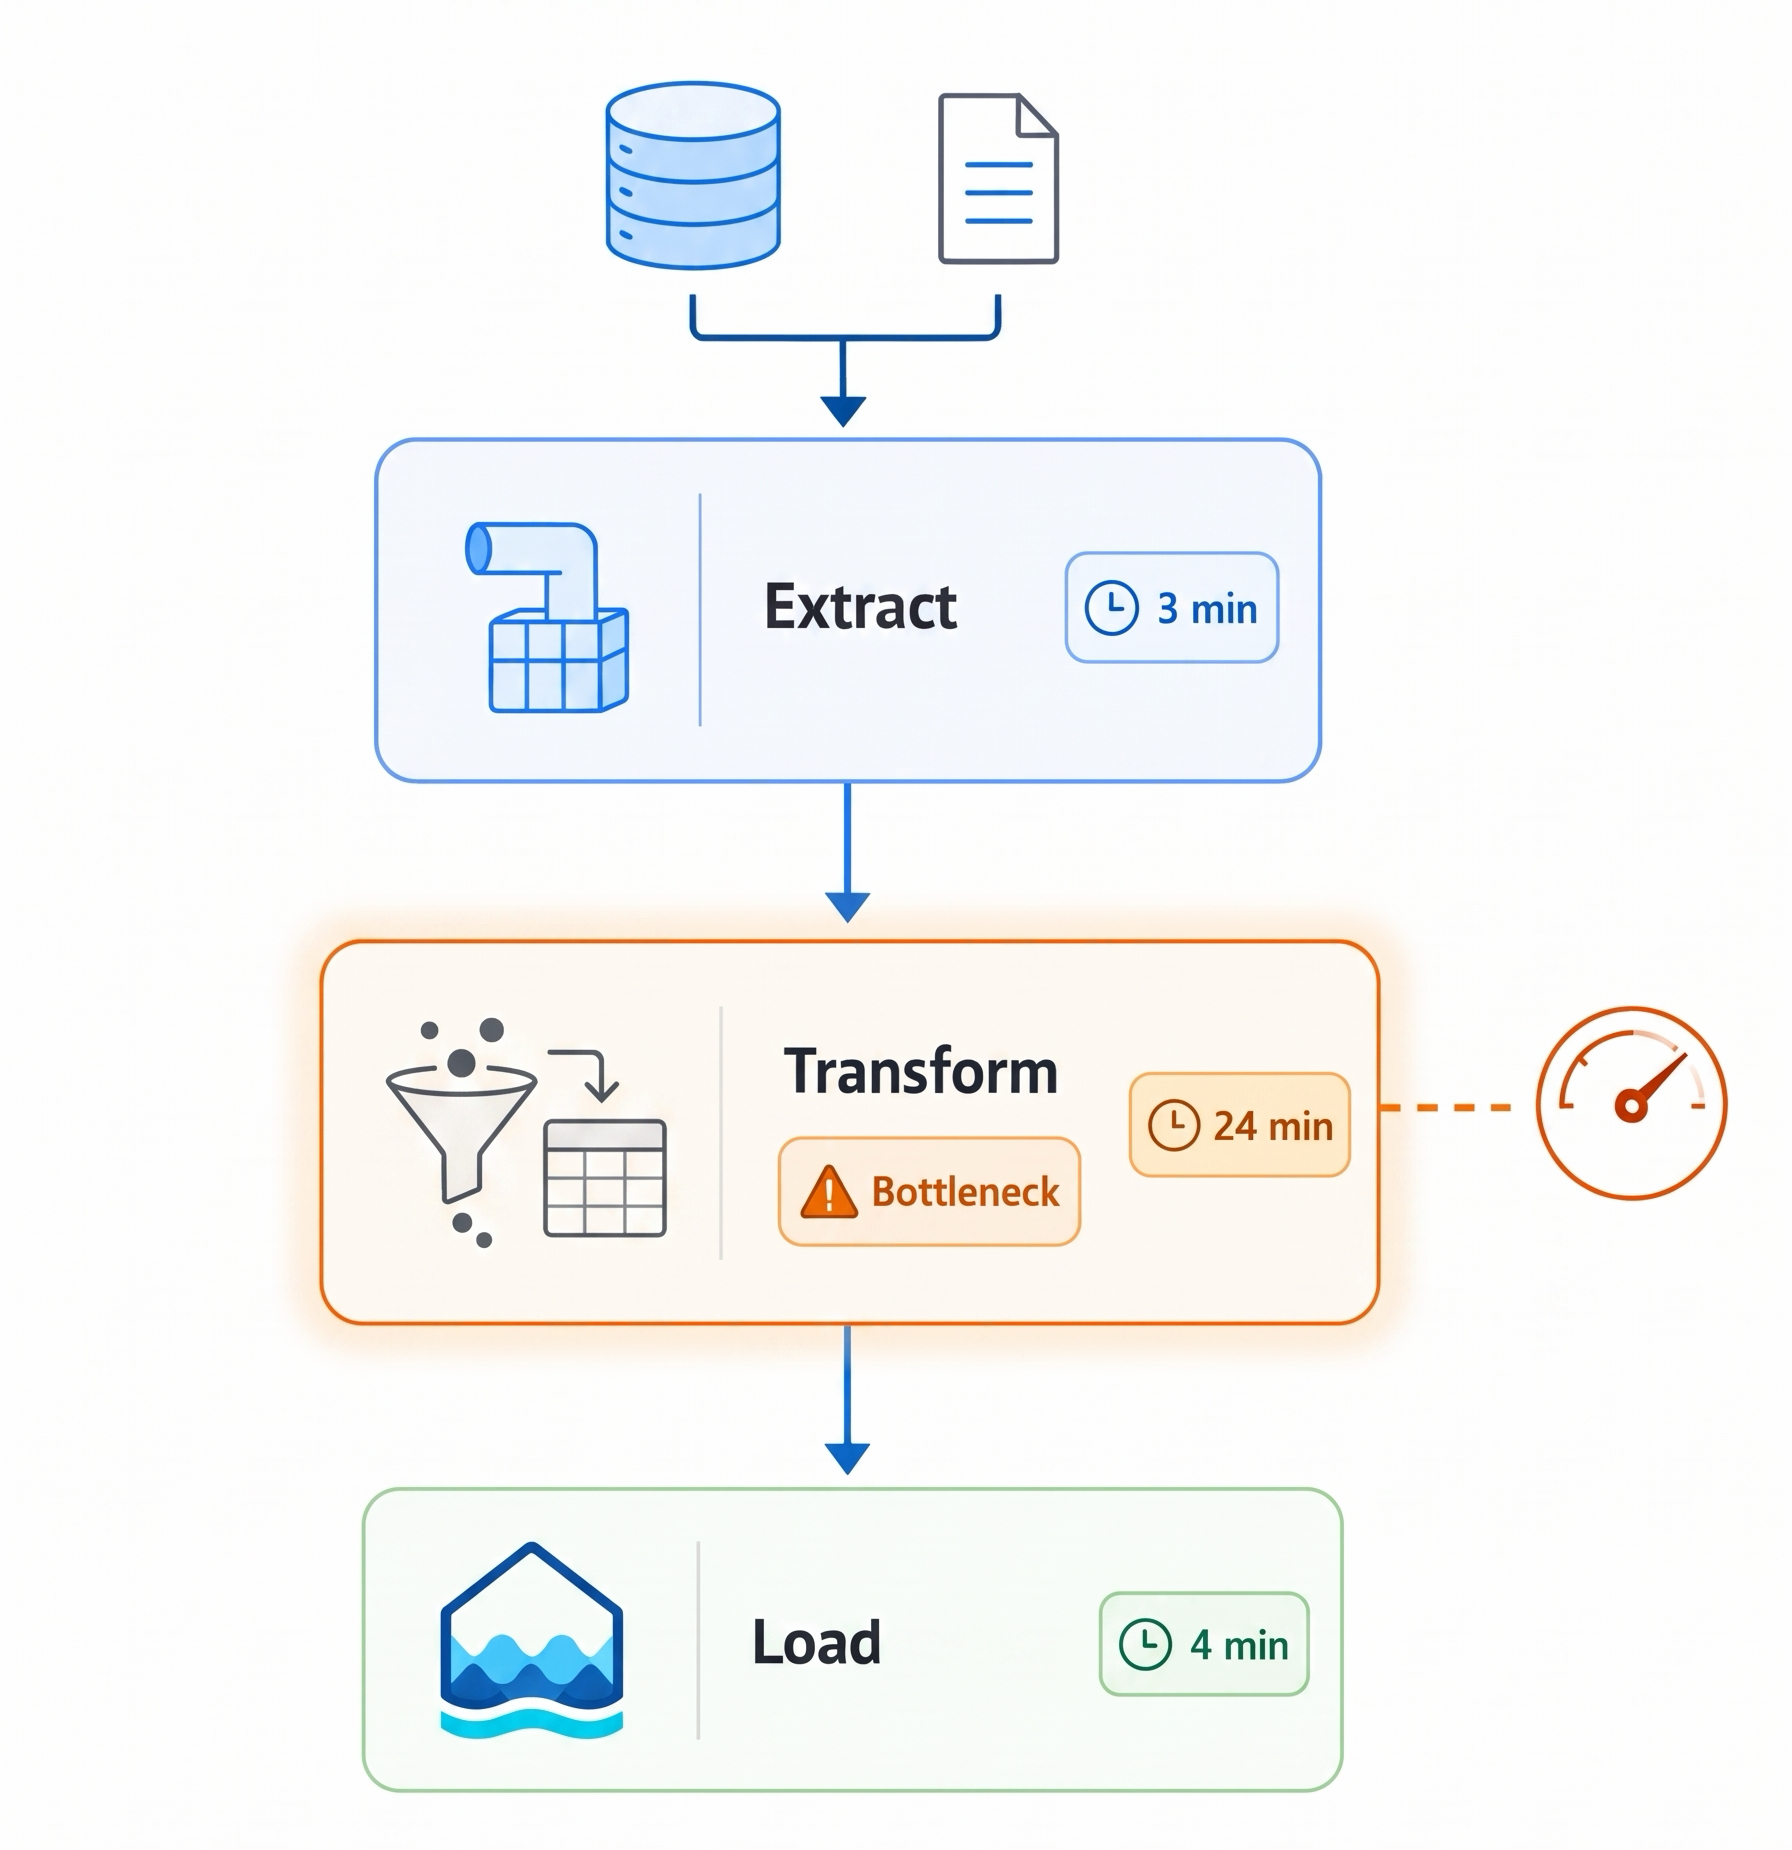
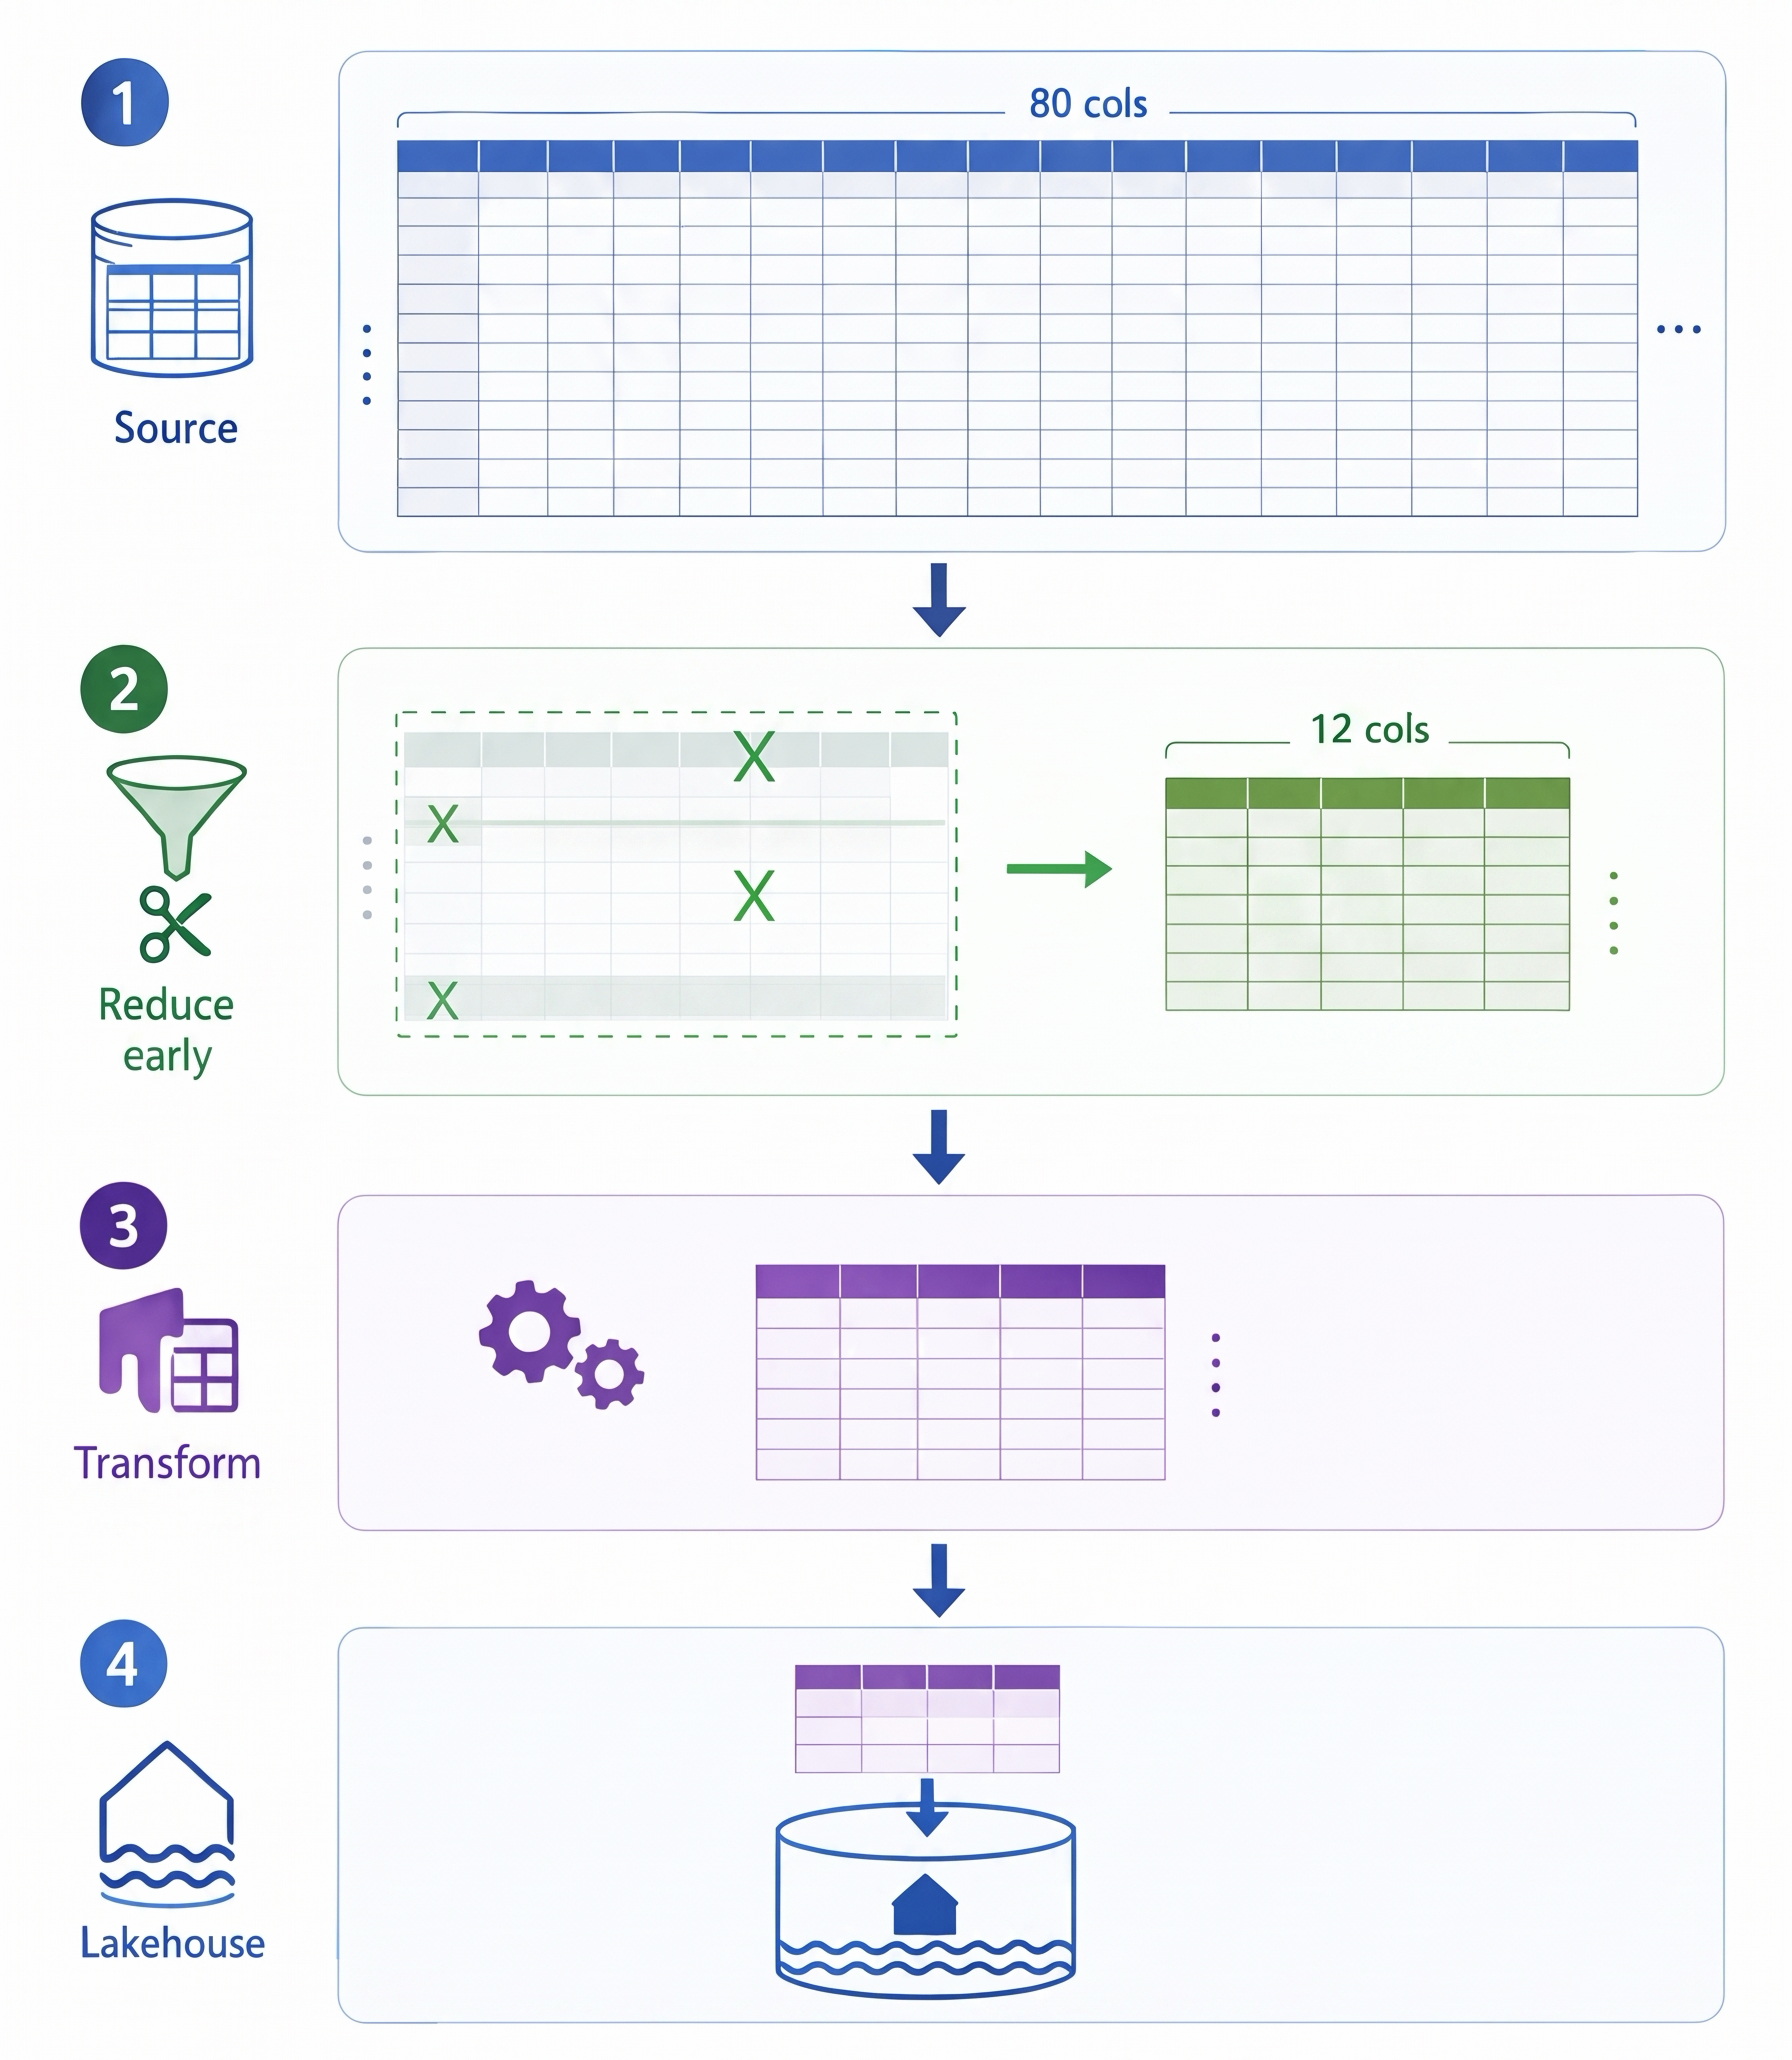
| बहुत ज़्यादा डेटा | शुरुआत में कम करें |
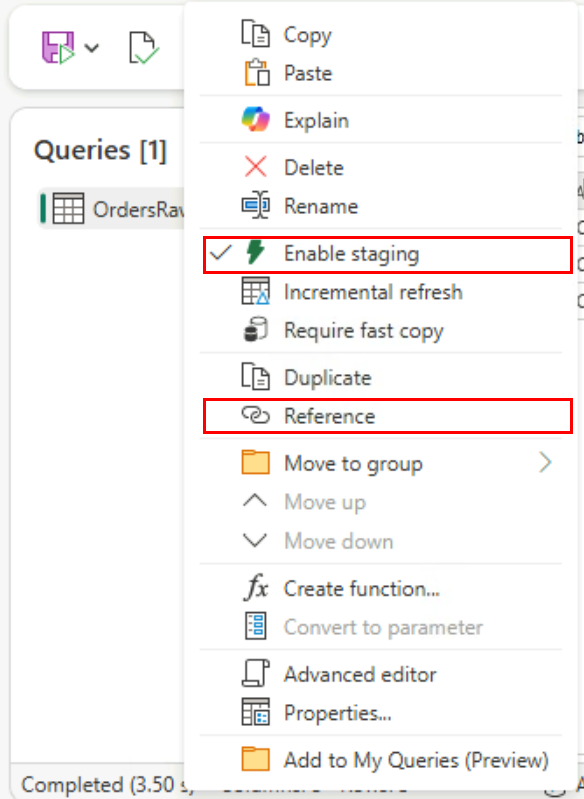
| दोहराई तैयारी | एक बार स्टेज करें |
| बड़ा लोड, हल्के ट्रांसफॉर्म | Fast Copy |
| ब्रांचिंग, नोटिफिकेशन, कोऑर्डिनेशन | पाइपलाइन |
| निरंतर replication चाहिए | Mirroring |
| बड़े टेबल पर हेवी मर्ज | सोर्स पर पुश करें (view या folded query) |
| गलत टूल | टूल बदलें |
Microsoft Fabric में Data Ingestion और Semantic Models