PySpark के साथ Machine Learning
Andrew Collier
Data Scientist, Fathom Data


cars.select('mass', 'cyl', 'consumption').show(5)
+------+---+-----------+
| mass|cyl|consumption|
+------+---+-----------+
|1451.0| 6| 9.05|
|1129.0| 4| 6.53|
|1399.0| 4| 7.84|
|1147.0| 4| 7.84|
|1111.0| 4| 9.05|
+------+---+-----------+
मॉडल बनाने के लिए एक ऑब्जेक्ट. यह एक pipeline हो सकता है.
regression = LinearRegression(labelCol='consumption')
मॉडल परफॉर्मेंस मापने का ऑब्जेक्ट.
evaluator = RegressionEvaluator(labelCol='consumption')
from pyspark.ml.tuning import CrossValidator, ParamGridBuilder
पैरामीटर वैल्यूज़ का एक grid (अभी खाली).
params = ParamGridBuilder().build()
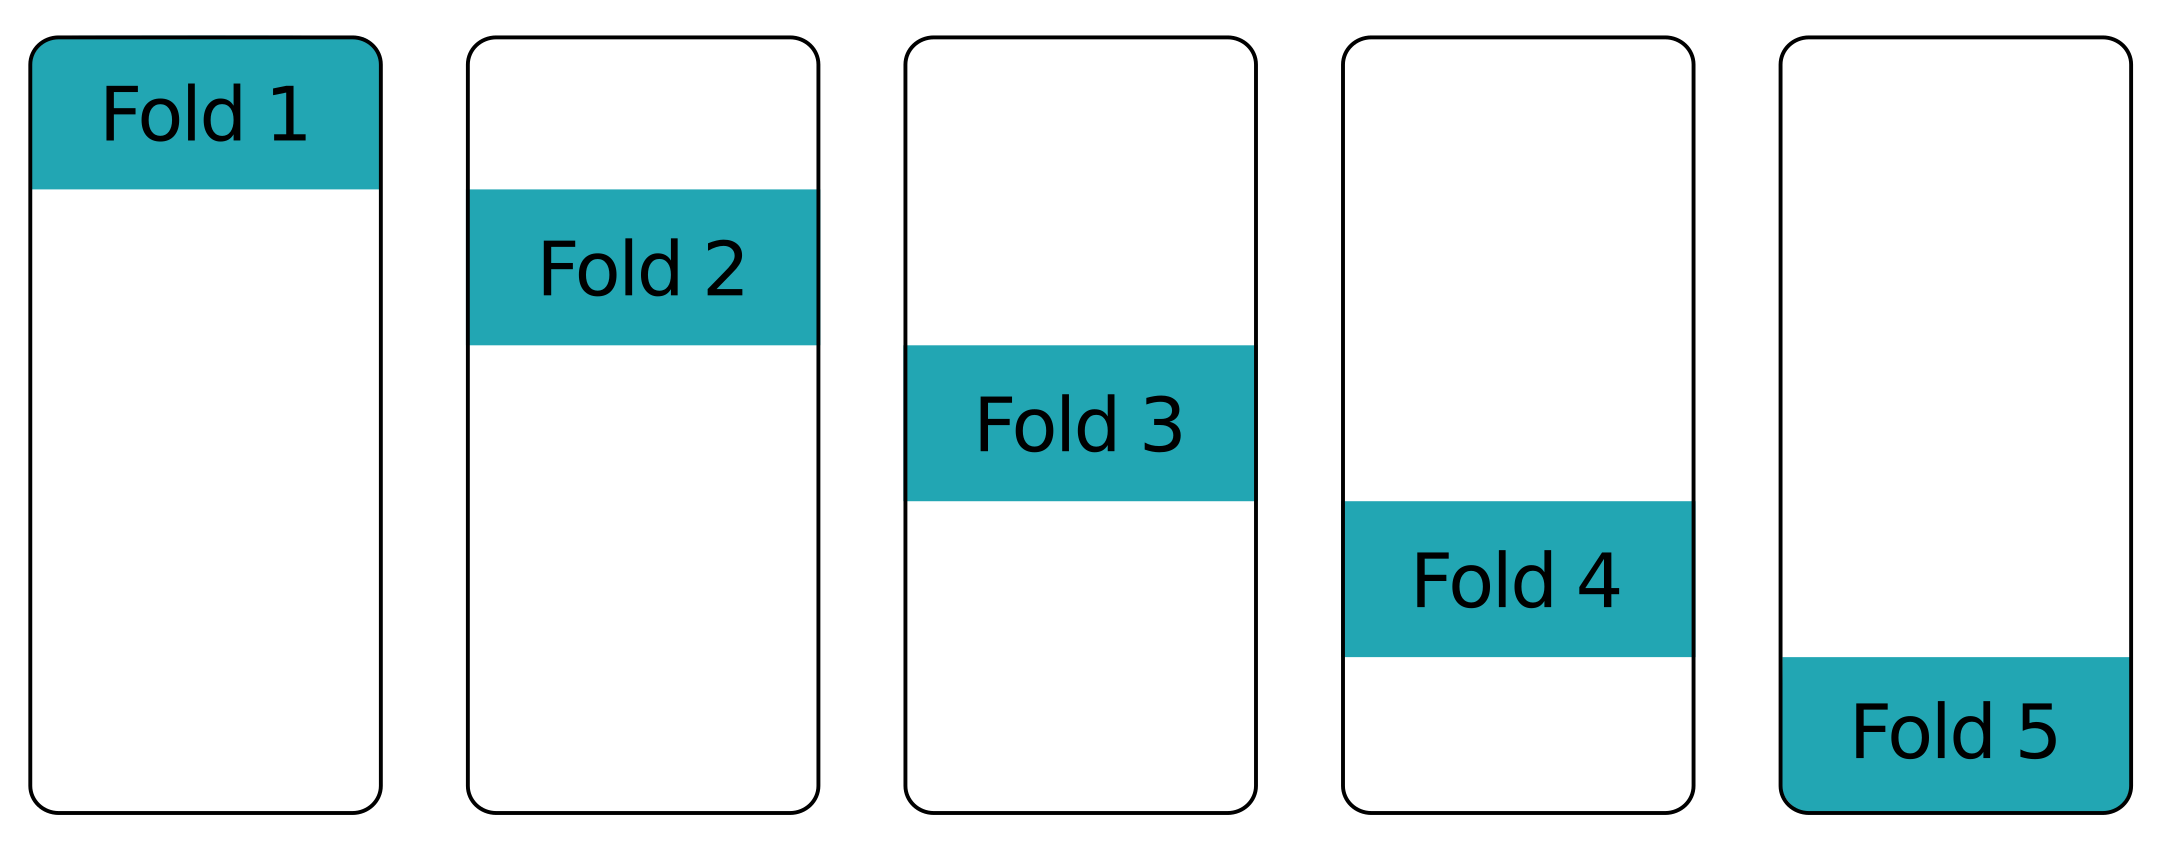
Cross-validation ऑब्जेक्ट.
cv = CrossValidator(estimator=regression,
estimatorParamMaps=params,
evaluator=evaluator,
numFolds=10, seed=13)
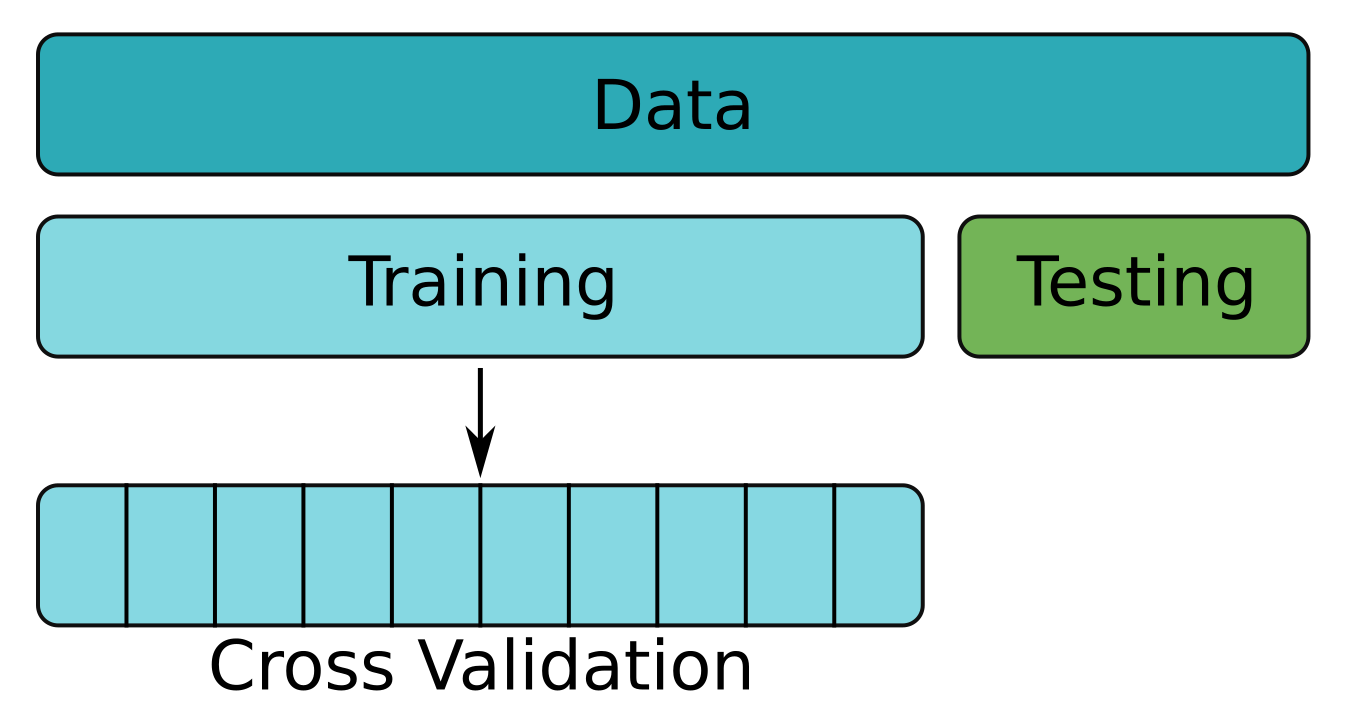
Training डेटा पर cross-validation लागू करें.
cv = cv.fit(cars_train)
Folds पर औसत RMSE क्या है?
cv.avgMetrics
[0.800663722151572]
मूल testing डेटा पर predictions बनाएँ.
evaluator.evaluate(cv.transform(cars_test))
# testing डेटा पर RMSE
0.745974203928479
Cross-validated RMSE से काफी छोटा.
# cross-validation से RMSE
0.800663722151572
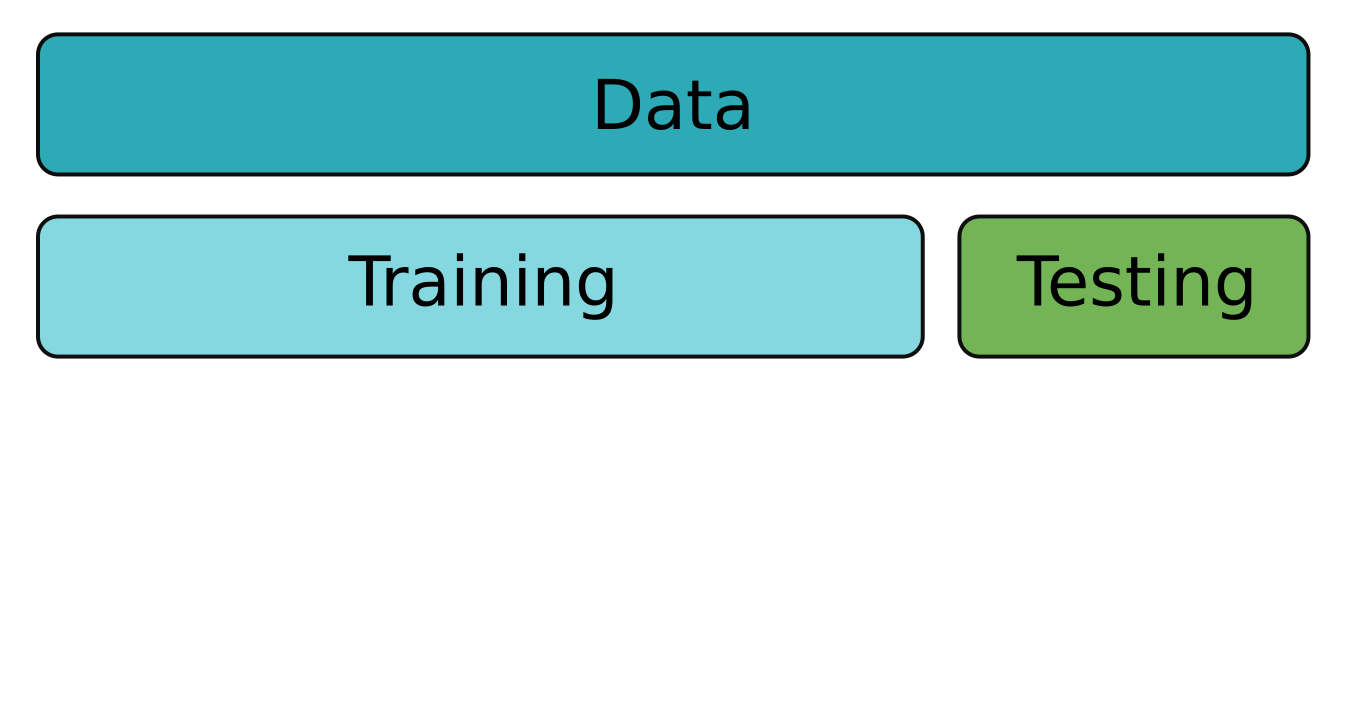
सिर्फ train-test split मॉडल परफॉर्मेंस को जरूरत से ज्यादा अच्छा दिखाता.
PySpark के साथ Machine Learning