PySpark के साथ Machine Learning
Andrew Collier
Data Scientist, Fathom Data
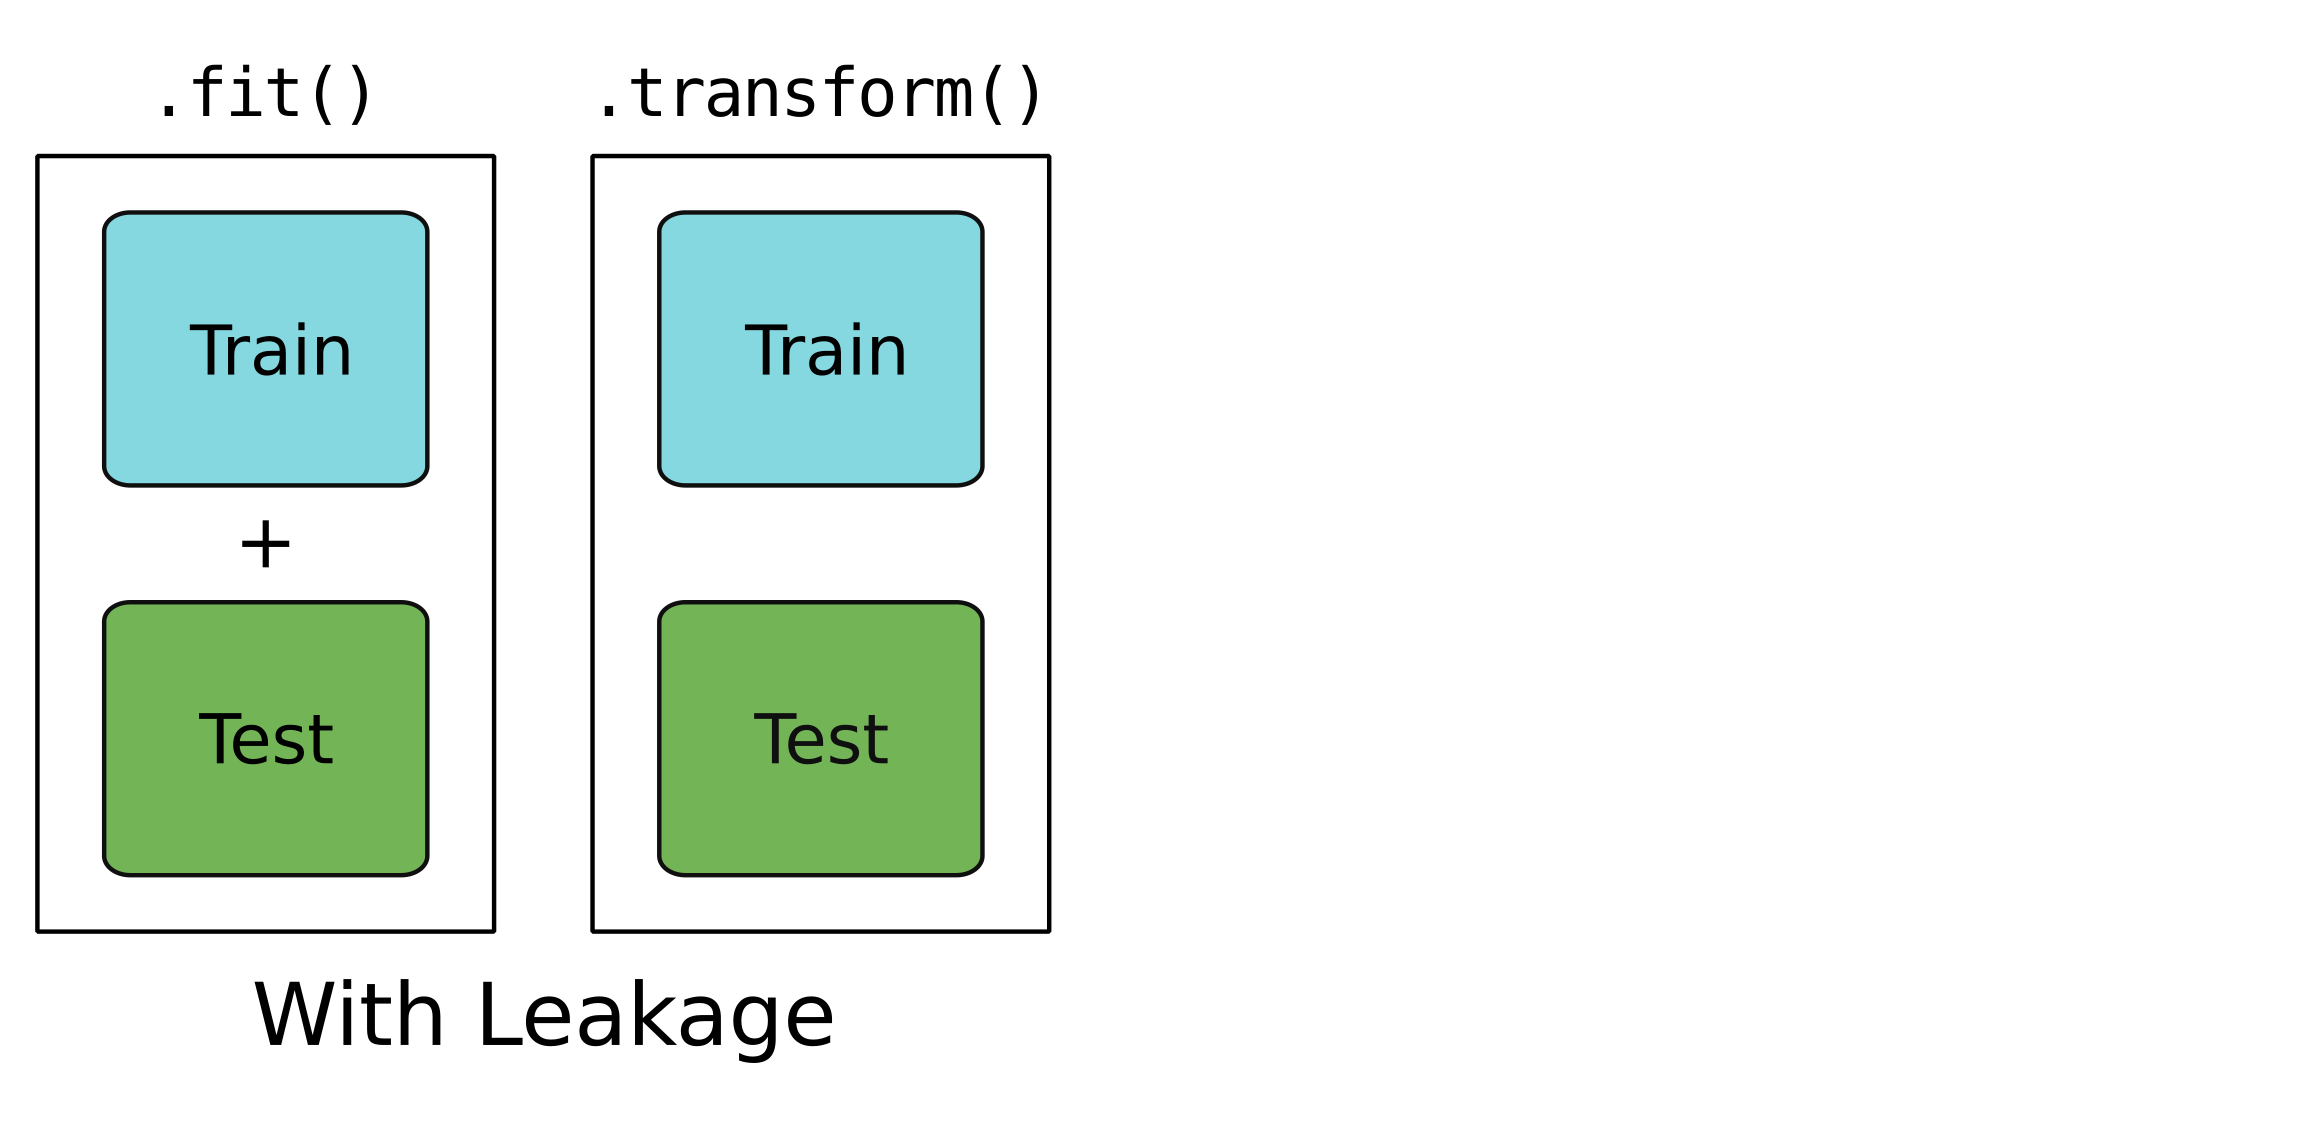
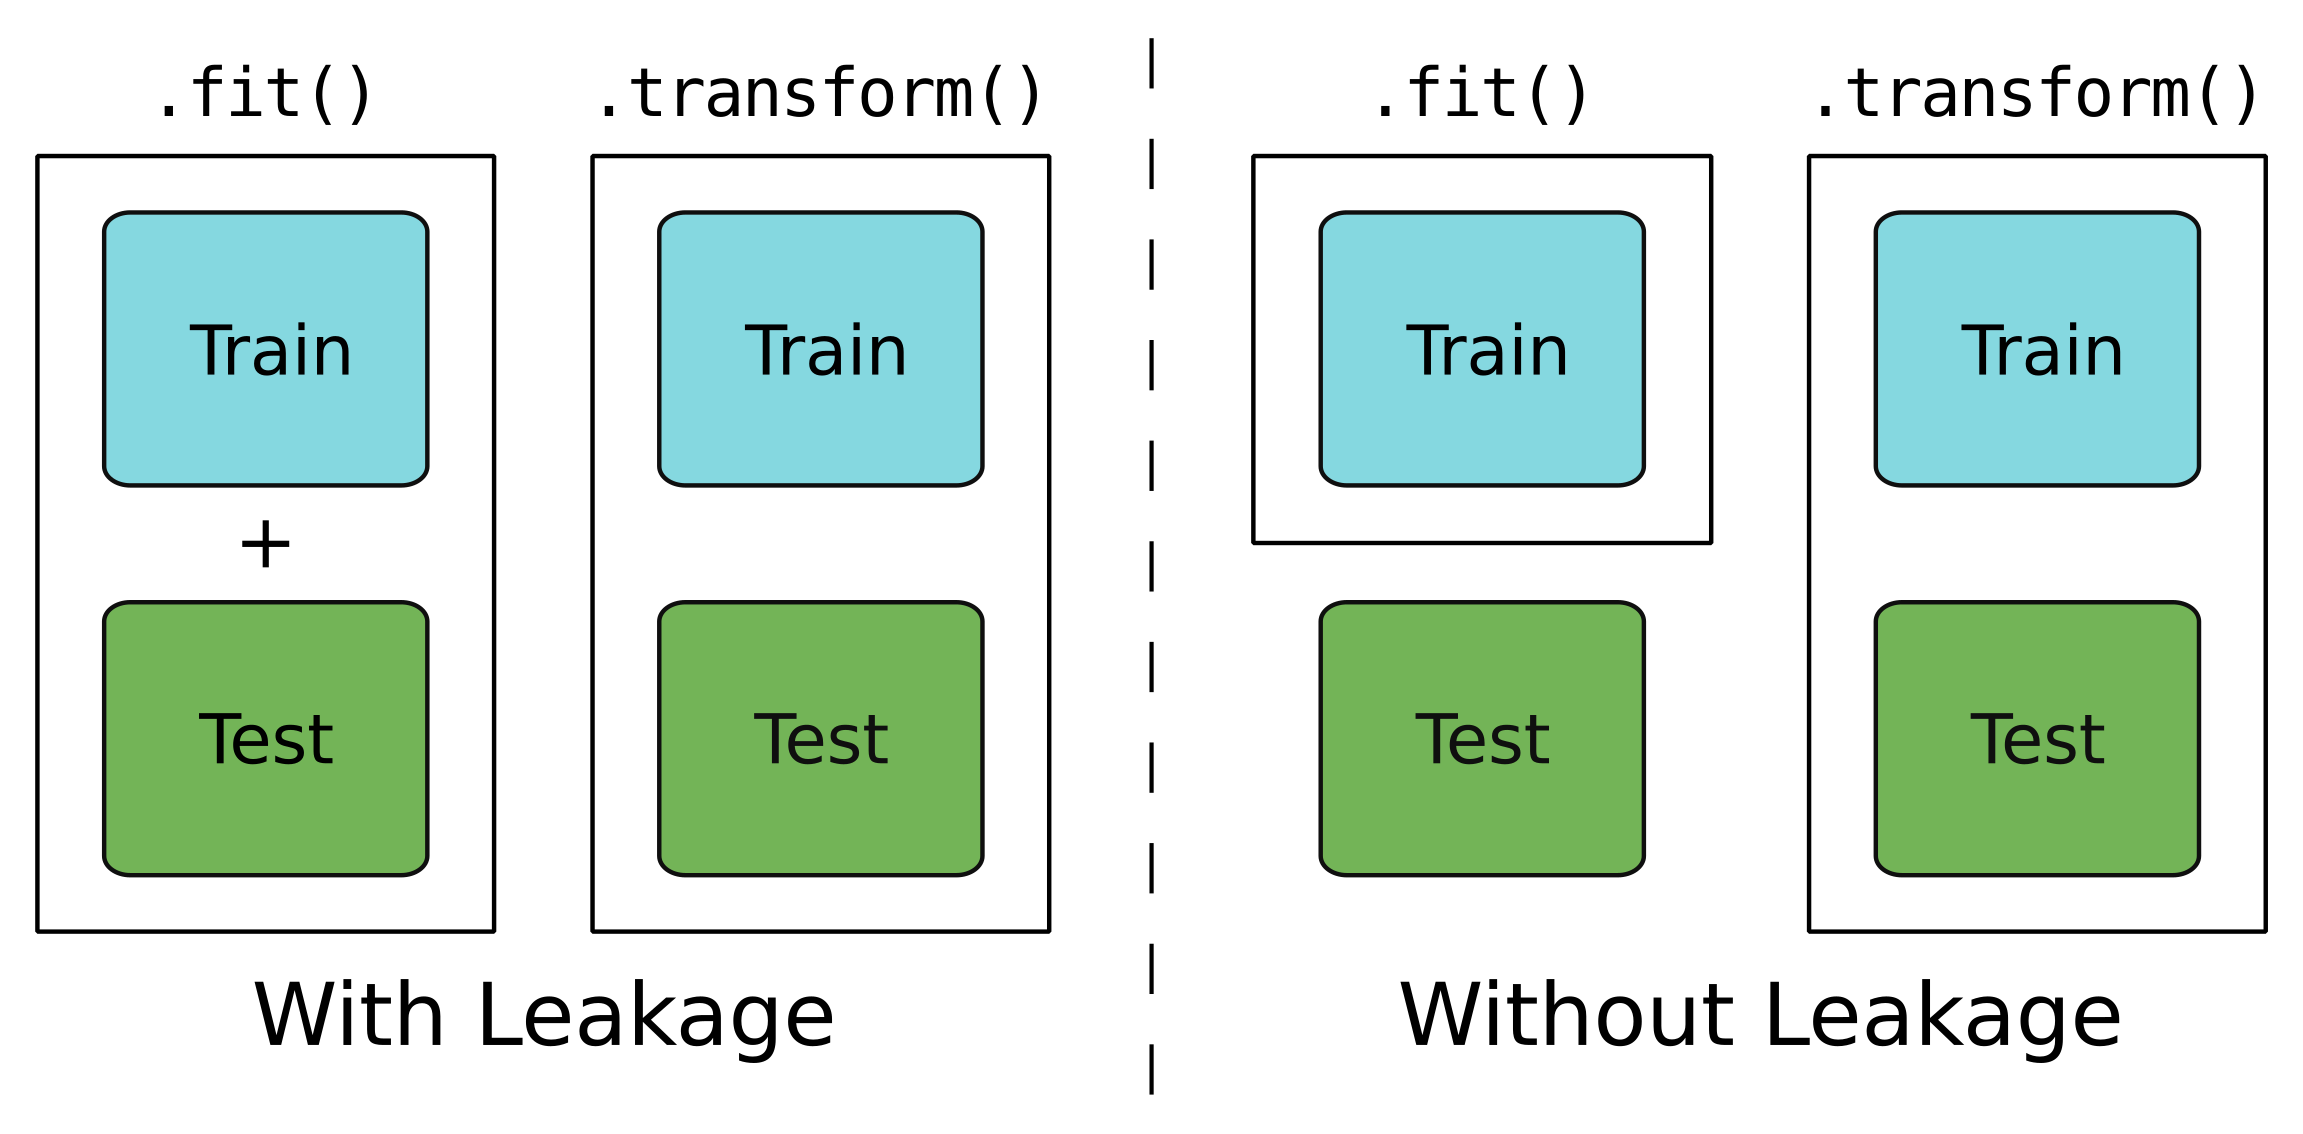
सिर्फ training डेटा के लिए.
Testing और training डेटा के लिए.


एक पाइपलाइन कई ऑपरेशंस की श्रृंखला होती है.
आप हर ऑपरेशन अलग-अलग चला सकते हैं... या पूरी पाइपलाइन ही चला दें!
indexer = StringIndexer(inputCol='type', outputCol='type_idx')onehot = OneHotEncoder(inputCols=['type_idx'], outputCols=['type_dummy'])assemble = VectorAssembler( inputCols=['mass', 'cyl', 'type_dummy'], outputCol='features' )regression = LinearRegression(labelCol='consumption')
indexer = indexer.fit(cars_train)
cars_train = indexer.transform(cars_train)
onehot = onehot.fit(cars_train)
cars_train = onehot.transform(cars_train)
cars_train = assemble.transform(cars_train)
# Training डेटा पर मॉडल फिट करें
regression = regression.fit(cars_train)
cars_test = indexer.transform(cars_test)
cars_test = onehot.transform(cars_test)
cars_test = assemble.transform(cars_test)
# Testing डेटा पर प्रेडिक्शन करें
predictions = regression.transform(cars_test)
स्टेप्स को एक पाइपलाइन में कॉम्बाइन करें.
from pyspark.ml import Pipeline
pipeline = Pipeline(stages=[indexer, onehot, assemble, regression])
Training डेटा
pipeline = pipeline.fit(cars_train)
Testing डेटा
predictions = pipeline.transform(cars_test)
.stages एट्रिब्यूट से अलग-अलग स्टेजेस एक्सेस करें.
# LinearRegression ऑब्जेक्ट (चौथा स्टेज -> इंडेक्स 3) pipeline.stages[3]print(pipeline.stages[3].intercept)
4.19433571782916
print(pipeline.stages[3].coefficients)
DenseVector([0.0028, 0.2705, -1.1813, -1.3696, -1.1751, -1.1553, -1.8894])
PySpark के साथ Machine Learning