Hugging Face के साथ मल्टी-मोडल मॉडल्स
James Chapman
Curriculum Manager, DataCamp


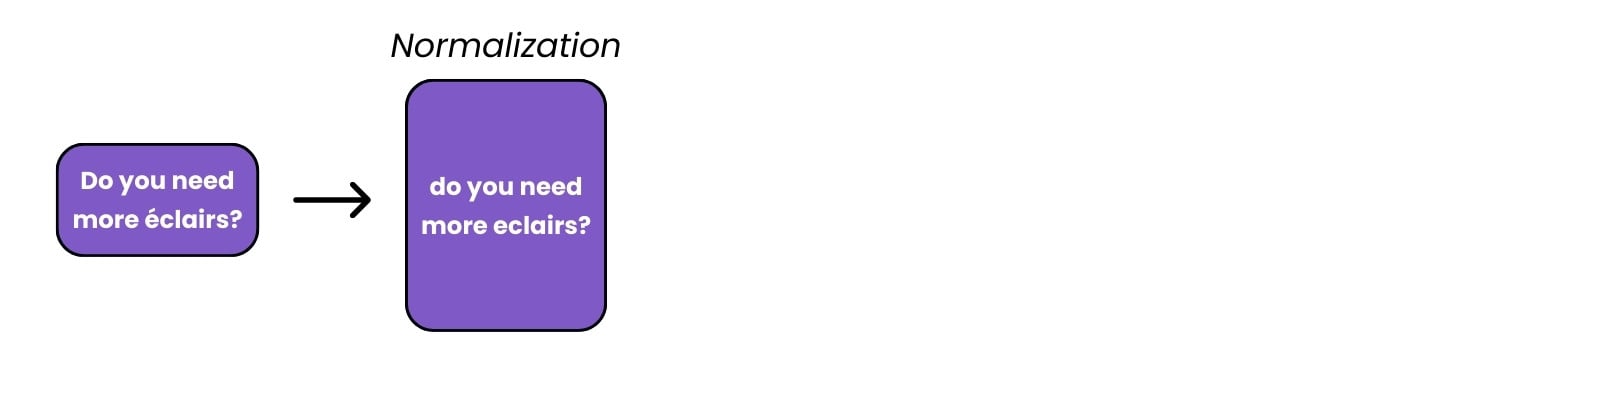
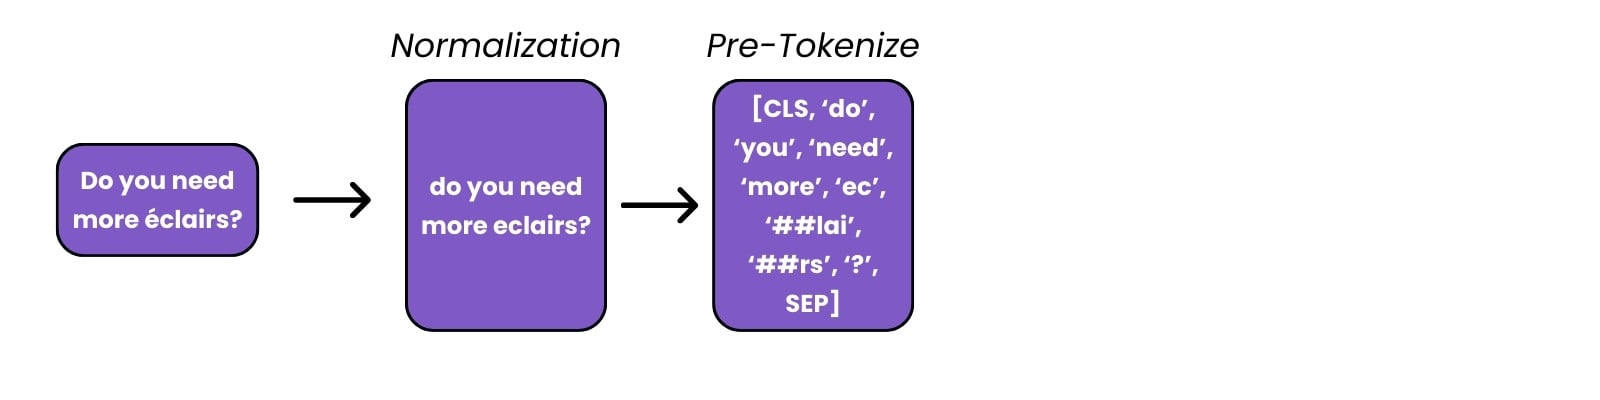
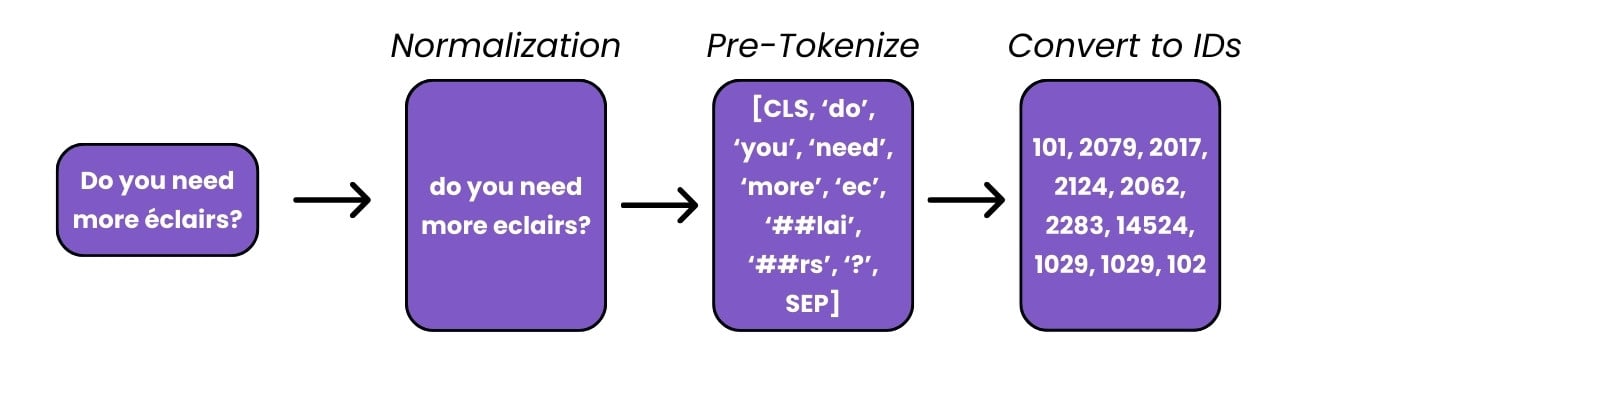
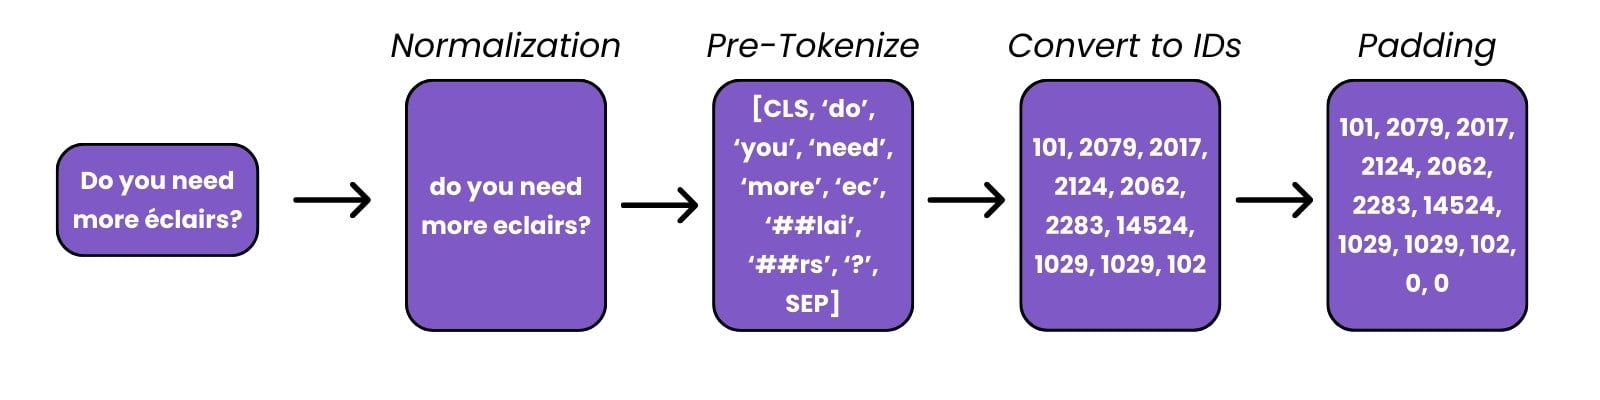
from transformers import AutoTokenizer tokenizer = AutoTokenizer.from_pretrained('distilbert/distilbert-base-uncased')text = "Do you need more éclairs?"print(tokenizer.backend_tokenizer.normalizer.normalize_str(text))
do you need more eclairs
tokenizer(text, return_tensors='pt', padding=True)
{'input_ids': tensor([[ 101, ..., 102]]), ...}

मल्टीमोडल टास्क के लिए संगत प्रीप्रोसेसिंग ज़रूरी है:
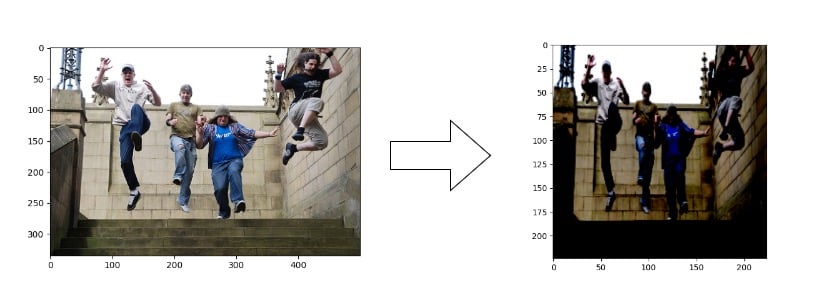
from transformers import BlipProcessor, BlipForConditionalGenerationcheckpoint = "Salesforce/blip-image-captioning-base"model = BlipForConditionalGeneration.from_pretrained(checkpoint) processor = BlipProcessor.from_pretrained(checkpoint)
इमेज एन्कोड करें → टेक्स्ट एन्कोडिंग में ट्रांसफॉर्म करें → टेक्स्ट डिकोड करें
image = load_dataset("nlphuji/flickr30k")['test'][11]["image"] inputs = processor(images=image, return_tensors="pt")output = model.generate(**inputs)print(processor.decode(output[0]))
[{'generated_text': 'a group of people jumping'}]

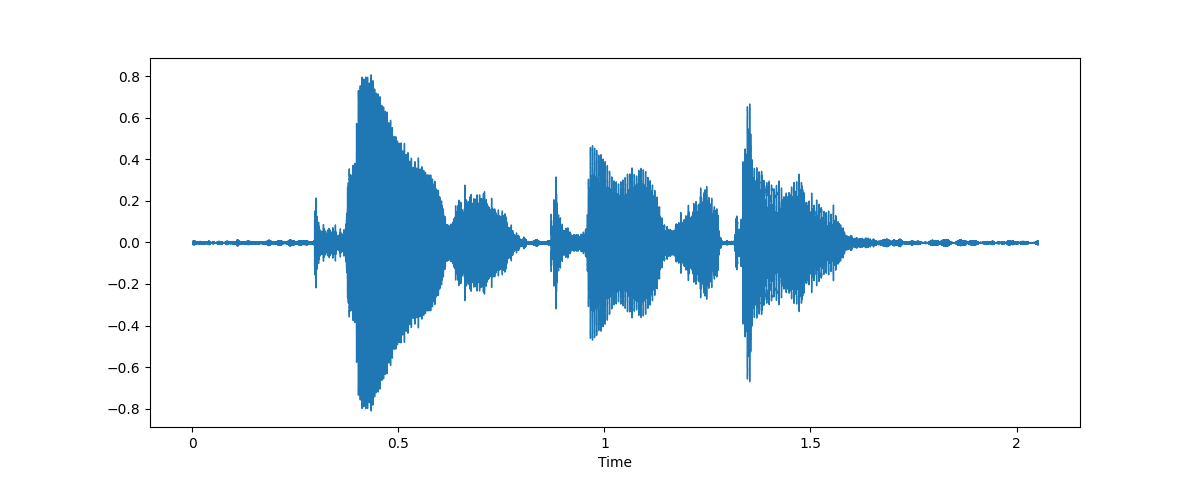
मॉडल इनपुट के रूप में फीचर एक्सट्रैक्शन (स्पेक्ट्रोग्राम)
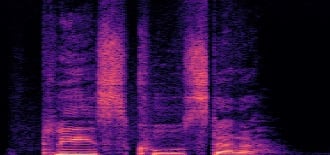
from datasets import load_dataset, Audiodataset = load_dataset("CSTR-Edinburgh/vctk")["train"] dataset = dataset.cast_column("audio", Audio(sampling_rate=16_000))
from transformers import AutoProcessor
processor = AutoProcessor.from_pretrained("openai/whisper-small")
audio_pp = processor(dataset[0]["audio"]["array"],
sampling_rate=16_000, return_tensors="pt")
Hugging Face के साथ मल्टी-मोडल मॉडल्स