विजुअल प्रश्न-उत्तर (VQA)

Hugging Face के साथ मल्टी-मोडल मॉडल्स

James Chapman

Curriculum Manager, DataCamp

मल्टीमॉडल QA टास्क
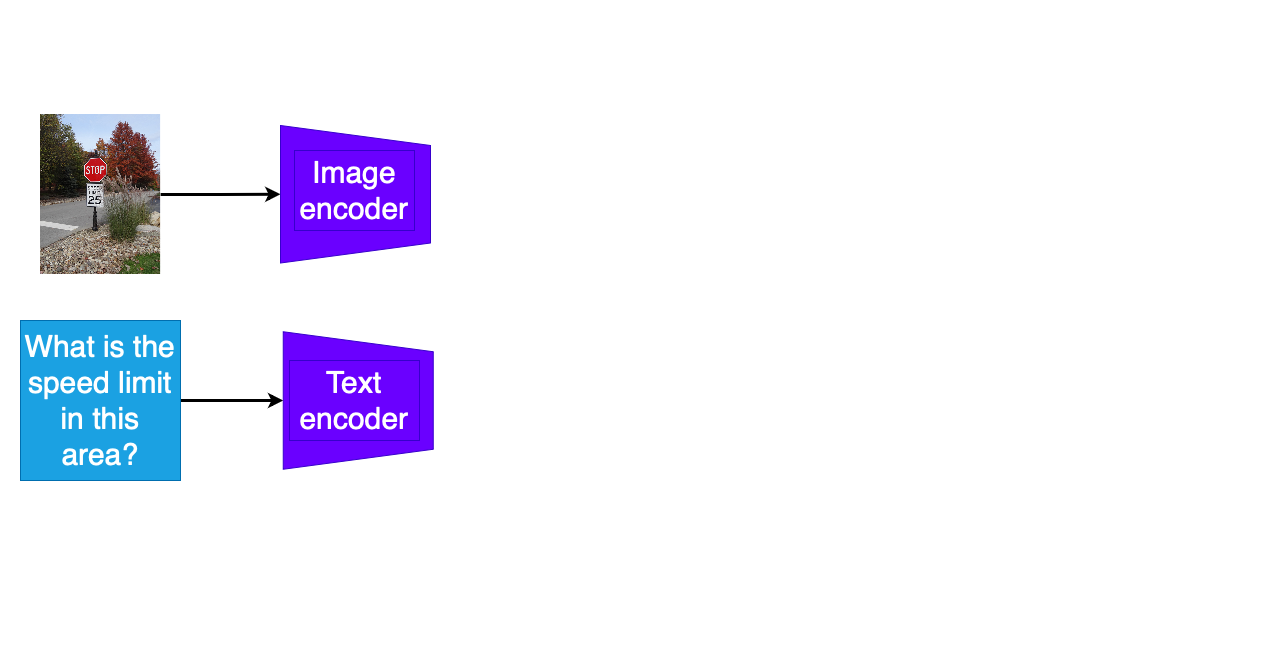
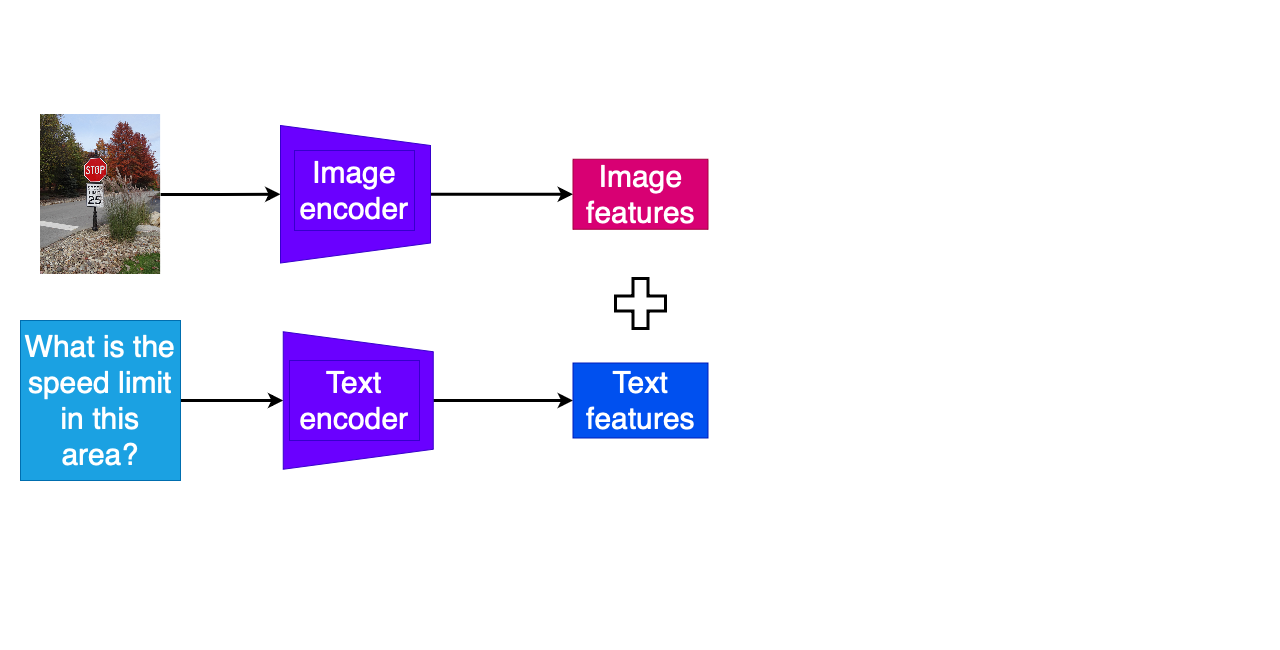
VQA मॉडल में इमेज और टेक्स्ट की प्रोसेसिंग दिखाने वाला डायग्राम

  1. प्रश्न टेक्स्ट और दूसरी मॉडैलिटी का अलग-अलग एन्कोडिंग
Hugging Face के साथ मल्टी-मोडल मॉडल्स

मल्टीमॉडल QA टास्क

VQA मॉडल में इमेज और टेक्स्ट की प्रोसेसिंग दिखाने वाला डायग्राम

  1. प्रश्न टेक्स्ट और दूसरी मॉडैलिटी का अलग-अलग एन्कोडिंग
  2. एन्कोडेड फीचर्स का संयोजन
Hugging Face के साथ मल्टी-मोडल मॉडल्स

मल्टीमॉडल QA टास्क

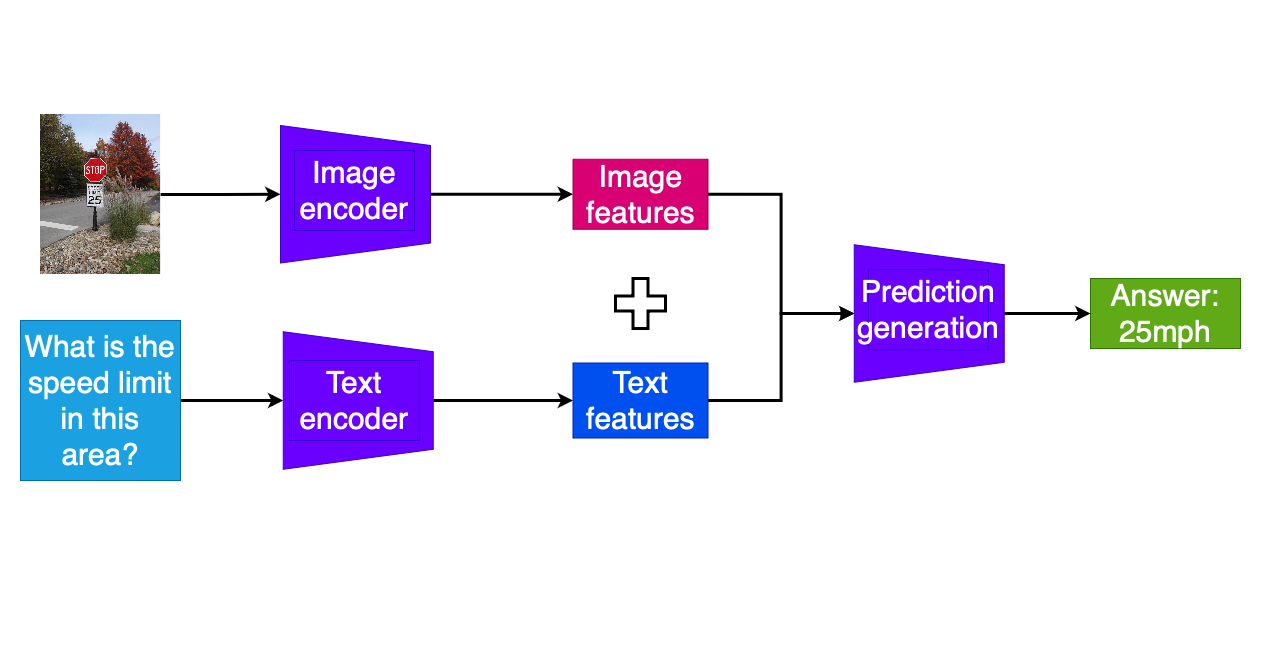
VQA मॉडल में इमेज और टेक्स्ट की प्रोसेसिंग दिखाने वाला डायग्राम

  1. प्रश्न टेक्स्ट और दूसरी मॉडैलिटी का अलग-अलग एन्कोडिंग
  2. एन्कोडेड फीचर्स का संयोजन
  3. उत्तर टोकन प्रेडिक्ट करने के लिए अतिरिक्त मॉडल लेयर
Hugging Face के साथ मल्टी-मोडल मॉडल्स

VQA

import requests
from PIL import Image

url = "https://www.worldanimalprotection
.org/cdn-cgi/image/width=1920,format=
auto/globalassets/images/elephants/1
033551-elephant.jpg"


image = Image.open(requests.get(url, stream=True).raw)
text = "What animal is in this photo?"

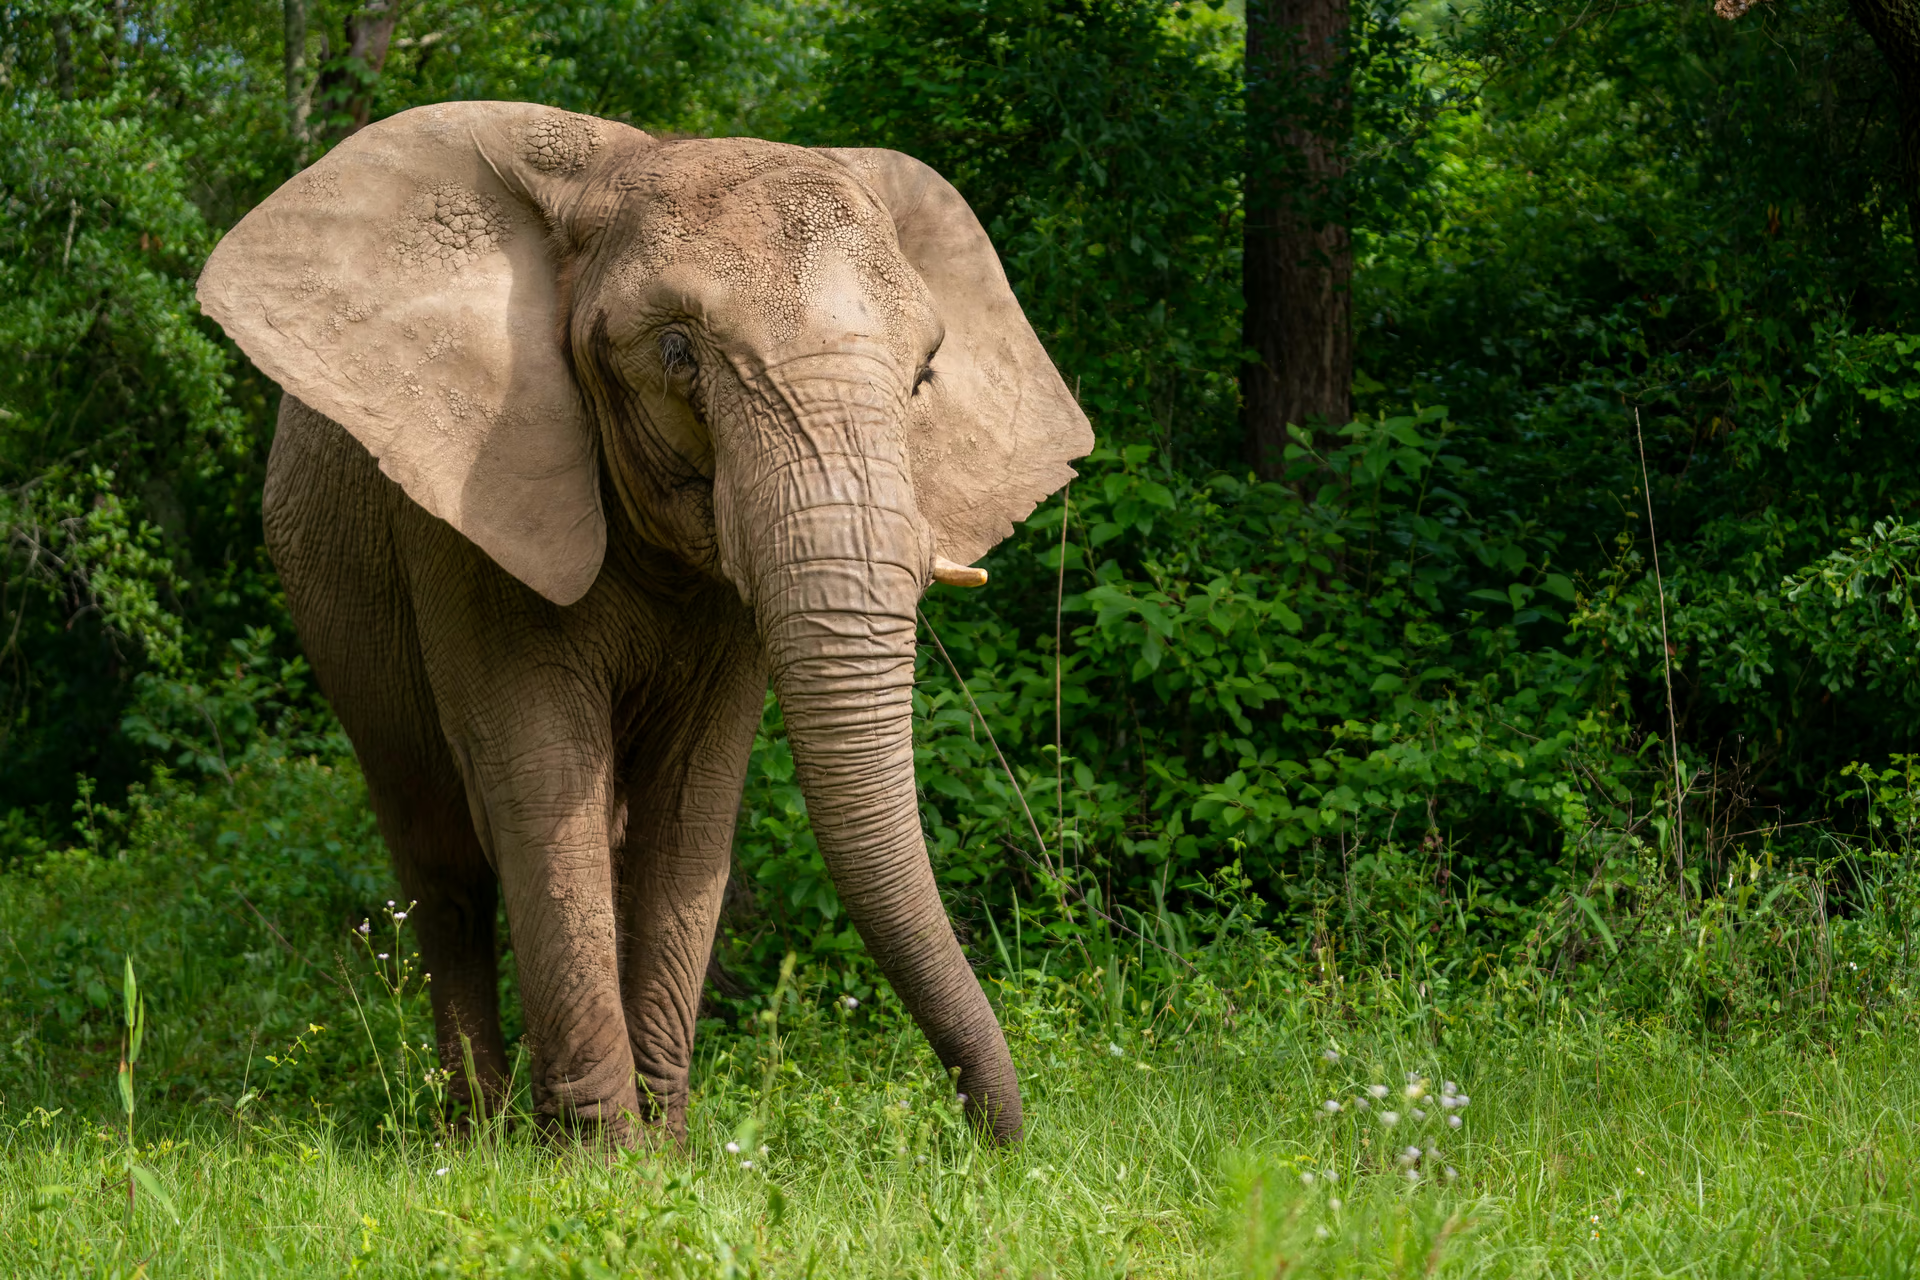
जंगली हाथी की तस्वीर

Hugging Face के साथ मल्टी-मोडल मॉडल्स

VQA


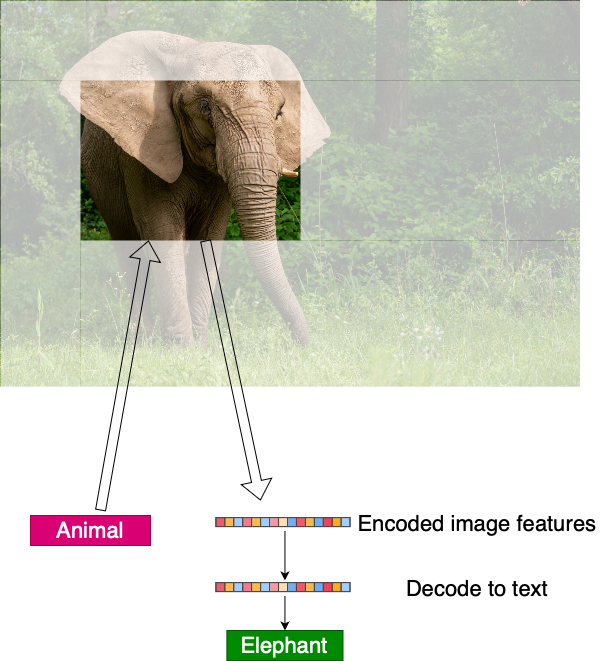
  • मॉडल को कई ऑब्जेक्ट्स की इमेज और टेक्स्ट फीचर्स पता होते हैं
  • बिना अतिरिक्त फाइन-ट्यूनिंग के रीउस करने योग्य मॉडल

किसी जानवर पर फोकस और पहचान दिखाने वाला डायग्राम

Hugging Face के साथ मल्टी-मोडल मॉडल्स

VQA

from transformers import ViltProcessor, ViltForQuestionAnswering


processor = ViltProcessor.from_pretrained("dandelin/vilt-b32-finetuned-vqa") model = ViltForQuestionAnswering.from_pretrained("dandelin/vilt-b32-finetuned-vqa")
encoding = processor(image, text, return_tensors="pt")
outputs = model(**encoding)
idx = outputs.logits.argmax(-1).item()
print("Predicted answer:", model.config.id2label[idx])
Predicted answer: elephant
Hugging Face के साथ मल्टी-मोडल मॉडल्स

डॉक्यूमेंट VQA

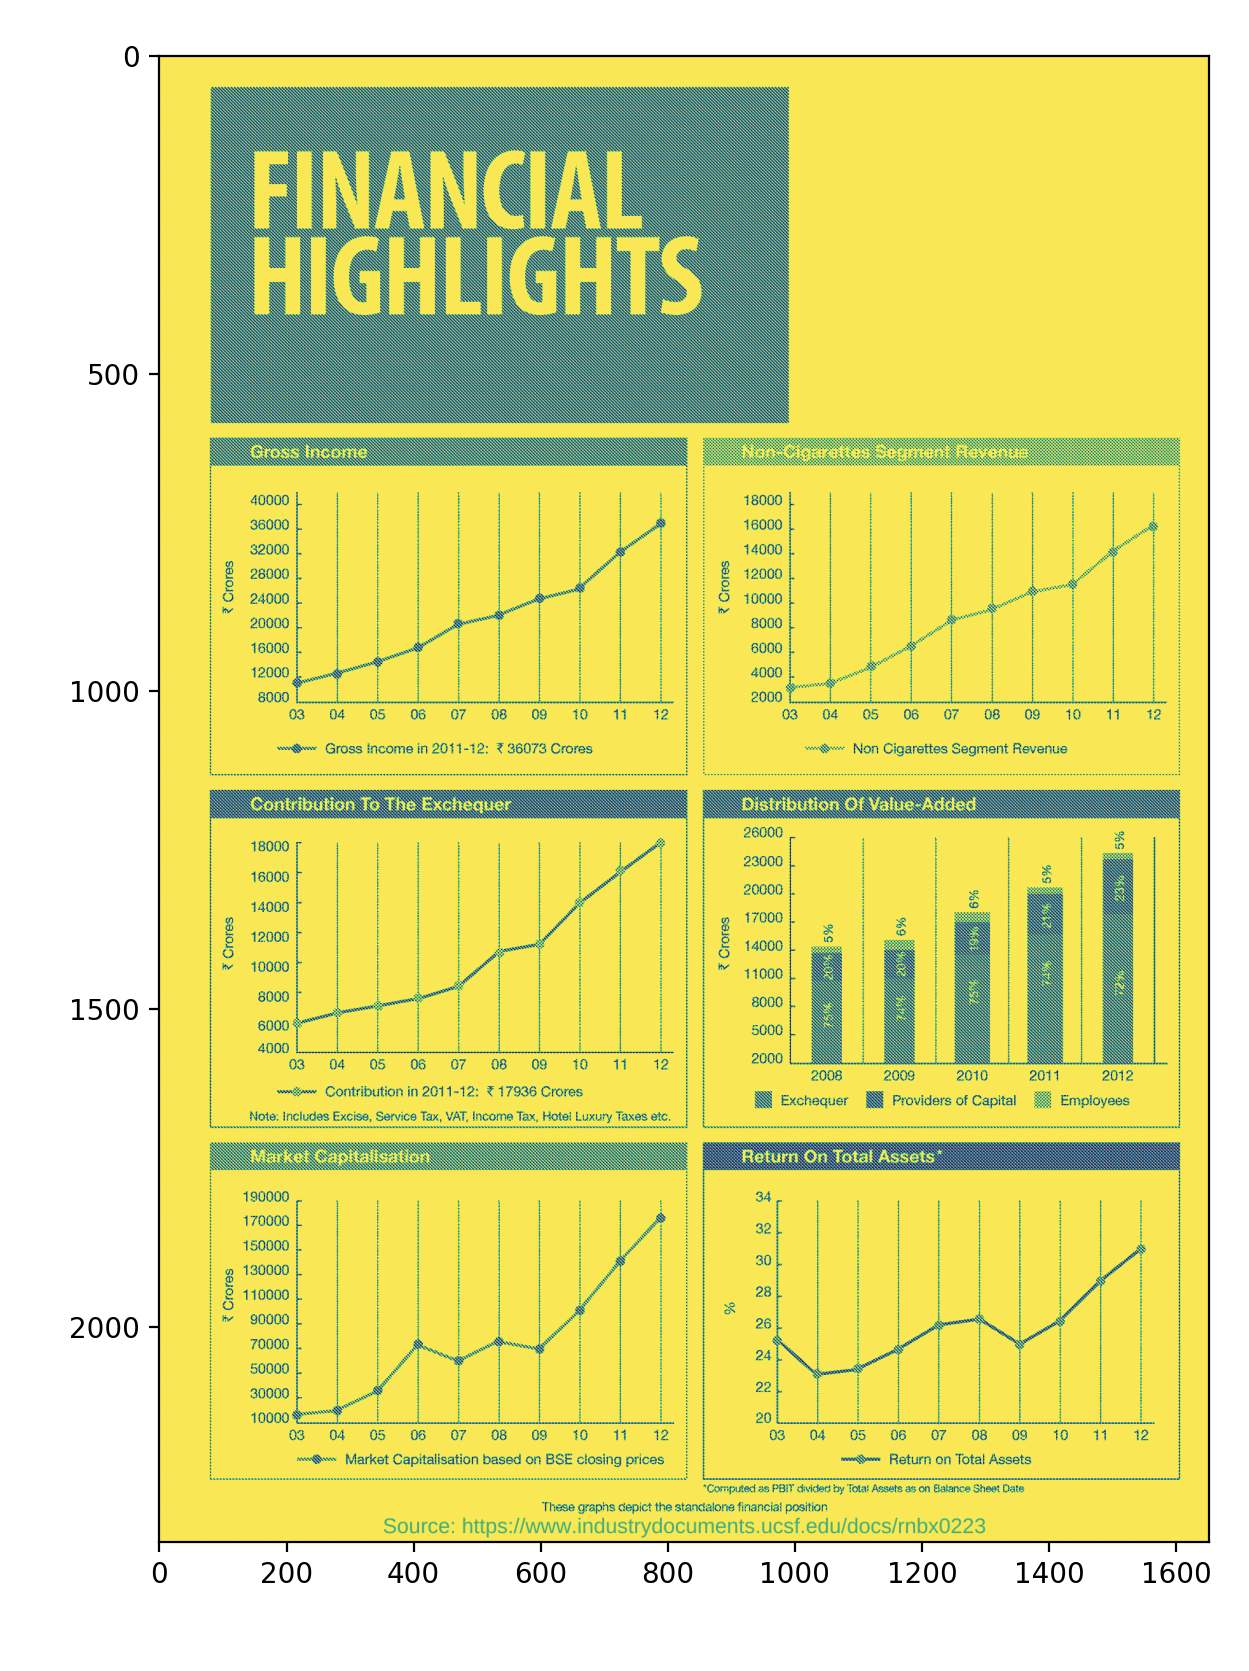
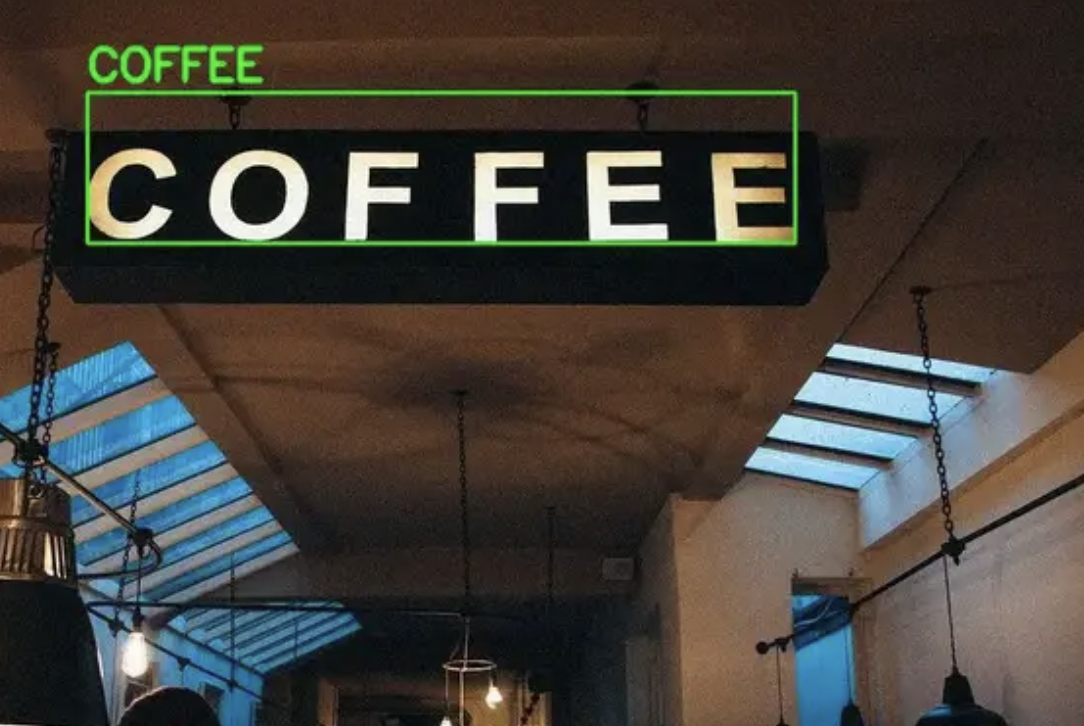
  • VQA का विस्तार: इमेज में ग्राफ, टेबल और टेक्स्ट (OCR) डिटेक्ट करना
from datasets import load_dataset
from transformers import pipeline

dataset = load_dataset("lmms-lab/DocVQA")


import matplotlib.pyplot as plt plt.imshow(dataset["test"][2]["image"]) plt.show()

ग्राफ और बार चार्ट वाले डॉक्यूमेंट की इमेज

Hugging Face के साथ मल्टी-मोडल मॉडल्स

डॉक्यूमेंट VQA

Google Tessearact लोगो

  • OCR चलाने के लिए अतिरिक्त डिपेंडेंसी चाहिए
  • pytesseract को pip से इंस्टॉल करें
  • Tesseract OCR को पैकेज installer से इंस्टॉल करें (जैसे apt-get, exe या homebrew/macports)

OCR के साथ कॉफी साइन की तस्वीर

Hugging Face के साथ मल्टी-मोडल मॉडल्स

डॉक्यूमेंट VQA

from transformers import pipeline
pipe = pipeline("document-question-answering", "impira/layoutlm-document-qa")

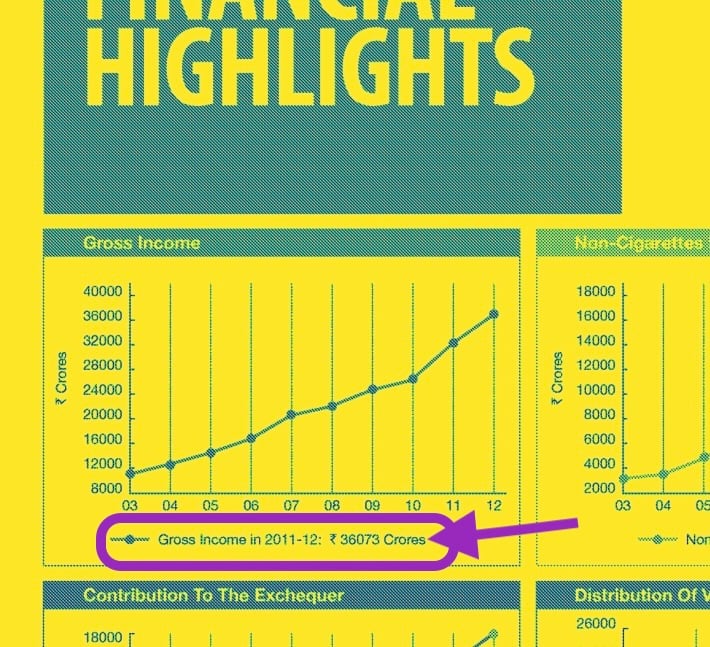
result = pipe( dataset["test"][2]["image"], "What was the gross income in 2011-2012?" )
Hugging Face के साथ मल्टी-मोडल मॉडल्स

डॉक्यूमेंट VQA

print(result)
[{'score': 0.05149758607149124,
  'answer': '3 36073 Crores', ...}]

ग्राफ और बार चार्ट वाले डॉक्यूमेंट की इमेज

Hugging Face के साथ मल्टी-मोडल मॉडल्स

अभ्यास करते हैं!

Hugging Face के साथ मल्टी-मोडल मॉडल्स

Preparing Video For Download...