KNN के हाइपरपैरामीटर

Python में Anomaly Detection

Bekhruz (Bex) Tuychiev

Kaggle Master, Data Science Content Creator

evaluate_outlier_classifier संशोधित करें

def evaluate_outlier_classifier(model, data, threshold=.75):
    model.fit(data)

    probs = model.predict_proba(data)
    inliers = data[probs[:, 1] <= threshold]

    return inliers
Python में Anomaly Detection

evaluate_regressor में बदलाव

def evaluate_regressor(inliers):
    X, y = inliers.drop("weightkg", axis=1), inliers[['weightkg']]
    X_train, X_test, y_train, y_test = train_test_split(
      X, y, random_state=10, train_size=0.8)

    lr = LinearRegression()
    lr.fit(X_train, y_train)

    preds = lr.predict(X_test)
    rmse = root_mean_squared_error(y_test, preds)

    return round(rmse, 3)
Python में Anomaly Detection

पड़ोसियों की संख्या ट्यून करना

n_neighbors = [5, 10, 15, 20]
scores = dict()


for k in n_neighbors: # Init a KNN knn = KNN(n_neighbors=k) # Get the inliers with KNN inliers = evaluate_outlier_classifier(knn, males_transformed, .55) # Calculate and store RMSE scores[k] = evaluate_regressor(inliers)
Python में Anomaly Detection

परिणाम देखें

print(scores)
{5: 19.463, 10: 17.965, 15: 18.817, 20: 20.597}
Python में Anomaly Detection

डिस्टेंस मेट्रिक्स

  • 40 से अधिक मेट्रिक्स सपोर्टेड हैं
knn = KNN(metric='euclidean')

8 इंस्टेंस वाले एक सैंपल डेटासेट का प्लॉट, जहाँ A एक आउट्लायर है और A के 4 सबसे नज़दीकी पड़ोसियों तक तीर दिखाए गए हैं.

Python में Anomaly Detection

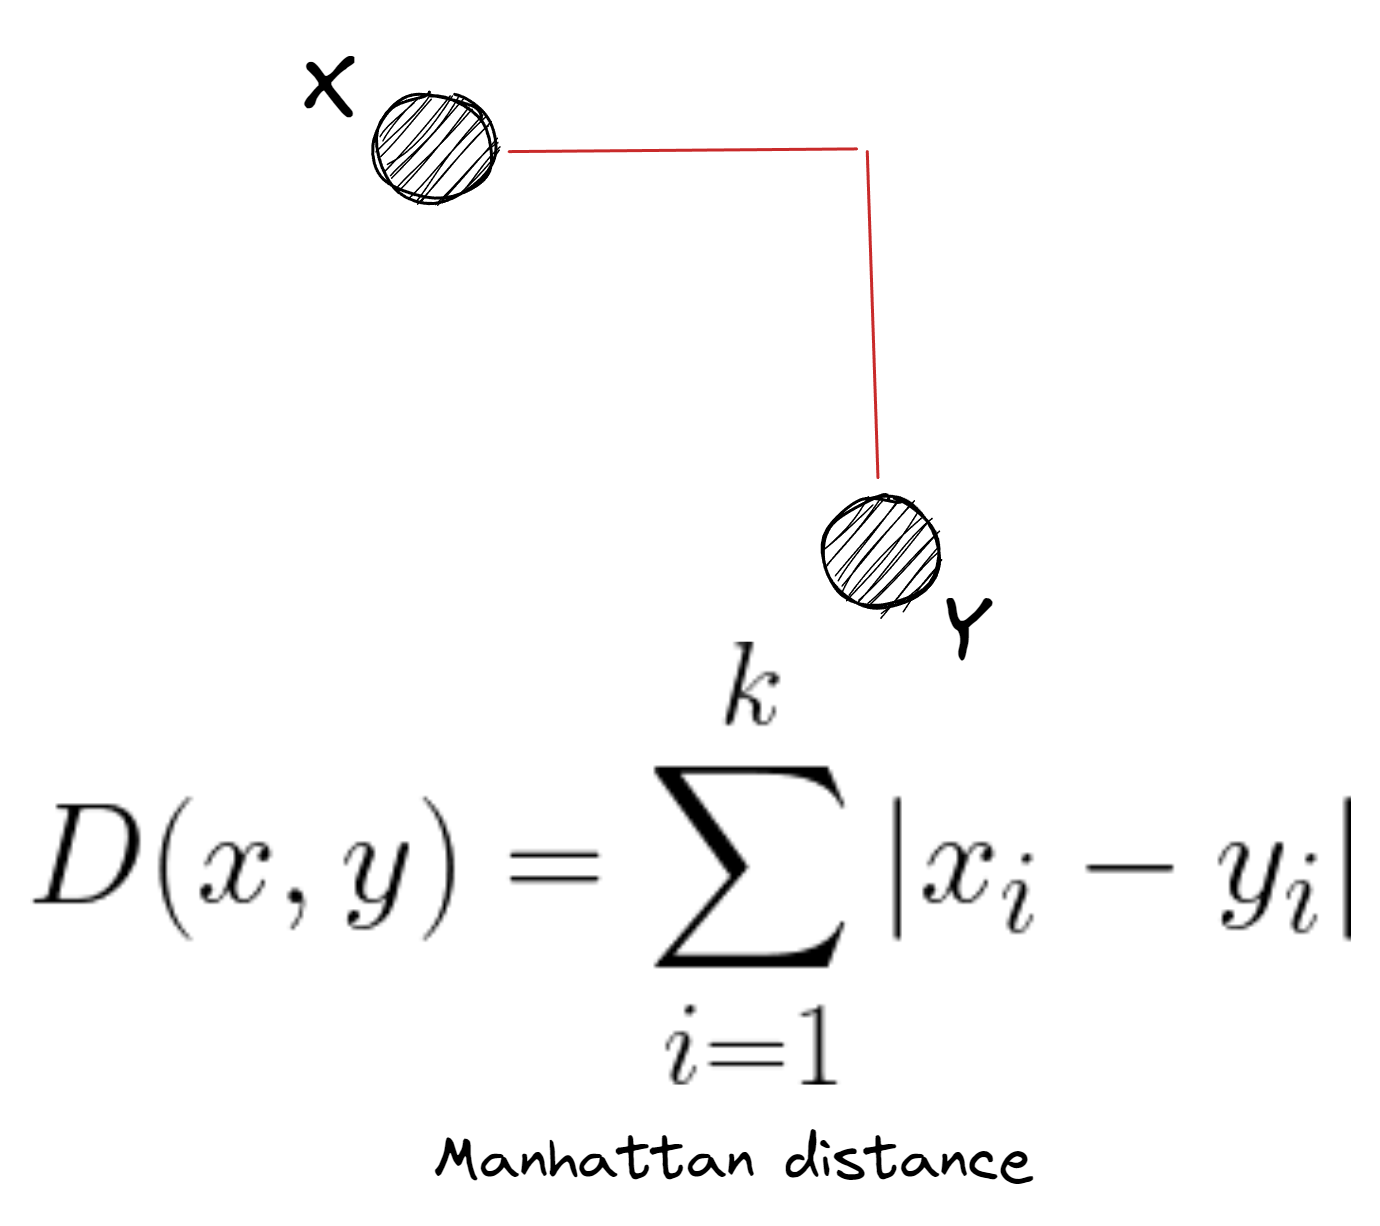
Manhattan distance

A = np.array([9, 1, 6, ...])
B = np.array([25, 44, 85, ...])


diffs = np.abs(B - A)
manhattan_dist_AB = np.sum(diffs) manhattan_dist_AB
573

मैनहैटन डिस्टेंस निकालने का सूत्र और प्रक्रिया समझाने वाला विज़ुअल.

Python में Anomaly Detection

Manhattan distance

  • हाई-डायमेंशनल डेटा पर अच्छा काम करता है
  • euclidean से बड़े मान देता है
  • कैटेगोरिकल फीचर्स के साथ बेहतर काम करता है

मैनहैटन डिस्टेंस निकालने का सूत्र और प्रक्रिया समझाने वाला विज़ुअल.

Python में Anomaly Detection

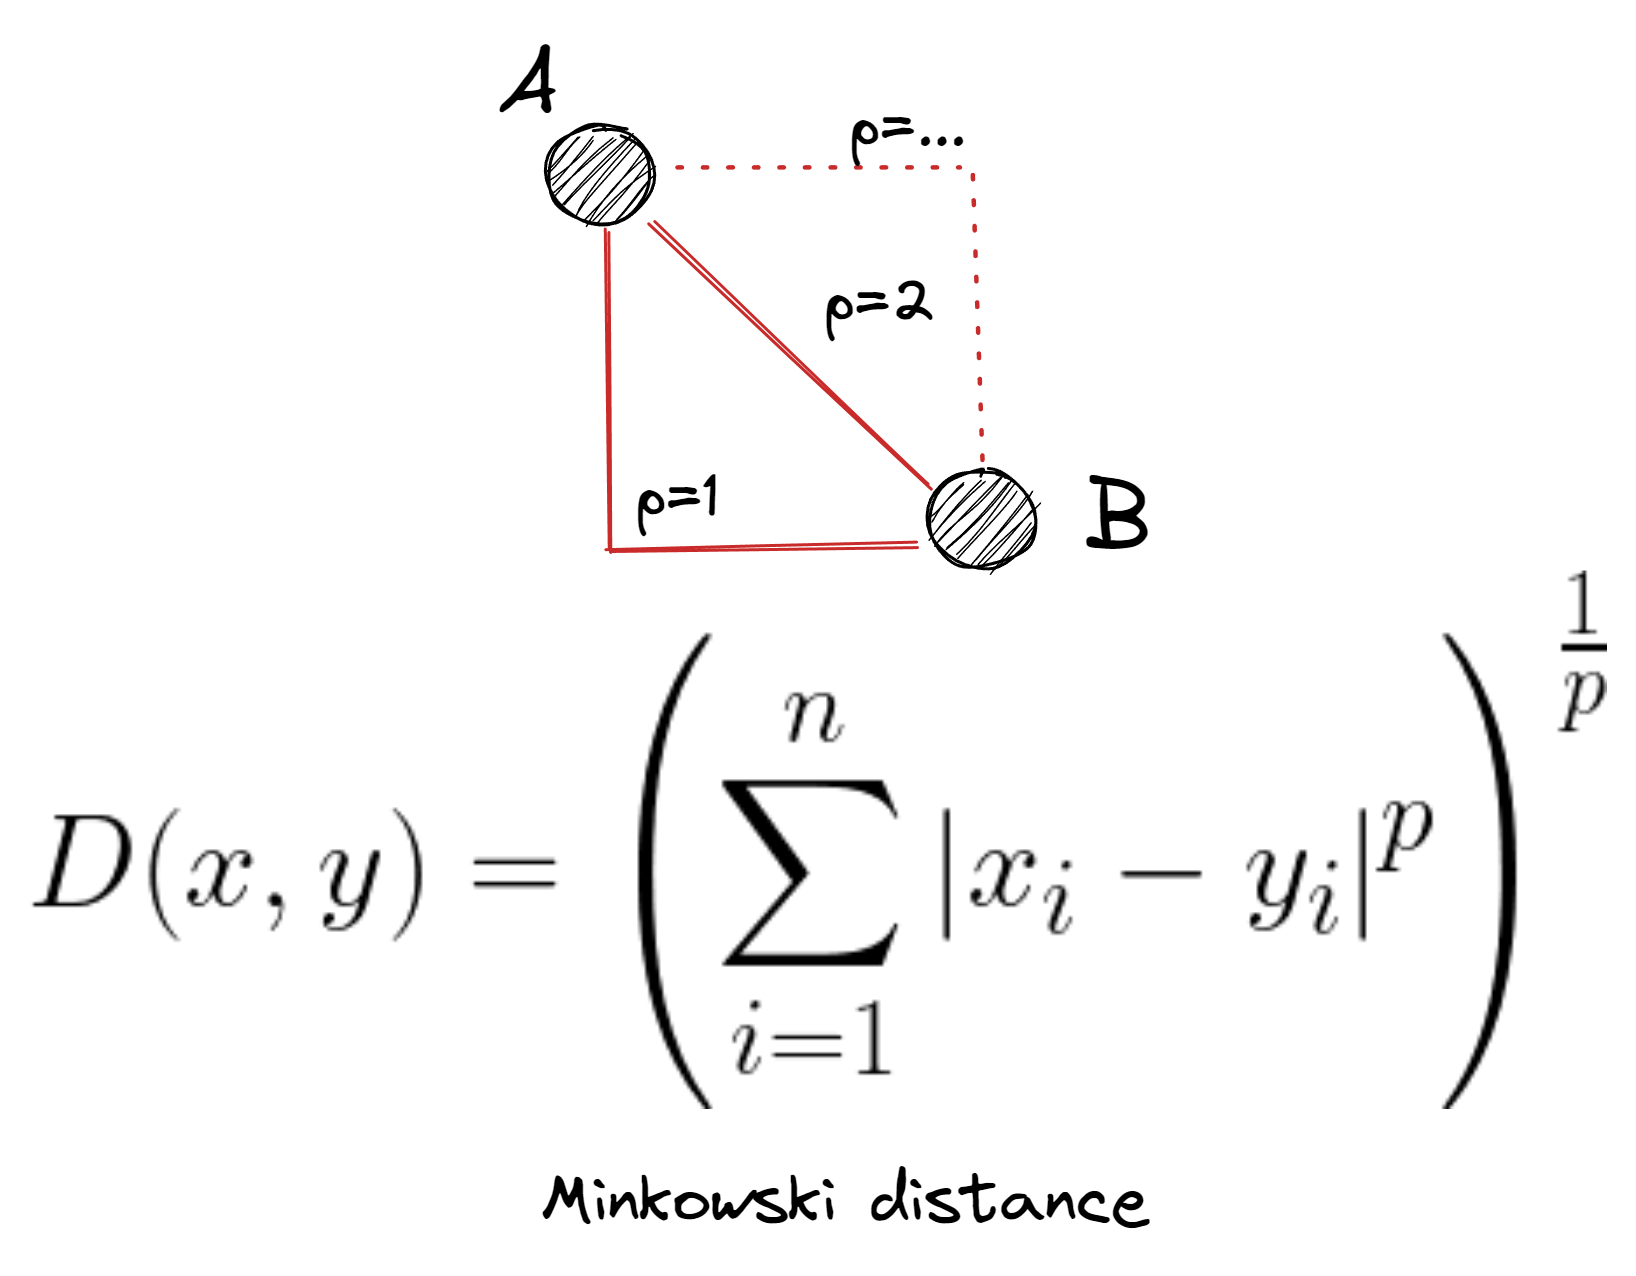
Minkowski distance

# Euclidean distance
knn = KNN(metric="minkowski", p=2)
# Manhattan distance
knn = KNN(metric="minkowski", p=1)

मिन्कोव्स्की डिस्टेंस का सूत्र और प्रक्रिया समझाने वाला विज़ुअल.

Python में Anomaly Detection

डिस्टेंस एग्रीगेशन

knn_largest = KNN(n_neighbors=10, method="largest")


knn_mean = KNN(n_neighbors=10, method="mean") knn_median = KNN(n_neighbors=10, method="median")
Python में Anomaly Detection

डिस्टेंस और मेथड ट्यून करना

ps = [1, 2, 3, 4]
methods = ["largest", "mean", "median"]
scores = dict()


for p, method in product(ps, methods): # Init an instance of KNN knn = KNN(n_neighbors=10, method=method, p=p, n_jobs=-1) # Find the inliers with the current KNN inliers = evaluate_outlier_classifier(knn, males_transformed, .55) # Calculate and store RMSE into scores scores[(p, method)] = evaluate_regressor(inliers)
Python में Anomaly Detection

परिणाम देखें

print(scores)
{(1, 'largest'): 23.188,
 (1, 'mean'): 23.188,
 (1, 'median'): 23.188,
 (2, 'largest'): 17.965,
 (2, 'mean'): 19.463,
 (2, 'median'): 19.463,
 (3, 'largest'): 17.965,
 (3, 'mean'): 19.463,
 (3, 'median'): 19.463, ...
}
Python में Anomaly Detection

अभ्यास करते हैं!

Python में Anomaly Detection

Preparing Video For Download...