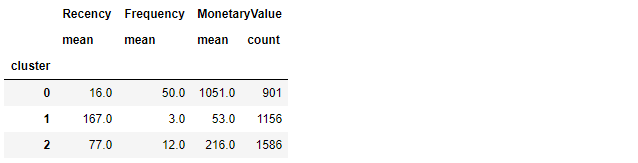सेगमेंट्स का प्रोफाइल बनाएँ और व्याख्या करें

Python में Customer Segmentation

Karolis Urbonas

Head of Data Science, Amazon

कस्टमर पर्सोना बनाने के तरीके

  • हर क्लस्टर के लिए समरी आँकड़े, जैसे औसत RFM मान
  • स्नेक प्लॉट्स (मार्केट रिसर्च से)
  • जनसंख्या की तुलना में क्लस्टर विशेषताओं की सापेक्ष महत्ता
Python में Customer Segmentation

हर क्लस्टर के समरी आँकड़े

  • सुझाए गए मान के आसपास कई k मानों के लिए k-means सेगमेंटेशन चलाएँ.
  • मूल DataFrame में क्लस्टर लेबल वाला कॉलम बनाएँ:

    datamart_rfm_k2 = datamart_rfm.assign(Cluster = cluster_labels)
    

    हर क्लस्टर के लिए औसत RFM मान और आकार निकालें:

    datamart_rfm_k2.groupby(['Cluster']).agg({
       'Recency': 'mean',
       'Frequency': 'mean',
       'MonetaryValue': ['mean', 'count'],
    }).round(0)
    
    • k=3 के लिए भी यही दोहराएँ
Python में Customer Segmentation

हर क्लस्टर के समरी आँकड़े

  • हर क्लस्टरिंग समाधान के औसत RFM मानों की तुलना करें
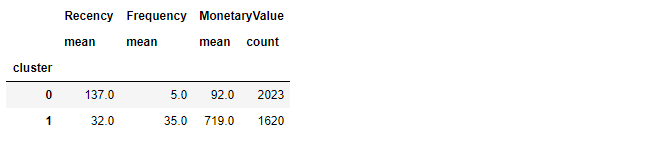
Python में Customer Segmentation

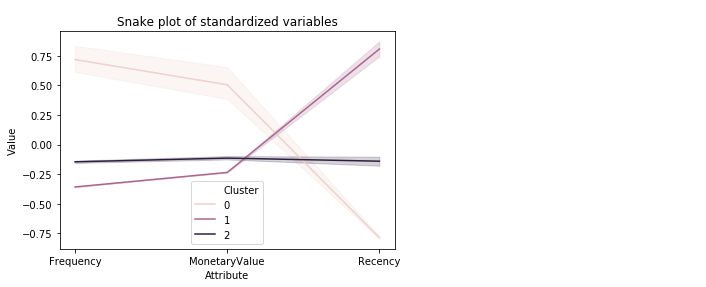
सेगमेंट समझने व तुलना के लिए स्नेक प्लॉट्स

  • अलग-अलग सेगमेंट्स की तुलना के लिए मार्केट रिसर्च तकनीक
  • हर सेगमेंट की विशेषताओं का विजुअल रिप्रेजेंटेशन
  • पहले डेटा को normalize करना होगा (center & scale)
  • हर क्लस्टर के प्रत्येक एट्रिब्यूट के औसत normalized मान प्लॉट करें
Python में Customer Segmentation

स्नेक प्लॉट के लिए डेटा तैयार करें

datamart_normalized को DataFrame में बदलें और Cluster कॉलम जोड़ें

datamart_normalized = pd.DataFrame(datamart_normalized, 
                                   index=datamart_rfm.index, 
                                   columns=datamart_rfm.columns)
datamart_normalized['Cluster'] = datamart_rfm_k3['Cluster']

डेटा को long फॉर्मेट में melt करें ताकि RFM मान और मेट्रिक नाम अलग-अलग 1 कॉलम में हों

datamart_melt = pd.melt(datamart_normalized.reset_index(), 
                    id_vars=['CustomerID', 'Cluster'],
                    value_vars=['Recency', 'Frequency', 'MonetaryValue'], 
                    var_name='Attribute', 
                    value_name='Value')
Python में Customer Segmentation

स्नेक प्लॉट विज़ुअलाइज़ करें

plt.title('Snake plot of standardized variables')
sns.lineplot(x="Attribute", y="Value", hue='Cluster', data=datamart_melt)
Python में Customer Segmentation

सेगमेंट विशेषताओं की सापेक्ष महत्ता

  • हर सेगमेंट की विशेषताओं की सापेक्ष महत्ता पहचानने की उपयोगी तकनीक
  • हर क्लस्टर के औसत मान निकालें
  • पूरी जनसंख्या के औसत मान निकालें
  • इन्हें भाग देकर और 1 घटाकर importance स्कोर निकालें (जब क्लस्टर औसत = जनसंख्या औसत हो तो 0 मिलता है)
cluster_avg = datamart_rfm_k3.groupby(['Cluster']).mean()

population_avg = datamart_rfm.mean()
relative_imp = cluster_avg / population_avg - 1
Python में Customer Segmentation

सापेक्ष महत्ता का विश्लेषण और प्लॉट करें

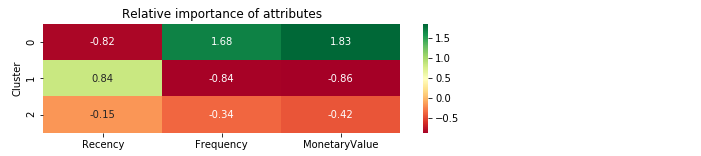
  • जैसे-जैसे अनुपात 0 से दूर जाए, कुल जनसंख्या की तुलना में सेगमेंट की एट्रिब्यूट महत्ता बढ़ती है.
relative_imp.round(2)
         Recency  Frequency  MonetaryValue
Cluster                                   
0          -0.82       1.68           1.83
1           0.84      -0.84          -0.86
2          -0.15      -0.34          -0.42
# Plot heatmap
plt.figure(figsize=(8, 2))
plt.title('Relative importance of attributes')
sns.heatmap(data=relative_imp, annot=True, fmt='.2f', cmap='RdYlGn')
plt.show()
Python में Customer Segmentation

सापेक्ष महत्ता हीटमैप

         Recency  Frequency  MonetaryValue
Cluster                                   
0          -0.82       1.68           1.83
1           0.84      -0.84          -0.86
2          -0.15      -0.34          -0.42
Python में Customer Segmentation

अब आपकी बारी: अलग-अलग कस्टमर प्रोफाइलिंग तकनीकों के साथ प्रयोग करें!

Python में Customer Segmentation

Preparing Video For Download...