वैरिएबल्स को सेंट्रिंग और स्केलिंग

Python में Customer Segmentation

Karolis Urbonas

Head of Data Science, Amazon

समस्या पहचानना

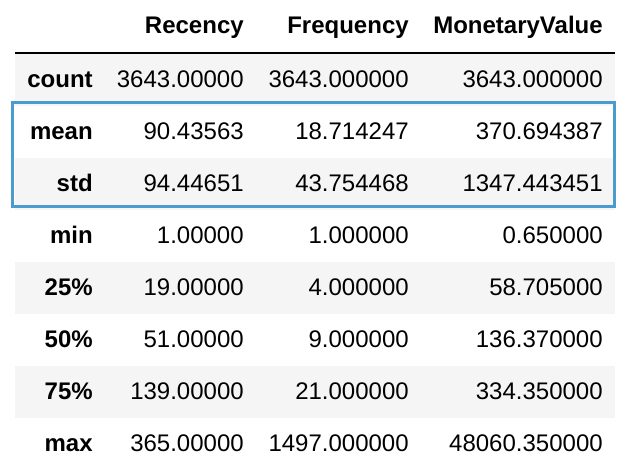
  • डेटासेट {{1}} की प्रमुख सांख्यिकीय जानकारी जाँचें
  • औसत और स्टैंडर्ड डिविएशन की तुलना करें
datamart_rfm.describe()

Python में Customer Segmentation

अलग-अलग औसत वाले वैरिएबल्स की सेंट्रिंग

  • K-means उन वैरिएबल्स पर बेहतर काम करता है जिनका औसत समान हो
  • सेंट्रिंग में हर ऑब्ज़र्वेशन से औसत घटाया जाता है
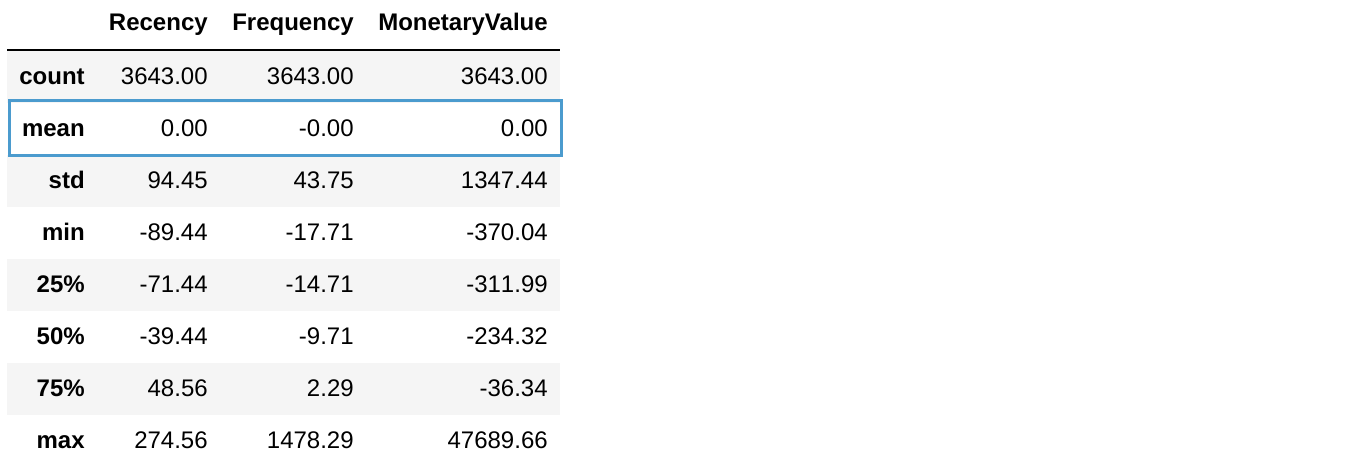
datamart_centered = datamart_rfm - datamart_rfm.mean()
datamart_centered.describe().round(2)
Python में Customer Segmentation

अलग-अलग variance वाले वैरिएबल्स की स्केलिंग

  • K-means समान variance/स्टैंडर्ड डिविएशन वाले वैरिएबल्स पर बेहतर चलता है
  • स्केलिंग में हर वैरिएबल को उसके स्टैंडर्ड डिविएशन से भाग दिया जाता है
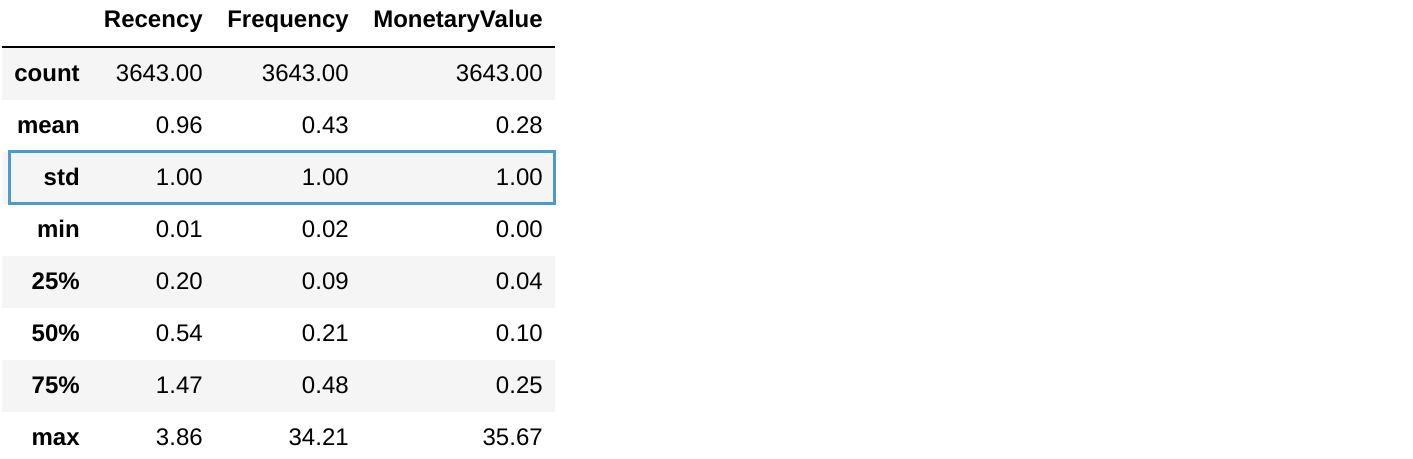
datamart_scaled = datamart_rfm / datamart_rfm.std()
datamart_scaled.describe().round(2)
Python में Customer Segmentation

सेंट्रिंग और स्केलिंग को साथ में लागू करना

  • मैन्युअल रूप से औसत घटाएँ और स्टैंडर्ड डिविएशन से भाग दें
  • या scikit-learn लाइब्रेरी का स्केलर उपयोग करें (जो numpy.ndarray ऑब्जेक्ट लौटाता है)
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
scaler.fit(datamart_rfm)
datamart_normalized = scaler.transform(datamart_rfm)

print('mean: ', datamart_normalized.mean(axis=0).round(2)) print('std: ', datamart_normalized.std(axis=0).round(2))
mean:  [-0. -0.  0.]
std:  [1. 1. 1.]
Python में Customer Segmentation

खुद अलग-अलग तरीके आज़माएँ!

Python में Customer Segmentation

Preparing Video For Download...