Normality tests

Python में अनुमान का आधार

Paul Savala

Assistant Professor of Mathematics

US पुरुषों की ऊँचाई
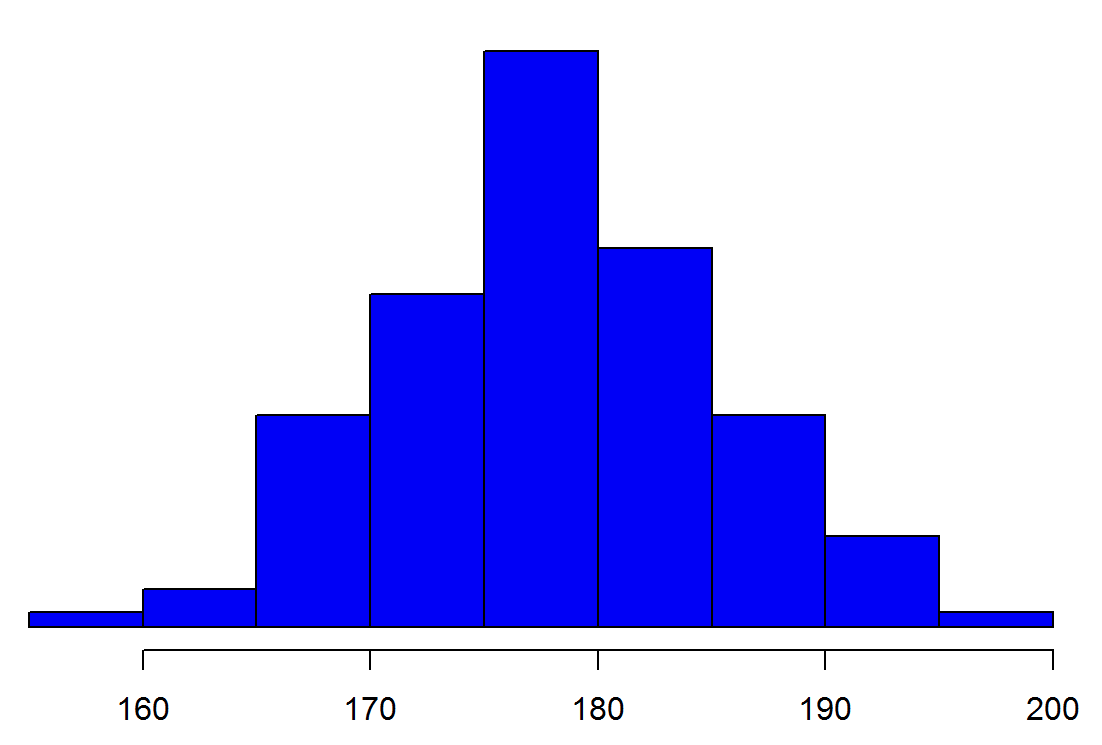
एक हिस्टोग्राम जो लगभग नॉर्मल वितरित है; औसत कद 180 सेंटीमीटर, न्यूनतम 160 सेंटीमीटर, अधिकतम 200 सेंटीमीटर।

Python में अनुमान का आधार

मॉडल अवशेष

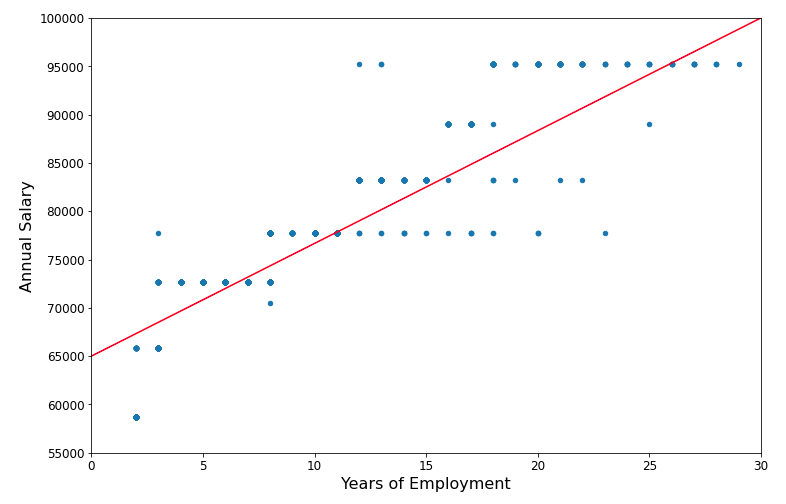
एक स्कैटर प्लॉट: x-अक्ष पर नौकरी के साल, y-अक्ष पर वार्षिक सैलरी, और सामान्यतः पॉजिटिव लीनियर ट्रेंड। डेटा पर एक लाल बेस्ट-फिट लाइन भी है।

पूर्वानुमान रेखा के ऊपर-नीचे अवशेष समान हों, यही अपेक्षा

Python में अनुमान का आधार

मॉडल अवशेष

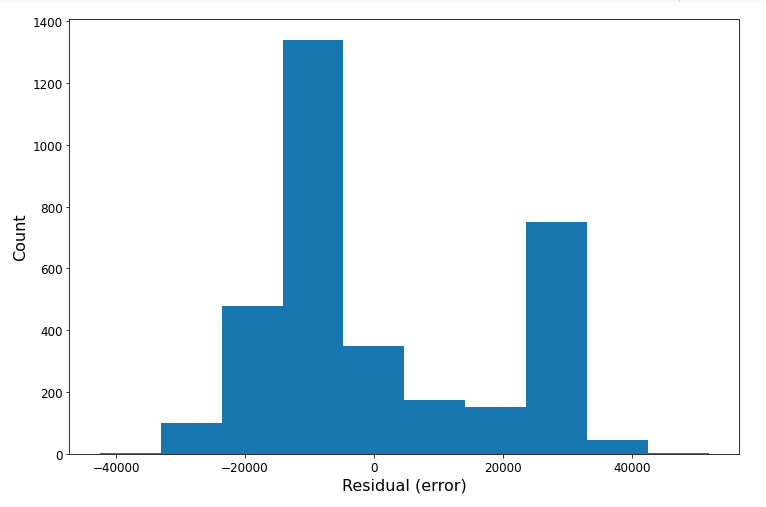
एक हिस्टोग्राम: x-अक्ष "residual (error)", y-अक्ष "count"; द्विशीर्षकीय वितरण, एक मोड लगभग माइनस दस हज़ार और दूसरा लगभग प्लस तीस हज़ार।

Python में अनुमान का आधार

नॉर्मल डिस्ट्रीब्यूशंस के उपयोग

  • पैरामेट्रिक टेस्ट: नॉर्मलिटी मानकर की जाने वाली हाइपोथेसिस टेस्ट
  • औसत तुलना के लिए T-test:
    • मानता है कि सैंपल मीन्स नॉर्मल वितरित हैं
    • यदि नहीं, तो निष्कर्ष अमान्य होंगे
Python में अनुमान का आधार

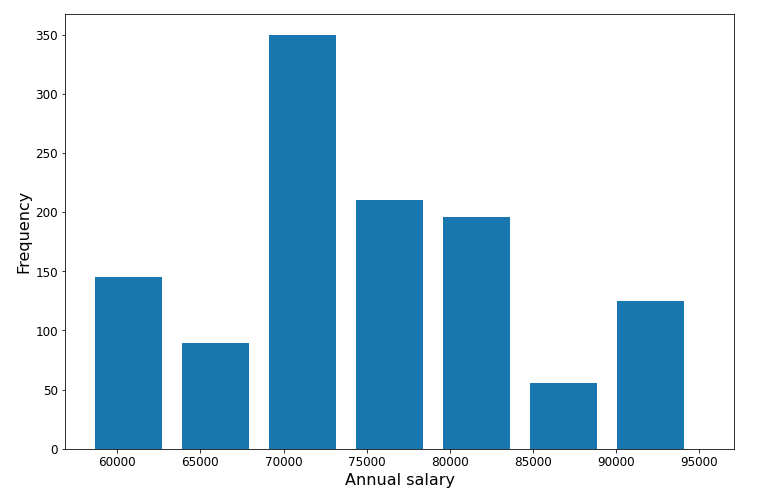
एक हिस्टोग्राम: x-अक्ष पर सैलरी 60,000 से 95,000 के बीच, y-अक्ष पर फ्रीक्वेंसी। हिस्टोग्राम काफ़ी हद तक नॉर्मल दिखता है।

Python में अनुमान का आधार

नॉर्मलिटी के लिए Anderson-Darling टेस्ट

  • नॉर्मलिटी की धारणा की जाँच

$H_0$: डेटा नॉर्मल वितरित है

$H_a$: डेटा नॉर्मल वितरित नहीं है

Python में अनुमान का आधार

SciPy में Anderson-Darling टेस्ट

result = stats.anderson(police_df['Annual Salary'])

result.statistic
27.41
result.critical_values
[0.574, 0.654, 0.784, 0.915, 1.088]
result.significance_level[result.statistic > result.critical_values]
[15.  10.   5.   2.5  1. ]
Python में अनुमान का आधार

नॉर्मल डिस्ट्रीब्यूशन फिट करना

mu, std = stats.norm.fit(police_df['Annual Salary'])

estimated_pct_under_70k = stats.norm.cdf(70000, loc=mu, scale=std)
print(estimated_pct_under_70k)
0.27
actual_under_70k = police_df[police_df['Annual Salary'] < 70000]

print(len(actual_under_70k) / len(police_df))
0.20
Python में अनुमान का आधार

अभ्यास करते हैं!

Python में अनुमान का आधार

Preparing Video For Download...