Python में अनुमान का आधार
Paul Savala
Assistant Professor of Mathematics


$n_1 = \text{पहले समूह का sample size}$
$n_2 = \text{दूसरे समूह का sample size}$
$s_1 = \text{पहले समूह का standard deviation}$
$s_2 = \text{दूसरे समूह का standard deviation}$
$\overline{x}_1 = \text{पहले समूह का mean}$
$\overline{x}_2 = \text{दूसरे समूह का mean}$
$s = \displaystyle\sqrt{\frac{(n_1-1)s_1^2 + (n_2-1)s_2^2}{n_1 + n_2 - 2}}$
Cohen's $d = \displaystyle\frac{\overline{x}_1 - \overline{x}_2}{s}$
Cohen's $d = 0.6$
मध्यम से बड़ा effect size
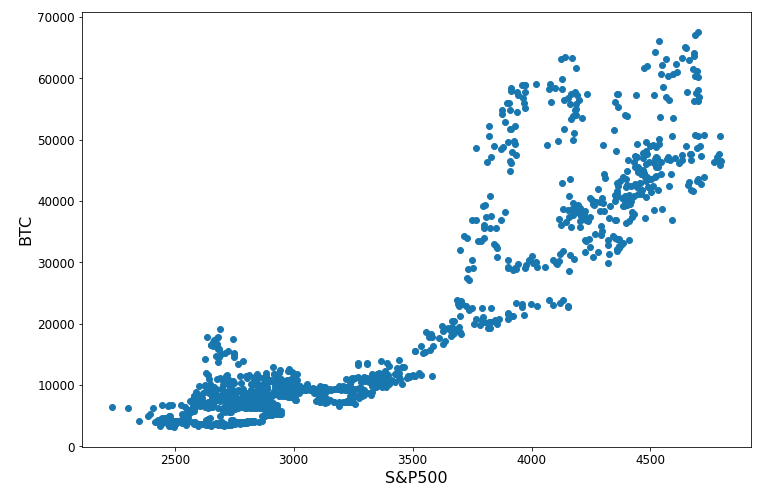
r, p_value = stats.pearsonr( btc_sp_df['Close_BTC'], btc_sp_df['Close_SP500'] )print(r**2)
0.82
$R^2:$ एक वैरिएबल में variation का वह प्रतिशत, जो दूसरे को जानने से समझाया जाता है

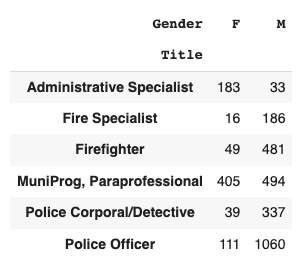
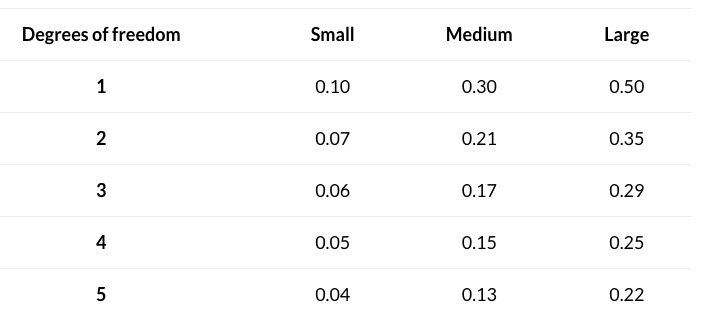
Cramer's $V = \displaystyle\sqrt{\frac{\chi^2/n}{d}}$
chi2, p, d, e = stats.chi2_contingency( contingency_table)dof = min(6-1, 2-1) = 1 n = 3394v = np.sqrt((chi2 / n) / dof)
v = 0.52

Cramer's V = 0.52, Degrees of Freedom = 1
Python में अनुमान का आधार