SAS उपयोगकर्ताओं के लिए R
Melinda Higgins, PhD
Research Professor/Senior Biostatistician Emory University

x बनाएँx को 4 असाइन करेंx देखें[1] दिखाता है कि x में 1 एलिमेंट हैy को x के स्क्वेयर के रूप में बनाएँy टाइप करेंx <- 4
x
[1] 4
y <- x * x
y
[1] 16
y में असाइन करेंFALSE को z में असाइन करेंy और z देखेंy <- "fish"
z <- FALSE
y
z
[1] "fish"
[1] FALSE
# तीन संख्याएँ जोड़ें
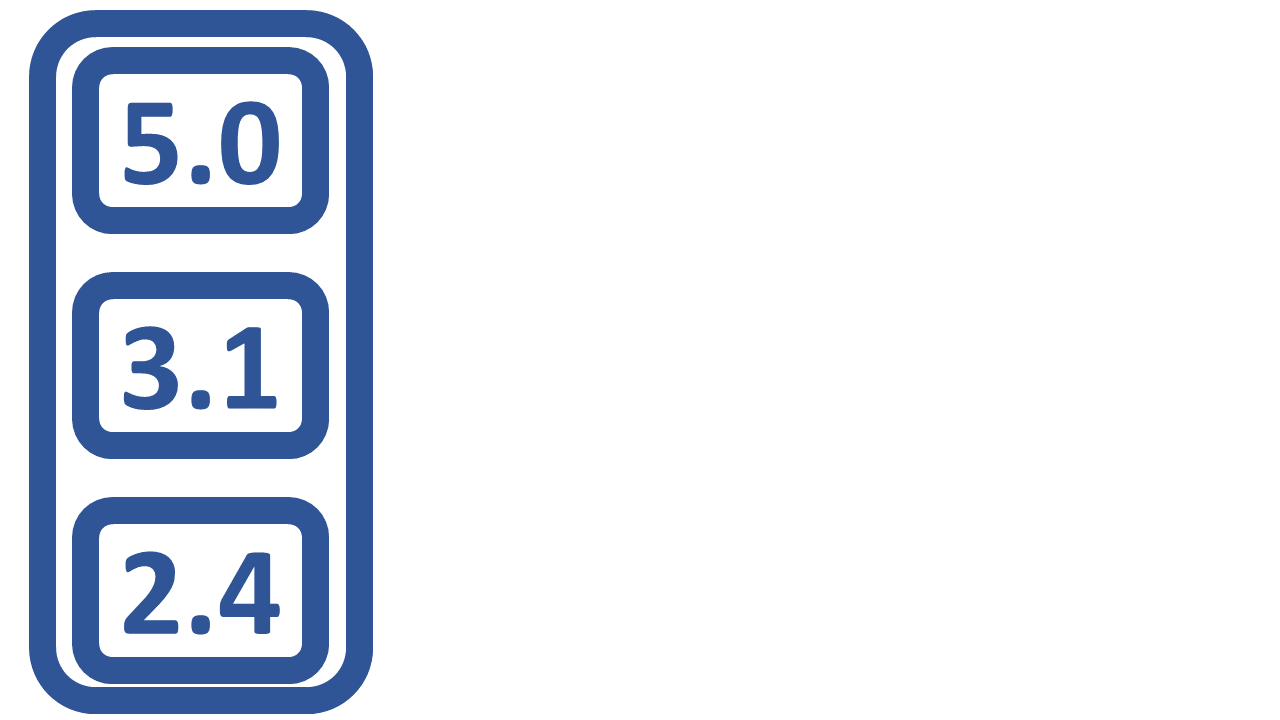
c(5, 3, 2)

# न्यूमेरिक वेक्टर x असाइन करें
x <- c(5, 3, 2)
# परिणाम देखें
x
Result
[1] 5 3 2

# शब्द child को कैरेक्टर वेक्टर में जोड़ें
y <- c("child")

# दूसरा शब्द young जोड़ें
y <- c("child", "young")

# तीसरा शब्द old जोड़ें
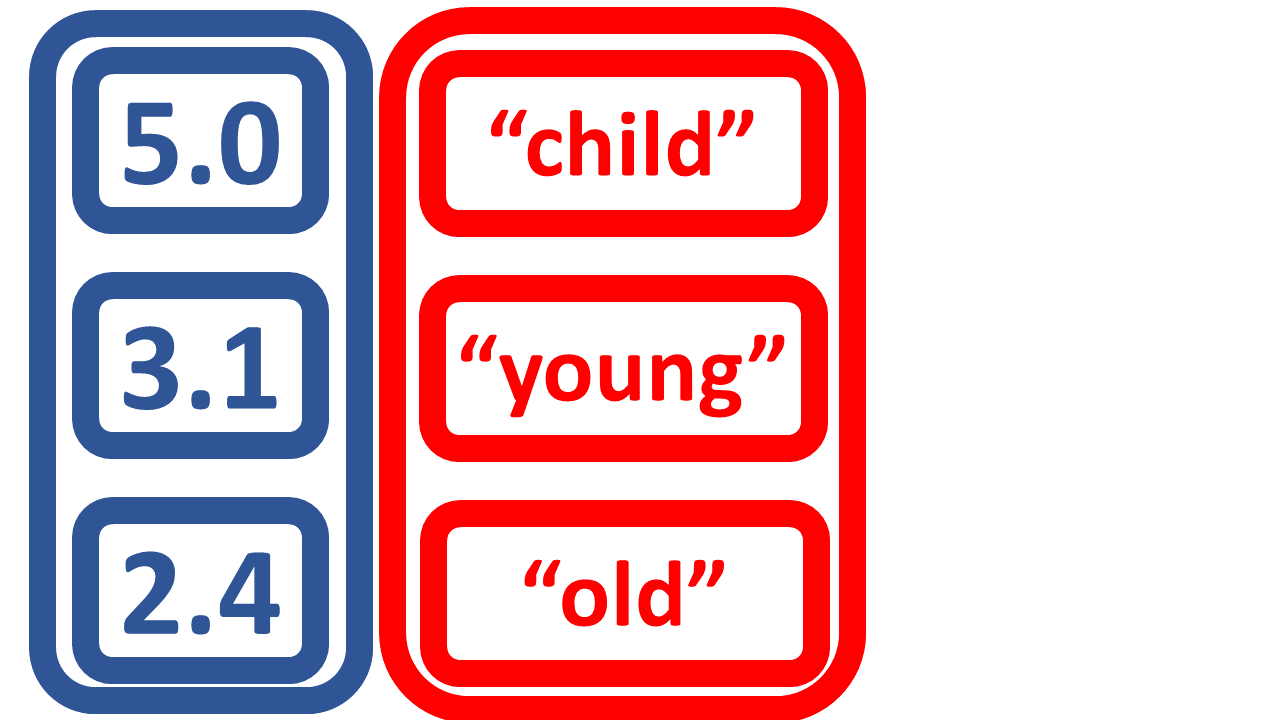
y <- c("child", "young", "old")
# y देखें
y
Result
[1] "child" "young" "old"

# TRUE को लॉजिकल वेक्टर में जोड़ें
z <- c(TRUE)
TRUE हैTRUE या FALSE होते हैंALL CAPS का उपयोग ज़रूरी हैT और F भी चल सकते हैं
# दूसरा एलिमेंट FALSE जोड़ें
z <- c(TRUE, FALSE)

# तीसरा एलिमेंट TRUE जोड़ें
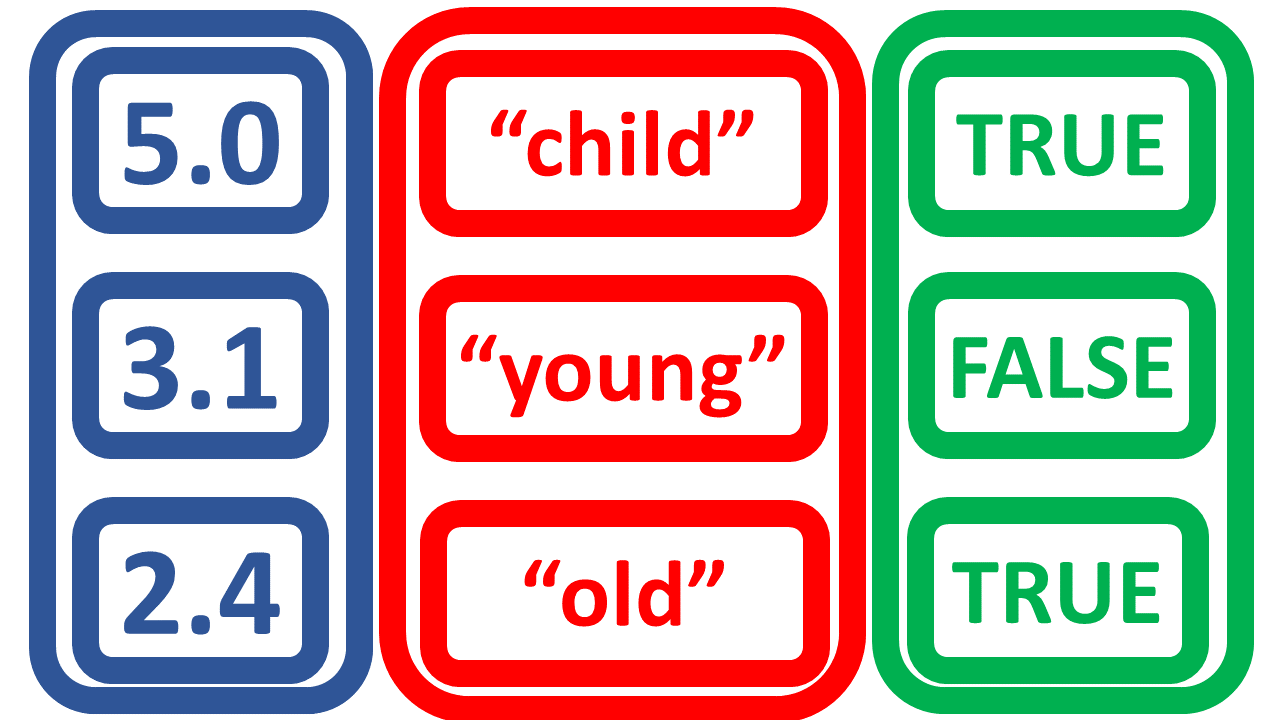
z <- c(TRUE, FALSE, TRUE)
# z देखें
z
Result
[1] TRUE FALSE TRUE

# न्यूमेरिक वेक्टर a बनाएँ
a <- c(5.0, 3.1, 2.4)

# न्यूमेरिक वेक्टर a बनाएँ
a <- c(5.0, 3.1, 2.4)
# न्यूमेरिक वेक्टर b बनाएँ
b <- c(4.1, 2.2, 5.4)

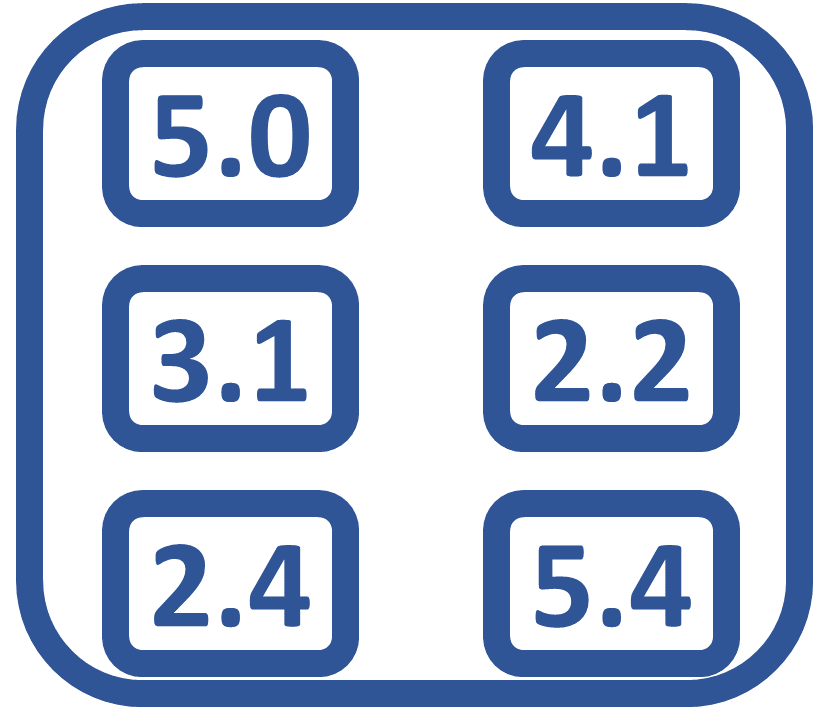
# a,b से 3 पंक्तियाँ, 2 कॉलम वाला m बनाएँ
m <- matrix(c(a, b),
nrow = 3,
ncol = 2)
# m देखें
m
[,1] [,2]
[1,] 5.0 4.1
[2,] 3.1 2.2
[3,] 2.4 5.4

# न्यूमेरिक वैरिएबल score बनाएँ
score <- c(5.0, 3.1, 2.4)
# score देखें
score
5.0 3.1 2.4
# कैरेक्टर वैरिएबल age बनाएँ
age <- c("child","young","old")
# age देखें
age
"child" "young" "old"
# लॉजिकल वैरिएबल test बनाएँ
test <- c(TRUE, FALSE, TRUE)
# test देखें
test
TRUE FALSE TRUE
# मिलाकर डेटा फ्रेम बनाएँ
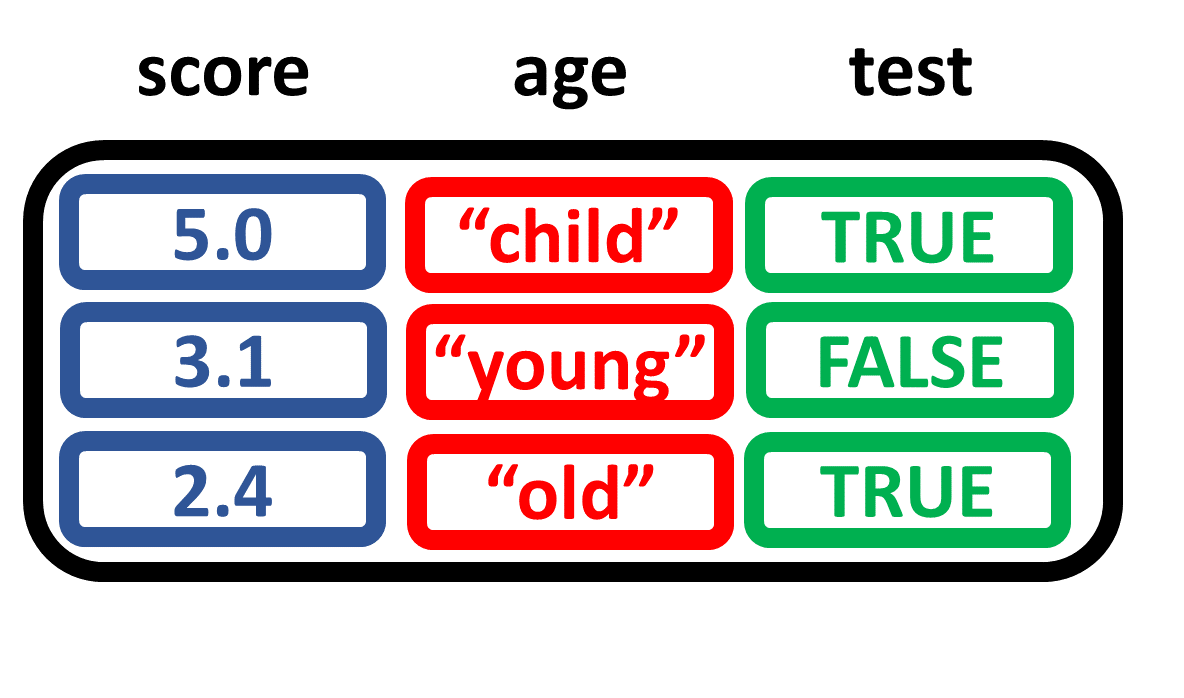
d <- data.frame(score, age, test)
# डेटा फ्रेम देखें
d
score age test
5.0 child TRUE
3.1 young FALSE
2.4 old TRUE

x बनाएँx की class जाँचेंx की संरचना str देखेंx <- c(5, 3, 2)
class(x)
[1] "numeric"
str(x)
num [1:3] 5 3 2
y; लॉजिकल वेक्टर zy और z की class जाँचेंy और z की संरचना str देखेंstr(y)
chr [1:3] "child" "young" "old"
str(z)
logi [1:3] TRUE FALSE TRUE
y <- c("child","young","old")
z <- c(TRUE, FALSE, TRUE)
class(y)
[1] "character"
class(z)
[1] "logical"
m बनाएँm की class पाएँm की संरचना str देखेंstr(m)
num [1:3, 1:2] 5 3.1 2.4 4.1 2.2 5.4
a <- c(5.0, 3.1, 2.4)
b <- c(4.1, 2.2, 5.4)
m <- matrix(c(a, b),
nrow = 3,
ncol = 2)
class(m)
[1] "matrix"
data.frame d बनाएँd की class पाएँd की संरचना str देखेंstr(d)
'data.frame': 3 obs. of 3 variables:
$ score: num 5 3.1 2.4
$ age : Factor w/ 3 levels
"child","old",..: 1 3 2
$ test : logi TRUE FALSE TRUE
score <- c(5.0, 3.1, 2.4)
age <- c("child","young","old")
test <- c(TRUE, FALSE, TRUE)
d <- data.frame(score, age, test)
class(d)
[1] "data.frame"
SAS उपयोगकर्ताओं के लिए R