क्लस्टरिंग और क्लस्टर मॉडल

Python में Discrete Event Simulation

Diogo Costa (PhD, MSc)

Adjunct Professor, University of Saskatchewan, Canada & CEO of ImpactBLUE-Scientific

मॉडल परिणामों के हिस्टोग्राम

  • मॉडल परिणामों को एक्सप्लोर करें
  • टिपिंग पॉइंट्स और बॉटलनेक्स पहचानें
  • सिस्टम ऑप्टिमाइज़ करें

हिस्टोग्राम

  • फ्रीक्वेंसी डिस्ट्रीब्यूशंस दिखाने वाला ग्राफ
  • दिए गए इंटरवल पर ऑब्ज़र्वेशंस की संख्या देता है

Matplotlib पैकेज

import matplotlib.pyplot as plt

उपयोग: डेटासेट data का 50 बिन्स वाला हिस्टोग्राम बनाएँ

plt.hist(data, bins=50)
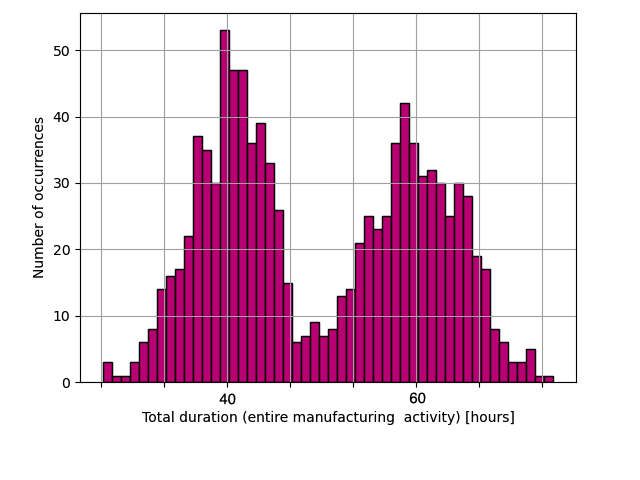
50 डेटा बिन्स वाला हिस्टोग्राम, दो Gaussian डिस्ट्रीब्यूशंस दिखाता है, जो दो डेटा क्लस्टर्स का संकेत देता है.

Python में Discrete Event Simulation

क्लस्टर विश्लेषण और मॉडलों में उपयोग

  • एप्लिकेशंस
    • पैटर्न रिकग्निशन (जैसे, मॉडल परिणाम)
    • इमेज एनालिसिस

उत्तरी अमेरिका में रात की रोशनी की सैटेलाइट इमेज.

  • डेटा कंप्रेशन
  • कंप्यूटर ग्राफ़िक्स
  • मशीन लर्निंग

    दिमाग़ के अंदर न्यूरॉन नेटवर्क का चित्र, जो मशीन लर्निंग, पैटर्न उभरने, और क्लस्टरिंग की ओर संकेत करता है.

  • डिस्क्रीट-इवेंट मॉडल्स में

    • मॉडल आउटपुट पैटर्न पहचानें
    • अधिक एक्शन योग्य जानकारी
Python में Discrete Event Simulation

k-means क्लस्टरिंग

हमारा फोकस

  • k-means क्लस्टरिंग (सेंट्रोइड मॉडल)
  • ऑब्ज़र्वेशंस को k क्लस्टर्स में बाँटना
  • हर ऑब्ज़र्वेशन निकटतम माध्य वाले क्लस्टर में जाता है
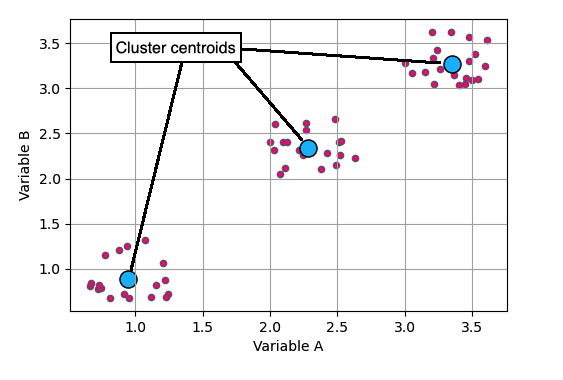
  • क्लस्टर्स के माध्य को "क्लस्टर सेंट्रोइड्स" कहते हैं

ऑब्ज़र्वेशंस और क्लस्टर सेंट्रोइड्स

ग्राफ़ जिसमें k-means क्लस्टरिंग से निकले क्लस्टर सेंट्रोइड्स के साथ डेटा दिखाया गया है.

Python में Discrete Event Simulation

SciPy के साथ k-means क्लस्टरिंग

SciPy मेथड

scipy.cluster.vq.kmeans()

इम्प्लीमेंटेशन

import scipy
scipy.cluster.vq.kmeans(
obs, k_or_guess, iter=20, thresh=1e-05,
check_finite=True, *, seed=None)
  • obs एक numpy array है
  • रिटर्न करता है:
    1. क्लस्टर सेंट्रोइड्स
    2. डिस्टॉर्शन (ऑब्ज़र्वेशंस और बने सेंट्रोइड्स के बीच औसत दूरी)
Python में Discrete Event Simulation

डेटा व्हाइटनिंग: डिकॉरिलेशन और रिस्केलिंग

k-means चलाने से पहले: डेटा व्हाइटनिंग

  1. obs डेटा को डिकॉरिलेट करें
  2. obs के हर डायमेंशन को उसकी स्टैंडर्ड डिविएशन से रिस्केल करें
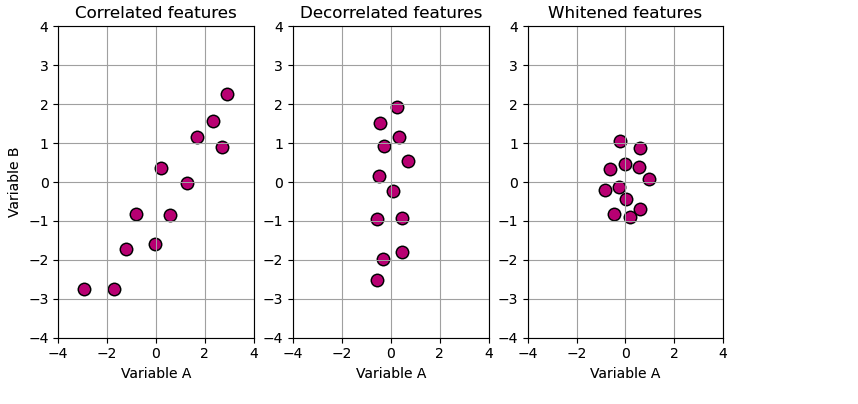
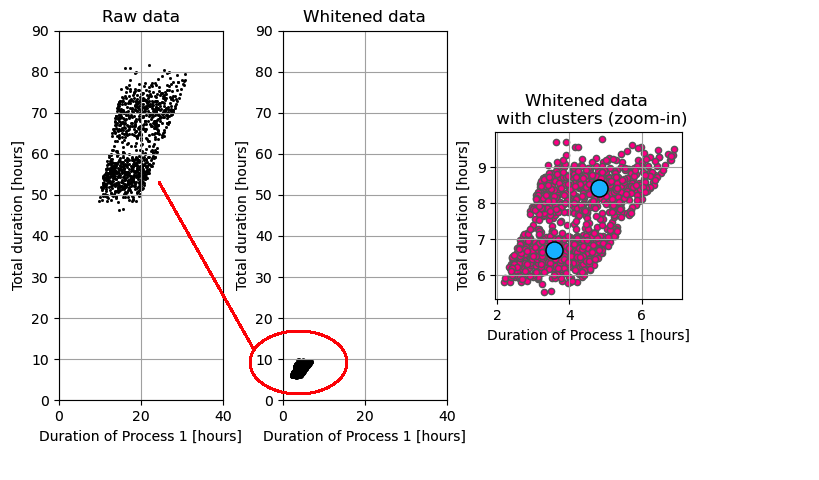
प्लॉट के तीन पैनल: पहले में कॉरिलेटेड डेटा, दूसरे में डिकॉरिलेटेड डेटा, तीसरे में व्हाइटन्ड डेटा.

SciPy में

scipy.cluster.vq.whiten(
obs, check_finite=True)
  • obs एक numpy array है
Python में Discrete Event Simulation

व्हाइटनिंग और k-means का उदाहरण

  • कई प्रक्रियाओं वाली मैन्युफैक्चरिंग एक्टिविटी
  • आइए Process 1 के प्रभाव की जाँच करें

DNT_CURLY_TAG_2 प्लॉट: प्रोसेस 1 की अवधि बनाम कुल अवधि, रॉ और व्हाइटन्ड डेटा पर, k-means क्लस्टर्स के साथ.

पैकेज इम्पोर्ट करें

import scipy.cluster.vq as scvq

मॉडल परिणाम व्हाइटन करें

white_data = scvq.whiten(model_results)

2 क्लस्टर्स खोजें (नीले डॉट्स)

cluster_centroids, distortion = 
scvq.kmeans(white_data, 2)
Python में Discrete Event Simulation

क्लस्टर्स की उत्तम संख्या

टेक्नीक्स

  • सिंपल मेथड (क्लस्टर्स की अधिकतम संख्या)
  • एल्बो मेथड
  • सिल्हूएट स्कोर कोएफ़िशिएंट
  • गैप स्टैटिस्टिक

सिंपल मेथड

  • क्लस्टर्स की अधिकतम संख्या तय करें
  • उपयोग कैसे करें: $\Big(\dfrac{nobs}{2}\Big)^{0.5}$
    • nobs = ऑब्ज़र्वेशंस की संख्या
num_clusters = 
  int((model_results.shape[0]/2)**0.5)
  • कंसोल आउटपुट
    22
    
Python में Discrete Event Simulation

क्लस्टर्स की उत्तम संख्या: सिल्हूएट-स्कोर विधि

  • लाइब्रेरीज़ इम्पोर्ट करें
from sklearn.metrics import silhouette_score

k क्लस्टर्स के लिए सिल्हूएट स्कोर निकालें

for k in range(2, 6):
  model = KMeans(n_clusters=k)
  model.fit(model_results)
  pred = model.predict(model_results)
  score = silhouette_score(model_results, pred)

कंसोल आउटपुट

Silhouette Score for k = 2: 0.591
Silhouette Score for k = 3: 0.472
Silhouette Score for k = 4: 0.381
Silhouette Score for k = 5: 0.364
Silhouette Score for k = 6: 0.373

परिणाम समझें

  • सर्वोत्तम मान: score = 1 DNT_CURLY_TAG_6
  • सबसे खराब मान: score = -1 DNT_CURLY_TAG_6
  • ओवरलैपिंग क्लस्टर्स: score 0 के पास
Python में Discrete Event Simulation

अभ्यास करते हैं!

Python में Discrete Event Simulation

Preparing Video For Download...