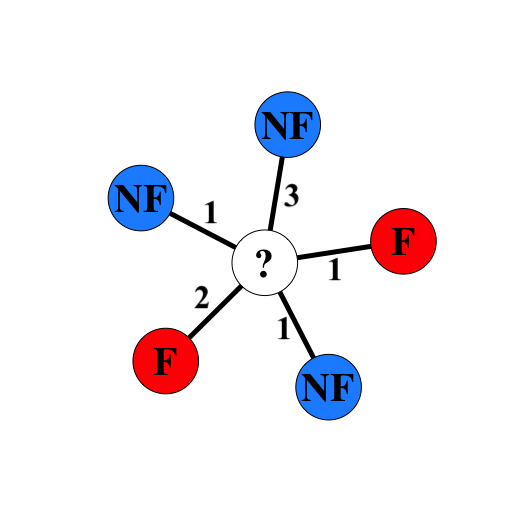
सोशल नेटवर्क आधारित इनफेरेंस
R में Fraud Detection

Tim Verdonck
Professor Data Science at KU Leuven
सोशल नेटवर्क आधारित इनफेरेंस
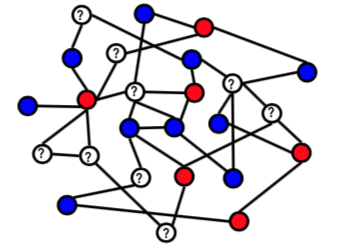
सोशल नेटवर्क आधारित इनफेरेंस
नॉन-रिलेशनल बनाम रिलेशनल
नॉन-रिलेशनल मॉडल
- केवल लोकल जानकारी उपयोग करता है
- Logistic regression, decision trees, ...
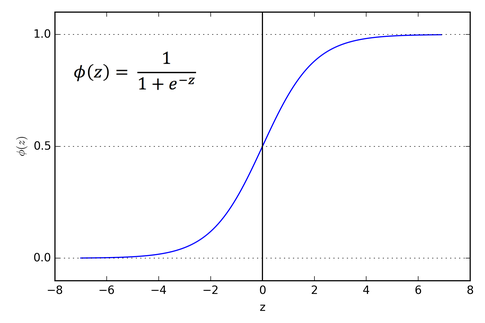
रिलेशनल मॉडल
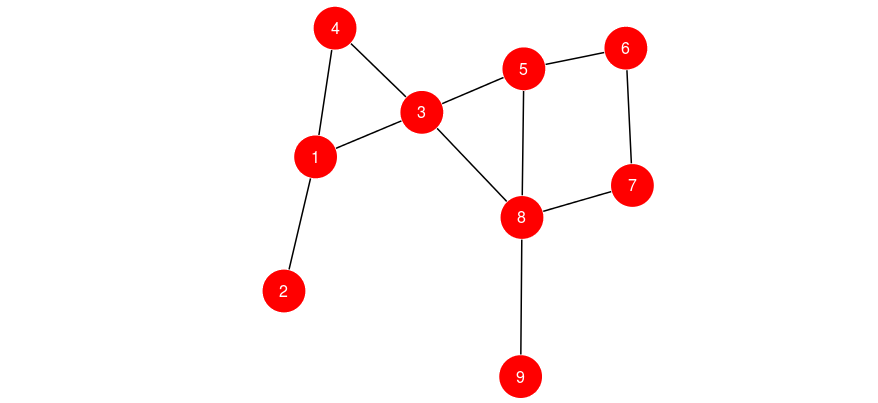
- नेटवर्क की लिंक्स का उपयोग करता है
- रिलेशनल नेighbor क्लासिफायर
रिलेशनल नेighbor क्लासिफायर
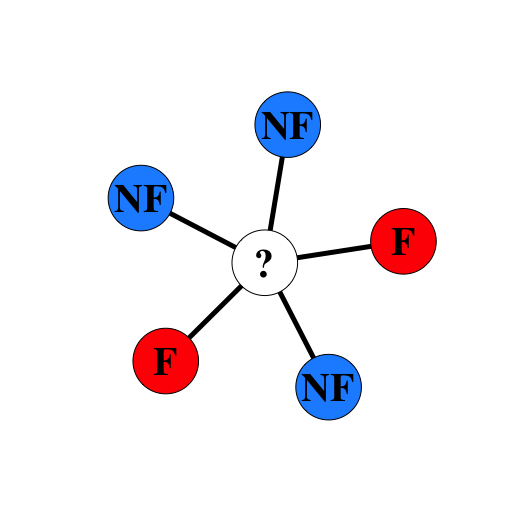
रिलेशनल नेighbor क्लासिफायर
वेट्स के साथ रिलेशनल नेighbor क्लासिफायर