R में Fraud Detection
Bart Baesens
Professor Data Science at KU Leuven
बेहतर है कि 1000 से अधिक संख्याएँ हों जो कई ऑर्डर्स में फैली हों।
ध्यान दें कि कभी-कभी डेटा Benford's Law से मेल नहीं भी खा सकता है.
किसी डेटासेट में पहले दो अंकों के लिए Benford's Law संतोषजनक है यदि पहले दो अंक $D_1D_2$ के $d_1d_2$ होने की प्रायिकता लगभग यह हो:
$$P(D_1D_2=d_1d_2)=\log\left(1+\frac{1}{d_1d_2}\right) \qquad d_1d_2\in [10, 11, ..., 98, 99]$$
benlaw <- function(d) log10(1 + 1 / d)
benlaw(12)
0.03476211
यह परीक्षण पहले अंक वाले परीक्षण से अधिक विश्वसनीय है और धोखाधड़ी पहचान में सबसे अधिक उपयोग होता है।
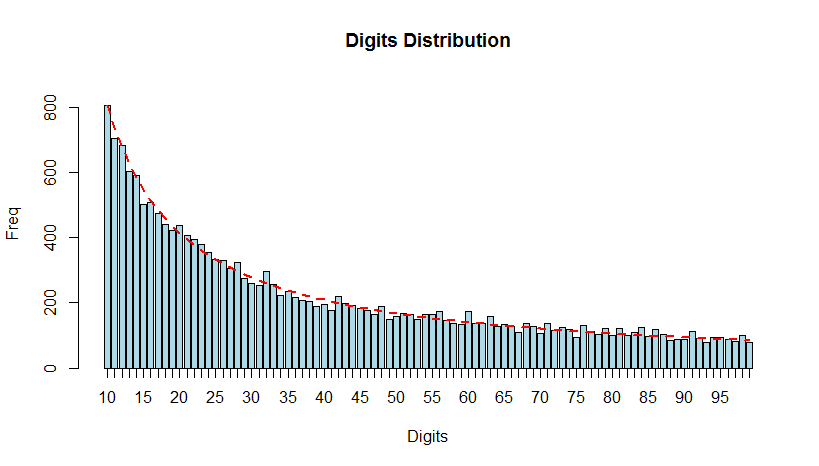
bfd.cen <- benford(census.2009$pop.2009, number.of.digits = 2)
plot(bfd.cen)
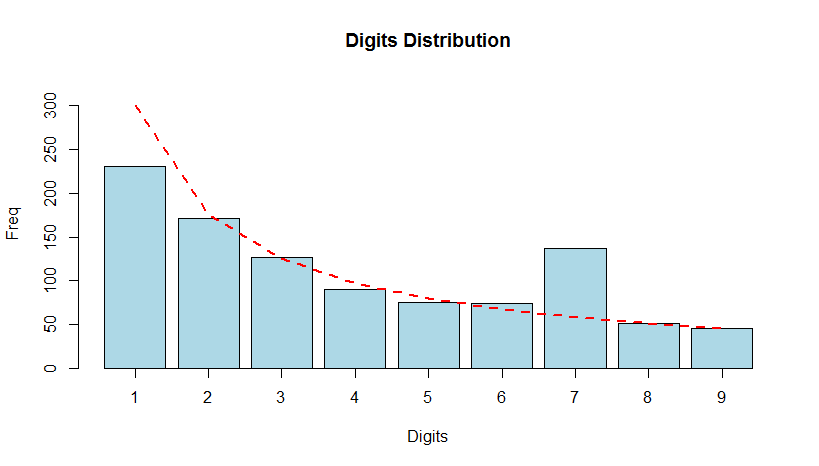
expenses में 1000 प्रतिपूर्ति प्रविष्टियाँ हैं।benford.analysis के फंक्शन का उपयोग करेंगे।bfd1.exp <- benford(expenses, number.of.digits = 1)
plot(bfd1.exp)
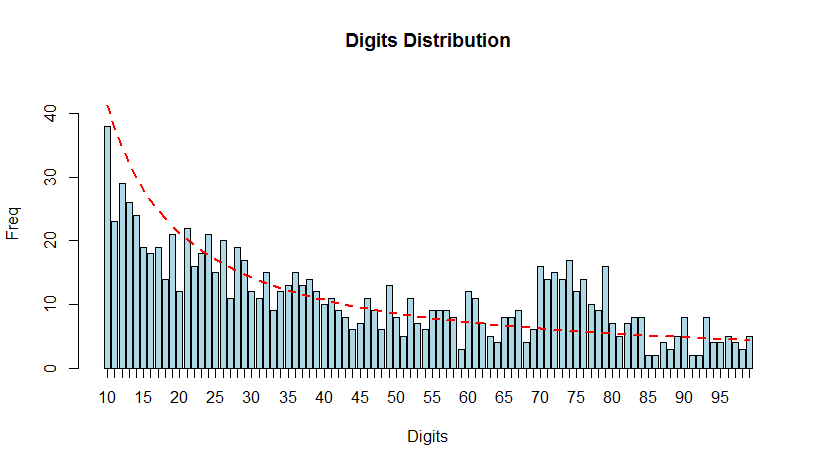
bfd2.exp <- benford(expenses, number.of.digits = 2)
plot(bfd2.exp)
R में Fraud Detection