सिंथेटिक ओवर-सैंपलिंग

R में Fraud Detection

Sebastiaan Höppner

PhD researcher in Data Science at KU Leuven
'SMOTE' के साथ ओवर-सैंपलिंग

  • SMOTE: Synthetic Minority Oversampling TEchnique (Chawla et al., 2002)
  • सिंथेटिक माइनोरिटी केस बनाकर माइनोरिटी क्लास (= fraud) को ओवर-सैंपल करें
R में Fraud Detection
dim(transfer_data)
1000    4
head(transfer_data)
  isFraud    amount   balance     ratio
1   false  528.6840 1529.4732 0.3456641
2   false  184.0193  836.3509 0.2200265
3   false 1885.8024 2984.0684 0.6319568
4   false  732.0286 1248.7217 0.5862224
prop.table(table(transfer_data$isFraud))
 false  true
  0.99  0.01
R में Fraud Detection

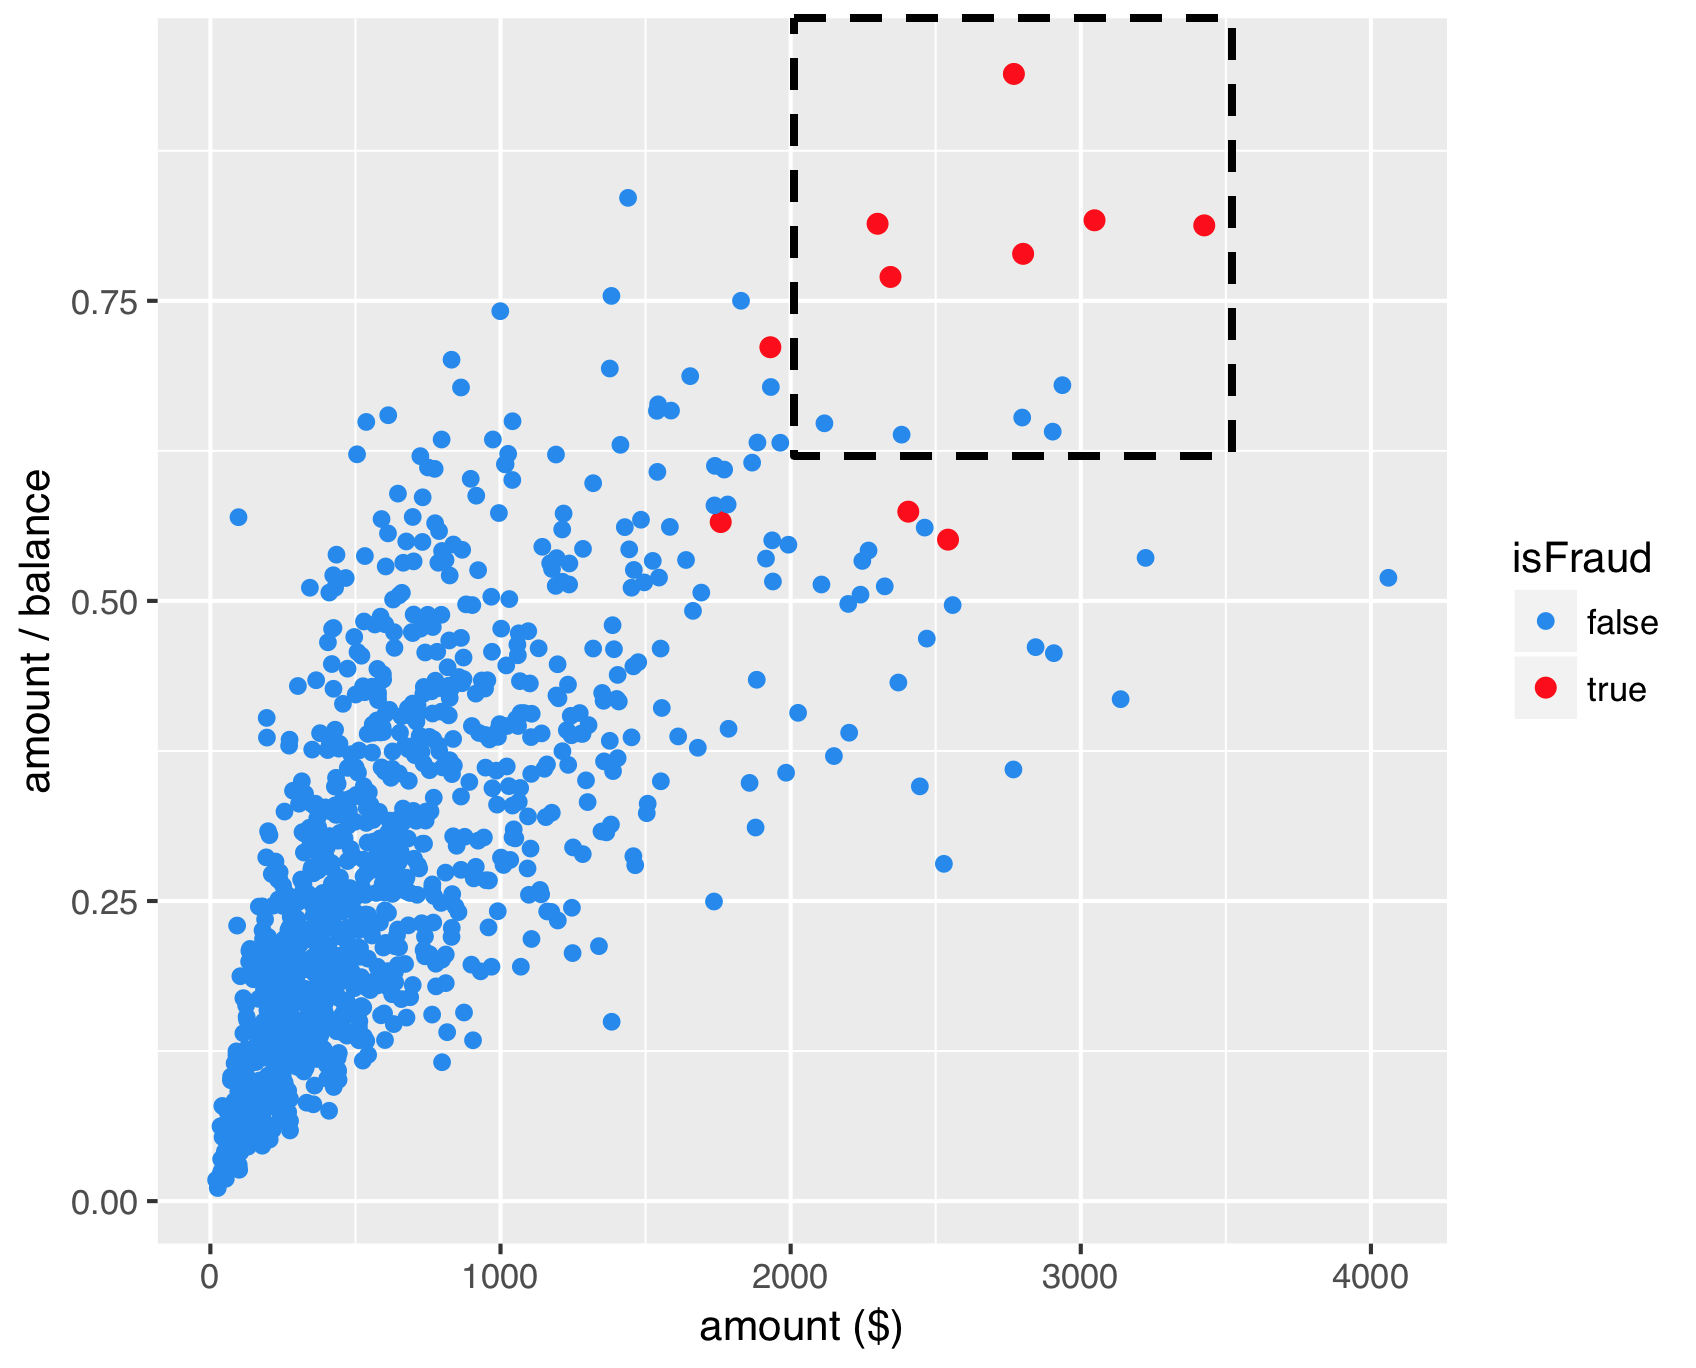
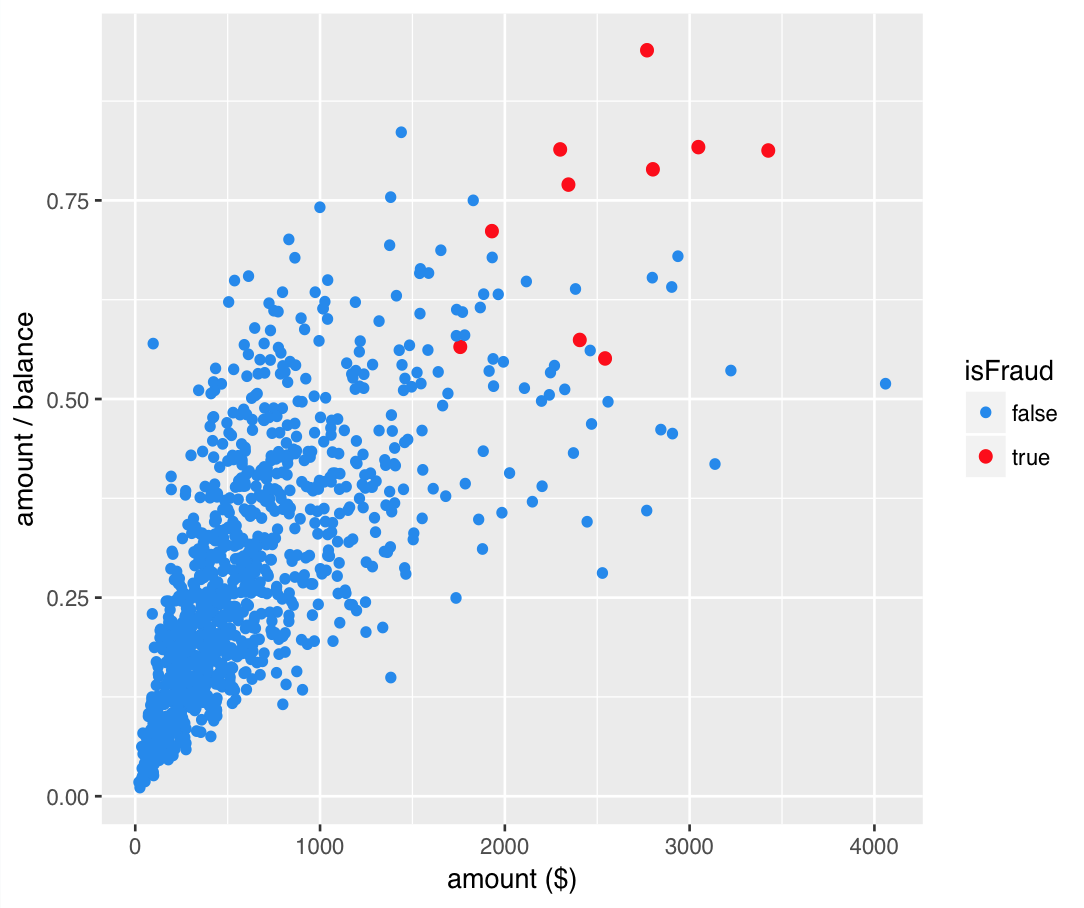
smote_scatterplot_1

R में Fraud Detection

smote_scatterplot_2

R में Fraud Detection

SMOTE

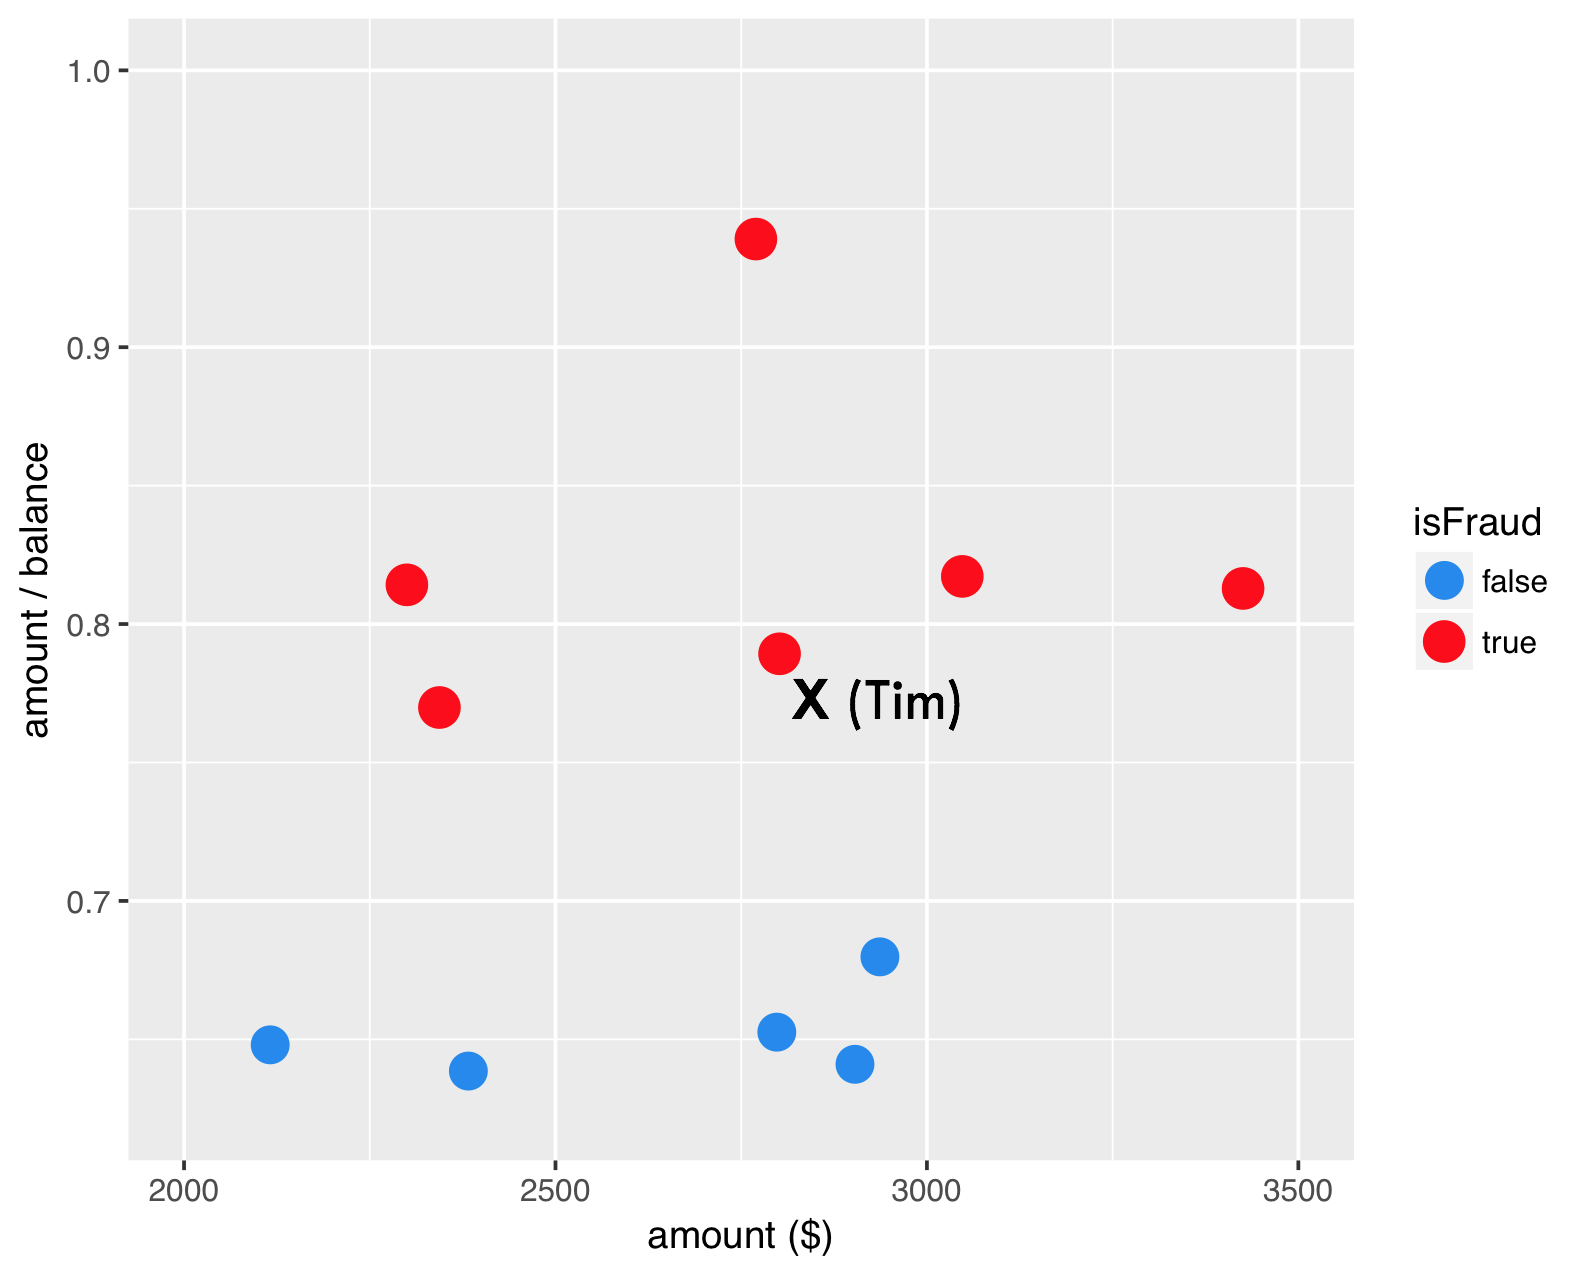
एक फ्रॉड केस X (Tim) चुनते हैं

smote_zoomin

R में Fraud Detection

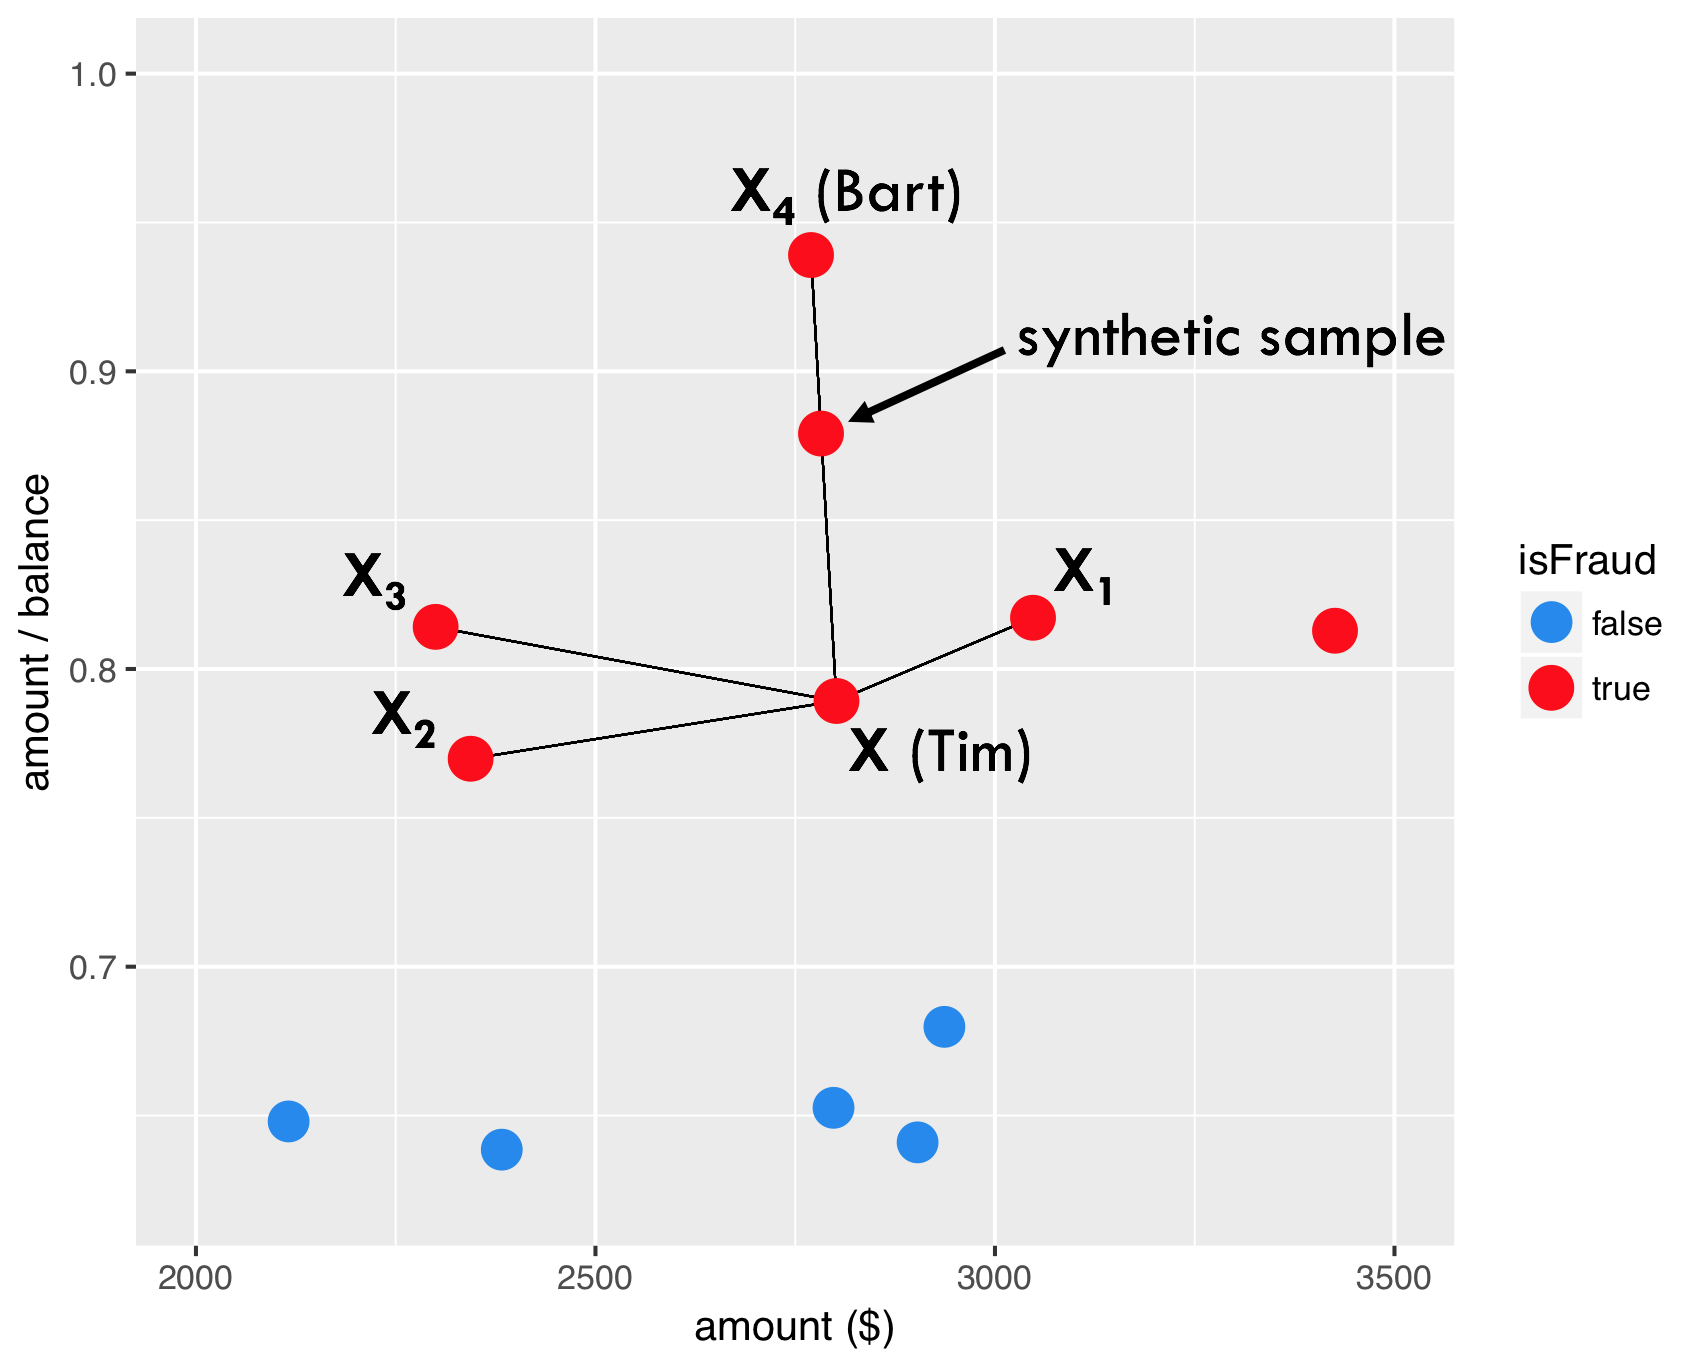
SMOTE - चरण 1

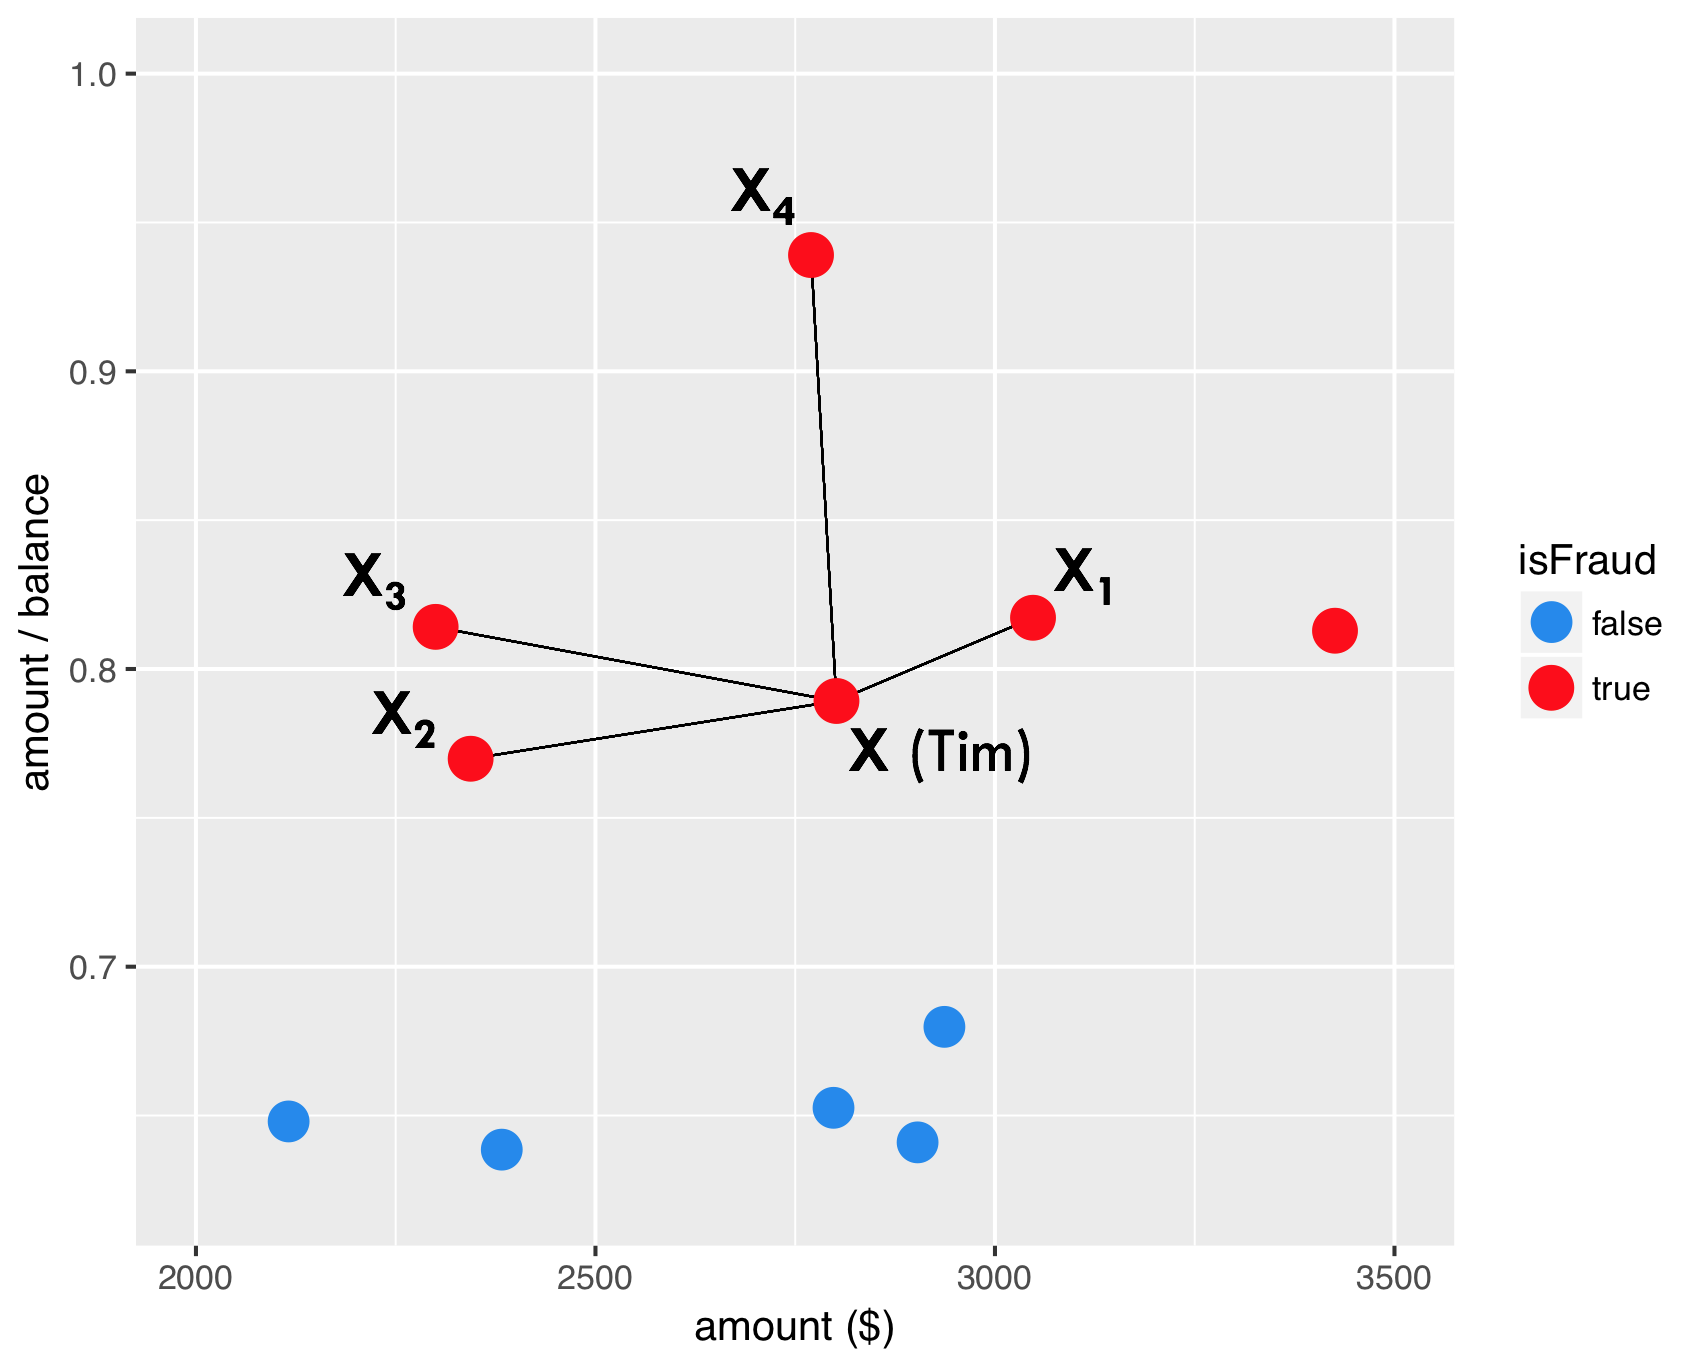
चरण 1

X (Tim) के K निकटतम फ्रॉड नेबर्स खोजें

उदा. K = 4

smote_step1

R में Fraud Detection

SMOTE - चरण 2

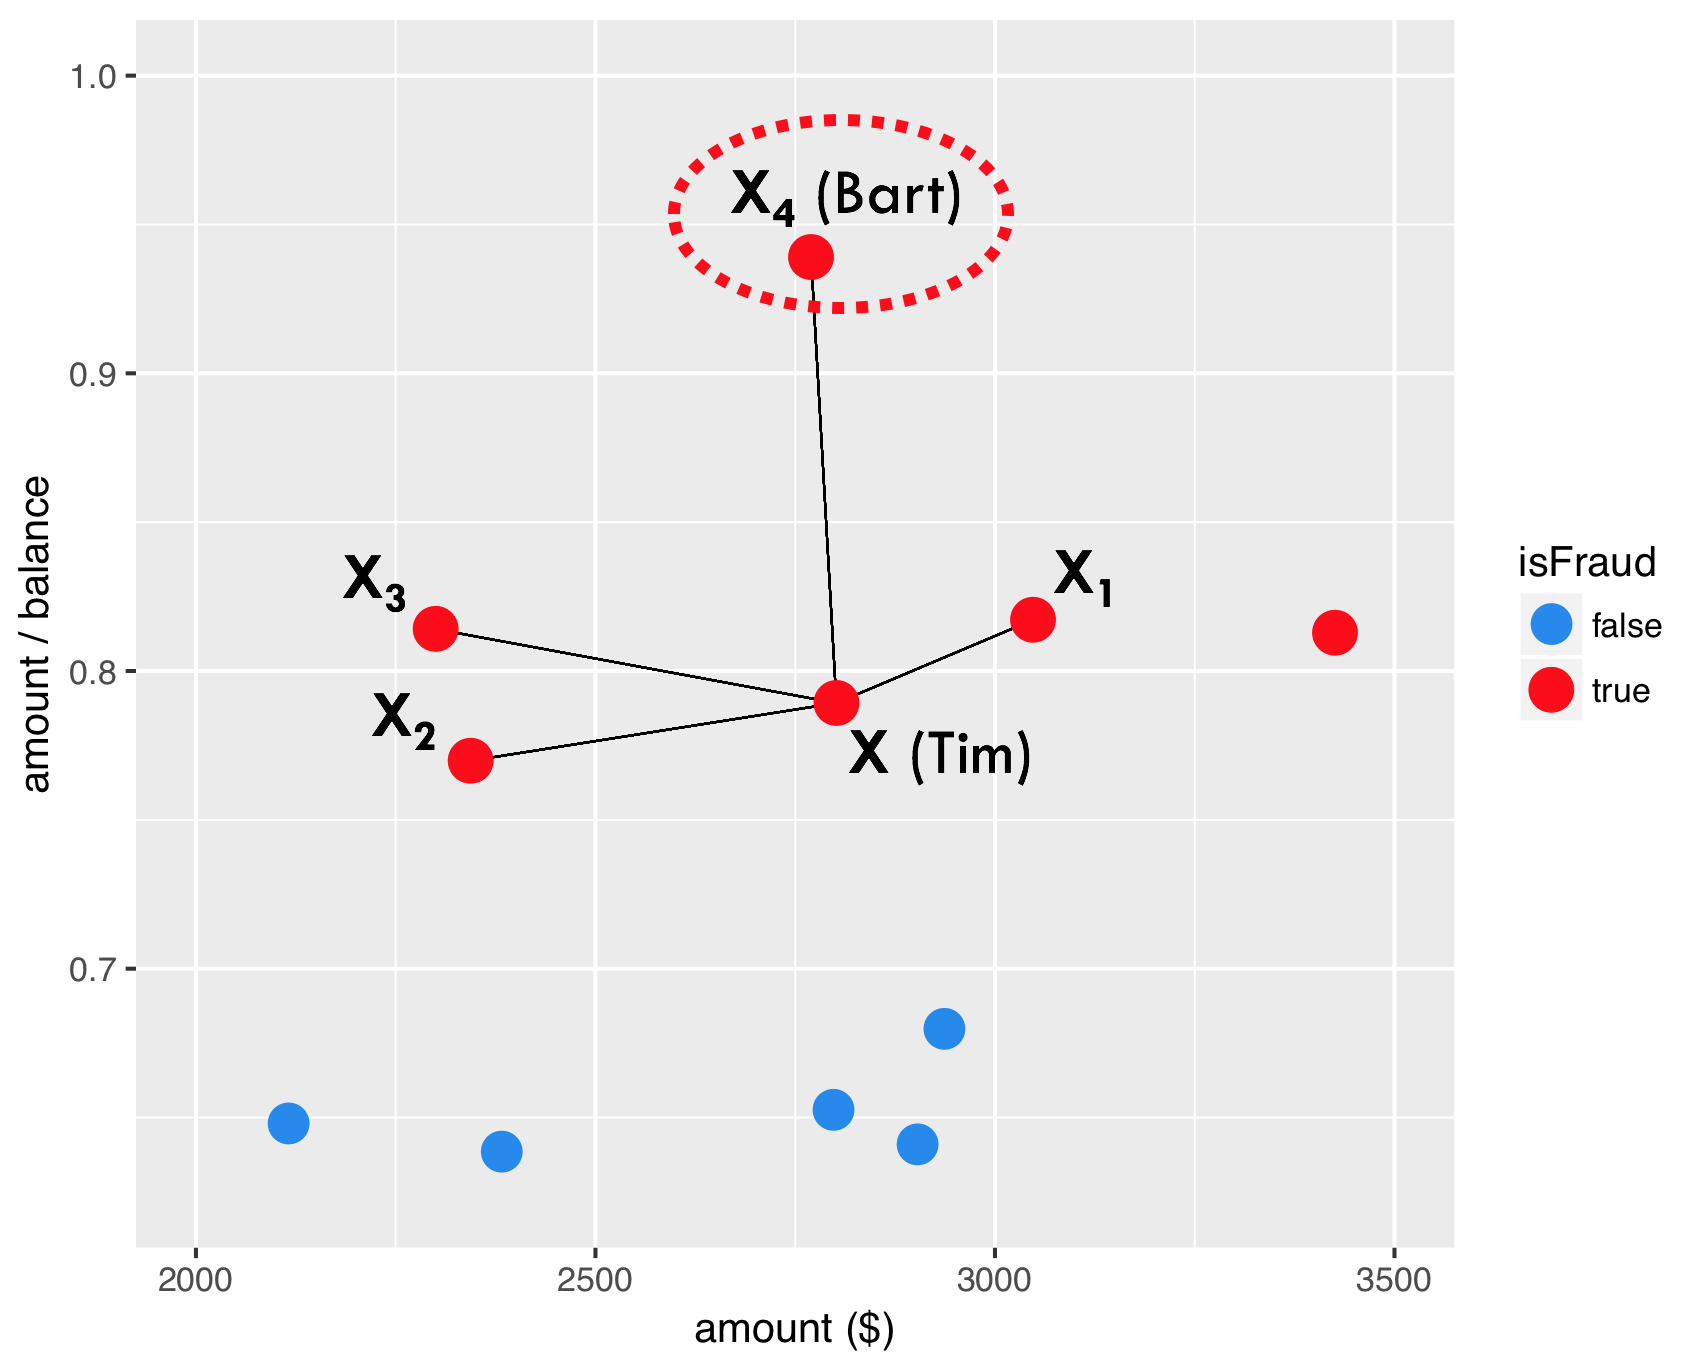
चरण 2

Tim के निकटतम नेबर्स में से एक को रैंडमली चुनें उदा. X4 (Bart)

smote_step2

R में Fraud Detection

SMOTE - चरण 3

चरण 3: एक सिंथेटिक सैंपल बनाएं
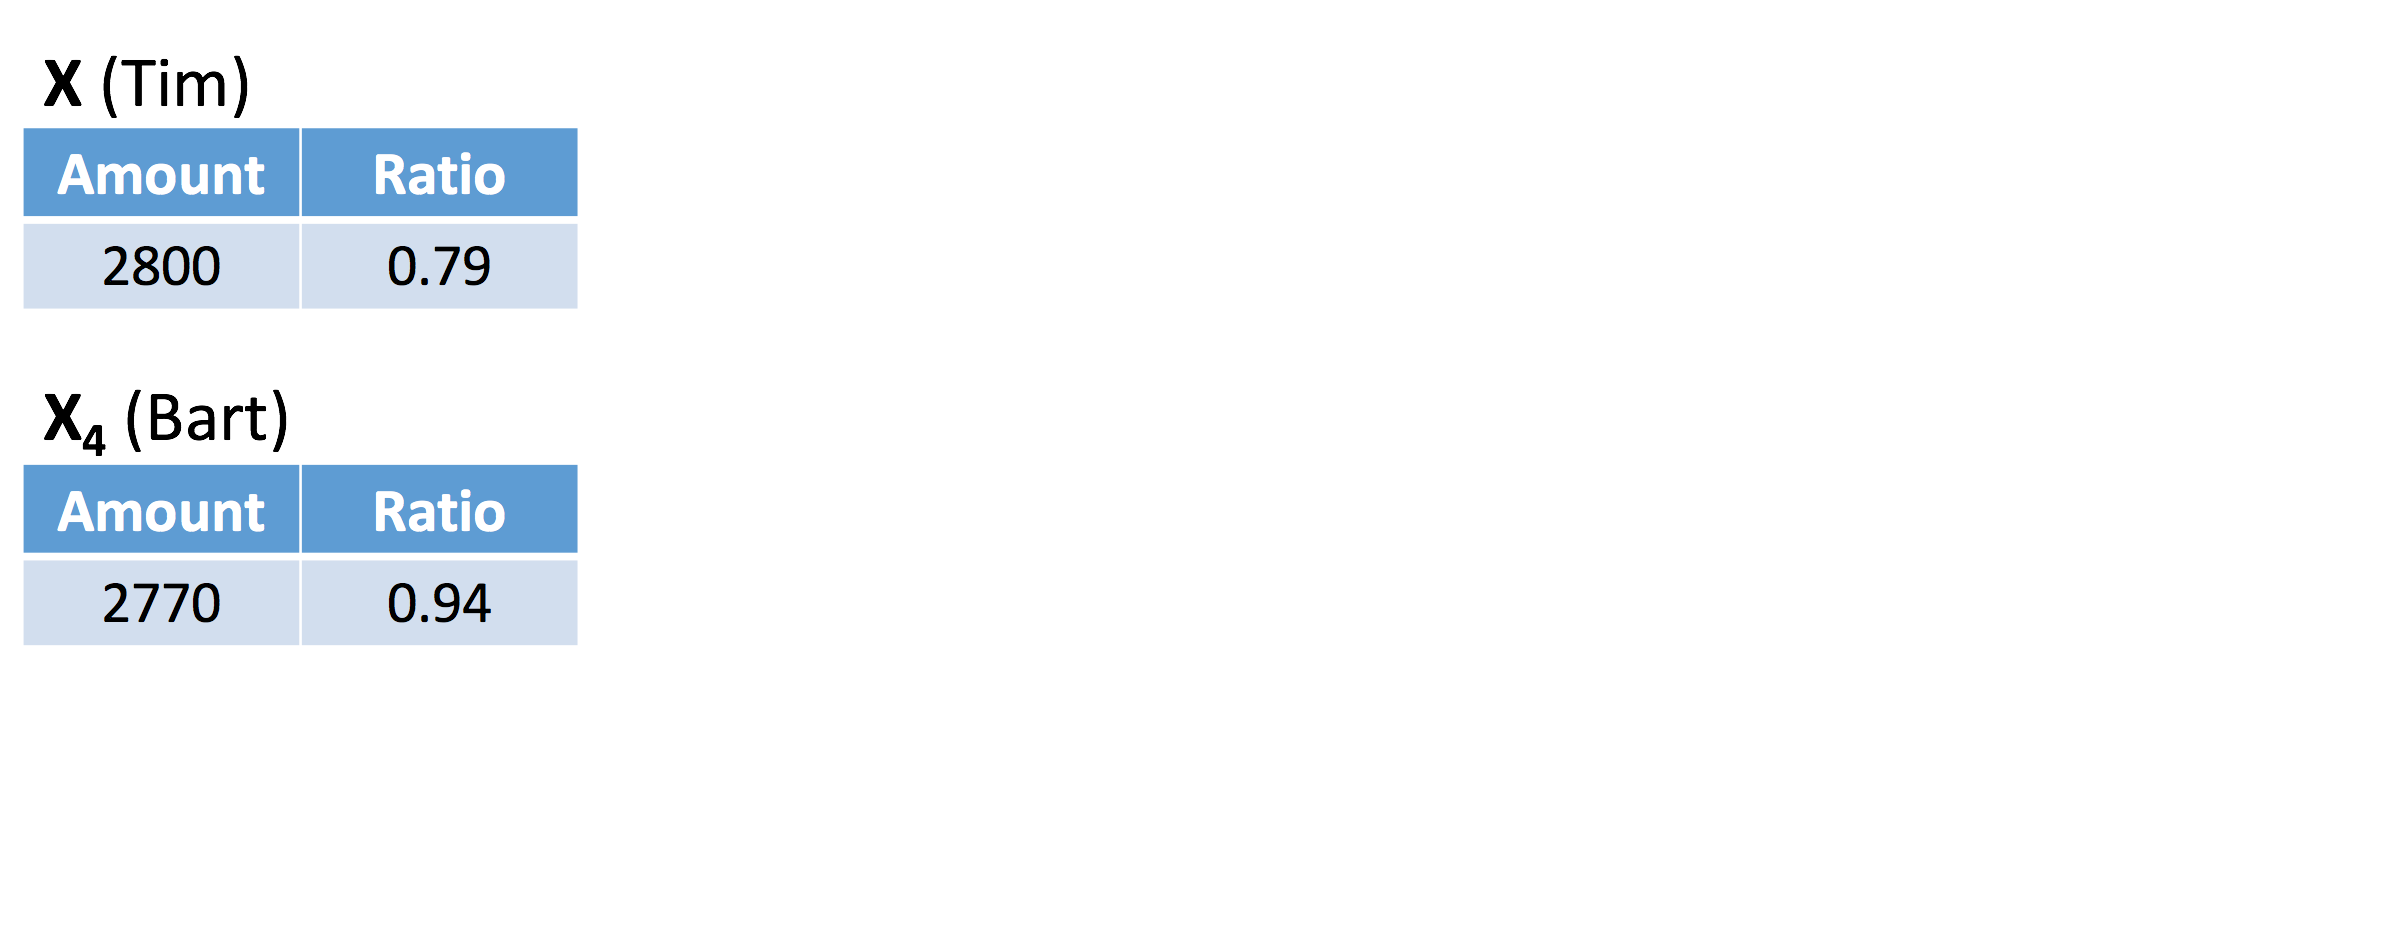
synthetic_case_1

R में Fraud Detection

SMOTE - चरण 3

चरण 3: एक सिंथेटिक सैंपल बनाएं
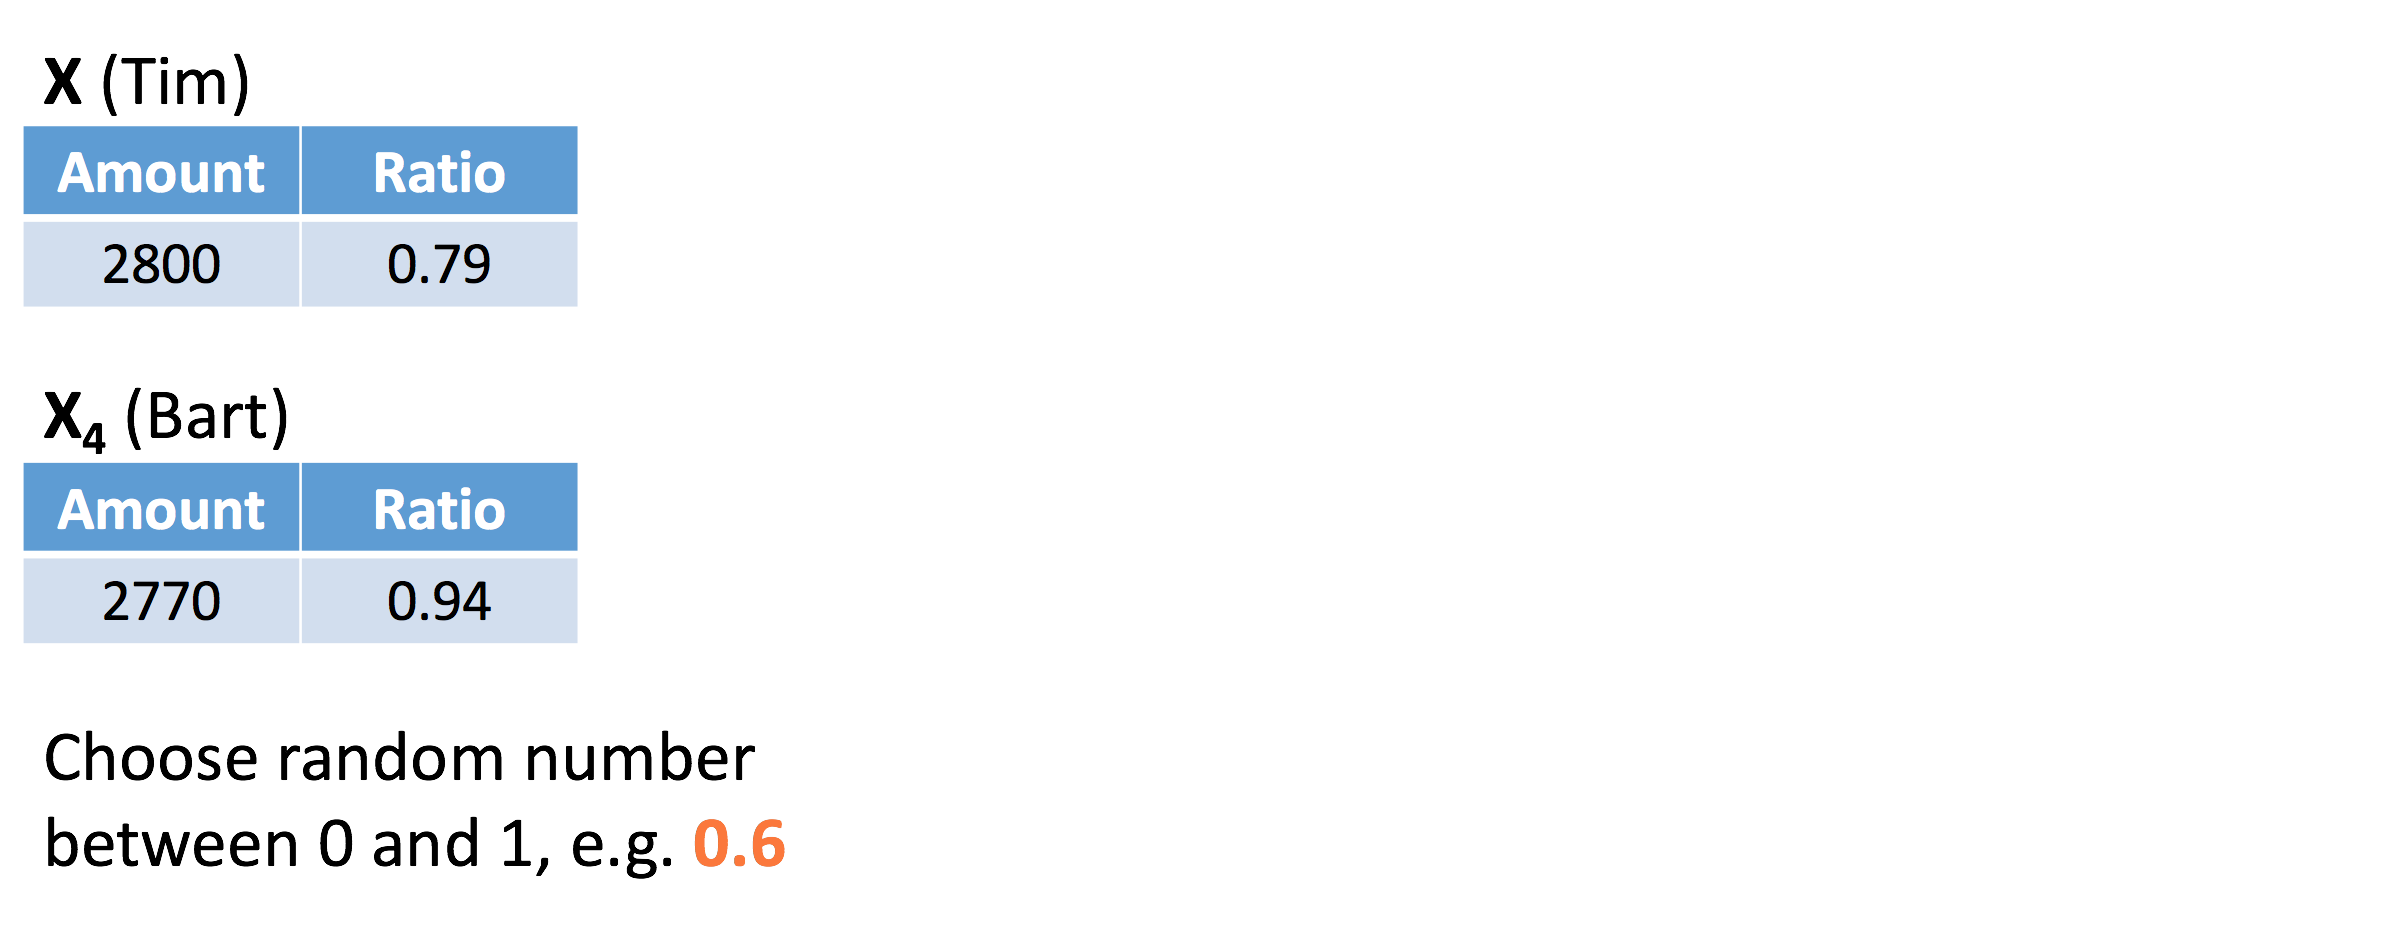
synthetic_case_2

R में Fraud Detection

SMOTE - चरण 3

चरण 3: एक सिंथेटिक सैंपल बनाएं
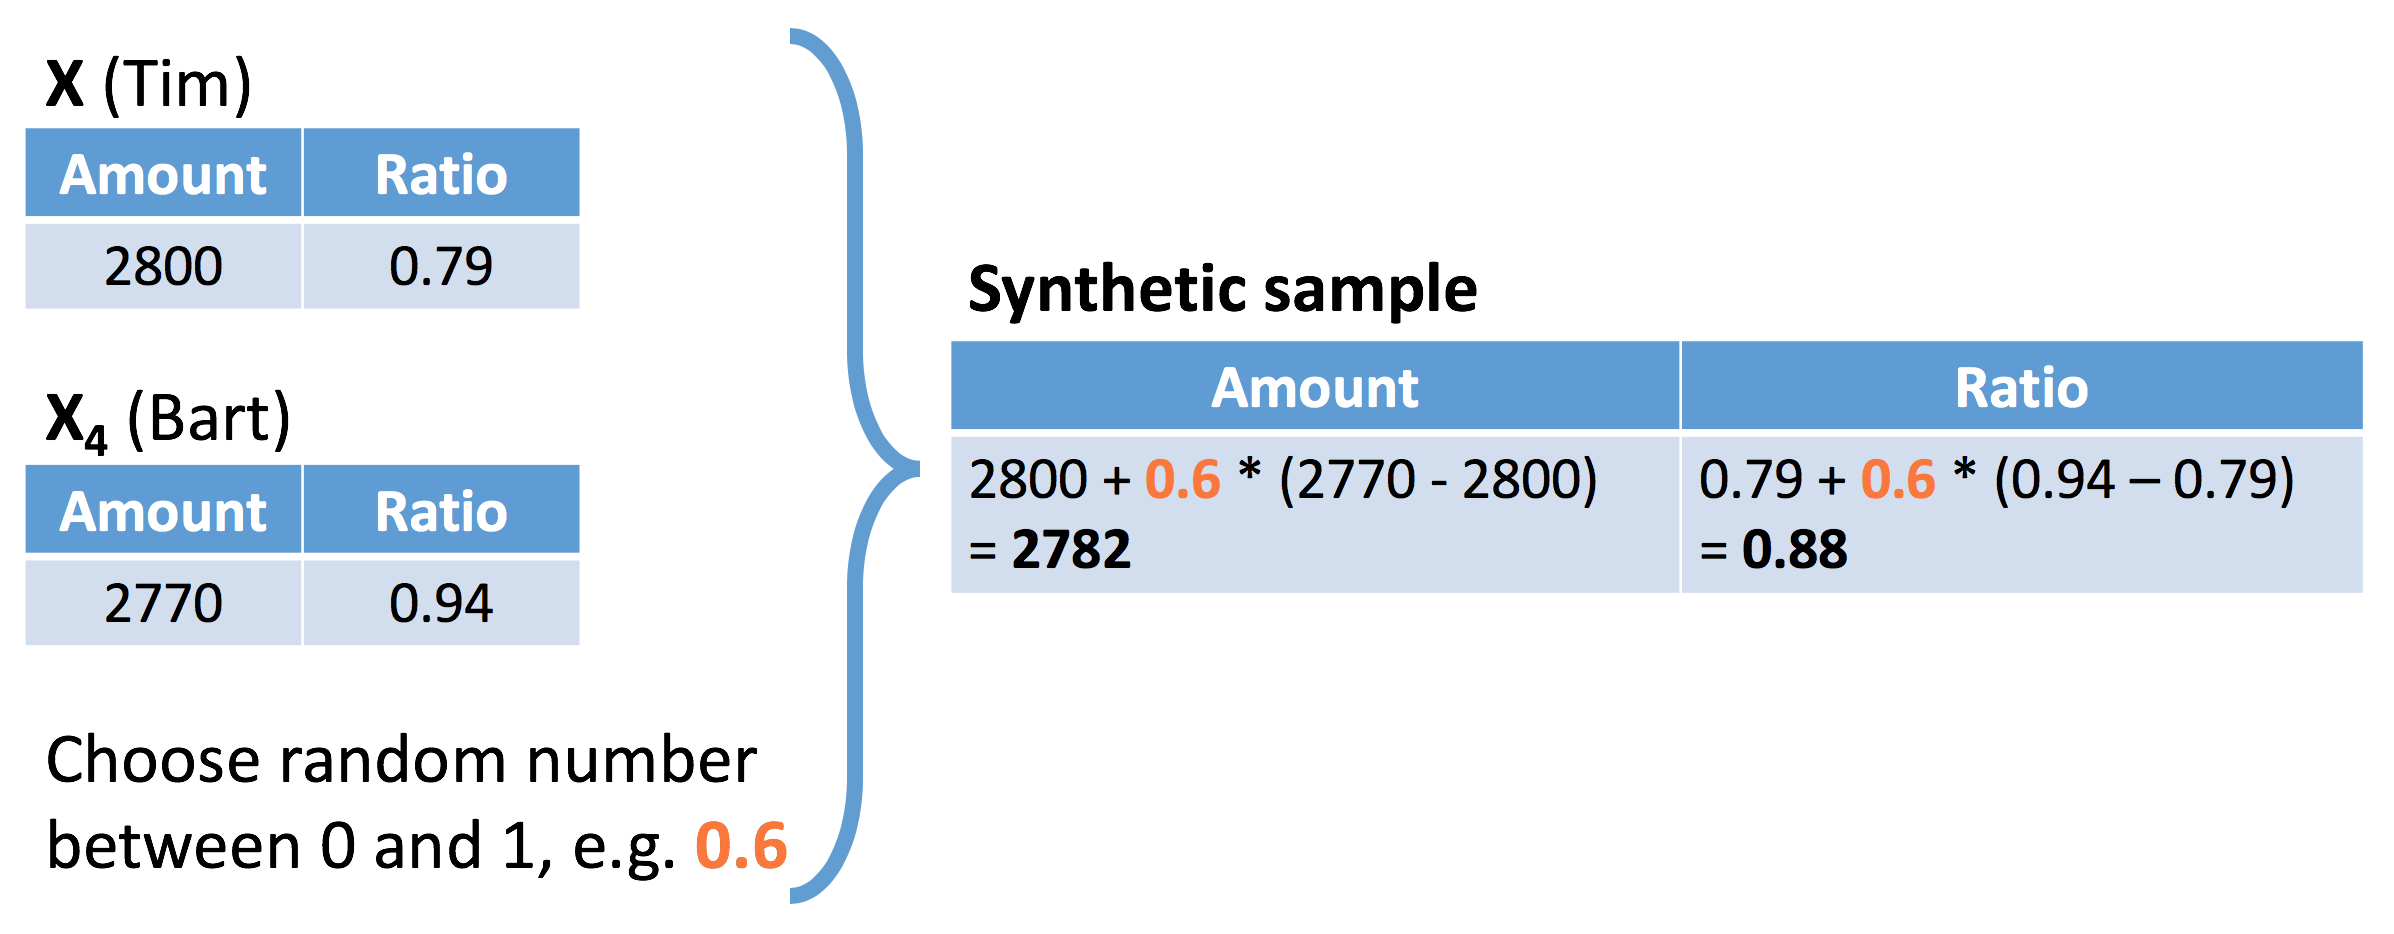
synthetic_case_3

R में Fraud Detection

SMOTE - चरण 3

smote_step3

R में Fraud Detection

SMOTE - चरण 4

चरण 4

हर फ्रॉड केस के लिए चरण 1-3 को dup_size बार दोहराएँ

उदा. dup_size = 10

smote_step3

R में Fraud Detection
library(smotefamily)
smote_output = SMOTE(X = transfer_data[, -1],
                       target = transfer_data$isFraud,
                       K = 4,
                       dup_size = 10)

oversampled_data = smote_output$data
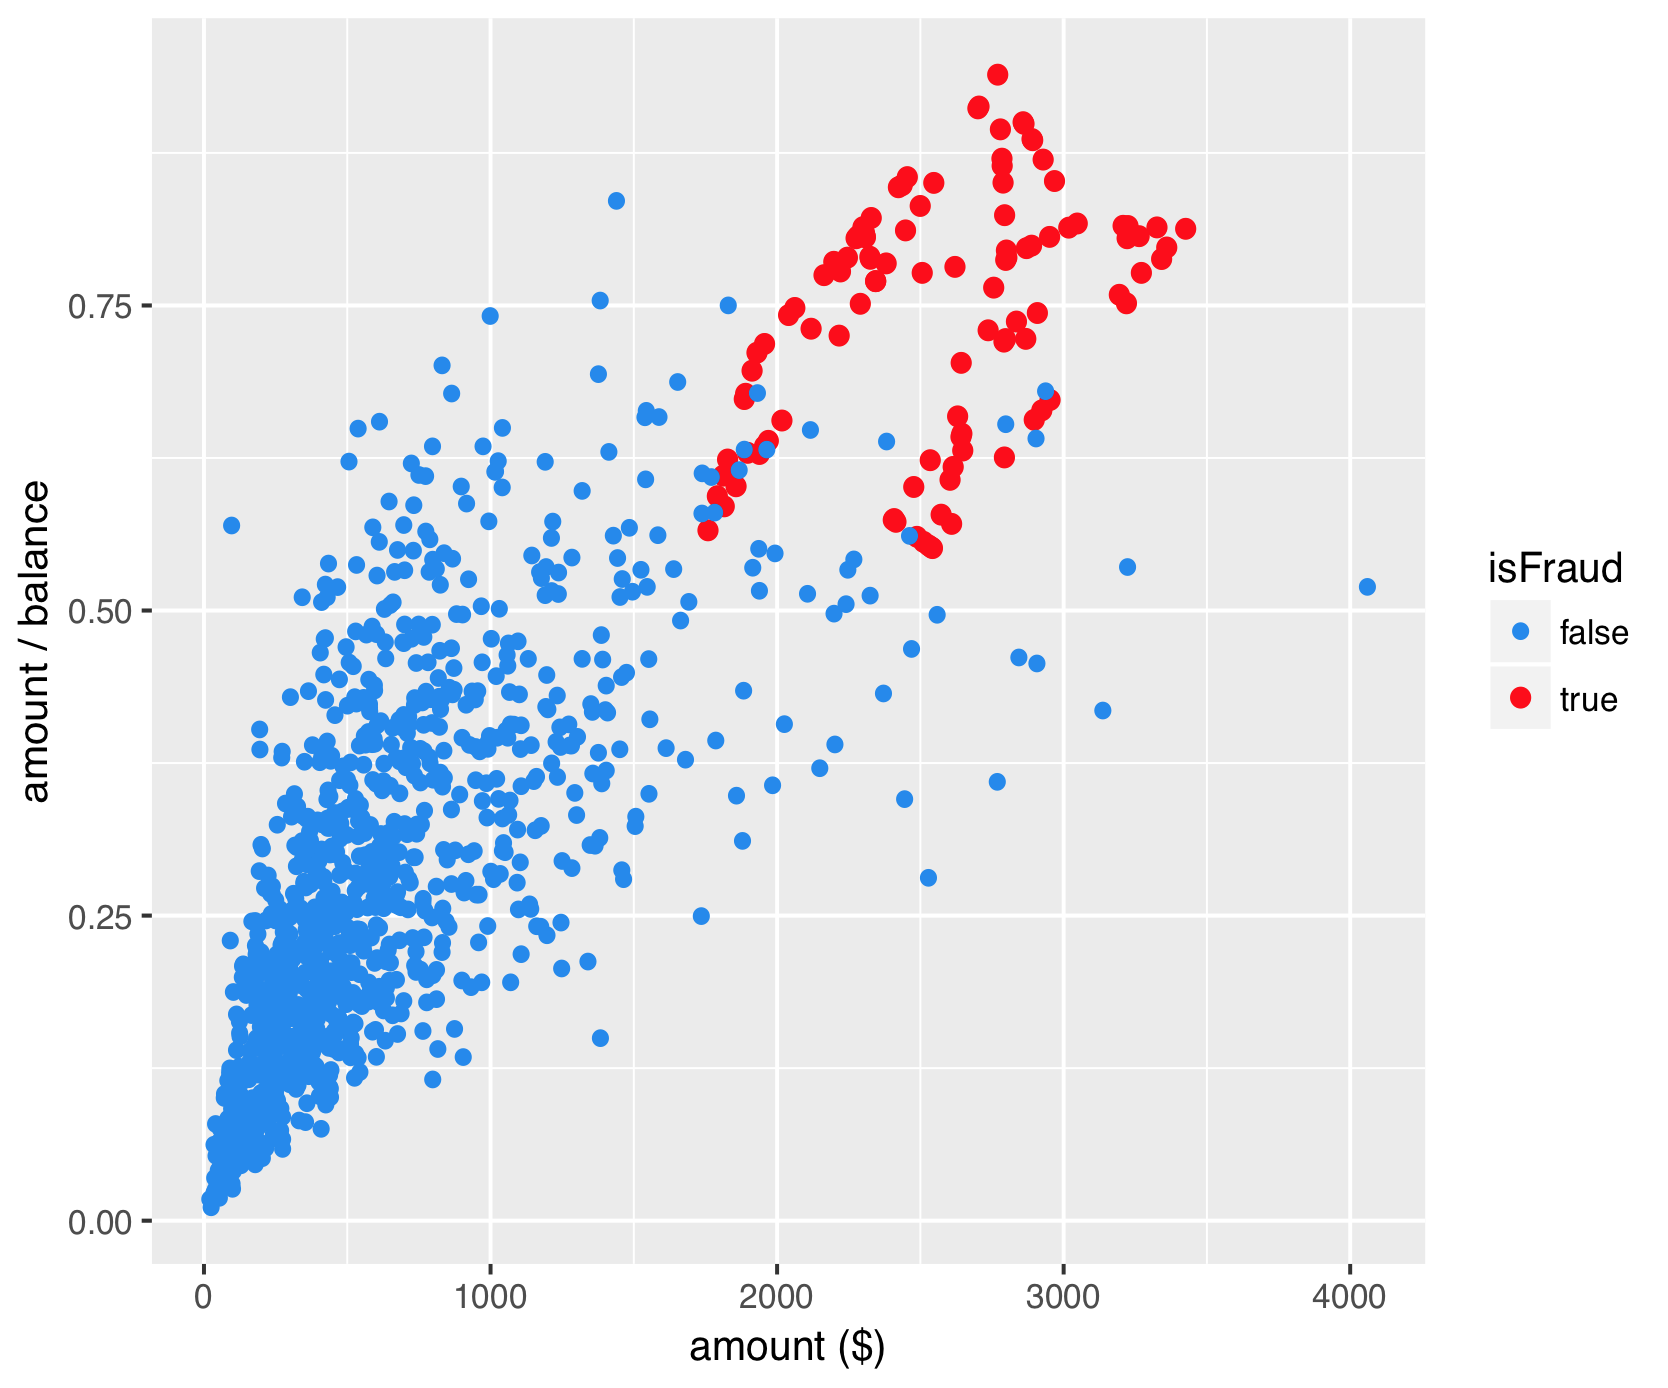
table(oversampled_data$isFraud)
false  true
  990   110
prop.table(table(oversampled_data$isFraud))
false  true
  0.9   0.1
R में Fraud Detection

smote_result

R में Fraud Detection

अभ्यास करते हैं!

R में Fraud Detection

Preparing Video For Download...