मौजूदा फीचर्स को ट्रांसफॉर्म क्यों करें?

R में Feature Engineering

Jorge Zazueta

Research Professor. Head of the Modeling Group at the School of Economics, UASLP

अपने मॉडल का काम आसान बनाना

डेटा को अधिक प्रबंधनीय बनाकर हम अपने मशीन लर्निंग मॉडल का प्रदर्शन बेहतर कर सकते हैं।

glimpse(loans_num)
Rows: 614
Columns: 6
$ Loan_Status       <fct> Y, N, Y, Y, Y, Y, Y, N, Y, N, Y, Y, Y, N...
$ ApplicantIncome   <dbl> 5849, 4583, 3000, 2583, 6000, 5417, 233...
$ CoapplicantIncome <dbl> 0, 1508, 0, 2358, 0, 4196, 1516, 2504, 1...
$ LoanAmount        <dbl> NA, 128, 66, 120, 141, 267, 95, 158, 168...
$ Loan_Amount_Term  <dbl> 360, 360, 360, 360, 360, 360, 360, 360, ...
$ Credit_History    <fct> 1, 1, 1, 1, 1, 1, 1, 0, 1, 1, 1, 1, 1, 1...
R में Feature Engineering

Log ट्रांसफॉर्मेशन

log-ट्रांसफॉर्म संख्यात्मक फीचर्स ताकि:

  • तिरछे डेटा को संभालें
  • आउट्लायर का प्रभाव घटाएँ
  • गुणात्मक संबंधों को योगात्मक में बदलें
  • डेटा मॉडलिंग के लिए अधिक उपयुक्त हो
  • केवल positive वैल्यू पर काम करता है

log-ट्रांसफॉर्म किया हुआ लोन अमाउंट डेटा
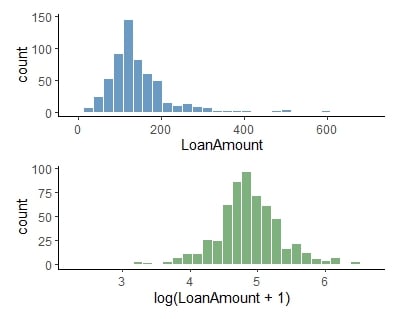
कच्चे और log-ट्रांसफॉर्म डेटा की ग्राफिकल तुलना

R में Feature Engineering

Normalization

संख्यात्मक फीचर्स को normalize या scale करें ताकि:

  • कोई एक फीचर दूसरों पर हावी न हो
  • व्याख्या आसान हो क्योंकि परिमाण तुलनीय होता है और
  • डेटा मॉडलिंग के लिए अधिक उपयुक्त हो

जैसे, लोन अमाउंट टर्म वैल्यू में काफ़ी फ़र्क है
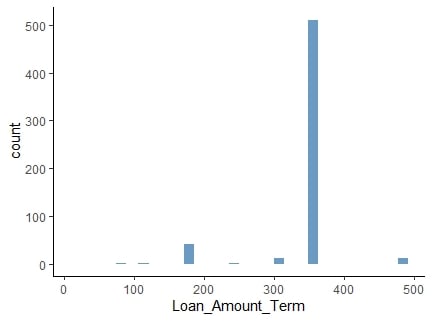
लोन अमाउंट वैल्यू दिखाने वाला हिस्टोग्राम.

R में Feature Engineering

Normalization

संख्यात्मक फीचर्स को normalize या scale करें ताकि:

  • कोई एक फीचर दूसरों पर हावी न हो
  • आउट्लायर संभालने में मदद मिले और
  • missing डेटा
  • डेटा मॉडलिंग के लिए अधिक उपयुक्त हो

Normalized वैल्यू वितरण को बनाए रखती हैं, पर वैरिएशन रहता है।
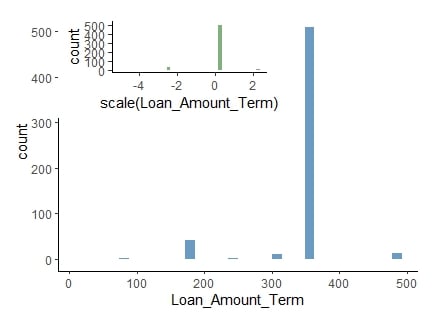
नॉर्मलाइज़्ड डेटा ओवरले के साथ लोन अमाउंट वैल्यू का हिस्टोग्राम.

R में Feature Engineering

मॉडल और recipe परिभाषित करना

अब हम एक logistic regression मॉडल डिक्लेयर कर सकते हैं और प्रासंगिक फीचर्स पर impute, normalize और log-ट्रांसफॉर्म लगाने के लिए एक recipe जोड़ सकते हैं।

lr_model <- logistic_reg()

lr_recipe <- 
  recipe(Loan_Status ~., 
         data = train) %>%
  step_impute_knn(
    all_numeric_predictors())%>%
  step_normalize(Loan_Amount_Term) %>%
  step_log(all_numeric_predictors(),
           -Loan_Amount_Term, offset = 1)

recipe ऑब्जेक्ट प्रिंट करने पर लागू कदमों का सारांश दिखता है।

lr_recipe
Recipe

Inputs:

      role #variables
   outcome          1
 predictor          5

Operations:

K-nearest neighbor imputation for all_numeric_predictors()
Centering and scaling for Loan_Amount_Term
Log transformation on all_numeric_predictors(),-Loan_Amount_Term
R में Feature Engineering

प्रदर्शन को कुशलतापूर्वक मापना

हम lr_fit वर्कफ़्लो ऑब्जेक्ट के फिट का आकलन करने के लिए roc_auc, accuracy और sens मैट्रिक्स का सेट परिभाषित करते हैं।

class_evaluate <- metric_set(
  roc_auc, accuracy, sens)

और इसे किसी भी फंक्शन की तरह चलाएँ।

lr_aug %>% 
  class_evaluate(
    truth = Loan_Status, 
    estimate = .pred_class, 
    .pred_Y)

कस्टमाइज़्ड मैट्रिक्स सेट

# A tibble: 3 × 3
  .metric  .estimator .estimate
  <chr>    <chr>          <dbl>
1 accuracy binary         0.813
2 sens     binary         0.467
3 roc_auc  binary         0.288
R में Feature Engineering

अभ्यास करते हैं!

R में Feature Engineering

Preparing Video For Download...