कच्चे डेटा की सूचना-सामग्री बढ़ाना

R में Feature Engineering

Jorge Zazueta

Research Professor and Head of the Modeling Group at the School of Economics, UASLP

कच्चे डेटा से निपटना

मिसिंग वैल्यू वाला एक सामान्य डेटासेट
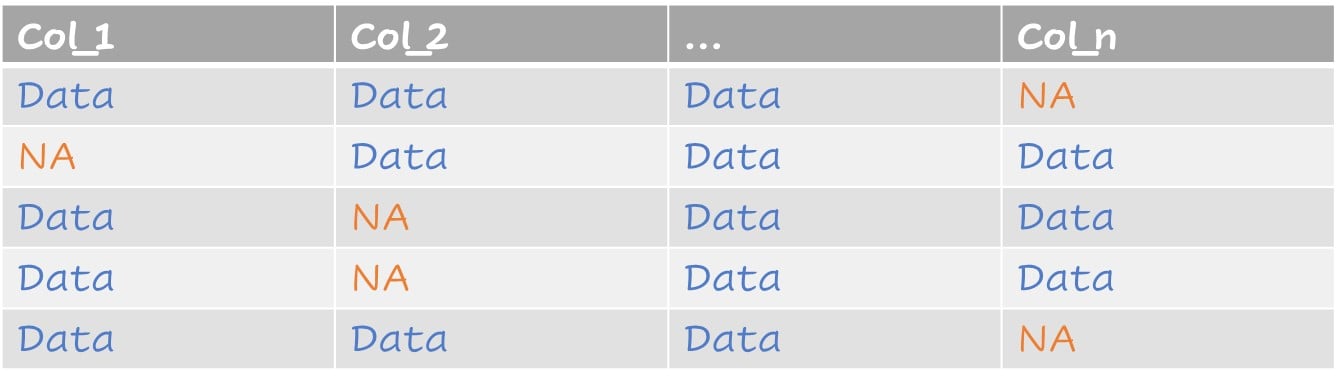
मिसिंग डेटा का उदाहरण दिखाती तालिका

वैल्यू को फैक्टर्स के रूप में

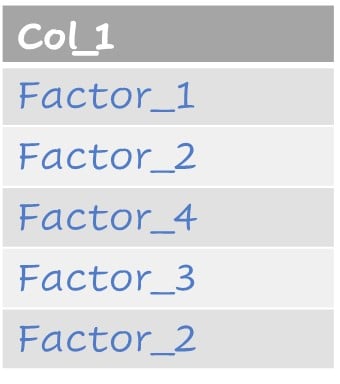
फैक्टर टाइप डेटा का उदाहरण दिखाती तालिका

R में Feature Engineering

कच्चे डेटा से निपटना

इम्प्यूटेड वैल्यू वाला डेटासेट
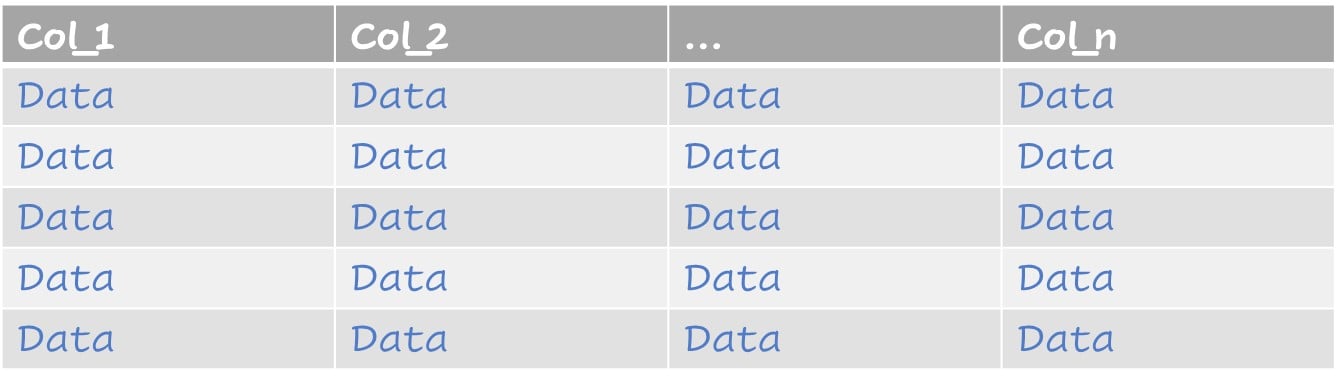
इम्प्यूटेशन के बाद बिना मिसिंग डेटा की तालिका

डमी वैरिएबल्स के रूप में दर्शाए गए फैक्टर्स
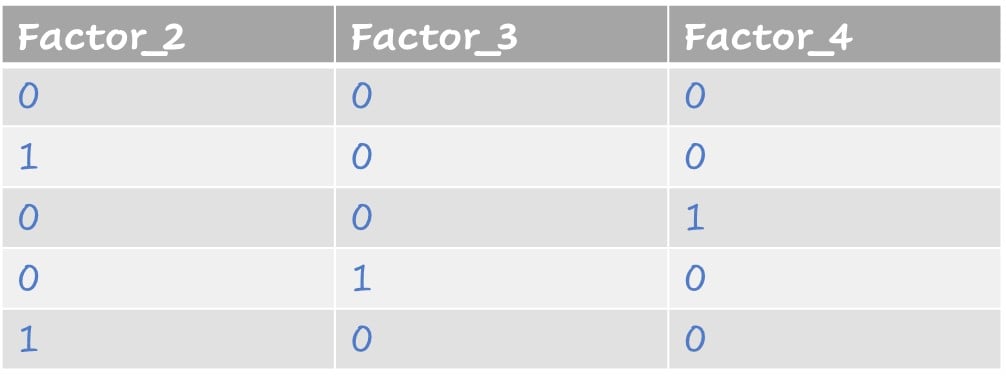
डमी वैरिएबल्स के रूप में दर्शाए गए फैक्टर्स

R में Feature Engineering

Loans डेटासेट

# A tibble: 614 × 13
   Loan_ID  Gender Married Dependents Educa…¹ Self_…² Appli…³ Coapp…⁴ LoanA…⁵ Loan_…⁶
   <fct>    <fct>  <fct>   <fct>      <fct>   <fct>     <dbl>   <dbl>   <dbl>   <dbl>
 1 LP001002 Male   No      0          Gradua… No         5849       0      NA     360
 2 LP001003 Male   Yes     1          Gradua… No         4583    1508     128     360
 3 LP001005 Male   Yes     0          Gradua… Yes        3000       0      66     360
 4 LP001006 Male   Yes     0          Not Gr… No         2583    2358     120     360
 5 LP001008 Male   No      0          Gradua… No         6000       0     141     360
 6 LP001011 Male   Yes     2          Gradua… Yes        5417    4196     267     360
 7 LP001013 Male   Yes     0          Not Gr… No         2333    1516      95     360
 8 LP001014 Male   Yes     3+         Gradua… No         3036    2504     158     360
 9 LP001018 Male   Yes     2          Gradua… No         4006    1526     168     360
10 LP001020 Male   Yes     1          Gradua… No        12841   10968     349     360
# … with 604 more rows, 3 more variables: Credit_History <dbl>, Property_Area <fct>,
#   Loan_Status <fct>, and abbreviated variable names ¹​Education, ²​Self_Employed,
#   ³​ApplicantIncome, ⁴​CoapplicantIncome, ⁵​LoanAmount, ⁶​Loan_Amount_Term
# ℹ Use `print(n = ...)` to see more rows, and `colnames()` to see all variable names
R में Feature Engineering

मिसिंग वैल्यू

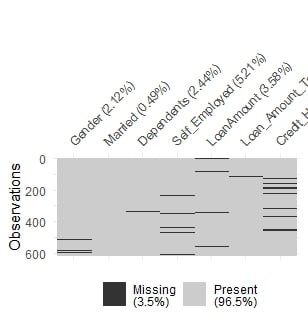
हम naniar पैकेज के vis_miss(loans) से loans में मिसिंग वैल्यू को विज़ुअली पहचान सकते हैं।
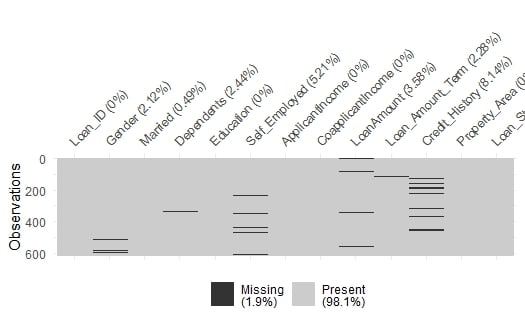
पूरा डेटासेट के लिए मिसिंग वैल्यू दिखाता ग्राफ

R में Feature Engineering

मिसिंग वैल्यू

हम केवल वे कॉलम चुनकर तालिका को ज़ूम कर सकते हैं जिनमें मिसिंग वैल्यू हैं।

loans %>% 
select(Gender, 
       Married, 
       Dependents,
       Self_Employed,
       LoanAmount,
       Loan_Amount_Term, 
       Credit_History) %>%
  vis_miss()

मिसिंग वैल्यू का नज़दीकी दृश्य

चुने गए फीचर्स के लिए मिसिंग वैल्यू दिखाता ग्राफ

R में Feature Engineering

मिसिंग वैल्यू और डमी वैरिएबल्स

हम उसी रेसिपी में मिसिंग वैल्यू हैंडल कर सकते हैं और डमी वैरिएबल्स बना सकते हैं।

lr_recipe <- 
  recipe(Loan_Status ~., 
         data = train) %>%
  update_role(Loan_ID, 
              new_role = "ID" ) %>%
  step_impute_knn(all_predictors()) %>%
  step_dummy(all_nominal_predictors())

रेसिपी प्रिंट करें

lr_recipe
Recipe

Inputs:

      role #variables
        ID          1
   outcome          1
 predictor         30

Operations:

K-nearest neighbor imputation for all_predictors()
Dummy variables from all_nominal_predictors()
R में Feature Engineering

सही रेसिपी स्टेप ढूँढ़ना

आप अन्य इम्प्यूटेशन मेथड्स और सभी रेसिपी स्टेप्स tidymodels डॉक्यूमेंटेशन में देख सकते हैं: www.tidymodels.org/find/recipes
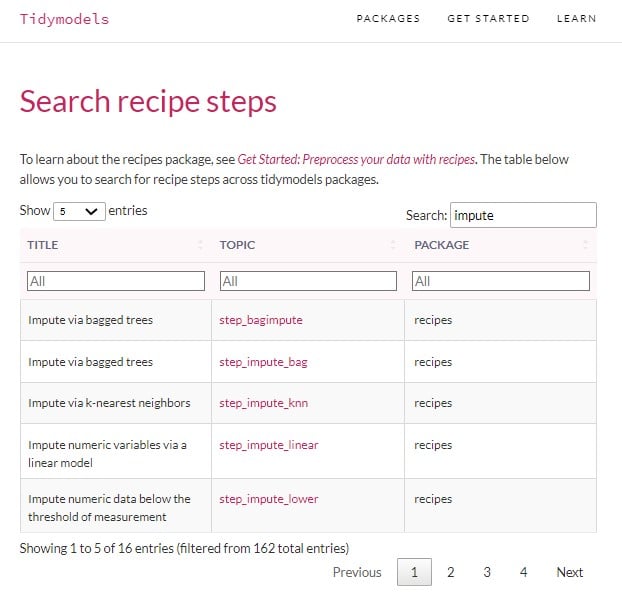
tidymodels डॉक्यूमेंटेशन में रेसिपी सर्च टूल

R में Feature Engineering

हमारे मॉडल को फिट करना और आकलन करना

# Fit
lr_fit <- 
  lr_workflow %>% fit(data = train)
lr_aug <- 
  lr_fit %>% augment(test)
# Assess
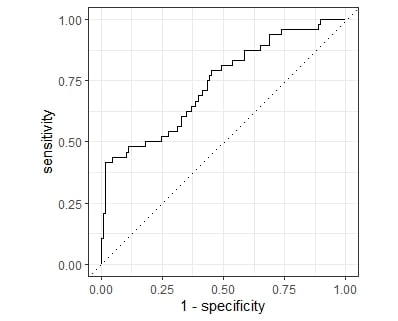
lr_aug %>%
  roc_curve(truth = Loan_Status, .pred_N) %>%
  autoplot()

bind_rows(lr_aug %>%
            roc_auc(truth = Loan_Status,
                    .pred_N),
          lr_aug %>%
            accuracy(truth = Loan_Status,
                     .pred_class))
# A tibble: 2 × 3
  .metric  .estimator .estimate
  <chr>    <chr>          <dbl>
1 roc_auc  binary         0.738
2 accuracy binary         0.792
R में Feature Engineering

अभ्यास करते हैं!

R में Feature Engineering

Preparing Video For Download...