Konfiguration av experimentdata

Experimentell design i Python

James Chapman

Curriculum Manager, DataCamp

Problemet med randomisering
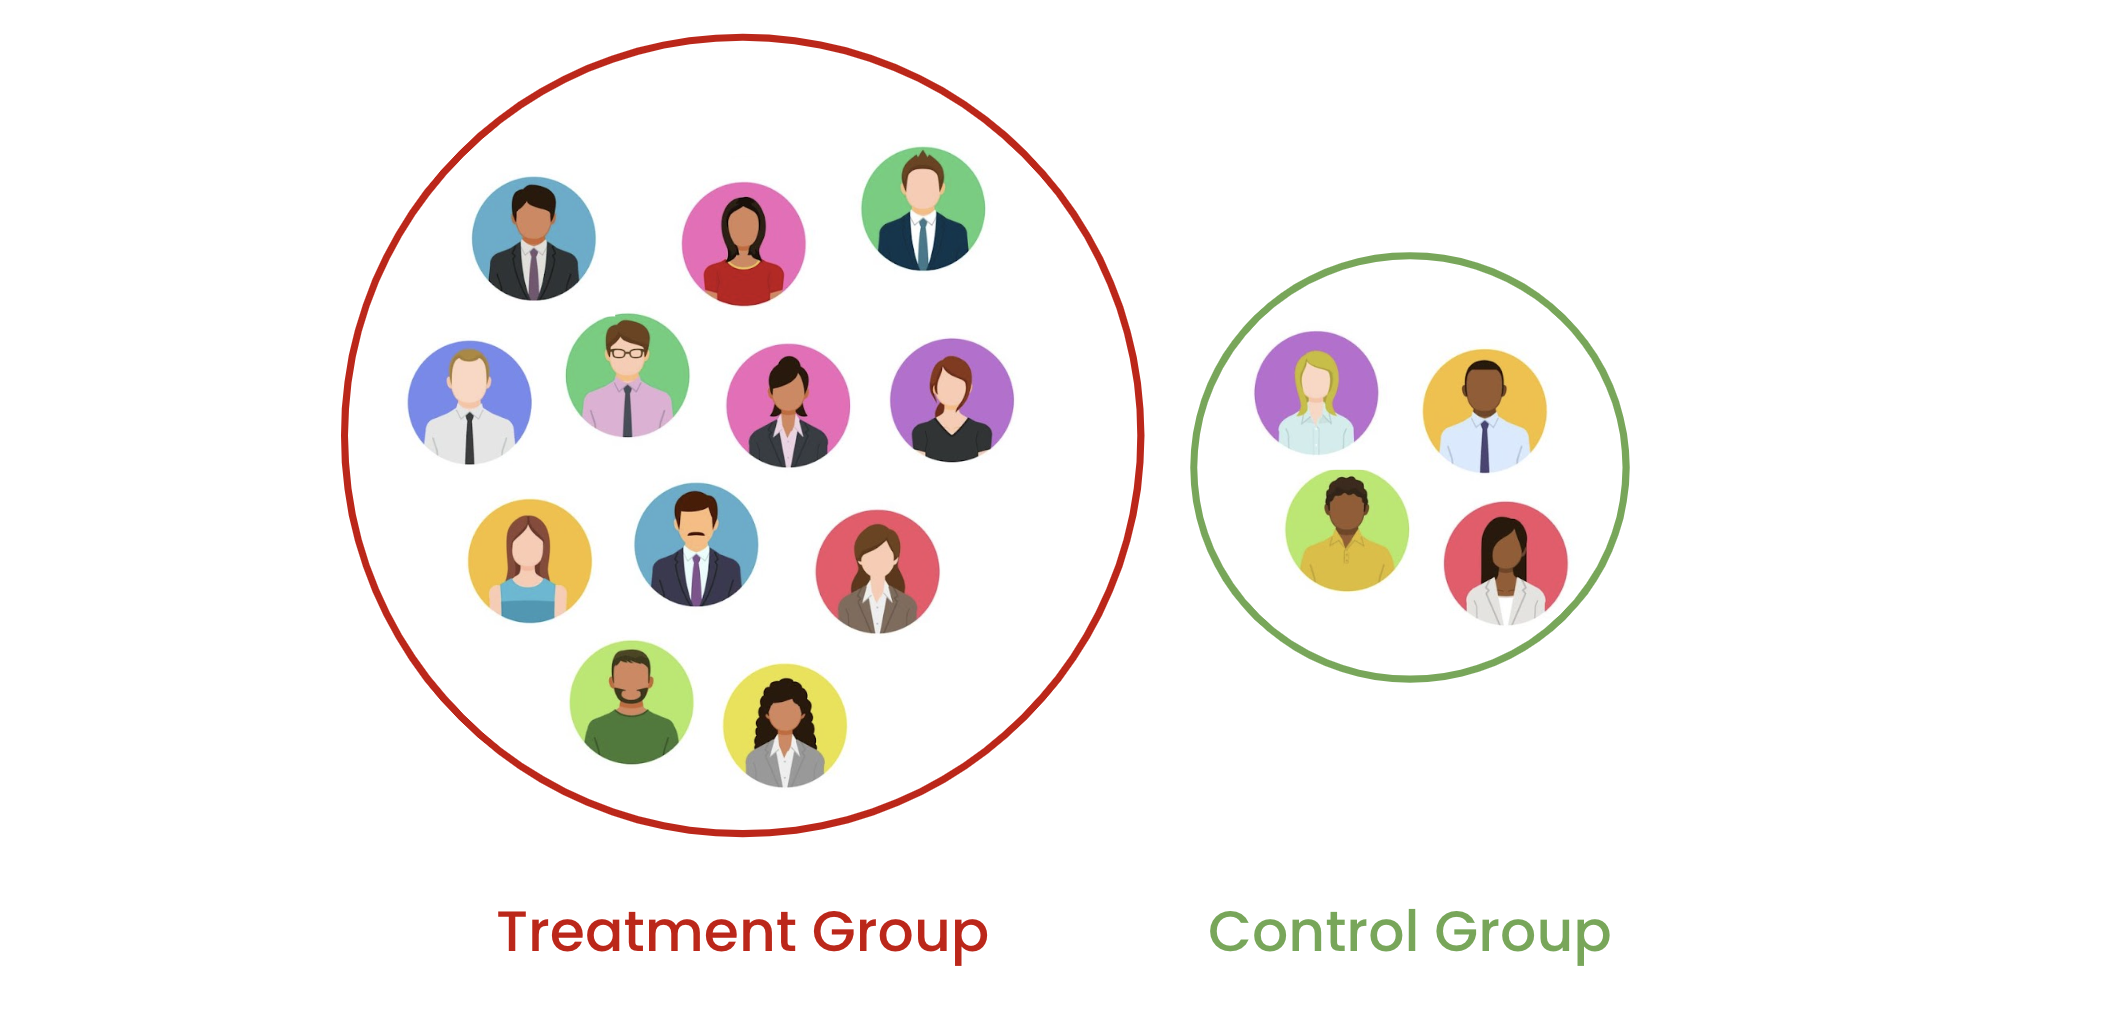
1) Ojämnt antal: olika antal försökspersoner per grupp

Två grupper med olika antal försökspersoner.

Experimentell design i Python

Problemet med randomisering

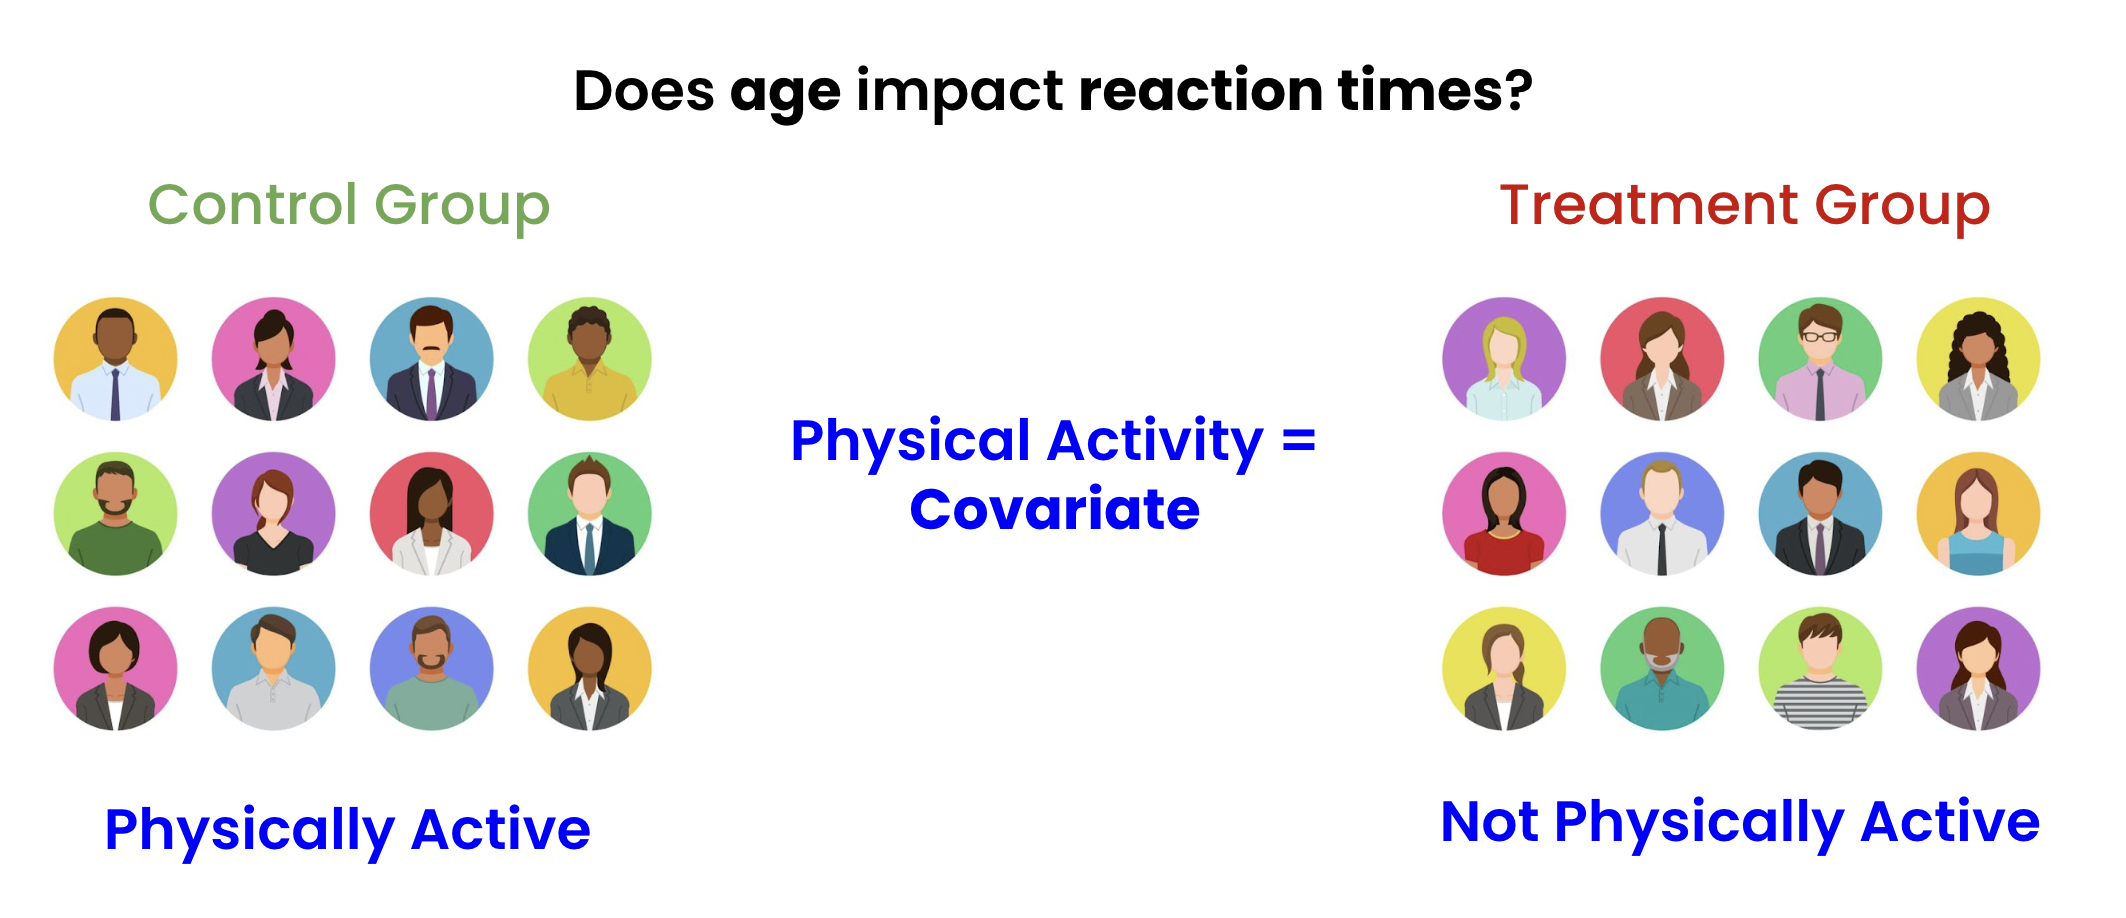
2) Kovariatproblem: hög variabilitet i kovariater → ojämn gruppbalans vid randomisering

Kontroll- och behandlingsgrupper utformade för att mäta ålderns påverkan på reaktionstider. De två grupperna har en ojämn fördelning av fysisk kondition, vilket inte är experimentets primära fokus men kan påverka reaktionstidsvariabeln.

Resultat: svårare att mäta behandlingseffekten!

Experimentell design i Python

Blockrandomisering


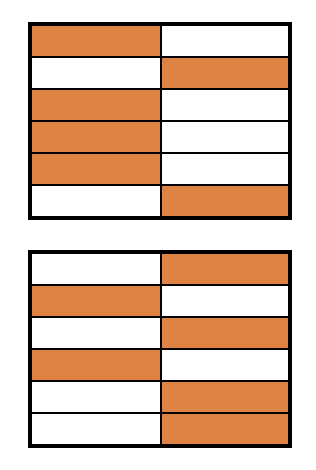
  • Dela in i block om storlek $n$ först, sedan slumpmässig fördelning
    • Löser problemet med ojämnt antal

Ett exempel på blockrandomisering med två rutnät av orange och vita rutor

  • 24 försökspersoner delas i två grupper och randomiseras sedan
Experimentell design i Python

Vår datamängd

  • E-handelsdatamängd (ecom) (1 000 försökspersoner)
    • Genomsnittlig korglstorlek
    • Genomsnittlig tid på webbplatsen
    • Storförbrukare (i genomsnitt 40+ minuter dagligen på webbplatsen)
   basket_size  web_time  power_user
0          227         7           0
1          123         5           0
2           98        16           0
3          211        45           1
4          133        17           0
Experimentell design i Python

Blockrandomisering i Python

group1 = ecom.sample(frac=0.5, random_state=42, replace=False)
group1['Block'] = 1
group2 = ecom.drop(group1.index)
group2['Block'] = 2
print(len(group1), len(group2))
500,500
Experimentell design i Python

Visualisera uppdelningar


import seaborn as sns
import matplotlib.pyplot as plt
sns.displot(data=ecom, 
            x='basket_size', 
            hue='power_user', 
            fill=True, 
            kind='kde')    
plt.show()

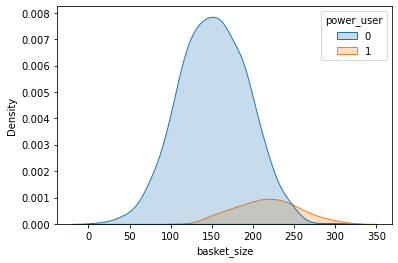
Confounding = variabel som kan orsaka effekten istället för behandlingen


Ett seaborn-fördelningsdiagram med två normalliknande, lätt genomskinliga fördelningar. En större blå och en mindre orange som delvis överlappar, med den orange förskjuten åt höger

Experimentell design i Python

Stratifierad randomisering


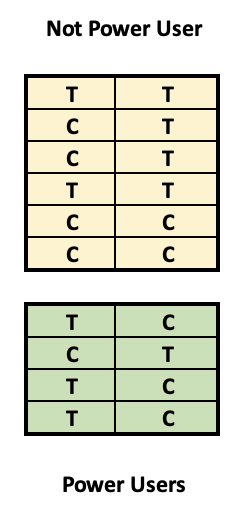
  • Dela efter kovariate(r) först
    • Sedan randomisering
  • Grönt = alla storförbrukare (Gult = inte storförbrukare)
    • Sedan uppdelning Behandling/Kontroll
  • Löser kovariat-/confoundingproblemet
  • Kan göras för flera kovariater – men blir komplext!

En bild av två datarutnät, ett grönt och ett gult. Alla celler innehåller bokstaven T eller C, och det gula rutnätet är större

Experimentell design i Python

Vårt första stratum

  • Separera storförbrukare
  • Fördela i Behandling/Kontroll
strata_1 = ecom[ecom['power_user'] == 1]
strata_1['Block'] = 1

strata_1_g1 = strata_1.sample(frac=0.5, replace=False) strata_1_g1['T_C'] = 'T'
strata_1_g2 = strata_1.drop(strata_1_g1.index) strata_1_g2['T_C'] = 'C'
Experimentell design i Python

Det andra stratumet

  • Separera icke-storförbrukare
  • Fördela i Behandling/Kontroll
strata_2 = ecom.drop(strata_1.index)
strata_2['Block'] = 2

strata_2_g1 = strata_2.sample(frac=0.5, replace=False) strata_2_g1['T_C'] = 'T' strata_2_g2 = strata_2.drop(strata_2_g1.index) strata_2_g2['T_C'] = 'C'
Experimentell design i Python

Bekräfta stratifieringen

  • Slå ihop block och grupper
  • Använd groupby för att kontrollera fördelningen
ecom_stratified = pd.concat([strata_1_g1, strata_1_g2, strata_2_g1, strata_2_g2])

ecom_stratified.groupby(['Block','T_C', 'power_user']).size()
Block  T_C  power_user
1      C    1              50
       T    1              50
2      C    0             450
       T    0             450
Experimentell design i Python

Nu kör vi en övning!

Experimentell design i Python

Preparing Video For Download...