การตั้งค่าข้อมูลการทดลอง

การออกแบบการทดลองด้วย Python

James Chapman

Curriculum Manager, DataCamp

ปัญหาของการสุ่ม
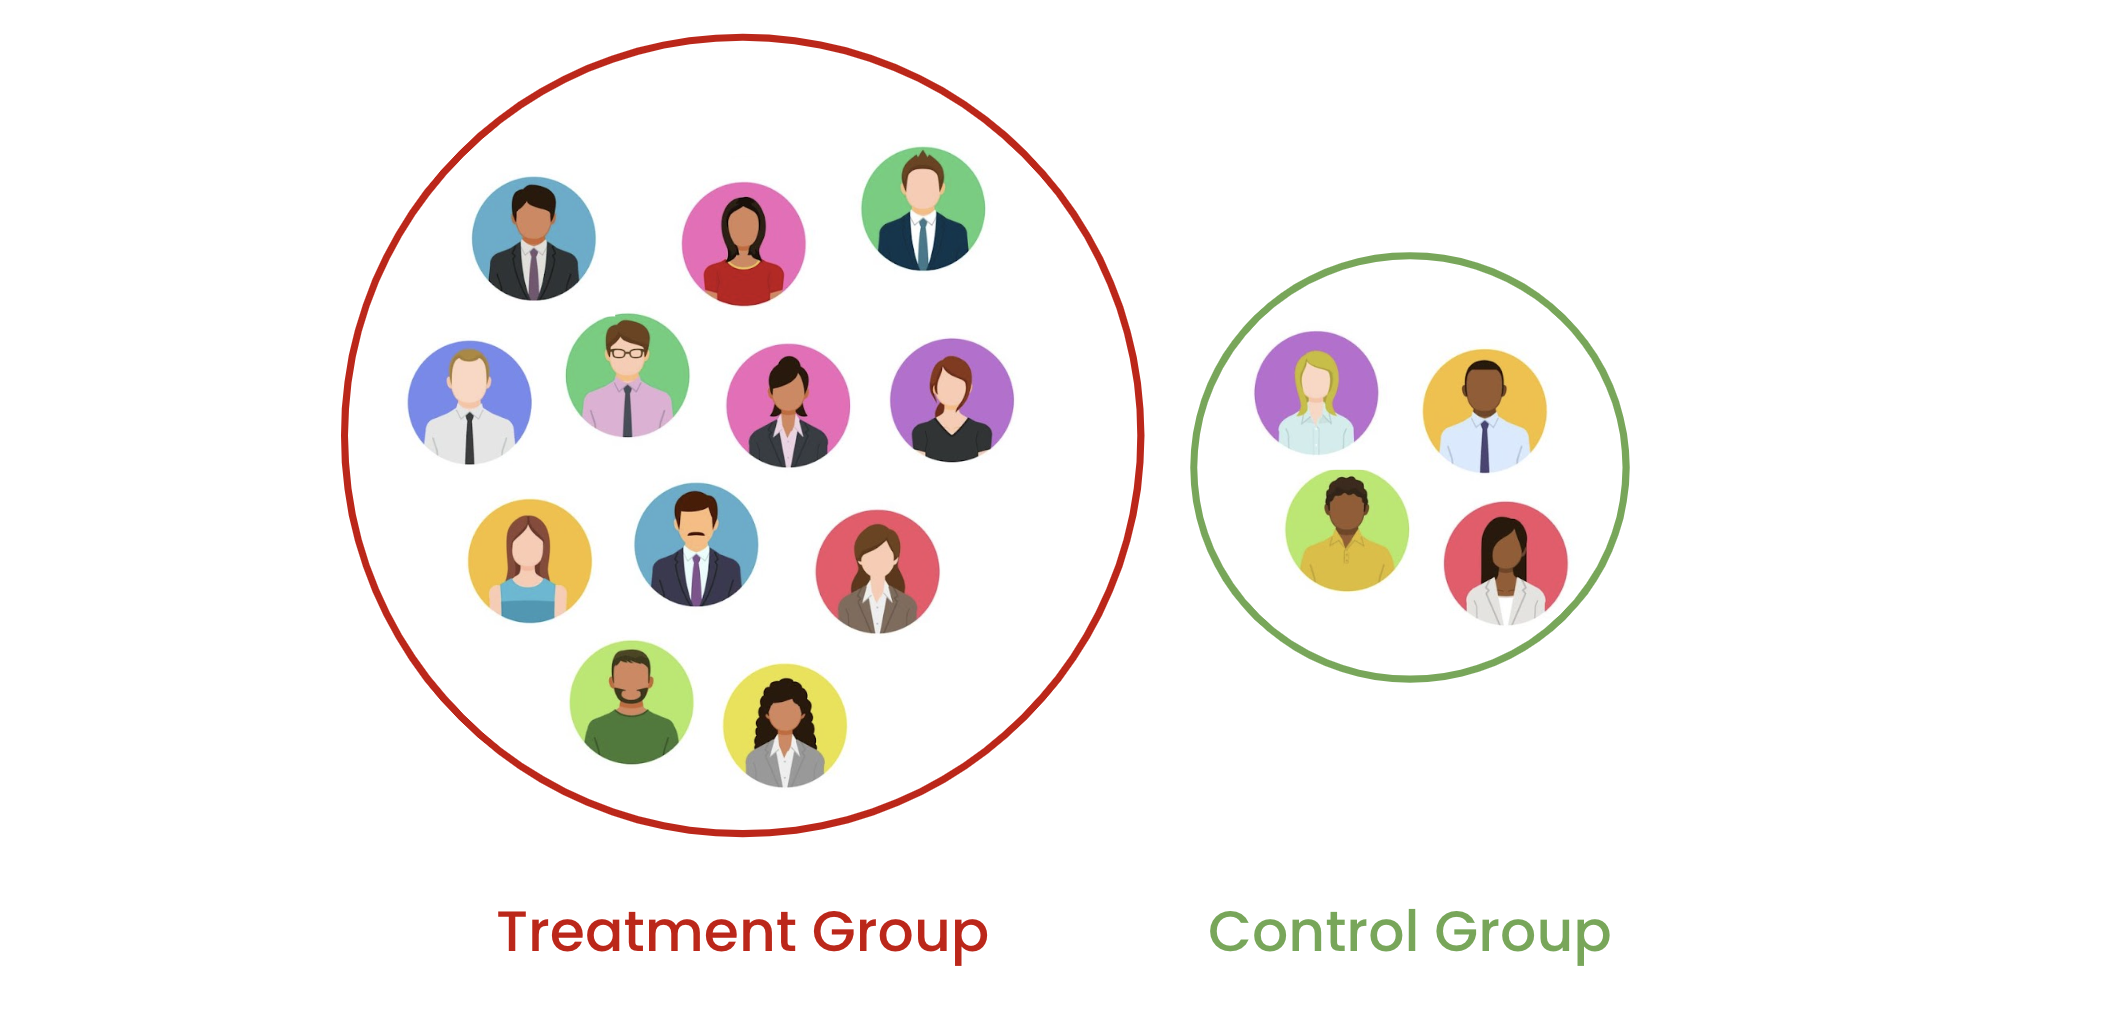
1) ปัญหาจำนวนไม่เท่ากัน: จำนวนผู้เข้าร่วมในแต่ละกลุ่มไม่เท่ากัน

สองกลุ่มที่มีจำนวนผู้เข้าร่วมต่างกัน

การออกแบบการทดลองด้วย Python

ปัญหาของการสุ่ม

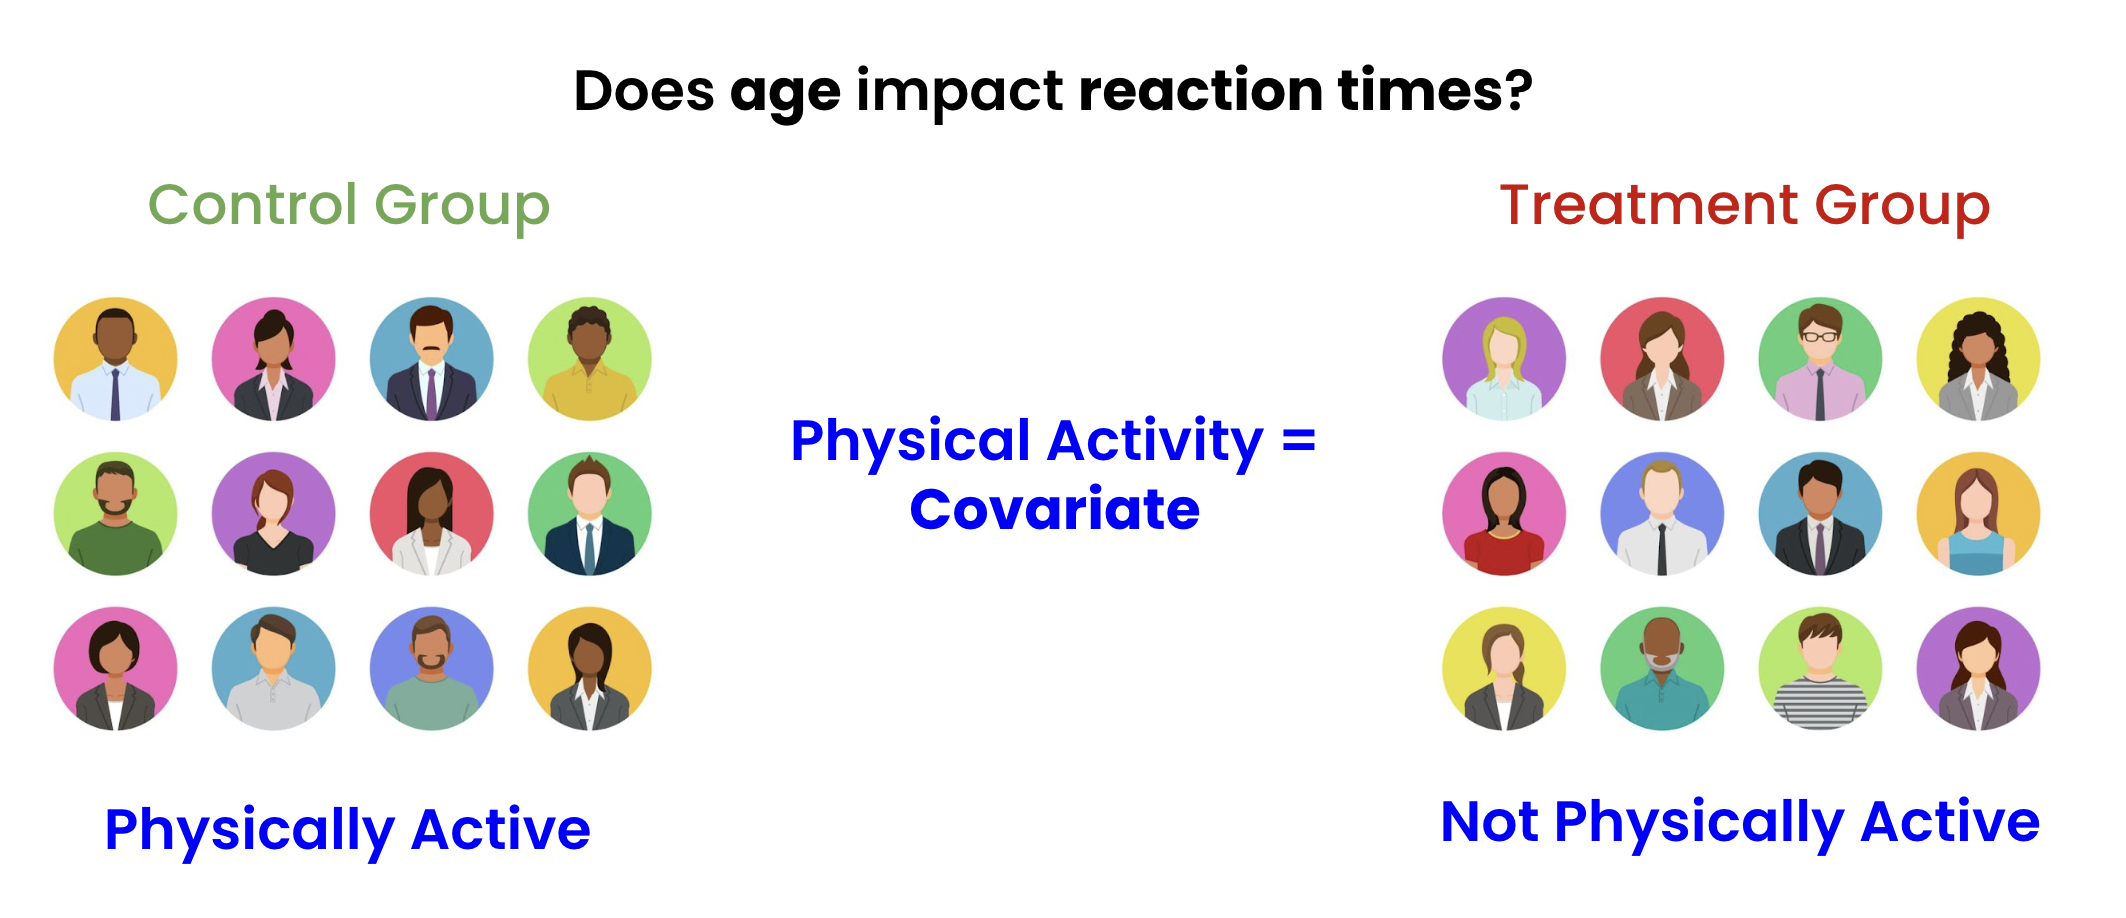
2) ปัญหา Covariate: ความแปรปรวนสูงใน covariate บางตัว → กลุ่มไม่สมดุลในการสุ่ม

กลุ่มควบคุมและกลุ่มทดลองที่ออกแบบเพื่อวัดผลกระทบของอายุต่อเวลาตอบสนอง โดยทั้งสองกลุ่มมีการกระจายตัวของสมรรถภาพร่างกายไม่เท่ากัน ซึ่งแม้ไม่ใช่ตัวแปรหลัก แต่อาจส่งผลต่อเวลาตอบสนองได้

ผลที่ตามมา: วัดผลกระทบของการทดลองได้ยากขึ้น!

การออกแบบการทดลองด้วย Python

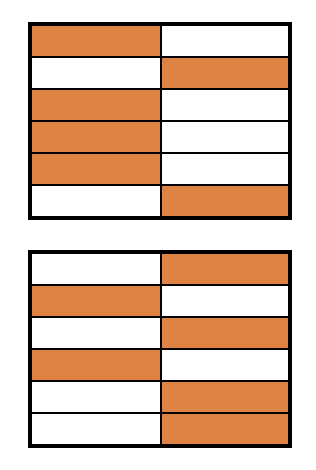
Block Randomization


  • แบ่งเป็นบล็อกขนาด $n$ ก่อน แล้วจึงสุ่มแบ่ง
    • แก้ปัญหาจำนวนไม่เท่ากัน

ตัวอย่าง Block Randomization แสดงกริดสีส้มและสีขาวสองชุด

  • ผู้เข้าร่วม 24 คน แบ่งเป็นสองกลุ่มแล้วสุ่มจัดสรร
การออกแบบการทดลองด้วย Python

ชุดข้อมูลของเรา

  • ชุดข้อมูล E-commerce (ecom) (1000 คน)
    • ขนาดตะกร้าเฉลี่ย
    • เวลาเฉลี่ยบนเว็บไซต์
    • Power user (ใช้งานเฉลี่ย 40+ นาที/วัน)
   basket_size  web_time  power_user
0          227         7           0
1          123         5           0
2           98        16           0
3          211        45           1
4          133        17           0
การออกแบบการทดลองด้วย Python

Block Randomization ใน Python

group1 = ecom.sample(frac=0.5, random_state=42, replace=False)
group1['Block'] = 1
group2 = ecom.drop(group1.index)
group2['Block'] = 2
print(len(group1), len(group2))
500,500
การออกแบบการทดลองด้วย Python

การแสดงผลการแบ่งกลุ่ม


import seaborn as sns
import matplotlib.pyplot as plt
sns.displot(data=ecom, 
            x='basket_size', 
            hue='power_user', 
            fill=True, 
            kind='kde')    
plt.show()

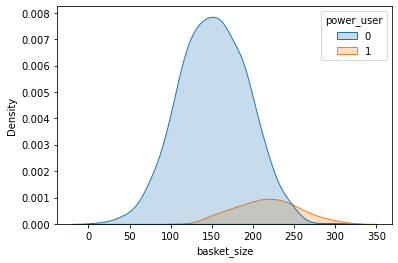
Confounding = ตัวแปรที่ อาจ ก่อให้เกิดผลแทนที่จะเป็นการทดลอง


กราฟการกระจาย seaborn แสดงการกระจายแบบปกติสองชุดที่โปร่งแสงเล็กน้อย ชุดสีน้ำเงินใหญ่กว่าและชุดสีส้มเล็กกว่า ทั้งสองทับซ้อนกันเล็กน้อยโดยชุดสีส้มอยู่ทางขวามากกว่า

การออกแบบการทดลองด้วย Python

Stratified Randomization


  • แบ่งตาม covariate ก่อน
    • แล้วจึงทำการสุ่ม
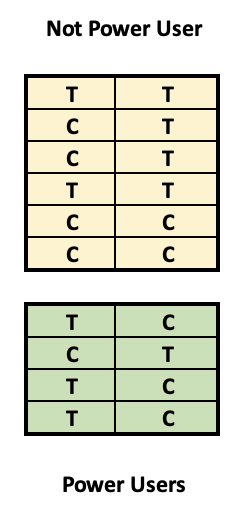
  • สีเขียว = Power users ทั้งหมด (สีเหลือง = ไม่ใช่ Power users)
    • จากนั้นแบ่ง Treatment/Control
  • แก้ปัญหา covariate/confounding
  • ทำได้กับหลาย covariate แต่จะซับซ้อนมากขึ้น!

ภาพกริดข้อมูลสองชุด ชุดหนึ่งสีเขียวและอีกชุดสีเหลือง แต่ละช่องมีตัวอักษร T หรือ C และกริดสีเหลืองมีขนาดใหญ่กว่า

การออกแบบการทดลองด้วย Python

Strata แรกของเรา

  • แยก Power users
  • สุ่มจัดสรรเป็น Treatment/Control
strata_1 = ecom[ecom['power_user'] == 1]
strata_1['Block'] = 1

strata_1_g1 = strata_1.sample(frac=0.5, replace=False) strata_1_g1['T_C'] = 'T'
strata_1_g2 = strata_1.drop(strata_1_g1.index) strata_1_g2['T_C'] = 'C'
การออกแบบการทดลองด้วย Python

Strata ที่สอง

  • แยกผู้ที่ไม่ใช่ Power users
  • สุ่มจัดสรรเป็น Treatment/Control
strata_2 = ecom.drop(strata_1.index)
strata_2['Block'] = 2

strata_2_g1 = strata_2.sample(frac=0.5, replace=False) strata_2_g1['T_C'] = 'T' strata_2_g2 = strata_2.drop(strata_2_g1.index) strata_2_g2['T_C'] = 'C'
การออกแบบการทดลองด้วย Python

ตรวจสอบการแบ่ง Strata

  • รวมบล็อกและกลุ่มเข้าด้วยกัน
  • ใช้ groupby เพื่อตรวจสอบการจัดสรร
ecom_stratified = pd.concat([strata_1_g1, strata_1_g2, strata_2_g1, strata_2_g2])

ecom_stratified.groupby(['Block','T_C', 'power_user']).size()
Block  T_C  power_user
1      C    1              50
       T    1              50
2      C    0             450
       T    0             450
การออกแบบการทดลองด้วย Python

มาฝึกกันเถอะ!

การออกแบบการทดลองด้วย Python

Preparing Video For Download...