การตั้งค่าการทดลอง

การออกแบบการทดลองด้วย Python

James Chapman

Curriculum Manager, DataCamp

ความหมายของการออกแบบการทดลอง
 

  • กระบวนการ
  • วิธีที่มี วัตถุประสงค์ และ ควบคุมได้
  • สรุป ข้อสรุปเฉพาะ
    • อ้างอิงจาก สมมติฐาน

experimental-design.png

1 https://www.sciencedirect.com/topics/earth-and-planetary-sciences/experimental-design
การออกแบบการทดลองด้วย Python

การสร้างข้อสรุปที่แข็งแกร่ง

X น่าจะมีผลต่อ Y โดยมีความเสี่ยงของข้อผิดพลาดเล็กน้อย


  • ภาษาที่แม่นยำและวัดผลได้

การวิเคราะห์ค่า P-value ชี้ว่า X มีผลต่อ Y โดยมี ความเสี่ยง Type I error 10%

  • Type I error: ปฏิเสธสมมติฐานหลักอย่างผิดพลาด


  • เป้าหมาย: การออกแบบการทดลอง และ การวิเคราะห์เชิงสถิติ
การออกแบบการทดลองด้วย Python

ทำไมต้องออกแบบการทดลอง?


มีประโยชน์ในหลายสาขา:

  • การวิจัยทางการแพทย์
  • การตลาด
  • การวิเคราะห์ผลิตภัณฑ์
  • การเกษตร
  • นโยบายภาครัฐ

why.png

การออกแบบการทดลองด้วย Python

คำศัพท์ที่ควรรู้...


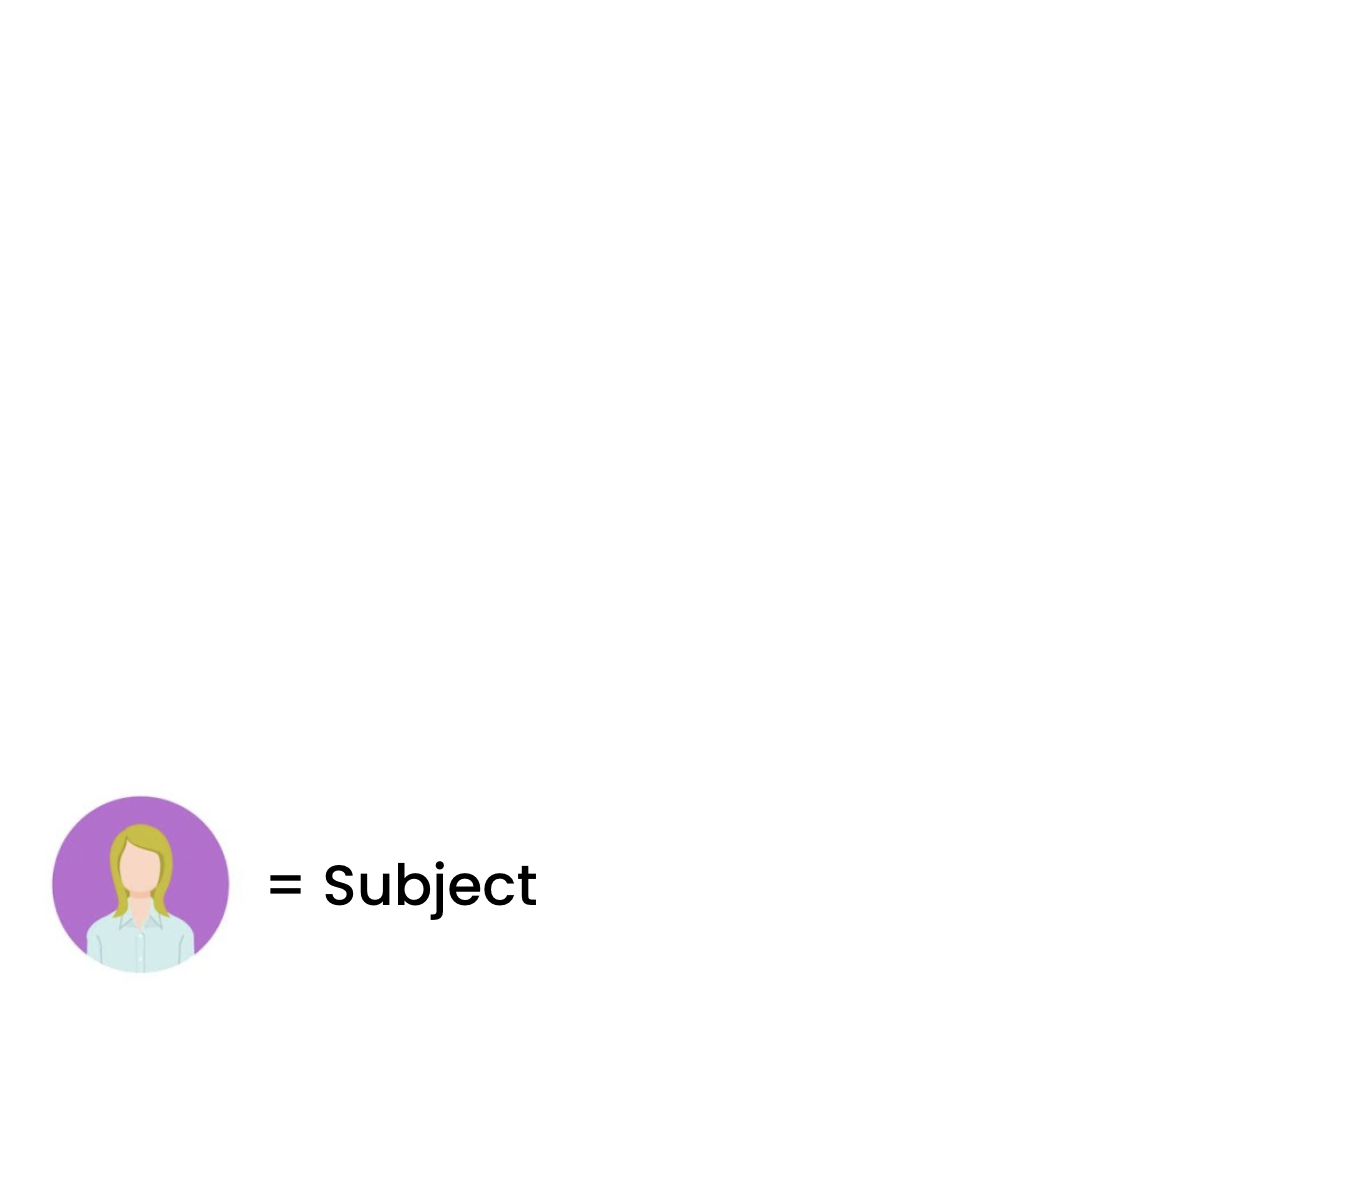
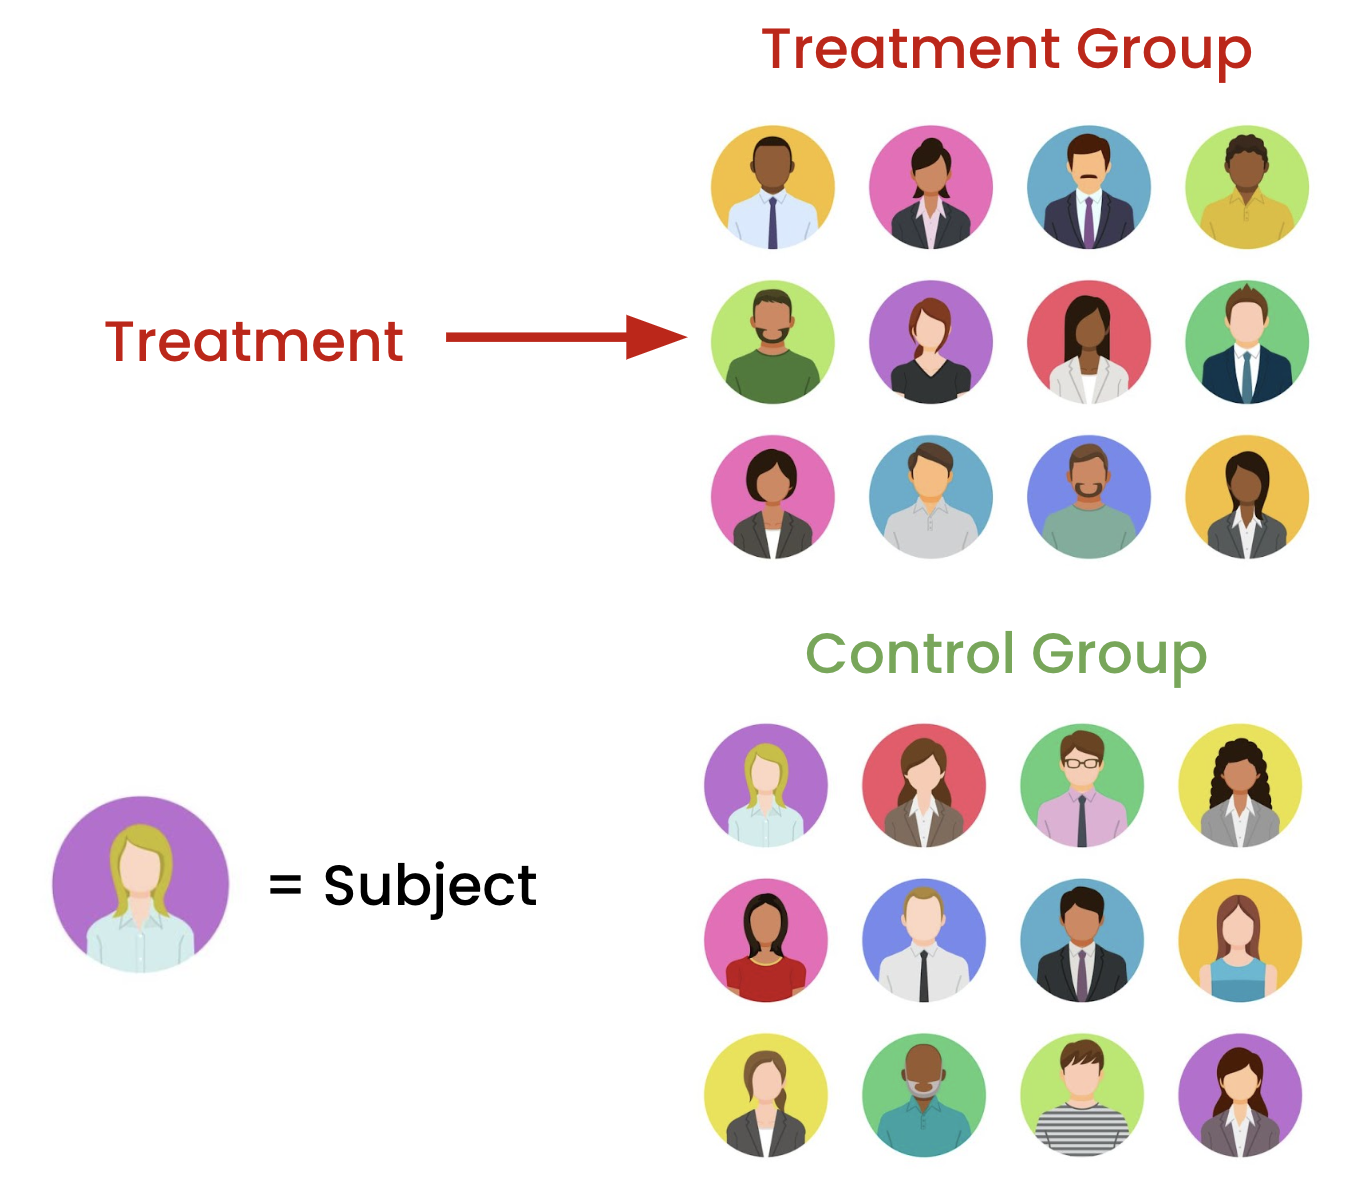
  • Subjects = สิ่งที่เราทดลอง (คน, พนักงาน, ผู้ใช้ ฯลฯ)

Subject คือบุคคลในกรณีนี้

การออกแบบการทดลองด้วย Python

คำศัพท์ที่ควรรู้...


  • Subjects = สิ่งที่เราทดลอง (คน, พนักงาน, ผู้ใช้ ฯลฯ)
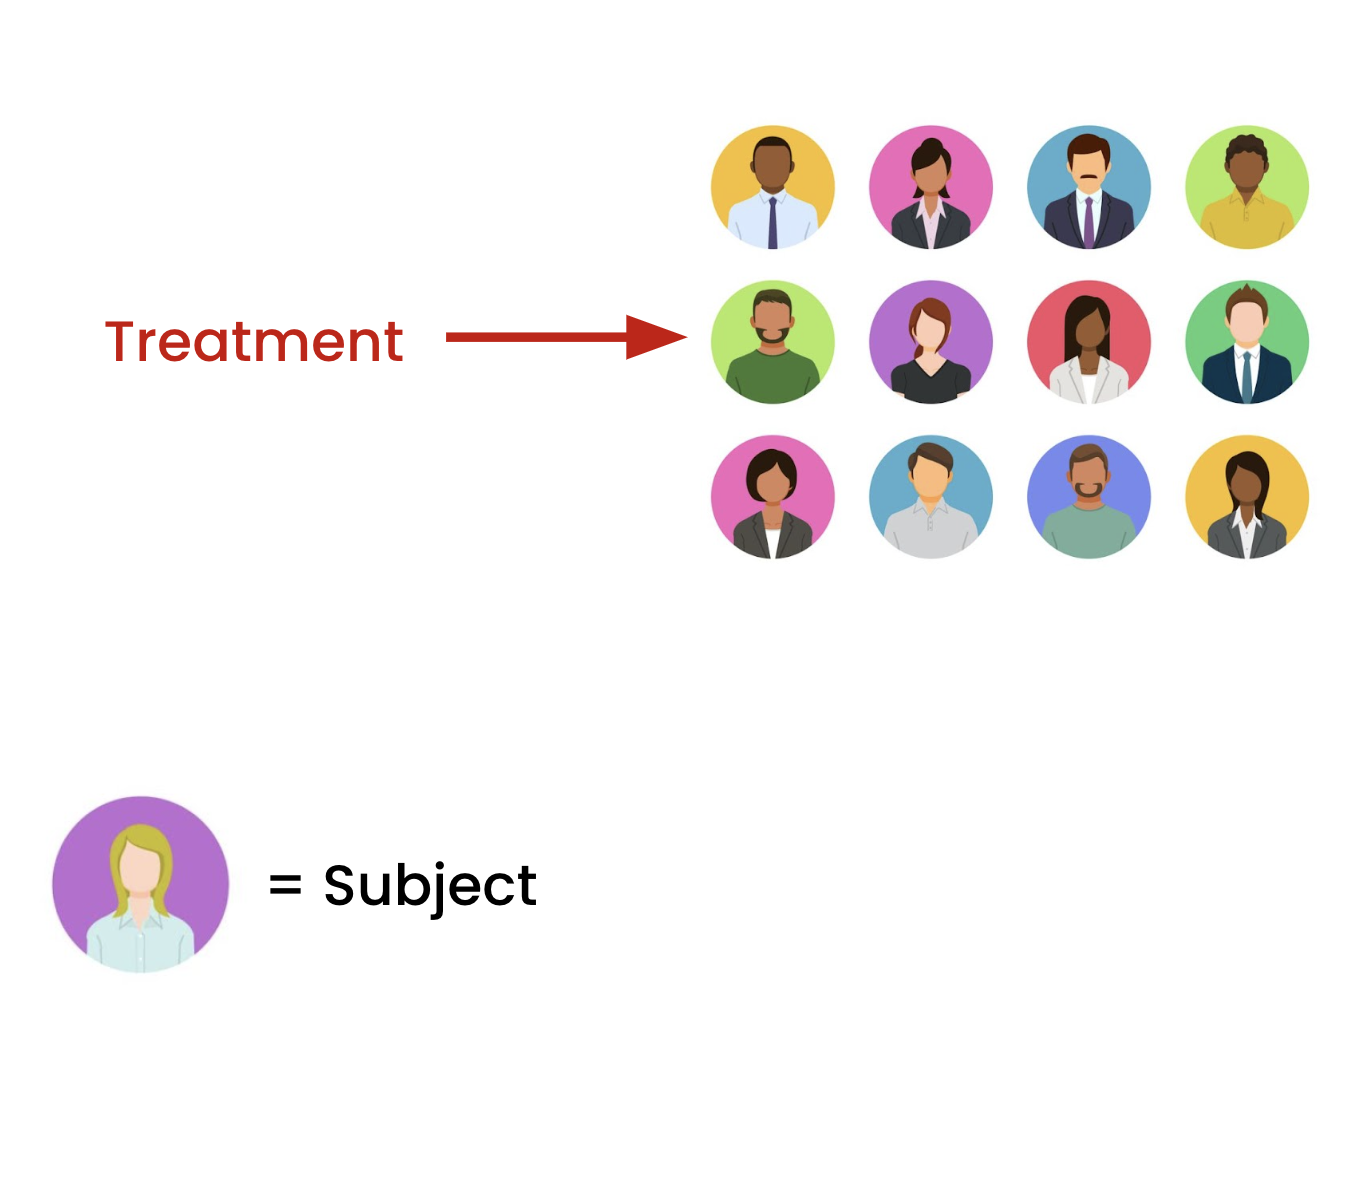
  • Treatment = การเปลี่ยนแปลงที่ให้กับกลุ่มหนึ่ง

Treatment ที่ถูกนำไปใช้กับกลุ่ม subjects

การออกแบบการทดลองด้วย Python

คำศัพท์ที่ควรรู้...


  • Subjects = สิ่งที่เราทดลอง (คน, พนักงาน, ผู้ใช้ ฯลฯ)
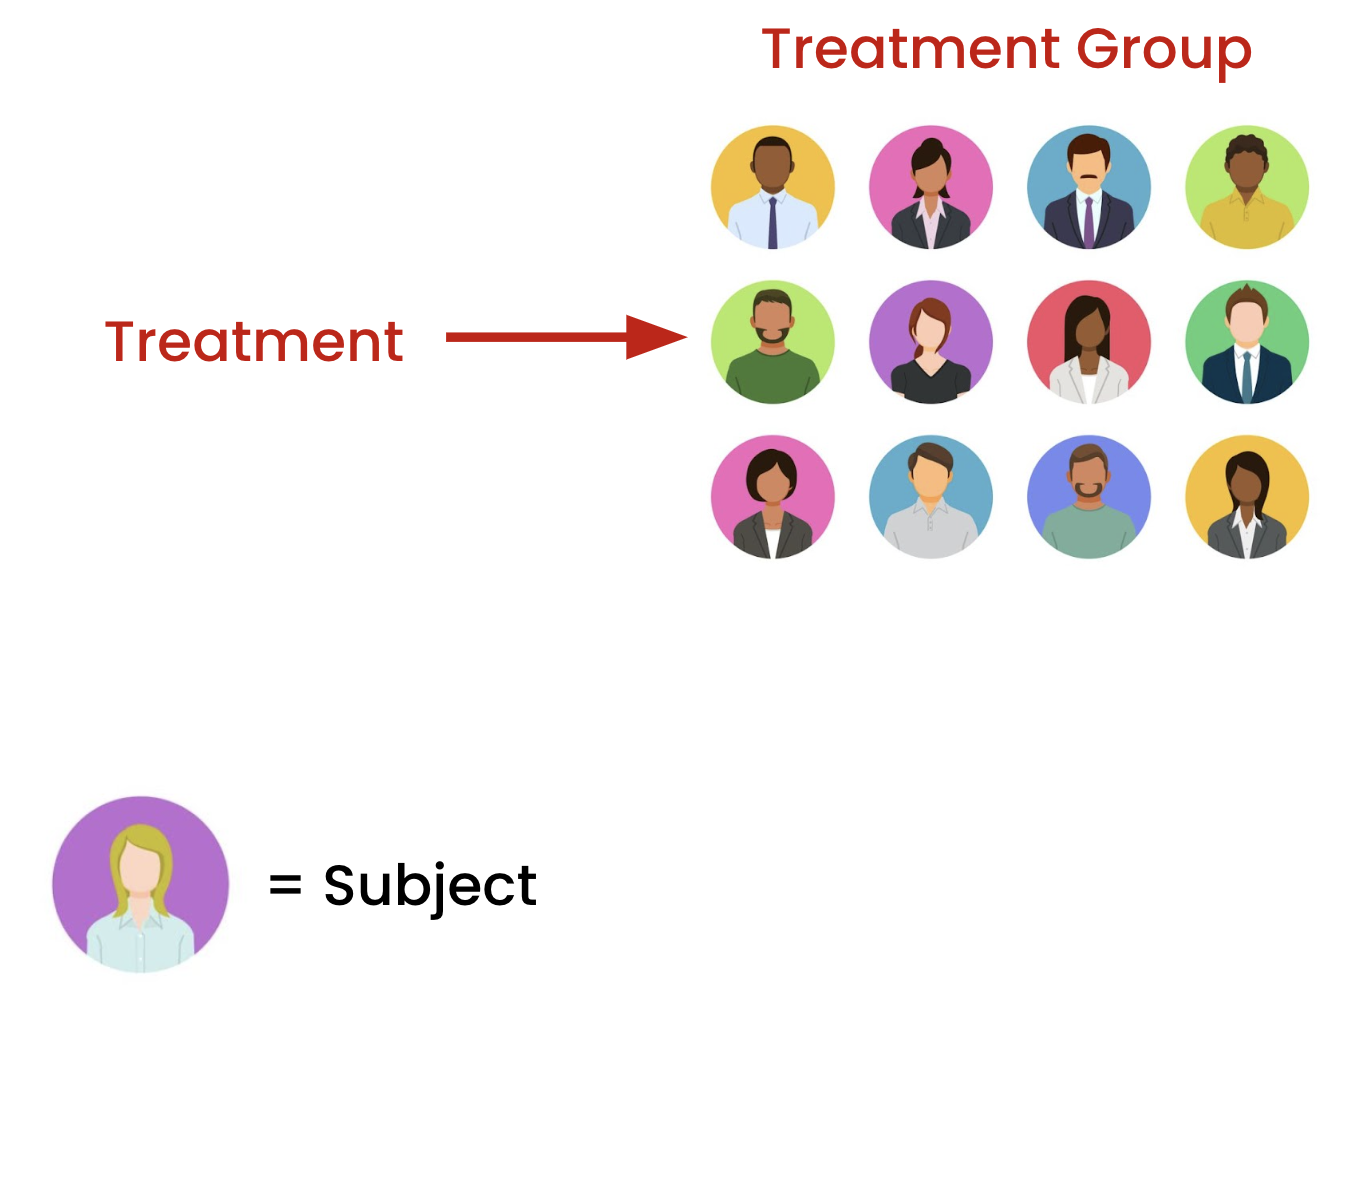
  • Treatment = การเปลี่ยนแปลงที่ให้กับกลุ่มหนึ่ง

Treatment ที่ถูกนำไปใช้กับกลุ่ม treatment

การออกแบบการทดลองด้วย Python

คำศัพท์ที่ควรรู้...


  • Subjects = สิ่งที่เราทดลอง (คน, พนักงาน, ผู้ใช้ ฯลฯ)
  • Treatment = การเปลี่ยนแปลงที่ให้กับกลุ่มหนึ่ง
  • Control = กลุ่มที่ไม่ได้รับการเปลี่ยนแปลงใดๆ

Subjects ที่แบ่งเป็นกลุ่ม treatment และกลุ่ม control

การออกแบบการทดลองด้วย Python

การกำหนด subjects เข้ากลุ่ม


  • จะแบ่ง subjects เข้ากลุ่มอย่างไร?
    • ตัวเลือก 1 - ไม่สุ่ม (ตัด DataFrame)
    • ตัวเลือก 2 - การสุ่มกำหนด


  • ตัวอย่าง: ข้อมูลส่วนสูงของ subjects 200 คนใน DataFrame heights
    id  height
0    0  177.98
1    1  174.17
2    2  178.89
การออกแบบการทดลองด้วย Python

การกำหนดกลุ่มแบบไม่สุ่ม


การแบ่งกลุ่มด้วยการ slice DataFrame

group1_nonrandom = heights.iloc[0:100,:]
group2_nonrandom = heights.iloc[100:,:]

compare_df = pd.concat( [group1_nonrandom['height'].describe(), group2_nonrandom['height'].describe()], axis=1) compare_df.columns = ['group1', 'group2'] print(compare_df)
  • ต่างกันมาก! (ค่าเฉลี่ยห่างกัน 9 ซม.)


       group1  group2
count  100.00  100.00
mean   170.32  179.19 <--
std      3.28    3.50
min    159.28  175.03
25%    168.06  176.57
50%    170.75  178.03
75%    173.09  180.79
max    174.92  191.32
การออกแบบการทดลองด้วย Python

การกำหนดกลุ่มแบบสุ่ม


  • ใช้ .sample()
    • n หรือ frac (สัดส่วน 0-1)
group1 = heights.sample(frac=0.5,
                        replace=False,
                        random_state=42)

group2 = heights.drop(group1.index)
print(compare_df)
  • ใกล้เคียงกันมาก! (<1 ซม.)


       group1  group2
count  100.00  100.00
mean   175.10  174.41 <--
std      5.39    5.78
min    163.07  159.28
25%    171.32  170.17
50%    175.22  174.86
75%    178.32  177.85
max    189.78  191.32
การออกแบบการทดลองด้วย Python

สรุปการกำหนดกลุ่ม


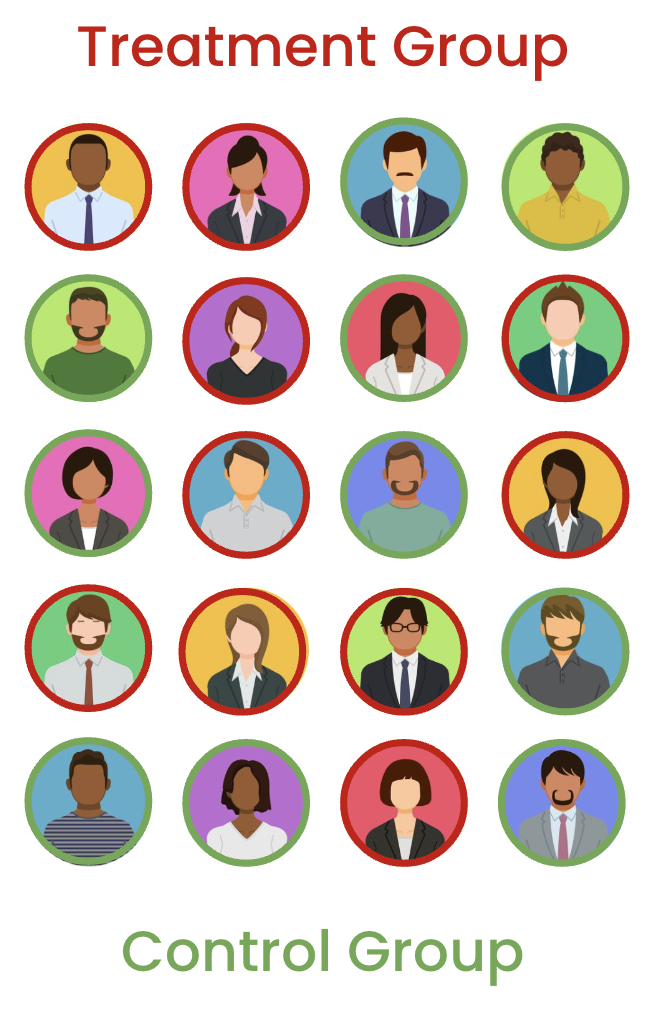
  • ควร สุ่ม กำหนด subjects เข้ากลุ่ม
    • การเปลี่ยนแปลงที่สังเกตได้จะถูกระบุสาเหตุได้อย่างถูกต้อง


  • การสุ่มกำหนด subjects: .sample()
  • ตรวจสอบความแตกต่าง: .describe()

Subjects ที่ถูกสุ่มกำหนดเข้ากลุ่ม treatment และกลุ่ม control

การออกแบบการทดลองด้วย Python

มาฝึกกันเถอะ!

การออกแบบการทดลองด้วย Python

Preparing Video For Download...