Rensa och förbättra dina data

Maskininlärning för tidsseriedata i Python

Chris Holdgraf

Fellow, Berkeley Institute for Data Science

Data är röriga

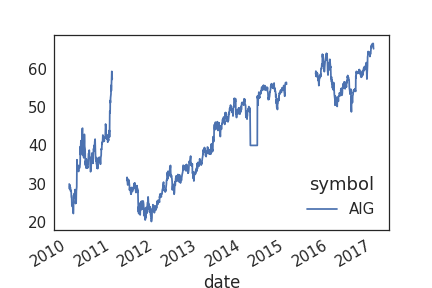
  • Verkliga data är ofta röriga
  • De två vanligaste problemen är saknade värden och avvikare
  • Det beror ofta på mänskliga fel, sensorfel, databasfel och liknande
  • Att visualisera rådata gör det lättare att upptäcka problemen
Maskininlärning för tidsseriedata i Python

Så ser röriga data ut

Maskininlärning för tidsseriedata i Python

Interpolation: fyll i saknade värden med hjälp av tid

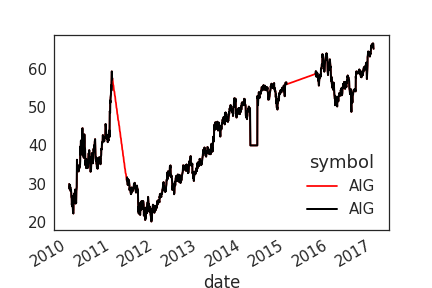
  • Ett vanligt sätt att hantera saknade värden är att interpolera dem
  • Med tidsseriedata kan du använda tid som stöd vid interpolation.
  • Här innebär interpolation att de kända värdena på vardera sida om ett gap används för att uppskatta vad som saknas.
Maskininlärning för tidsseriedata i Python

Interpolation i Pandas

# Return a boolean that notes where missing values are
missing = prices.isna()

# Interpolate linearly within missing windows
prices_interp = prices.interpolate('linear')

# Plot the interpolated data in red and the data w/ missing values in black
ax = prices_interp.plot(c='r')
prices.plot(c='k', ax=ax, lw=2)
Maskininlärning för tidsseriedata i Python

Visualisera interpolerade data

Maskininlärning för tidsseriedata i Python

Transformera data med rullande fönster

  • Rullande fönster kan också användas för att transformera data
  • Det har vi redan gjort en gång, för att jämna ut data
  • Men det går även att använda för mer komplexa transformationer
Maskininlärning för tidsseriedata i Python

Transformera data för att standardisera varians

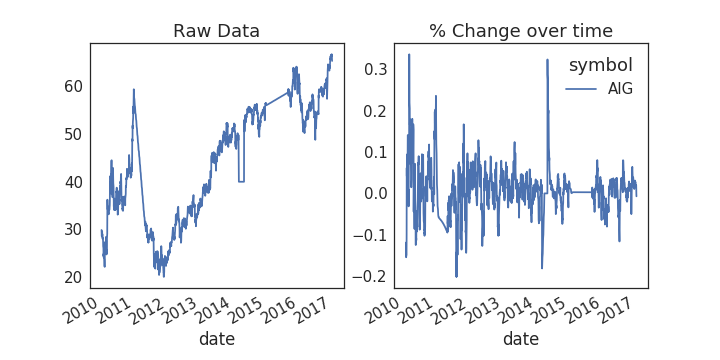
  • En vanlig transformation är att standardisera medelvärde och varians över tid. Det finns flera sätt att göra det.
  • Här visar vi hur du omvandlar datamängden så att varje punkt representerar procentuell förändring över ett tidigare fönster.
  • Det gör tidpunkterna mer jämförbara om de absoluta värdena varierar kraftigt.
Maskininlärning för tidsseriedata i Python

Transformera till procentuell förändring med Pandas

def percent_change(values):
    """Calculates the % change between the last value 
    and the mean of previous values"""
    # Separate the last value and all previous values into variables
    previous_values = values[:-1]
    last_value = values[-1]

    # Calculate the % difference between the last value 
    # and the mean of earlier values
    percent_change = (last_value - np.mean(previous_values)) \
    / np.mean(previous_values)
    return percent_change
Maskininlärning för tidsseriedata i Python

Tillämpa detta på våra data

# Plot the raw data
fig, axs = plt.subplots(1, 2, figsize=(10, 5))
ax = prices.plot(ax=axs[0])

# Calculate % change and plot
ax = prices.rolling(window=20).aggregate(percent_change).plot(ax=axs[1])
ax.legend_.set_visible(False)
Maskininlärning för tidsseriedata i Python

Hitta avvikare i dina data

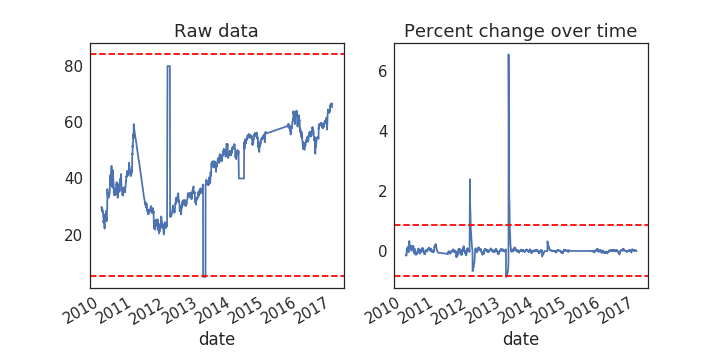
  • Avvikare är datapunkter som statistiskt skiljer sig markant från resten av datamängden.
  • De kan försämra modellens prediktionsförmåga och dra resultaten bort från det "sanna" värdet.
  • En lösning är att ta bort eller ersätta avvikare med ett mer representativt värde.

Var mycket försiktig med detta – det kan vara svårt att avgöra om ett extremt värde är ett verkligt sådant eller en felaktig mätning.

Maskininlärning för tidsseriedata i Python

Rita ett tröskelvärde i våra data

fig, axs = plt.subplots(1, 2, figsize=(10, 5))
for data, ax in zip([prices, prices_perc_change], axs):
    # Calculate the mean / standard deviation for the data
    this_mean = data.mean()
    this_std = data.std()

    # Plot the data, with a window that is 3 standard deviations 
    # around the mean
    data.plot(ax=ax)
    ax.axhline(this_mean + this_std * 3, ls='--', c='r')
    ax.axhline(this_mean - this_std * 3, ls='--', c='r')
Maskininlärning för tidsseriedata i Python

Visualisera tröskelvärden för avvikare
Maskininlärning för tidsseriedata i Python

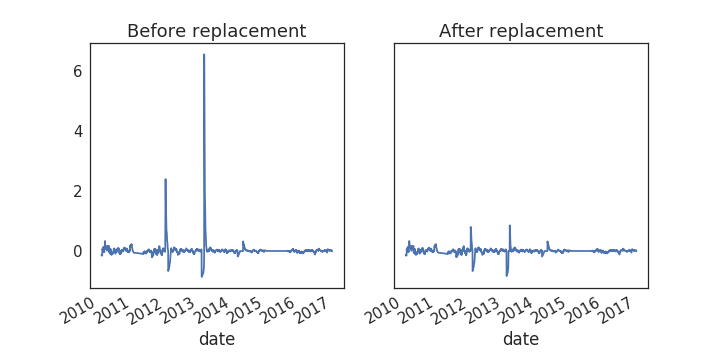
Ersätt avvikare med hjälp av tröskelvärdet

# Center the data so the mean is 0
prices_outlier_centered = prices_outlier_perc - prices_outlier_perc.mean()

# Calculate standard deviation
std = prices_outlier_perc.std()

# Use the absolute value of each datapoint 
# to make it easier to find outliers
outliers = np.abs(prices_outlier_centered) > (std * 3)

# Replace outliers with the median value
# We'll use np.nanmean since there may be nans around the outliers
prices_outlier_fixed = prices_outlier_centered.copy()
prices_outlier_fixed[outliers] = np.nanmedian(prices_outlier_fixed)

Maskininlärning för tidsseriedata i Python

Visualisera resultatet

fig, axs = plt.subplots(1, 2, figsize=(10, 5))
prices_outlier_centered.plot(ax=axs[0])
prices_outlier_fixed.plot(ax=axs[1])
Maskininlärning för tidsseriedata i Python

Nu kör vi en övning!

Maskininlärning för tidsseriedata i Python

Preparing Video For Download...