Середній рівень Regression у R
Richie Cotton
Data Evangelist at DataCamp
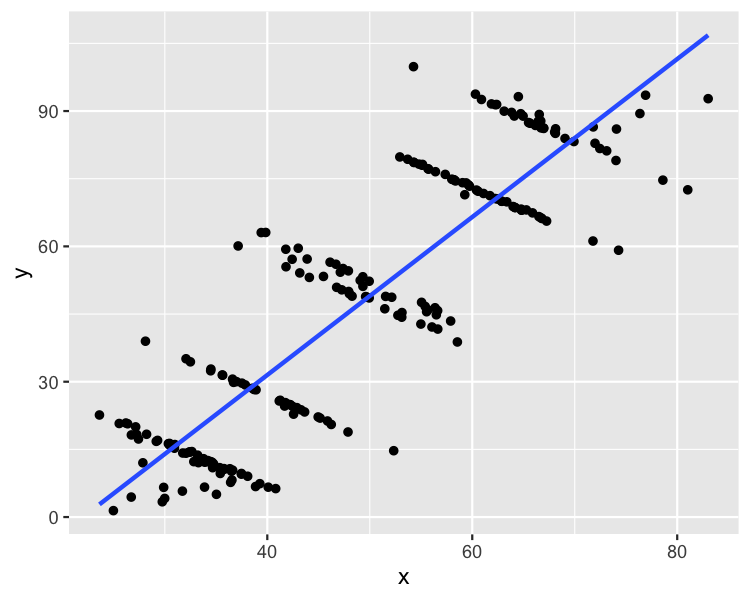
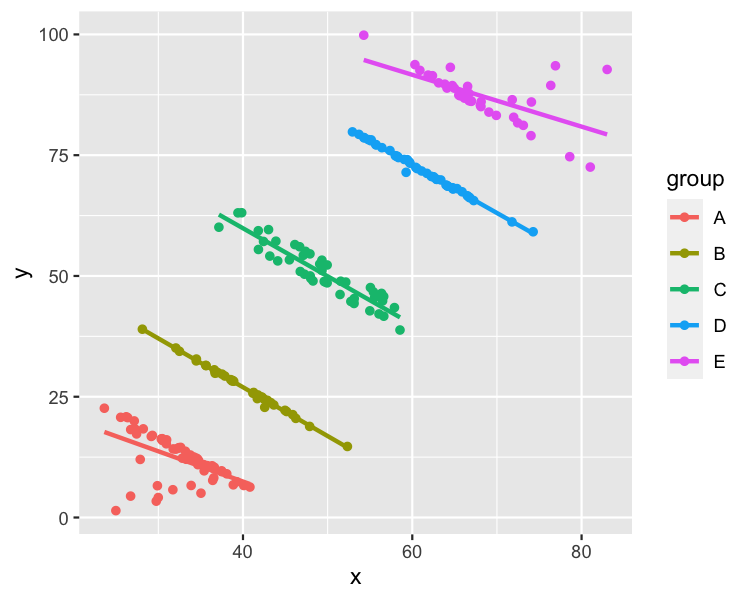
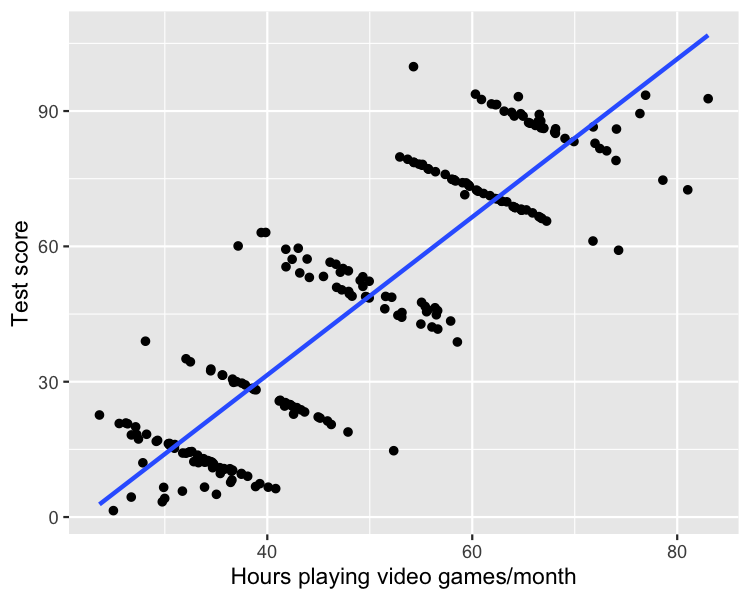
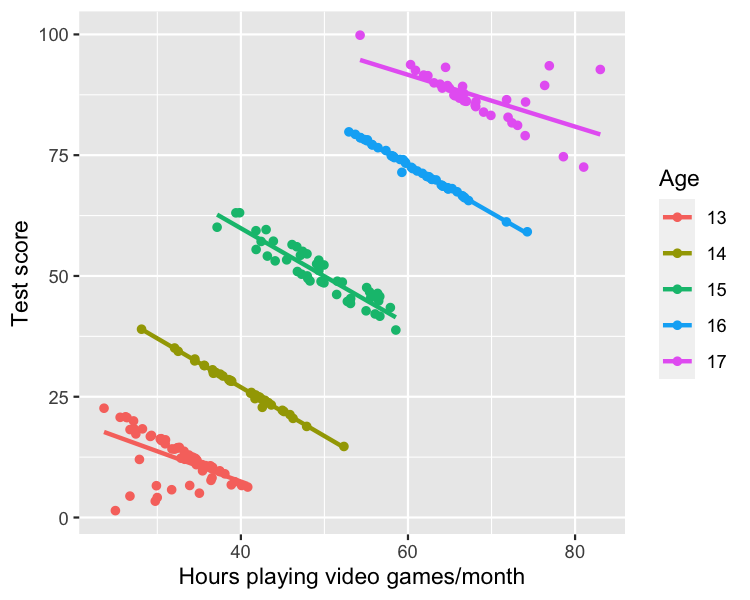
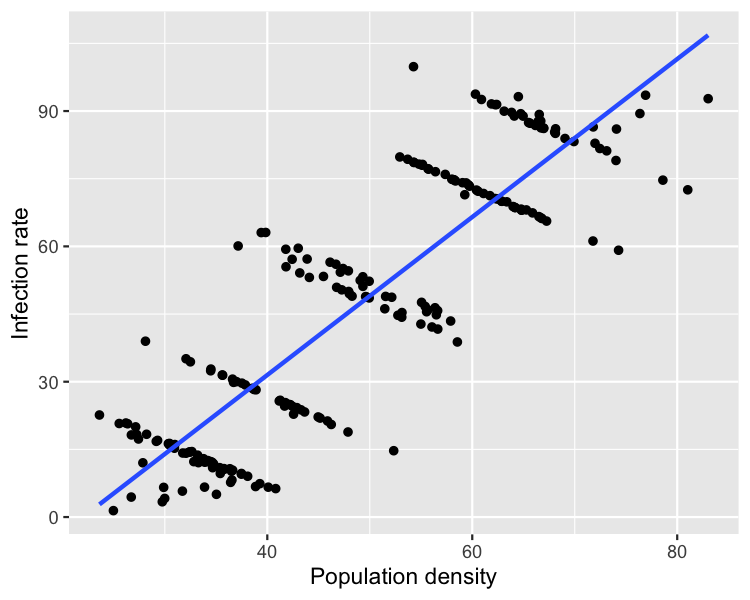
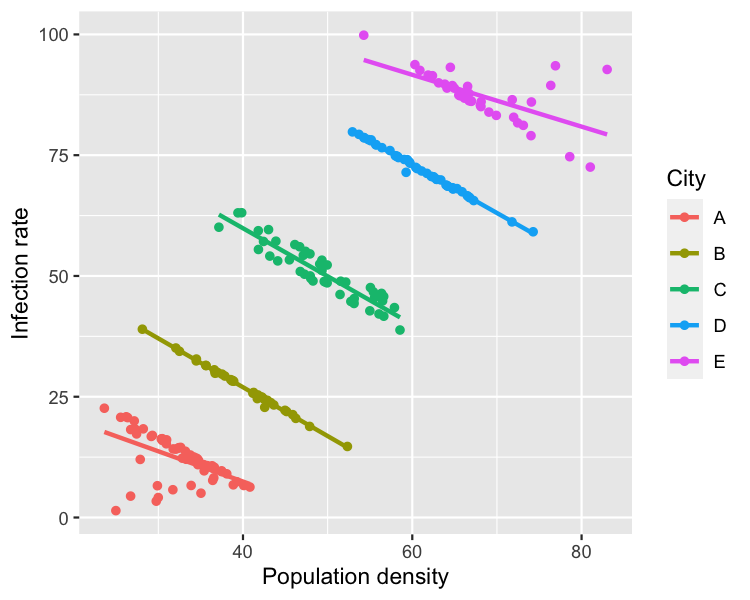
Парадокс Сімпсона виникає, коли тренд моделі на всьому наборі даних суттєво відрізняється від трендів моделей на підмножинах набору даних.
trend = коефіцієнт нахилу
| x | y | group |
|---|---|---|
| 62.24344 | 70.60840 | D |
| 52.33499 | 14.70577 | B |
| 56.36795 | 46.39554 | C |
| 66.80395 | 66.17487 | D |
| 66.53605 | 89.24658 | E |
| 62.38129 | 91.45260 | E |
mdl_whole <- lm(
y ~ x,
data = simpsons_paradox
)
coefficients(mdl_whole)
(Intercept) x
-38.554 1.751
mdl_by_group <- lm(
y ~ group + group:x + 0,
data = simpsons_paradox
)
coefficients(mdl_by_group)
groupA groupB groupC groupD groupE
32.5051 67.3886 99.6333 132.3932 123.8242
groupA:x groupB:x groupC:x groupD:x groupE:x
-0.6266 -1.0105 -0.9940 -0.9908 -0.5364
ggplot(simpsons_paradox, aes(x, y)) +
geom_point() +
geom_smooth(method = "lm", se = FALSE)

ggplot(simpsons_paradox, aes(x, y, color = group)) +
geom_point() +
geom_smooth(method = "lm", se = FALSE)

Якщо можливо, побудуйте графік набору даних.
Неможливо обрати «найкращу» модель узагалі — це залежить від даних і запитання, на яке ви відповідаєте.
Сформулюйте запитання перед моделюванням.


Середній рівень Regression у R