การออกแบบการทดลองที่ทำซ้ำได้

การพัฒนาโมเดล Machine Learning สำหรับ Production

Sinan Ozdemir

Data Scientist and Author

การทดลองที่ทำซ้ำได้

  • เพิ่มความถูกต้องและความน่าเชื่อถือ
  • ทำซ้ำผลลัพธ์ได้ง่ายขึ้น
  • ส่งเสริมการทำงานร่วมกัน
  • ลดความเสี่ยงจาก bias ในโมเดล ML
  • เสริมความน่าเชื่อถือของกระบวนการวิจัย
การพัฒนาโมเดล Machine Learning สำหรับ Production

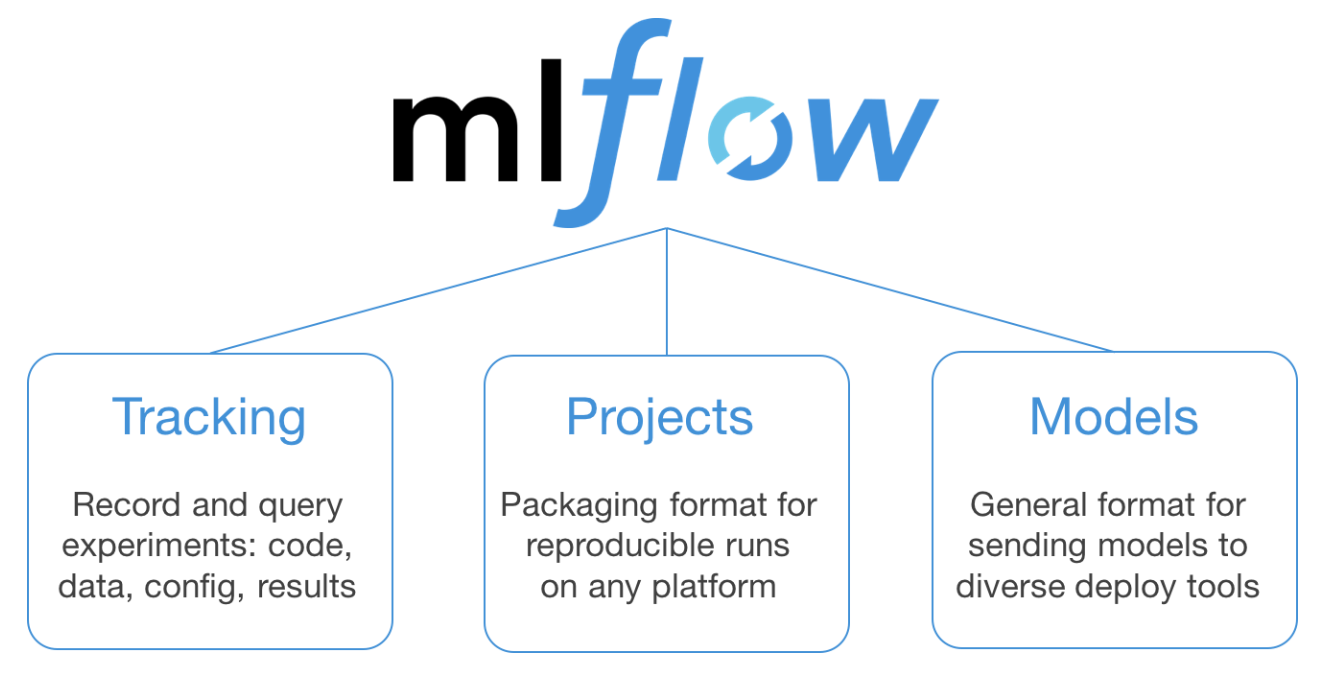
MLflow

แพลตฟอร์มโอเพนซอร์สสำหรับติดตามและจัดการการทดลอง machine learning ใช้ MLflow เพื่อ:

  • สร้าง ML pipeline ที่ทำซ้ำได้
  • ติดตามและจัดการ:
    • package dependencies
    • เวอร์ชันของโค้ด
    • การตั้งค่าการทดลอง
  • รองรับผู้ใช้หลายคนในการเข้าถึงการทดลอง

mlflow

1 https://www.databricks.com/blog/2018/06/05/introducing-mlflow-an-open-source-machine-learning-platform.html
การพัฒนาโมเดล Machine Learning สำหรับ Production

ตัวอย่างการใช้ MLflow

# standard scikit-learn imports
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

# new imports from MLflow
import mlflow
import mlflow.sklearn
การพัฒนาโมเดล Machine Learning สำหรับ Production

ตัวอย่างการใช้ MLflow (ต่อ)

with mlflow.start_run():  # Start an MLflow run assuming we have data prepared

    # Build and train model
    rf = RandomForestClassifier()
    rf.fit(X_train, y_train)

    # Log parameters and model information
    mlflow.log_param("n_estimators", rf.n_estimators)
    mlflow.sklearn.log_model(rf, "model")

    y_pred = rf.predict(X_test)  # Evaluate model
    accuracy = accuracy_score(y_test, y_pred)
    mlflow.log_metric("accuracy", accuracy)  # log the test accuracy metric
การพัฒนาโมเดล Machine Learning สำหรับ Production

การติดตามโค้ด

  • บันทึกเวอร์ชันและการเปลี่ยนแปลงของโค้ดด้วย MLflow
  • เปรียบเทียบโค้ดต่างเวอร์ชันกัน
  • ระบุว่าโค้ดเวอร์ชันใดสร้างผลลัพธ์ชุดนั้น
  • ทำซ้ำการทดลองได้อย่างง่ายดาย
  • ช่วยให้ debug และแก้ไขโค้ดได้สะดวก
การพัฒนาโมเดล Machine Learning สำหรับ Production

Model registries

  • คลังเก็บโมเดลและ metadata แบบรวมศูนย์
  • ใช้ MLflow บันทึก จัดเก็บ และเปรียบเทียบโมเดลต่างเวอร์ชันได้
  • ทำซ้ำ ML pipeline ทั้งหมด
  • ใช้เปรียบเทียบโมเดล
  • รับประกันความถูกต้องและความน่าเชื่อถือของโมเดล
storage

การพัฒนาโมเดล Machine Learning สำหรับ Production

การทำซ้ำการทดลอง

  • ติดตามและบันทึกข้อมูล input โค้ด และการตั้งค่า
  • ทำซ้ำ ML pipeline ทั้งหมด
  • สร้างความน่าเชื่อถือในผลลัพธ์ของโมเดล machine learning
  • เปิดโอกาสให้ผู้อื่นตรวจสอบและต่อยอดงาน
  • รับประกันว่าผลลัพธ์สอดคล้องกันในทุก run

การพัฒนาโมเดล Machine Learning สำหรับ Production

ทบทวนเรื่องเอกสารประกอบ

  • เอกสารประกอบมีความสำคัญต่อ ML ที่ทำซ้ำได้ และควรครอบคลุม:
    • ข้อมูล input ของโมเดล
    • โค้ดที่ใช้สร้างโมเดล
    • การตั้งค่าที่ใช้ในการทดลอง
    • ผลลัพธ์ของการทดลอง (เช่น โมเดลที่เลือก ฯลฯ)
  • เอกสารควรเข้าถึงได้ง่าย
  • ควรเป็นบันทึกครบถ้วนของการทดลอง
การพัฒนาโมเดล Machine Learning สำหรับ Production

มาฝึกกันเถอะ!

การพัฒนาโมเดล Machine Learning สำหรับ Production

Preparing Video For Download...