Finjustering av modeller med Hugging Face
Finjustering med Llama 3

Francesca Donadoni
Curriculum Manager, DataCamp
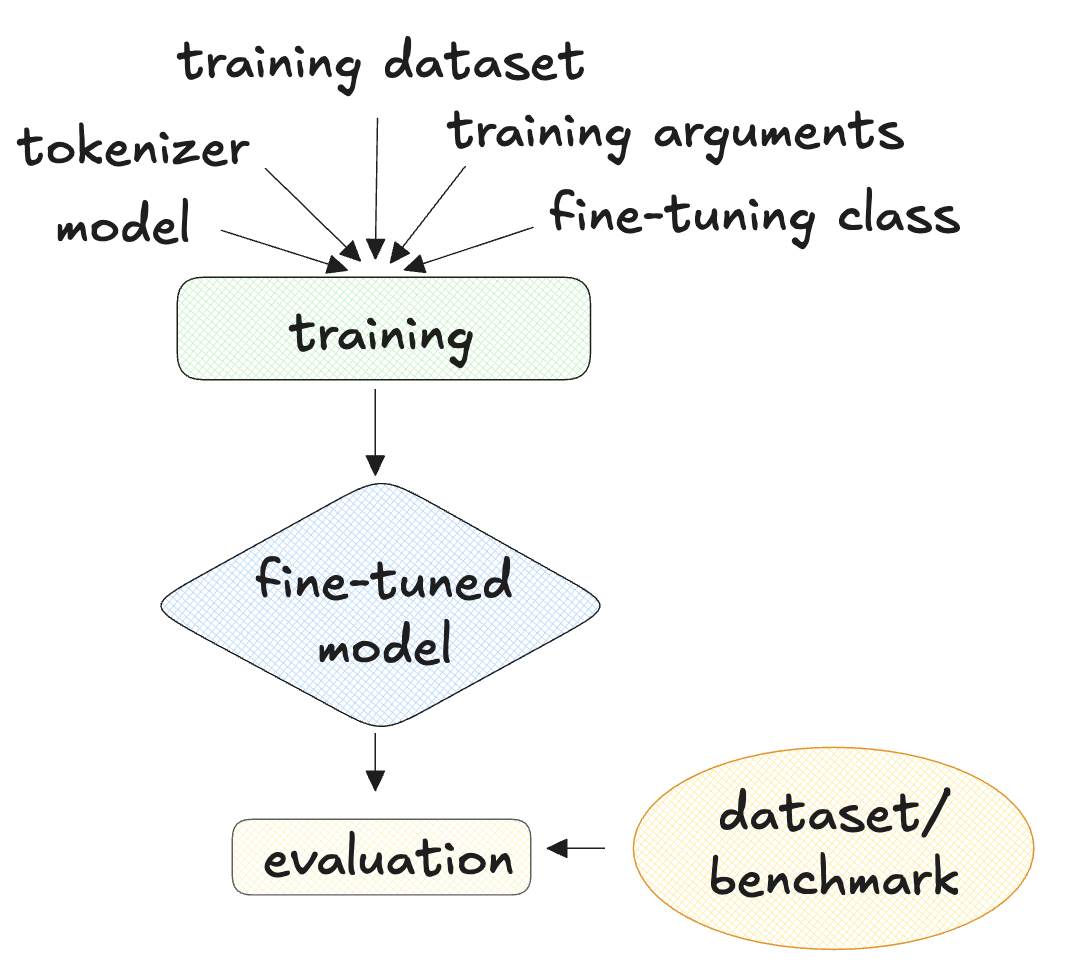
Vad behövs för att utföra finjustering?
- Språkmodell + tokeniserare (en LLama-modell, t.ex. TinyLLama-v0)
- Träningsdatamängd (Bitext-datamängden för kundservice)
- Träningsargument
- Utför finjustering (SFTTrainer från TRL)
- Utvärderingsbenchmark eller datamängd
Ladda modeller och tokeniserare med Auto-klasser
model_name="Maykeye/TinyLLama-v0" model = AutoModelForCausalLM.from_pretrained(model_name) tokenizer = AutoTokenizer.from_pretrained(model_name)tokenizer.pad_token = tokenizer.eos_token
1 https://huggingface.co/docs/transformers/main/en/model_doc/auto
Definiera träningsparametrar med TrainingArguments
training_arguments = TrainingArguments(per_device_train_batch_size=1,learning_rate=2e-3,max_grad_norm=0.3,max_steps=200,... gradient_accumulation_steps=2, save_steps=10,)
1 https://huggingface.co/docs/transformers/v4.40.1/en/main_classes/trainer#transformers.TrainingArguments
Konfigurera träning med SFTTrainer
trainer = SFTTrainer(model=model, tokenizer=tokenizer,train_dataset=dataset, dataset_text_field='conversation',max_seq_length=250,args=training_arguments)
Förstå finjusteringsresultat med SFTTrainer
trainer.train()
TrainOutput(global_step=200, training_loss=1.9401231002807617,
            metrics={'train_runtime': 142.5501,
                     'train_samples_per_second': 2.806,
                     'train_steps_per_second': 1.403,
                     'total_flos': 1461265827840.0,
                     'train_loss': 1.9401231002807617,
                     'epoch': 2.0})
Utvärdera en tränad modell med ROUGE-1
- ROUGE-1: Andel överlappande ord mellan en referenstext och genererad text
import evaluaterouge = evaluate.load('rouge')predictions = ["hello there", "general kenobi"] references = ["hello there", "master yoda"]results = rouge.compute(predictions=predictions, references=references) print(results)
{'rouge1': 0.5, 'rouge2': 0.5, 'rougeL': 0.5, 'rougeLsum': 0.5}
1 https://huggingface.co/spaces/evaluate-metric/rouge
Använda ROUGE-1-poängen
- Använd utvärderingsuppsättningen i
evaluation_dataset
def generate_predictions_and_reference(dataset): predictions = [] references = [] for row in dataset: inputs = tokenizer.encode(row["instruction"], return_tensors="pt")outputs = model.generate(inputs)decoded_outputs = tokenizer.decode(outputs[0, inputs.shape[1]:], skip_special_tokens = True)references += [row["response"]] predictions += [decoded_outputs] return references, predictions
Köra ROUGE-1 på en utvärderingsuppsättning
references, predictions = generate_predictions_and_reference(evaluation_dataset)
rouge = evaluate.load('rouge')
results = rouge.compute(predictions=predictions, references=references)
print(results)
Finjustering vs. ingen finjustering
Finjusterad
{'rouge1': 0.22425812699023645,
 'rouge2': 0.039502543246449,
 'rougeL': 0.1501513006868983,
 'rougeLsum': 0.18685597710721613}
Ingen finjustering
{'rouge1': 0.1310928764315105,
 'rouge2': 0.04581654122835097,
 'rougeL': 0.08415351421221628,
 'rougeLsum': 0.1224749866097021}
Nu kör vi en övning!
Finjustering med Llama 3

