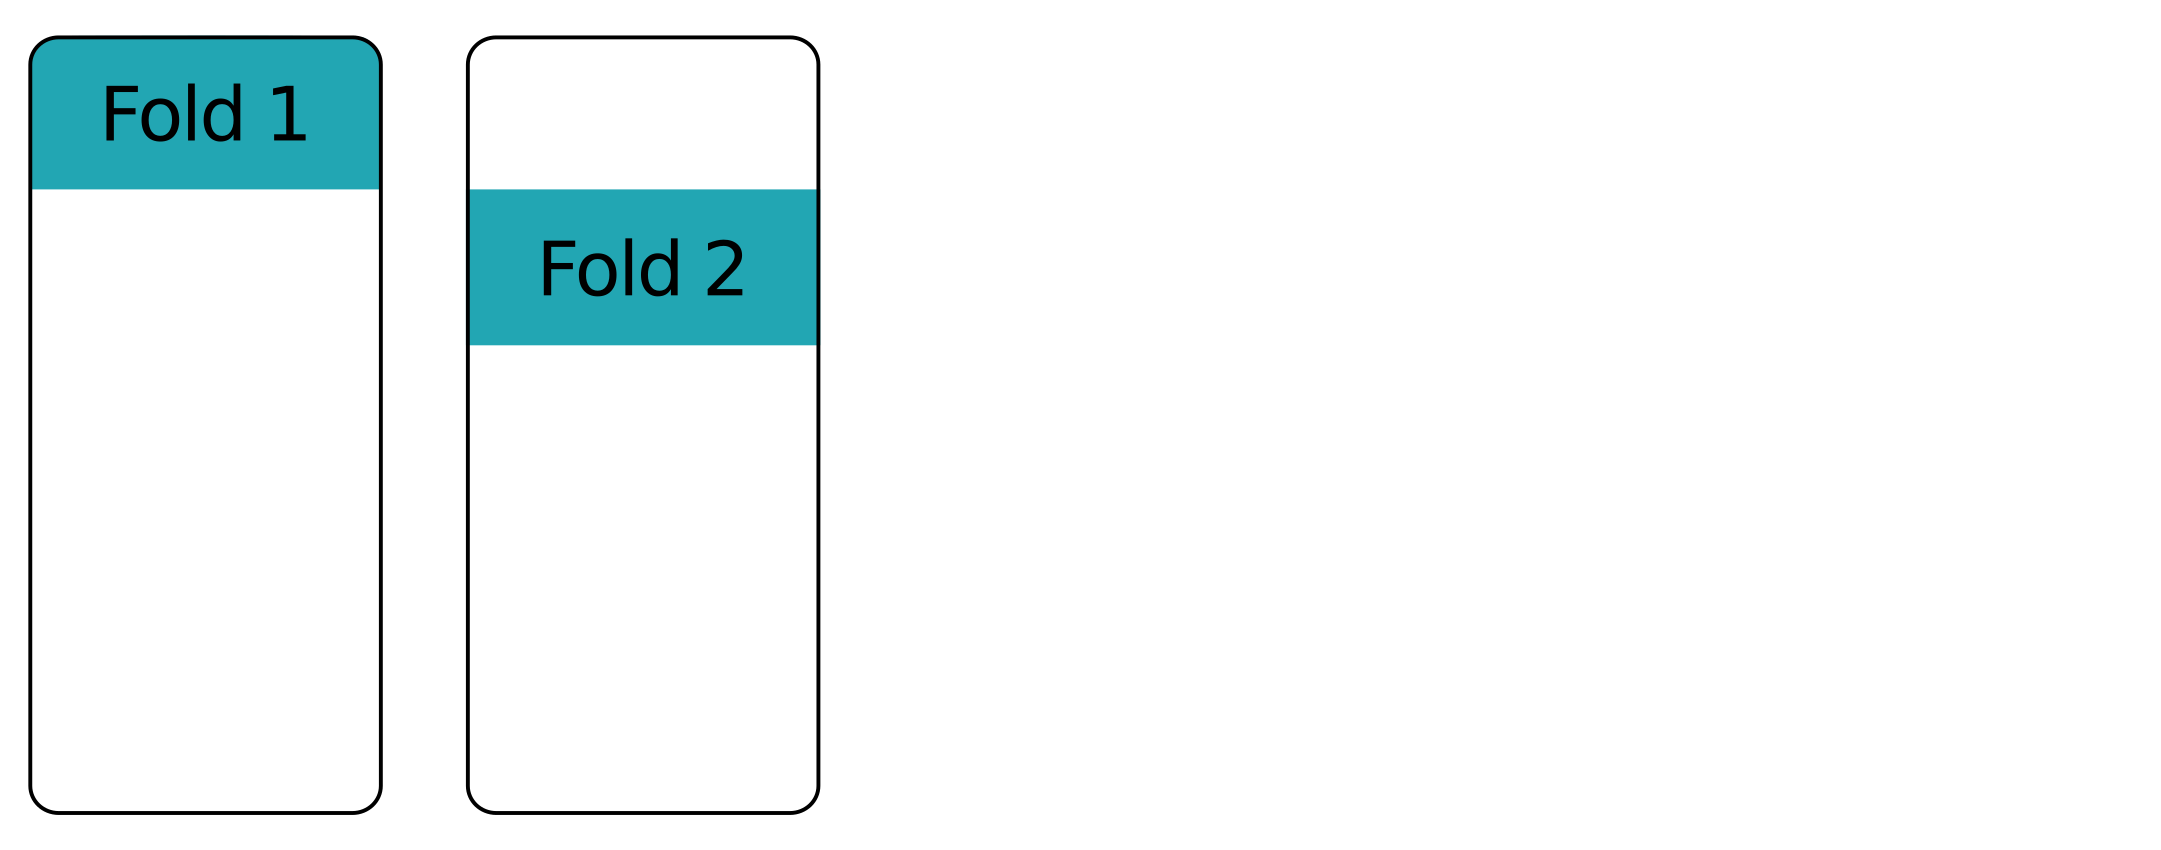Maskininlärning med PySpark
Andrew Collier
Data Scientist, Fathom Data


cars.select('mass', 'cyl', 'consumption').show(5)
+------+---+-----------+
| mass|cyl|consumption|
+------+---+-----------+
|1451.0| 6| 9.05|
|1129.0| 4| 6.53|
|1399.0| 4| 7.84|
|1147.0| 4| 7.84|
|1111.0| 4| 9.05|
+------+---+-----------+
Ett objekt för att bygga modellen. Det kan vara en pipeline.
regression = LinearRegression(labelCol='consumption')
Ett objekt för att utvärdera modellens prestanda.
evaluator = RegressionEvaluator(labelCol='consumption')
from pyspark.ml.tuning import CrossValidator, ParamGridBuilder
Ett rutnät med parametervärden (tomt för tillfället).
params = ParamGridBuilder().build()
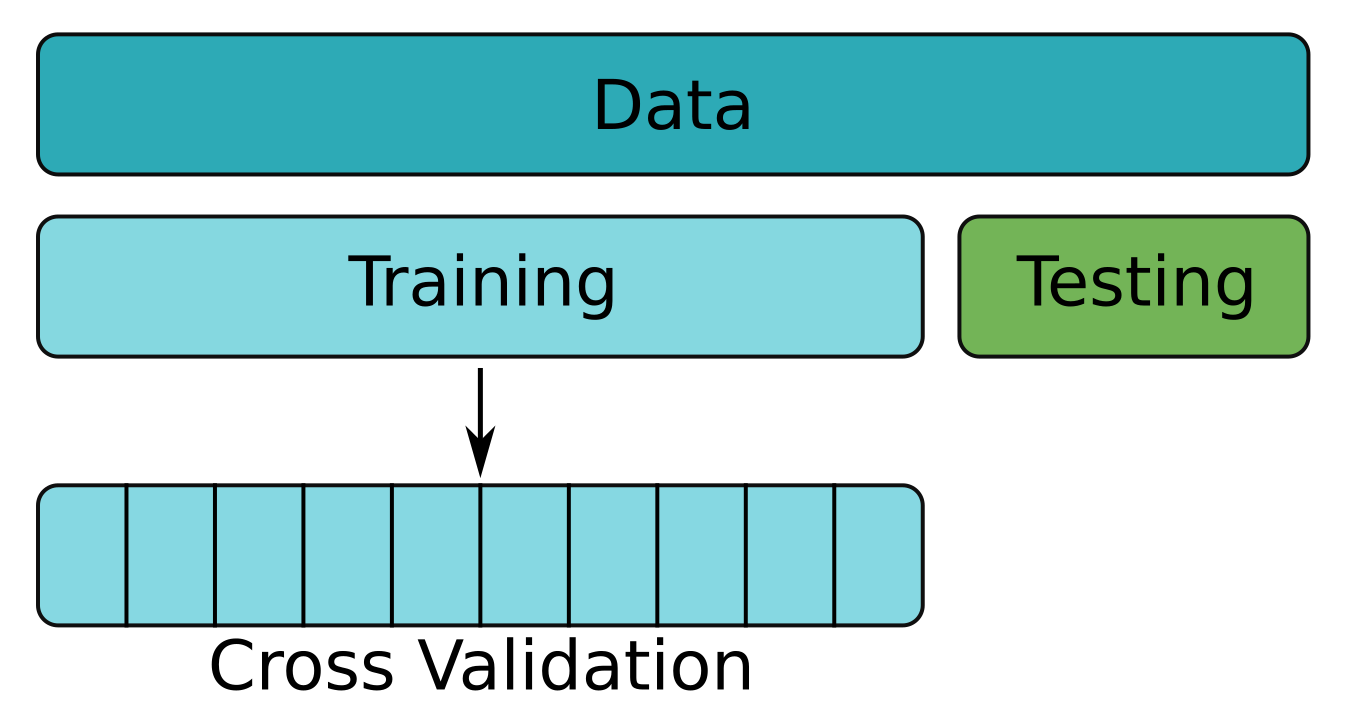
Korsvalideringsobjektet.
cv = CrossValidator(estimator=regression,
estimatorParamMaps=params,
evaluator=evaluator,
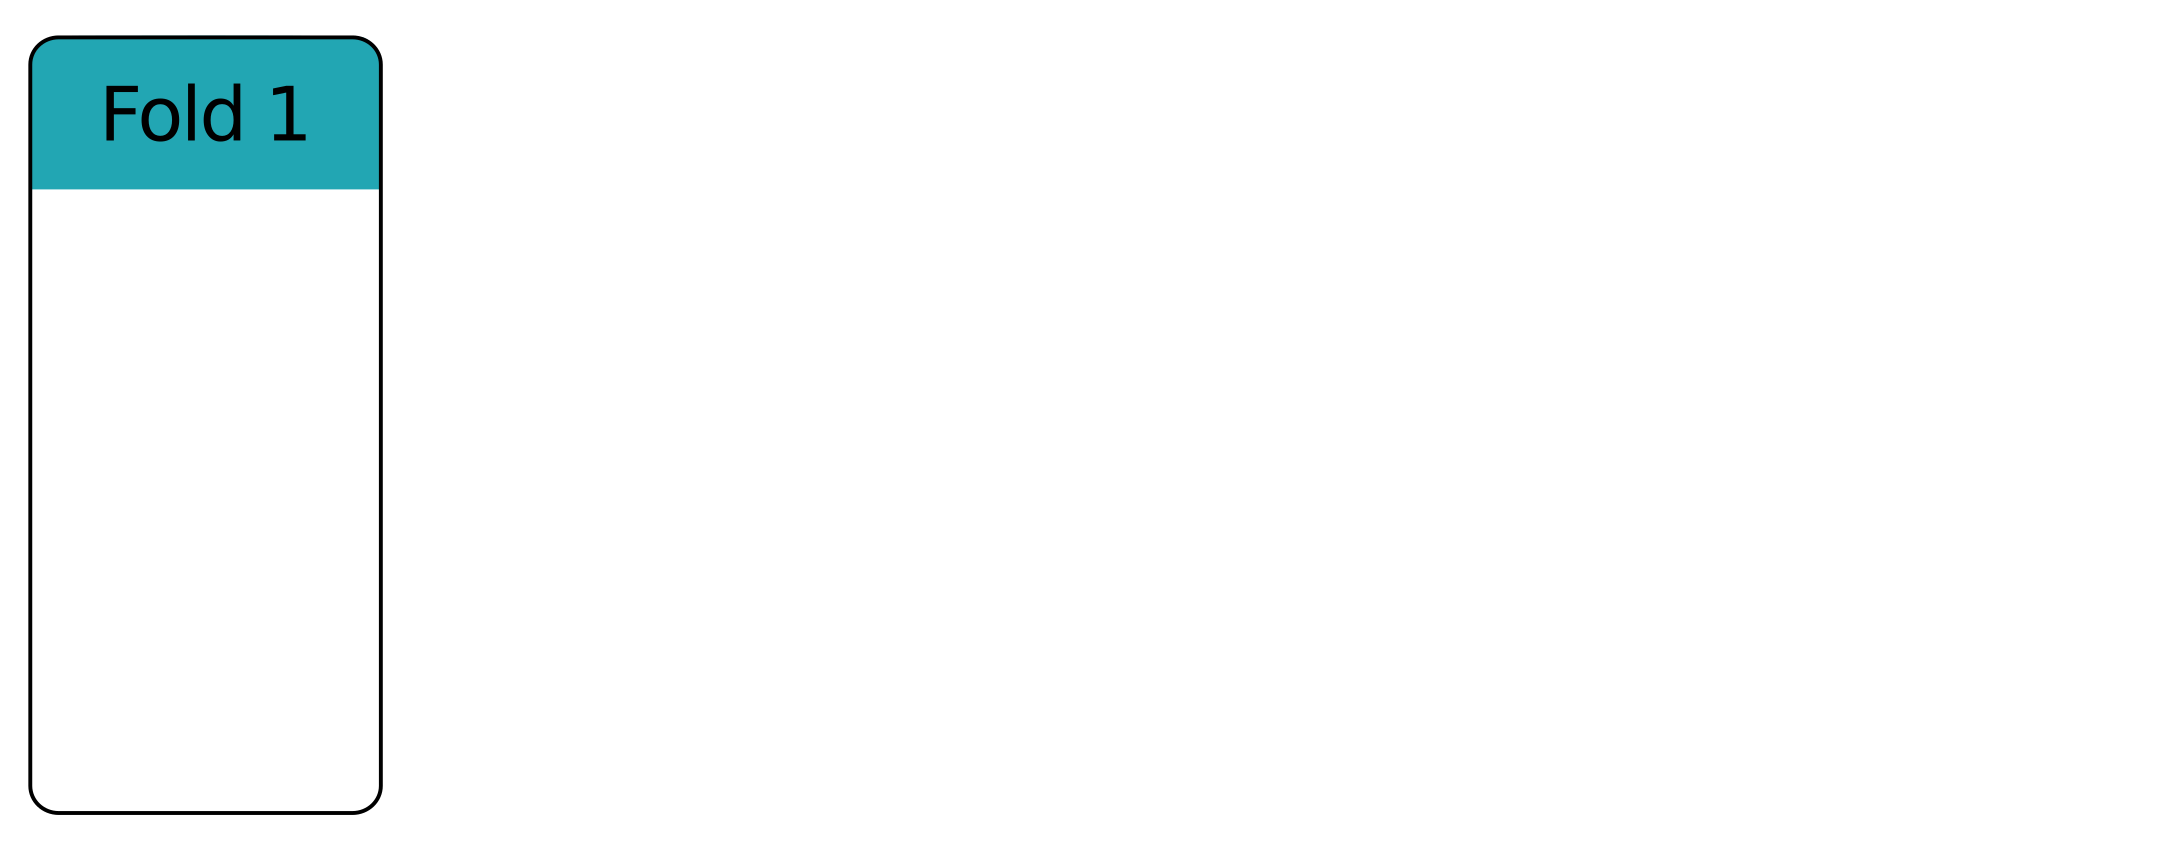
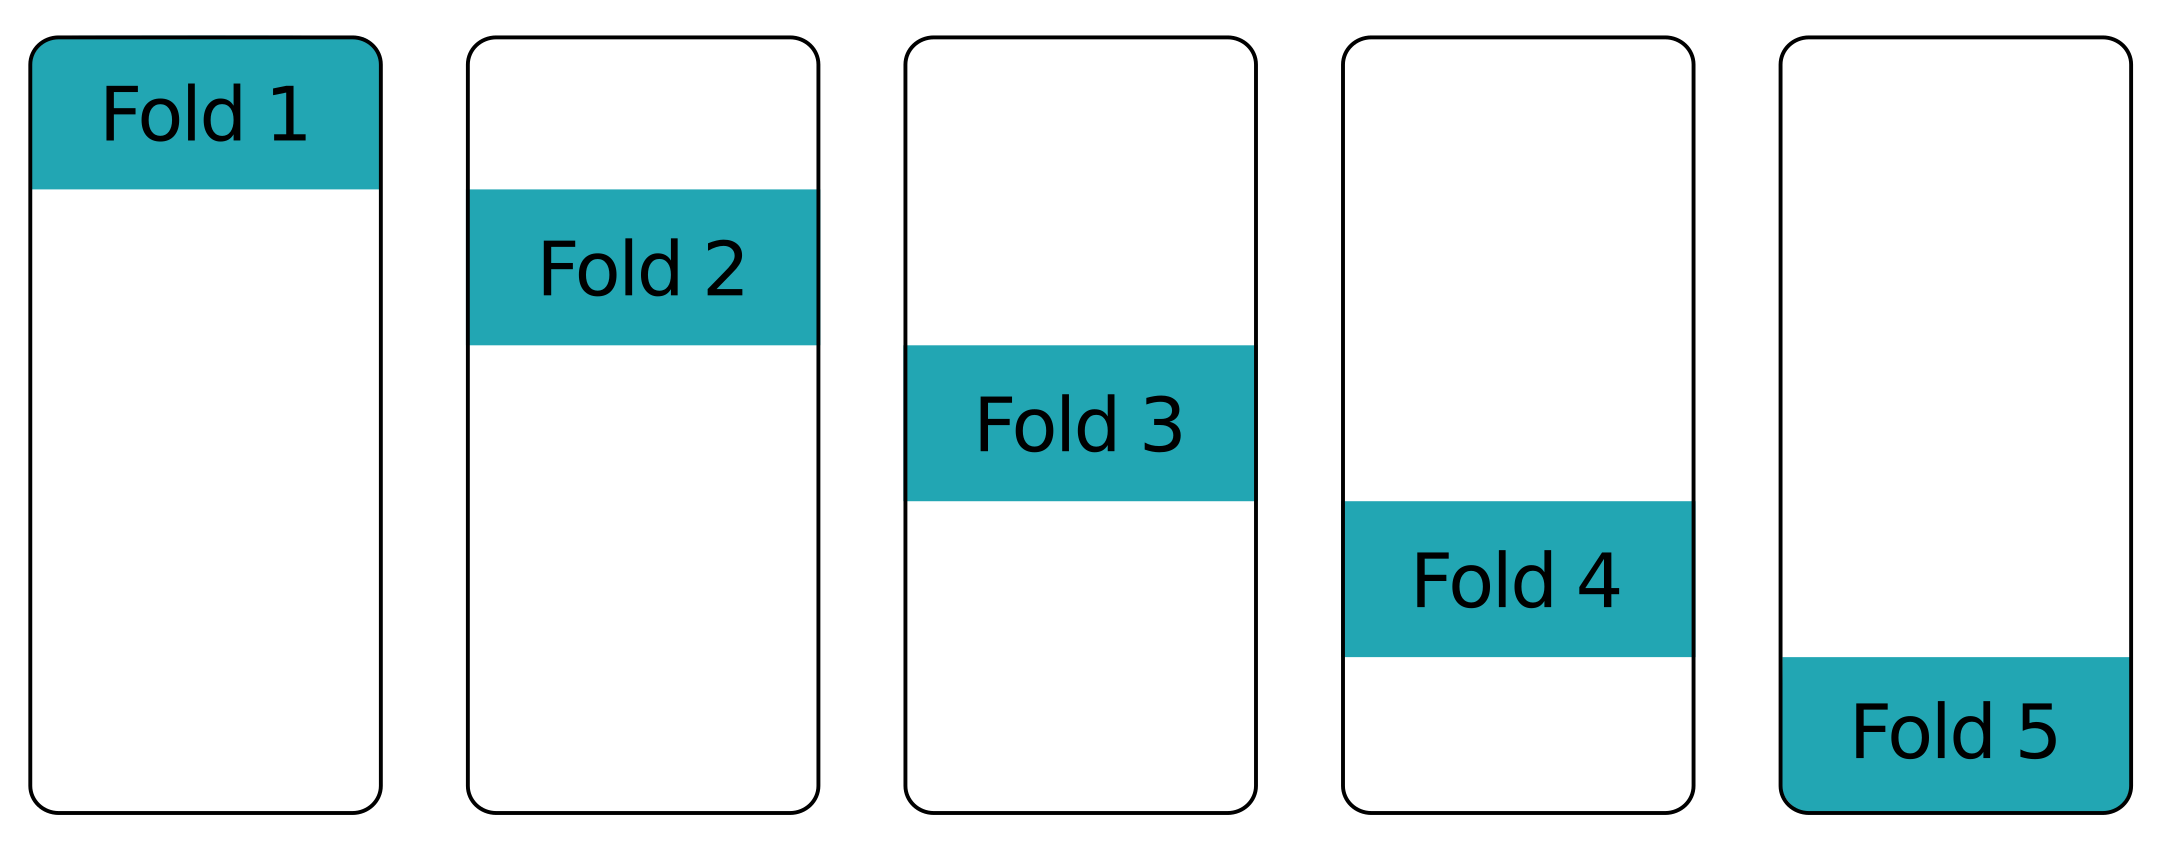
numFolds=10, seed=13)
Tillämpa korsvalidering på träningsdata.
cv = cv.fit(cars_train)
Vad är genomsnittligt RMSE över vecken?
cv.avgMetrics
[0.800663722151572]
Gör förutsägelser på den ursprungliga testdatan.
evaluator.evaluate(cv.transform(cars_test))
# RMSE on testing data
0.745974203928479
Betydligt lägre än det korsvaliderade RMSE.
# RMSE from cross-validation
0.800663722151572
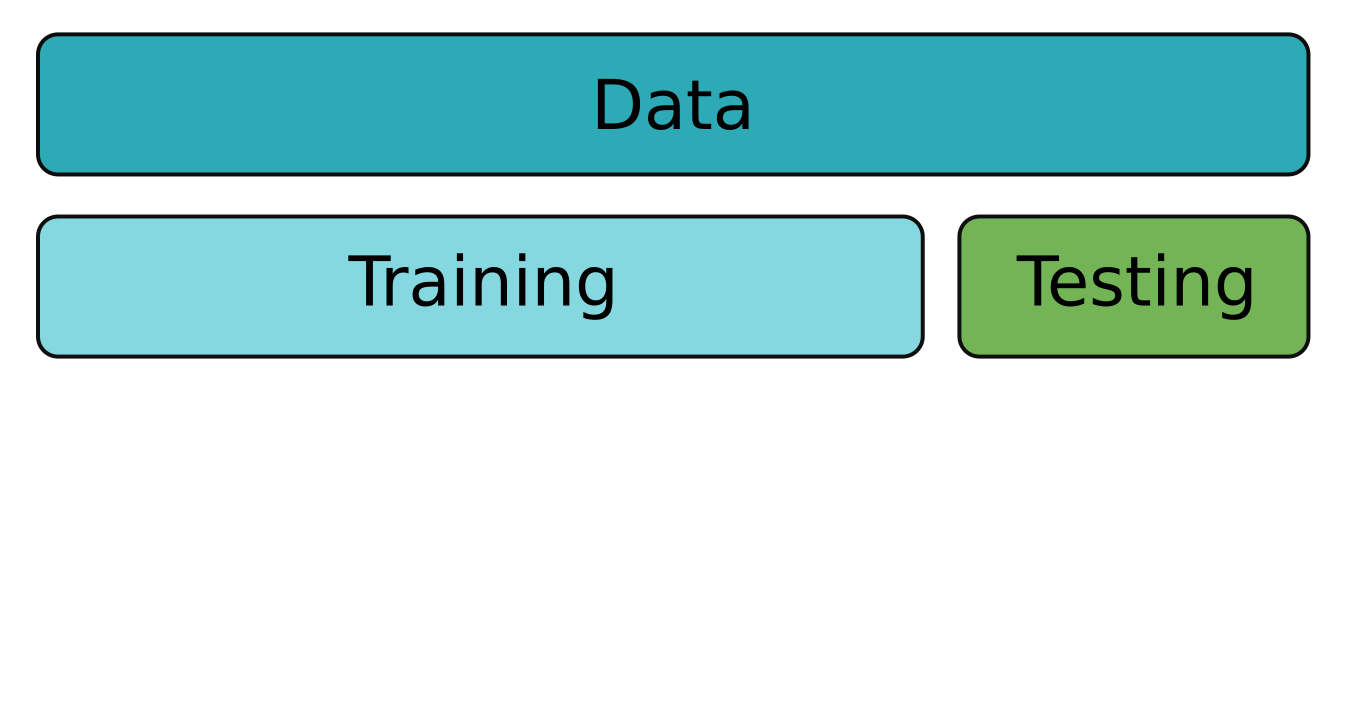
En enkel träning/testuppdelning hade gett en alltför optimistisk bild av modellens prestanda.
Maskininlärning med PySpark