การฝึกโมเดลอย่างถูกต้อง

Supervised Learning ใน R: การถดถอย

Nina Zumel and John Mount

Win-Vector, LLC

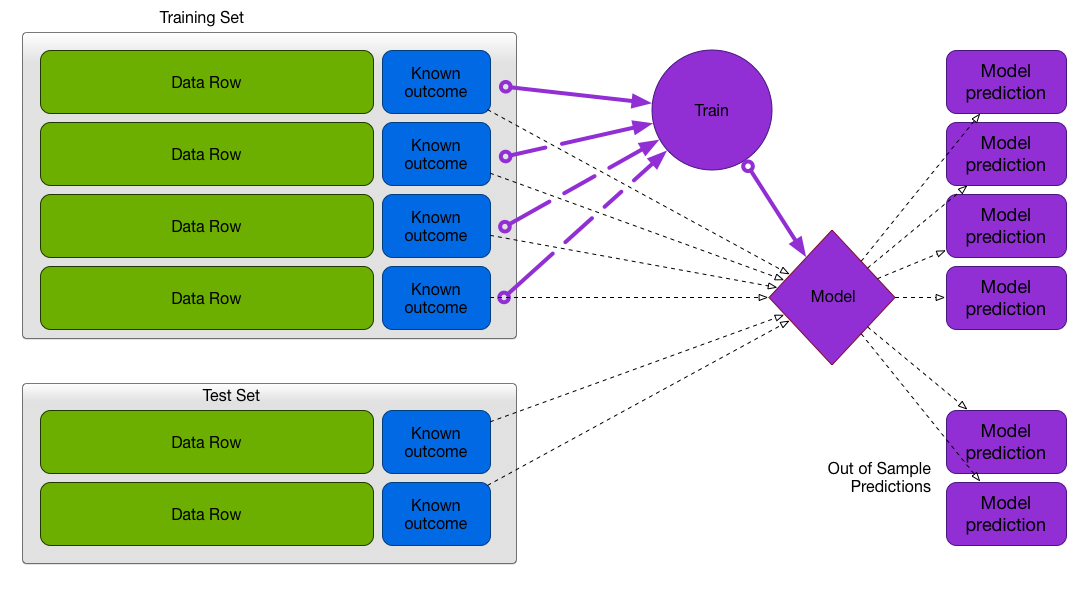
โมเดลอาจทำได้ดีกับข้อมูล training แต่แย่กับข้อมูลใหม่
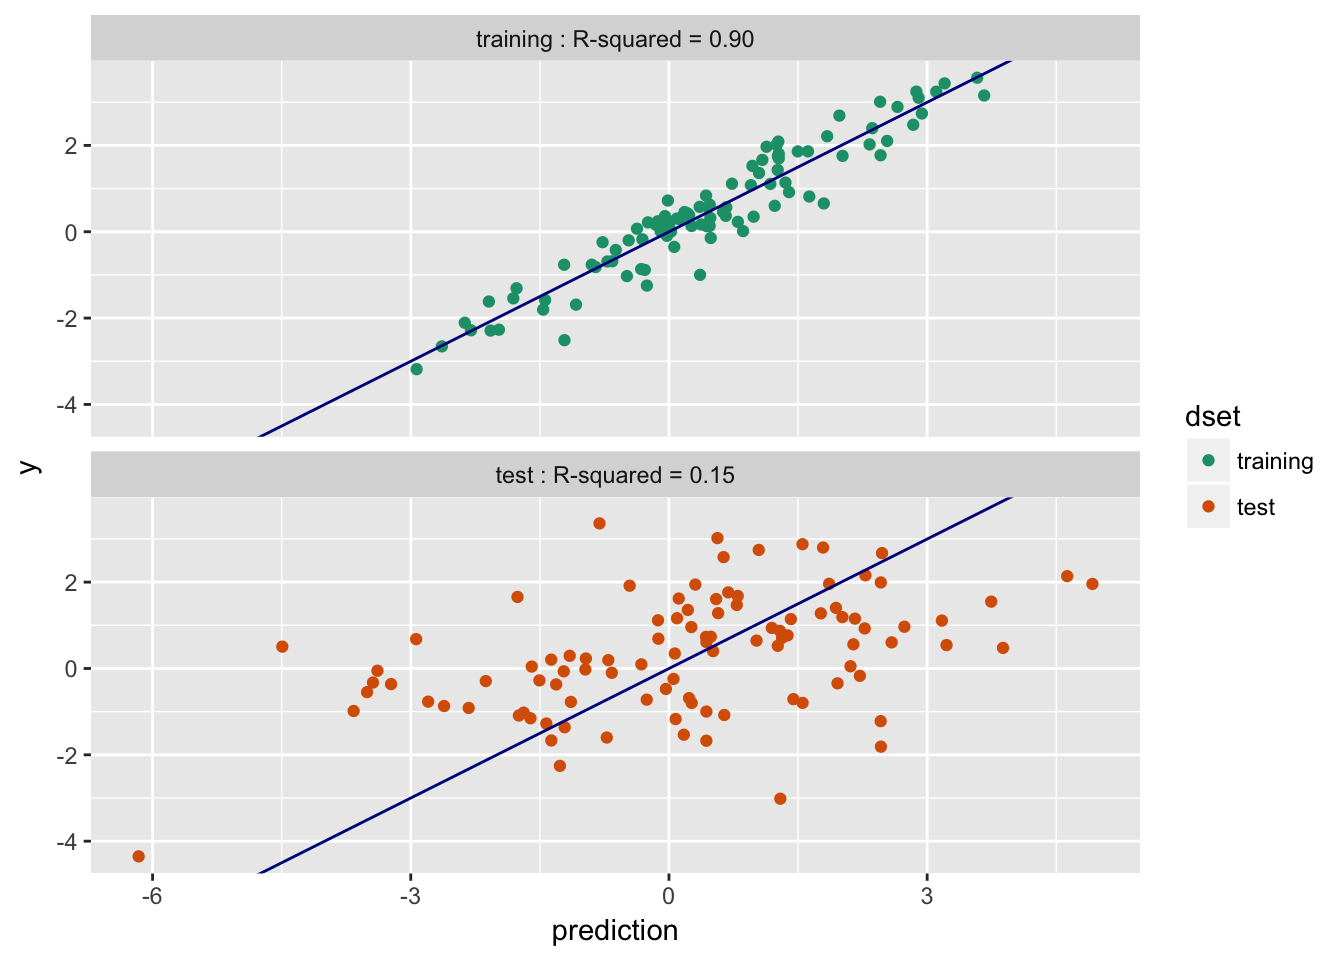
  • Training $R^2$: 0.9; Test $R^2$: 0.15 -- Overfit
Supervised Learning ใน R: การถดถอย

Test/Train Split

วิธีที่แนะนำเมื่อมีข้อมูลเพียงพอ

Supervised Learning ใน R: การถดถอย

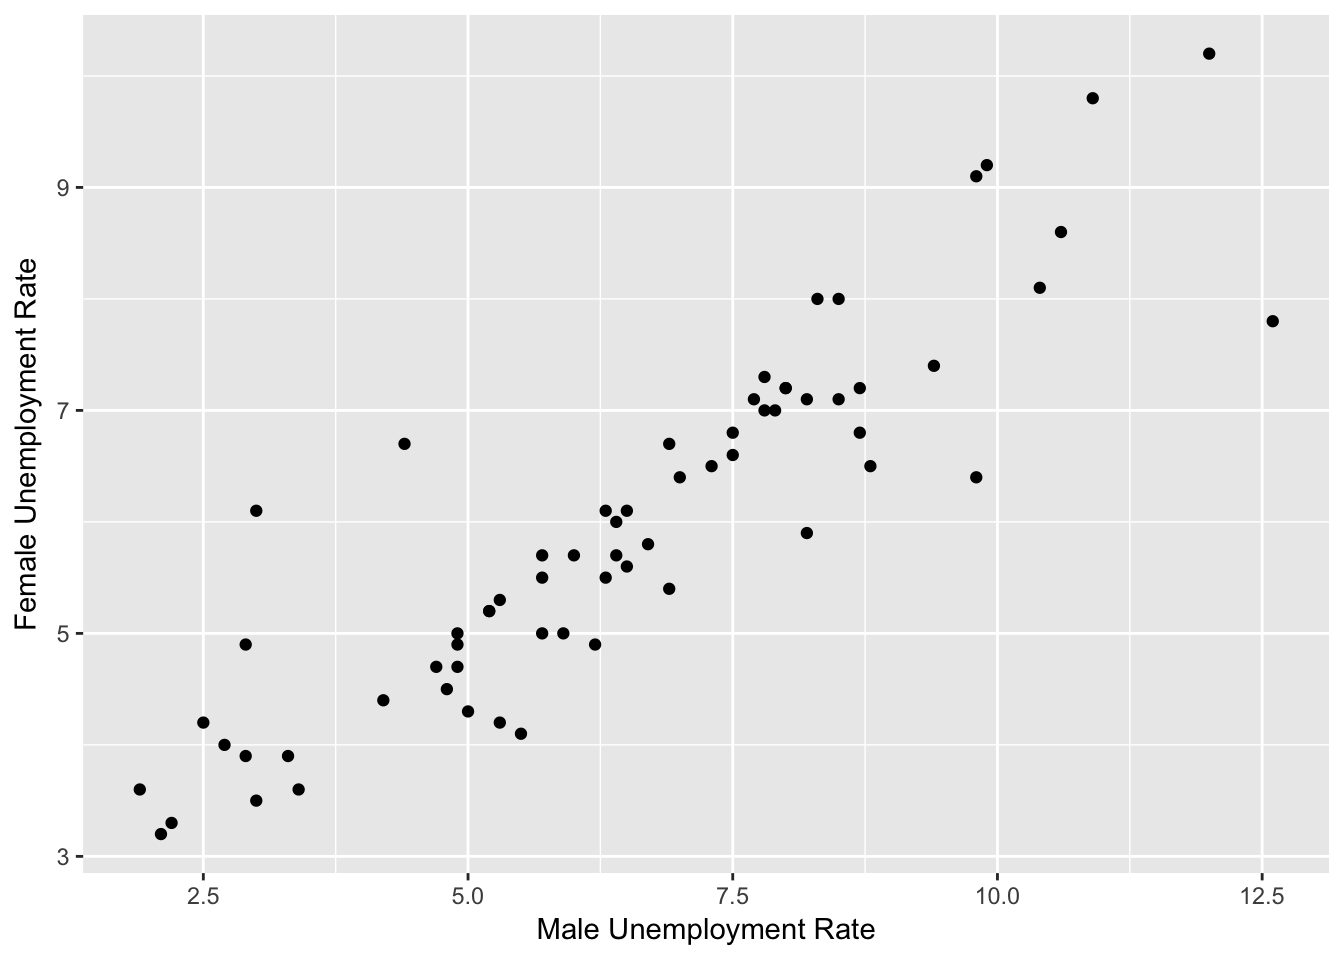
ตัวอย่าง: โมเดลการว่างงานของผู้หญิง

  • ฝึกด้วย 66 แถว ทดสอบด้วย 30 แถว
Supervised Learning ใน R: การถดถอย

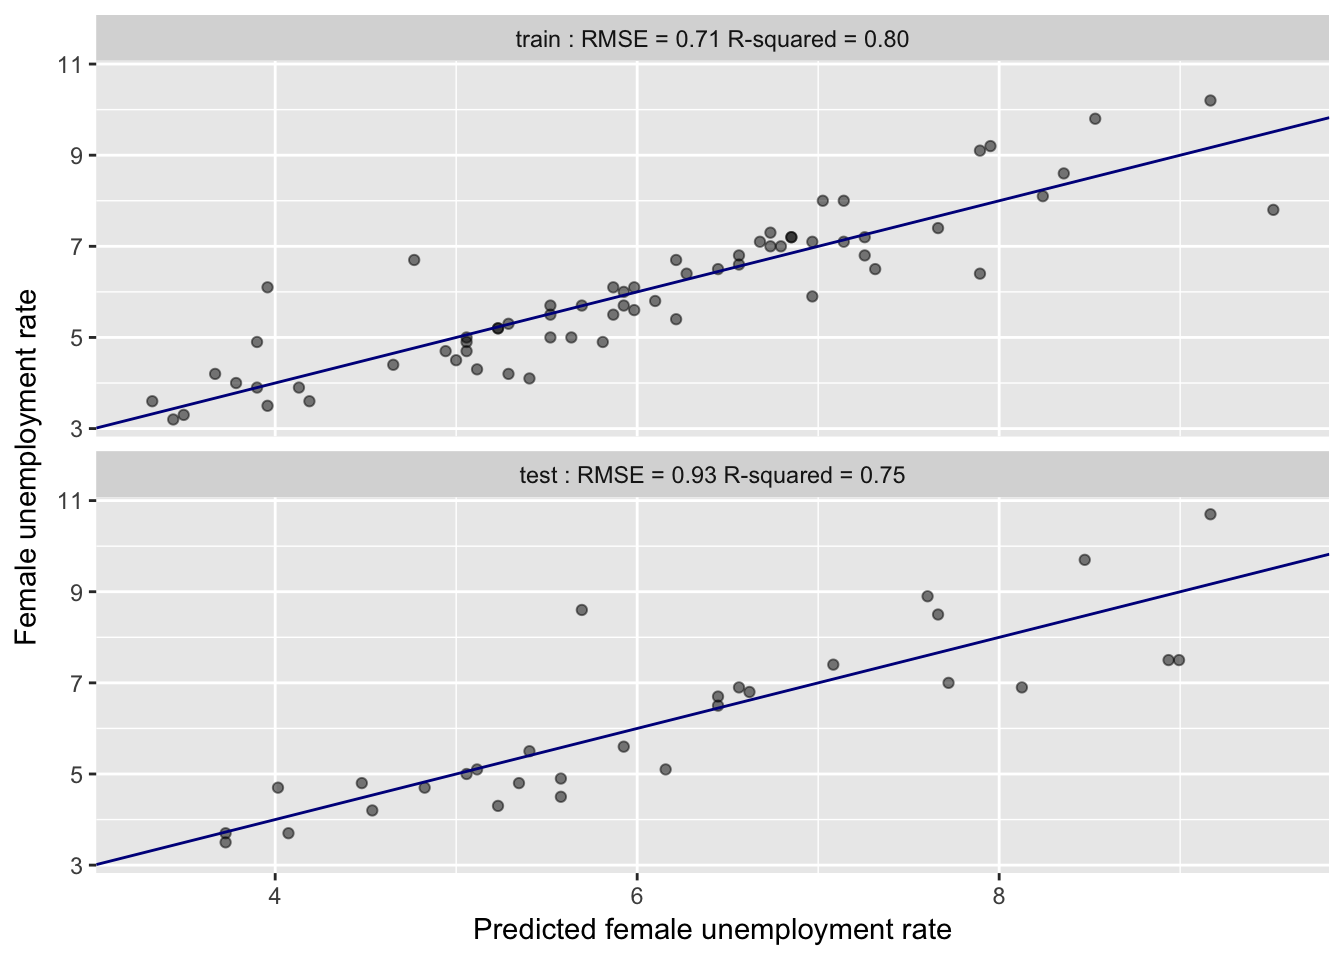
ประสิทธิภาพโมเดล: Train vs. Test

  • Training: RMSE 0.71, $R^2$ 0.8
  • Test: RMSE 0.93, $R^2$ 0.75
Supervised Learning ใน R: การถดถอย

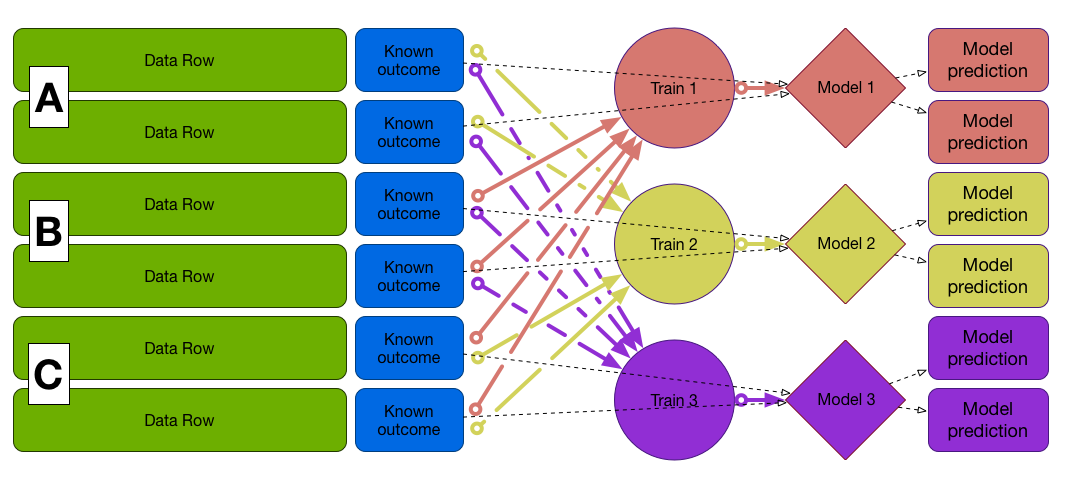
Cross-Validation

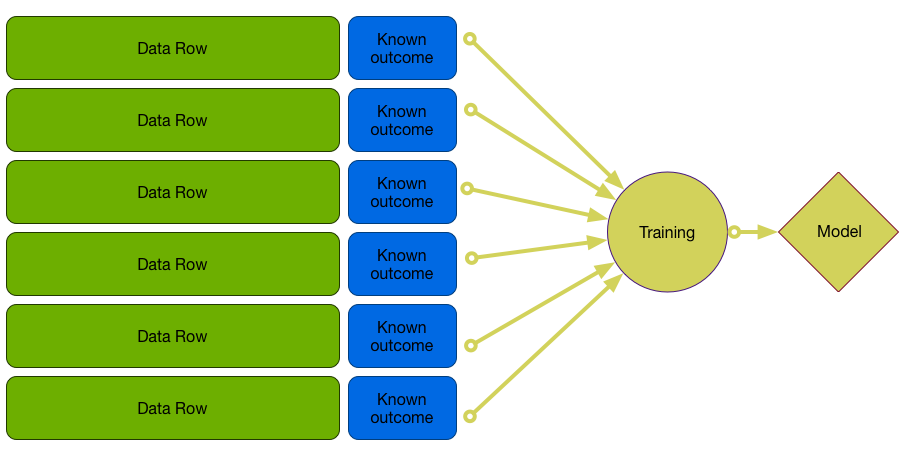
เหมาะเมื่อข้อมูลไม่มากพอสำหรับการแบ่ง test set

Supervised Learning ใน R: การถดถอย

Cross-Validation

Supervised Learning ใน R: การถดถอย

Cross-Validation

Supervised Learning ใน R: การถดถอย

Cross-Validation

Supervised Learning ใน R: การถดถอย

สร้างแผน cross-validation

library(vtreat)
splitPlan <- kWayCrossValidation(nRows, nSplits, NULL, NULL)
  • nRows: จำนวนแถวในข้อมูล training
  • nSplits: จำนวน fold (partition) ใน cross-validation
    • เช่น nfolds = 3 สำหรับ cross-validation แบบ 3 ทาง
  • อีก 2 อาร์กิวเมนต์ที่เหลือไม่จำเป็นในที่นี้
Supervised Learning ใน R: การถดถอย

สร้างแผน cross-validation

library(vtreat)
splitPlan <- kWayCrossValidation(10, 3, NULL, NULL)

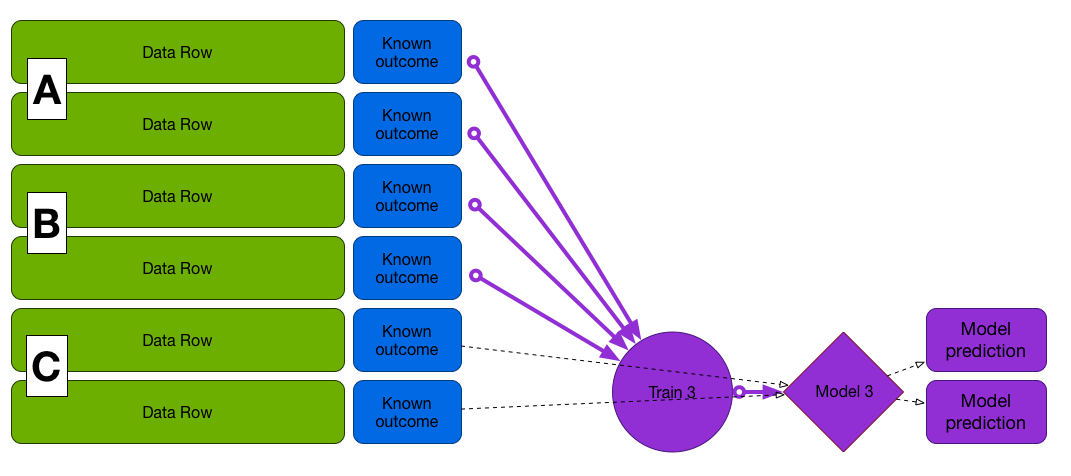
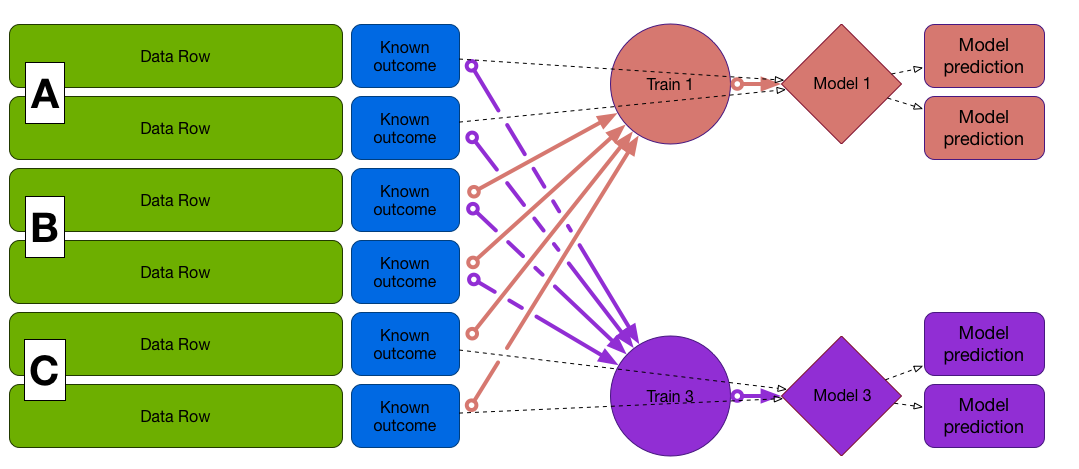
Fold แรก (A และ B สำหรับ train, C สำหรับ test)

splitPlan[[1]]
$train
1  2  4  5  7  9 10
$app
3 6 8

ฝึกด้วย A และ B ทดสอบด้วย C และต่อไปเรื่อย ๆ...

split <- splitPlan[[1]]
model <- lm(fmla, data = df[split$train,])
df$pred.cv[split$app] <- predict(model, newdata = df[split$app,])
Supervised Learning ใน R: การถดถอย

โมเดลสุดท้าย

Supervised Learning ใน R: การถดถอย

ตัวอย่าง: โมเดลการว่างงาน

ประเภทการวัด RMSE $R^2$
train 0.7082675 0.8029275
test 0.9349416 0.7451896
cross-validation 0.8175714 0.7635331
Supervised Learning ใน R: การถดถอย

มาฝึกกันเถอะ!

Supervised Learning ใน R: การถดถอย

Preparing Video For Download...