Gradient boosting machines

Supervised Learning ใน R: การถดถอย

Nina Zumel and John Mount

Win-Vector, LLC

Gradient Boosting ทำงานอย่างไร
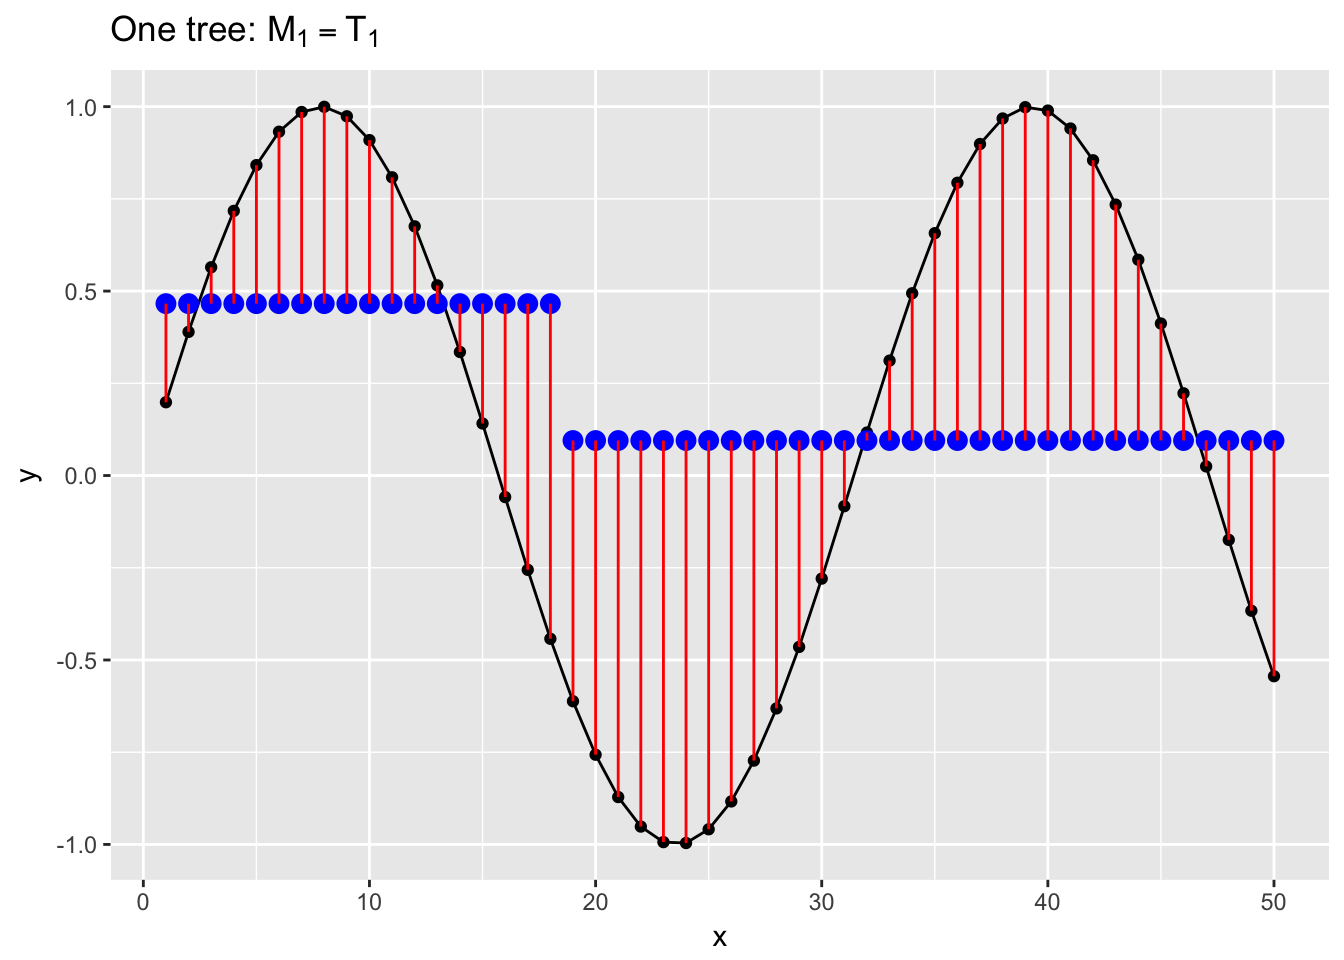
  1. ฟิตต้นไม้ตื้น $T_1$ กับข้อมูล: $M_1 = T_1$
Supervised Learning ใน R: การถดถอย

Gradient Boosting ทำงานอย่างไร

  1. ฟิตต้นไม้ตื้น $T_1$ กับข้อมูล: $M_1 = T_1$
  2. ฟิตต้นไม้ T_2 กับค่าคงเหลือ หา $\gamma$ ที่ทำให้ $M_2 = M_1 + \gamma T_2$ พอดีกับข้อมูลมากที่สุด
Supervised Learning ใน R: การถดถอย

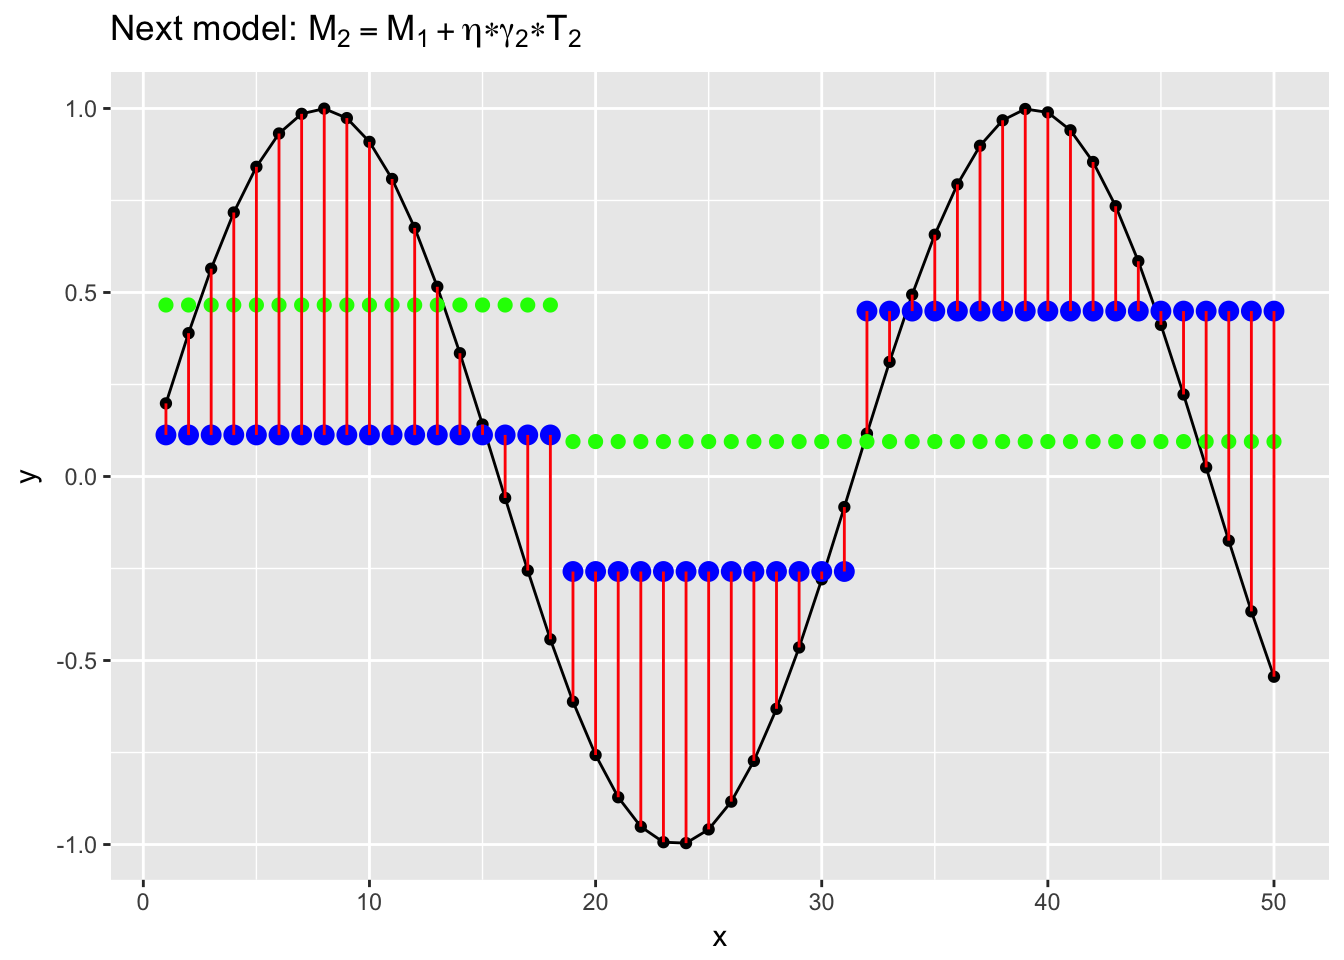
Gradient Boosting ทำงานอย่างไร

Regularization: learning rate $\eta \in(0,1)$

$$ M_2 = M_1 + \eta \gamma T_2 $$

  • $\eta$ มาก: เรียนรู้เร็วขึ้น
  • $\eta$ น้อย: ลดความเสี่ยง overfit
Supervised Learning ใน R: การถดถอย

Gradient Boosting ทำงานอย่างไร

  1. ฟิตต้นไม้ตื้น $T_1$ กับข้อมูล
    • $M_1 = T_1$
  2. ฟิตต้นไม้ T_2 กับค่าคงเหลือ
    • $M_2 = M_1 + \eta \gamma_2 T_2$
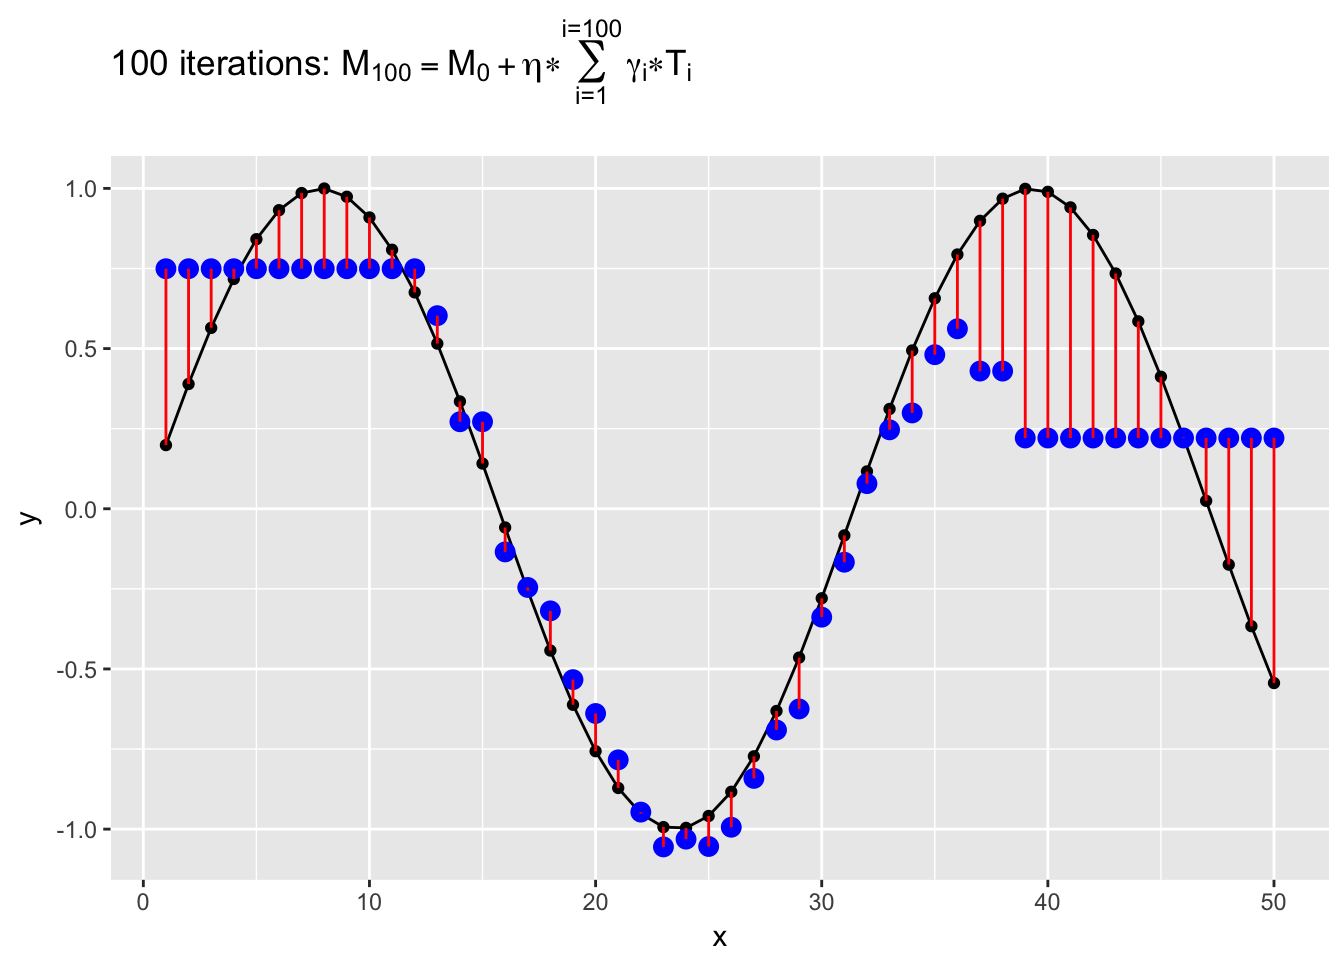
  3. ทำซ้ำขั้นที่ (2) จนกว่าจะถึงเงื่อนไขหยุด

โมเดลสุดท้าย:

$$ M = M_1 + \eta \sum \gamma_i T_i $$

Supervised Learning ใน R: การถดถอย

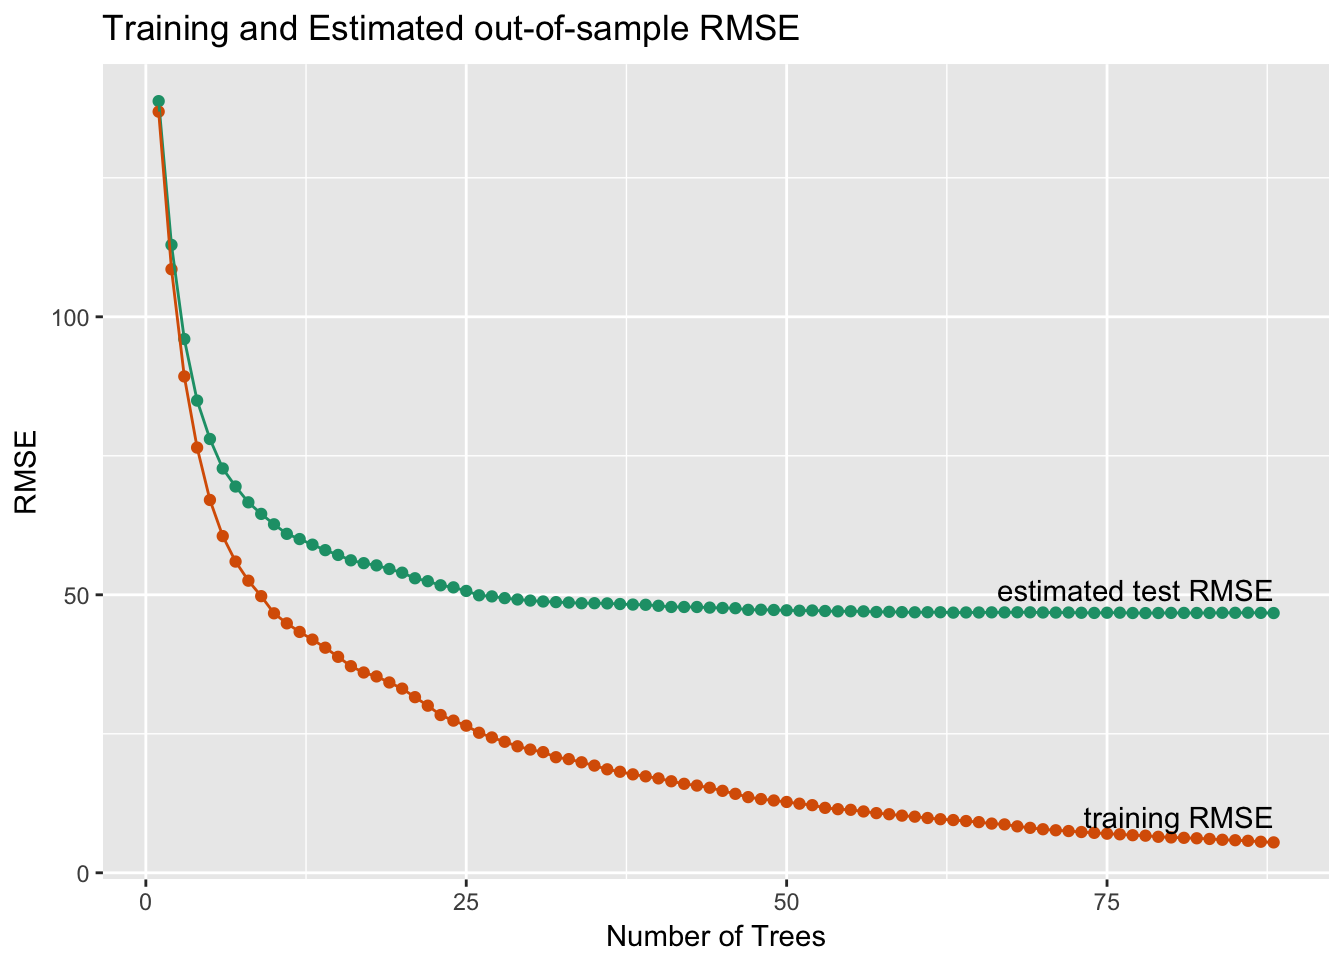
ใช้ Cross-validation ป้องกัน Overfit

ค่าความผิดพลาดของชุด training ลดลงเรื่อย ๆ แต่ชุด test ไม่ลดตาม

Supervised Learning ใน R: การถดถอย

แนวทางที่ดีที่สุด (กับ xgboost())

  1. รัน xgb.cv() ด้วยจำนวนรอบ (ต้นไม้) มาก ๆ
Supervised Learning ใน R: การถดถอย

แนวทางที่ดีที่สุด (กับ xgboost())

  1. รัน xgb.cv() ด้วยจำนวนรอบ (ต้นไม้) มาก ๆ
  2. xgb.cv()$evaluation_log: บันทึก RMSE ที่ประมาณได้ในแต่ละรอบ
    • หาจำนวนต้นไม้ที่ทำให้ RMSE ต่ำที่สุด: $n_{best}$
Supervised Learning ใน R: การถดถอย

แนวทางที่ดีที่สุด (กับ xgboost())

  1. รัน xgb.cv() ด้วยจำนวนรอบ (ต้นไม้) มาก ๆ
  2. xgb.cv()$evaluation_log: บันทึก RMSE ที่ประมาณได้ในแต่ละรอบ
    • หาจำนวนต้นไม้ที่ทำให้ RMSE ต่ำที่สุด: $n_{best}$
  3. รัน xgboost() โดยตั้งค่า nrounds = $n_{best}$
Supervised Learning ใน R: การถดถอย

ตัวอย่าง: โมเดลการเช่าจักรยาน

เตรียมข้อมูลก่อน

treatplan <- designTreatmentsZ(bikesJan, vars)
newvars <- treatplan$scoreFrame %>%
     filter(code %in% c("clean", "lev")) %>%
     use_series(varName)

bikesJan.treat <- prepare(treatplan, bikesJan, varRestriction = newvars)

สำหรับ xgboost():

  • ข้อมูล input: as.matrix(bikesJan.treat)
  • ผลลัพธ์: bikesJan$cnt
Supervised Learning ใน R: การถดถอย

ฝึกโมเดลด้วย xgboost() / xgb.cv()

cv <- xgb.cv(data = as.matrix(bikesJan.treat), label = bikesJan$cnt,
              objective = "reg:squarederror",
              nrounds = 100, nfold = 5, eta = 0.3, max_depth = 6)

พารามิเตอร์หลักของ xgb.cv() และ xgboost()

  • data: ข้อมูล input เป็น matrix ; label: ผลลัพธ์
  • objective: สำหรับ regression - "reg:squarederror"
  • nrounds: จำนวนต้นไม้สูงสุดที่จะฟิต
  • eta: learning rate
  • max_depth: ความลึกสูงสุดของแต่ละต้นไม้
  • nfold (เฉพาะ xgb.cv()): จำนวน fold สำหรับ cross-validation
Supervised Learning ใน R: การถดถอย

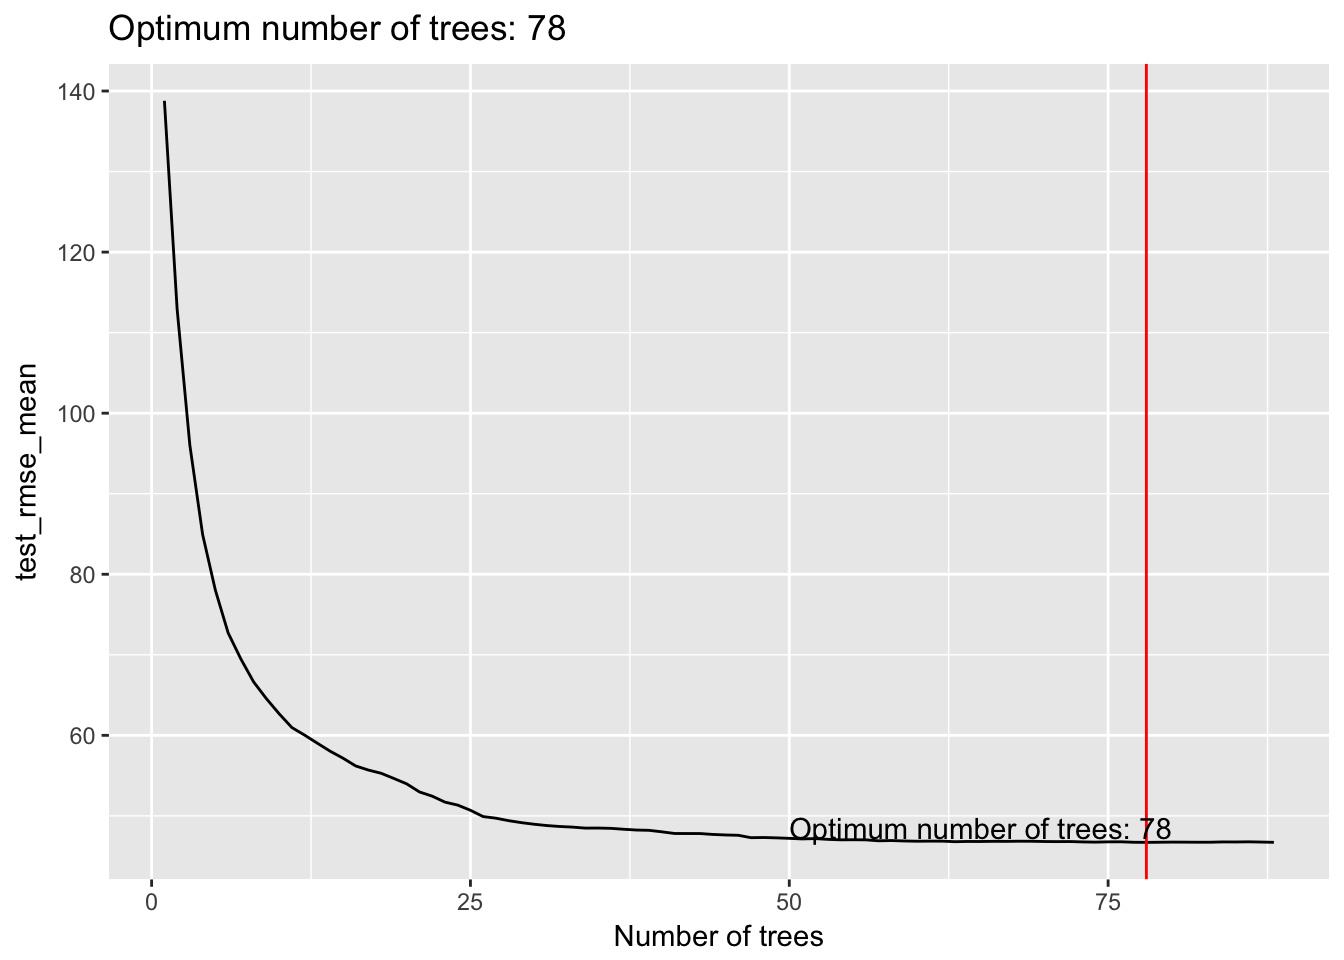
หาจำนวนต้นไม้ที่เหมาะสม

elog <- as.data.frame(cv$evaluation_log)
(nrounds <- which.min(elog$test_rmse_mean))
78
Supervised Learning ใน R: การถดถอย

รัน xgboost() เพื่อสร้างโมเดลสุดท้าย

nrounds <- 78

model <- xgboost(data = as.matrix(bikesJan.treat), 
                 label = bikesJan$cnt,
                 nrounds = nrounds,
                 objective = "reg:squarederror",
                 eta = 0.3,
                 max_depth = 6)
Supervised Learning ใน R: การถดถอย

ทำนายด้วยโมเดล xgboost()

เตรียมข้อมูลเดือนกุมภาพันธ์และทำนายผล

bikesFeb.treat <- prepare(treatplan, bikesFeb, varRestriction = newvars)

bikesFeb$pred <- predict(model, as.matrix(bikesFeb.treat))

ประสิทธิภาพโมเดลบนข้อมูลเดือนกุมภาพันธ์

โมเดล RMSE
Quasipoisson 69.3
Random forests 67.15
Gradient Boosting 54.0
Supervised Learning ใน R: การถดถอย

แสดงผลลัพธ์

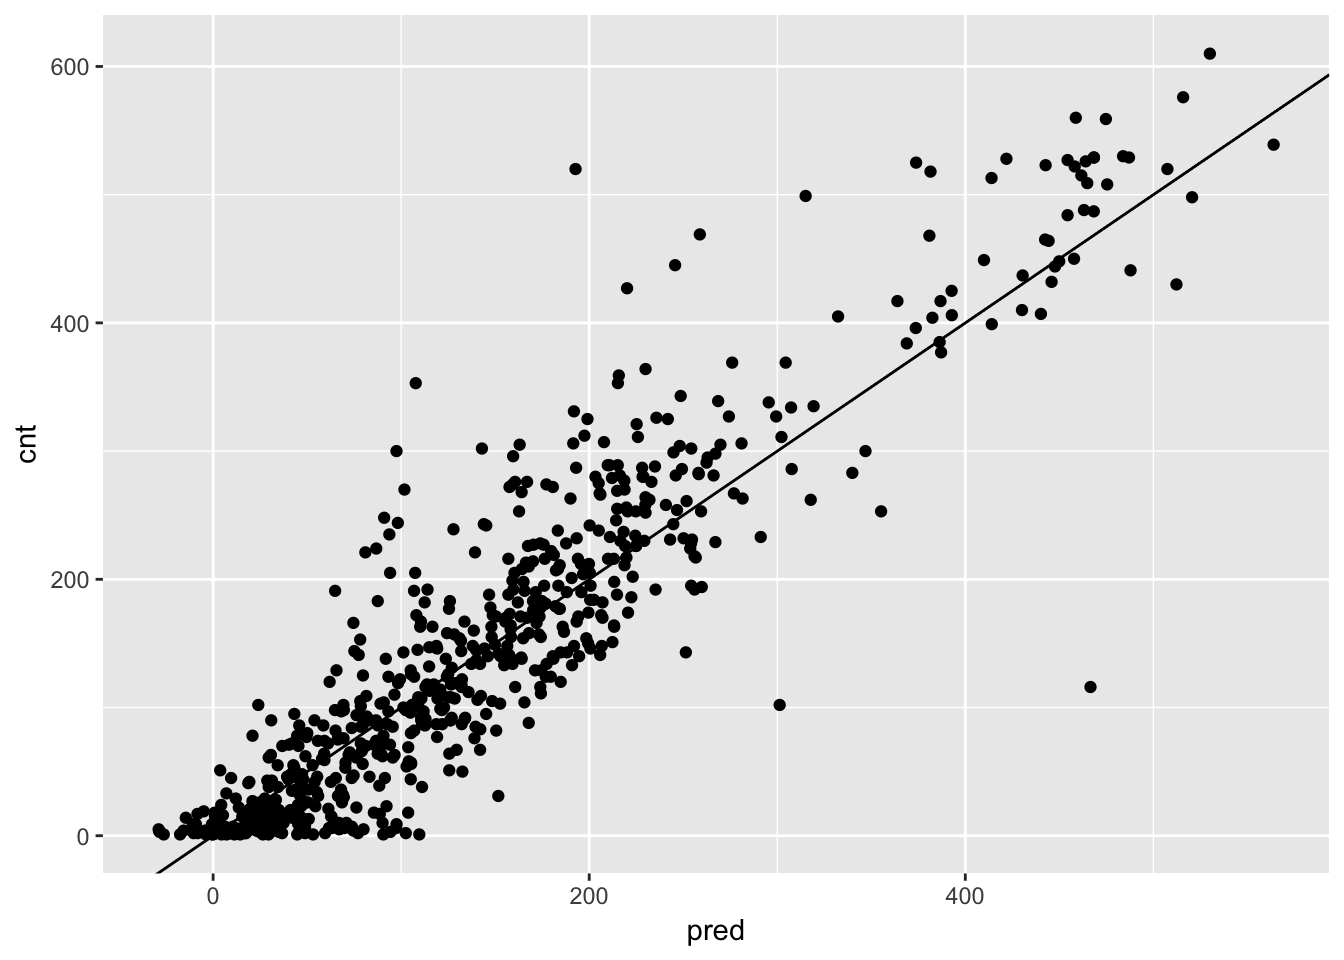
ค่าทำนายเทียบกับยอดเช่าจักรยานจริง เดือนกุมภาพันธ์
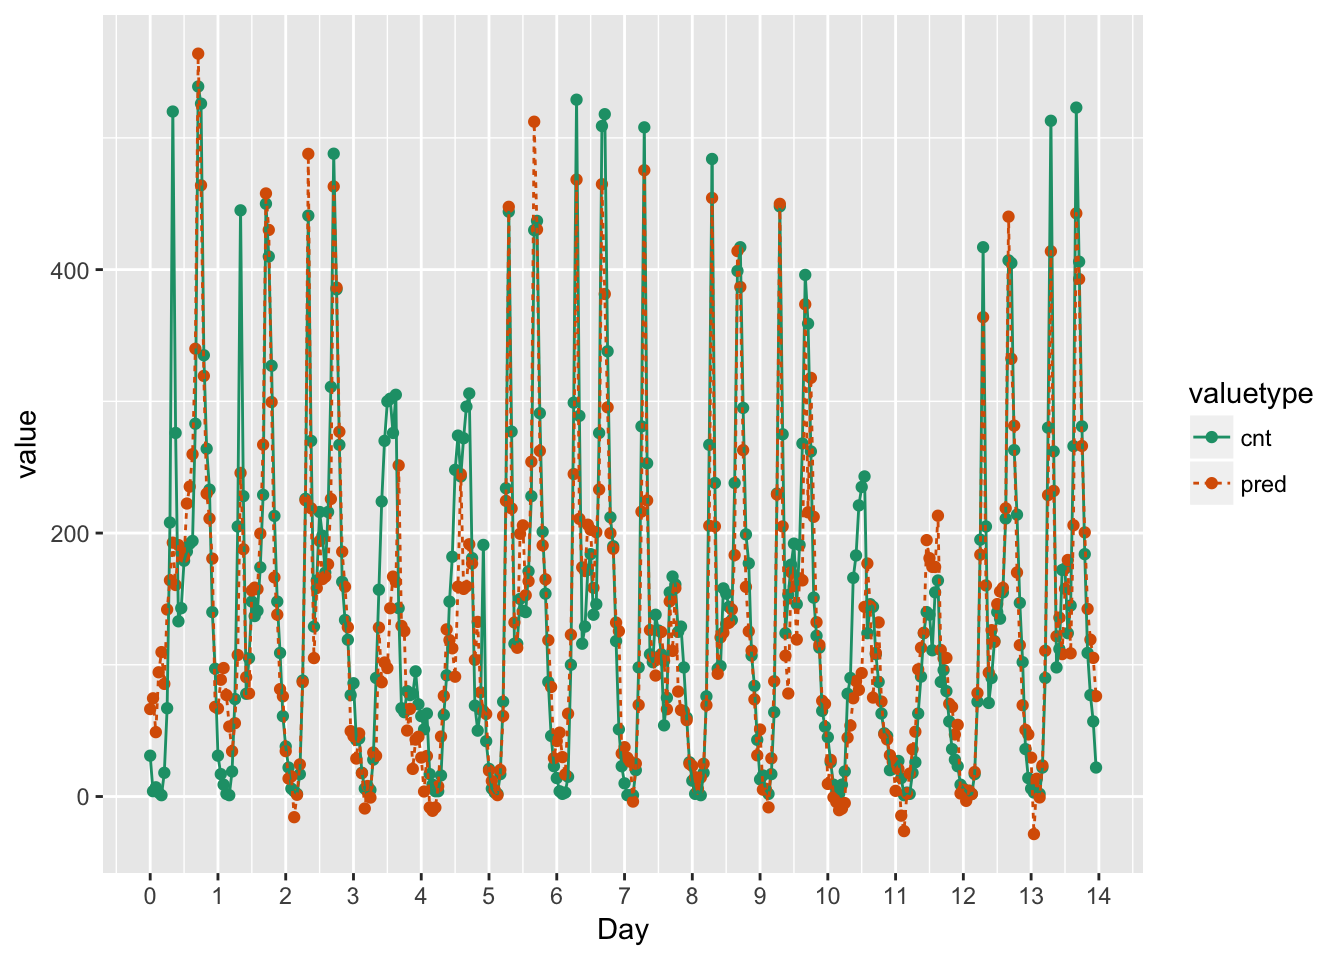
ค่าทำนายและยอดเช่าจักรยานรายชั่วโมง เดือนกุมภาพันธ์
Supervised Learning ใน R: การถดถอย

มาฝึกกันเถอะ!

Supervised Learning ใน R: การถดถอย

Preparing Video For Download...