Vyhodnocení modelů pomocí Acceleratoru

Efficient AI Model Training with PyTorch

Dennis Lee

Data Engineer, Amazon

Proč přepínat model do evaluačního režimu?

  • Trénovací režim
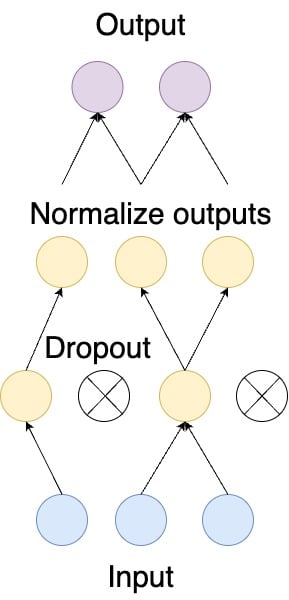
    • Dropout: nastavení neuronů na nulu
    • Dávková normalizace

Dropout a dávková normalizace Diagram neuronové sítě s více vrstvami, včetně vstupní, skrytých a výstupní vrstvy. Dropout je aplikován na skryté vrstvy jako ochrana před přetrénováním a dávková normalizace slouží k normalizaci výstupu každé vrstvy před aktivací.

Efficient AI Model Training with PyTorch

Proč přepínat model do evaluačního režimu?

  • Trénovací režim
    • Dropout: nastavení neuronů na nulu
    • Dávková normalizace
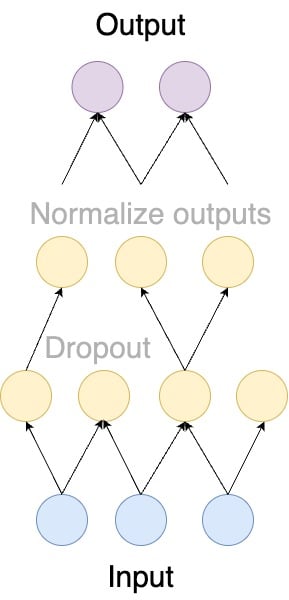
  • Evaluační režim tyto vrstvy deaktivuje
  • model.eval() aktivuje evaluační režim

Dropout a dávková normalizace Diagram neuronové sítě s více vrstvami, včetně vstupní, skrytých a výstupní vrstvy. Dropout je aplikován na skryté vrstvy jako ochrana před přetrénováním a dávková normalizace slouží k normalizaci výstupu každé vrstvy před aktivací.

Efficient AI Model Training with PyTorch

Deaktivace gradientů pomocí torch.no_grad()

  • Trénování vyžaduje výpočet gradientů
  • torch.no_grad() deaktivuje gradienty
  • Použijte model.eval i torch.no_grad:
model.eval()
with torch.no_grad():
    outputs = model(**inputs)

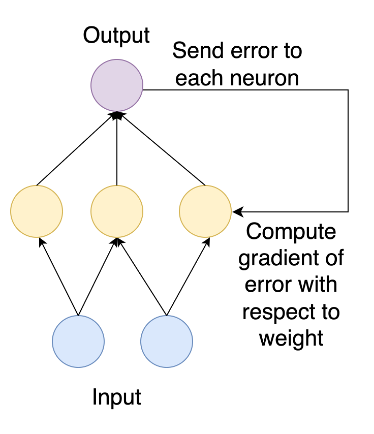
Výpočet gradientů při zpětném šíření Diagram neuronové sítě znázorňující proces zpětného šíření, při němž jsou v každé vrstvě vypočítány gradienty pro úpravu vah. Diagram ukazuje, jak jsou chyby šířeny zpět z výstupní vrstvy přes skryté vrstvy za účelem aktualizace vah pomocí gradientního sestupu.

Efficient AI Model Training with PyTorch

Příprava validační datové sady

  • Načtení validační části datové sady MRPC
validation_dataset = load_dataset("glue", "mrpc", split="validation")
  • Tokenizace validační datové sady
def encode(examples):
    return tokenizer(examples["sentence1"], 
                      examples["sentence2"],
                      truncation=True,
                      padding="max_length")

validation_dataset = validation_dataset.map(encode, batched=True)
Efficient AI Model Training with PyTorch

Průběh epochy: trénovací a evaluační smyčky

  • V každé epoše iterujte přes trénovací a validační datové sady
  • Nejprve spusťte model v trénovacím režimu
  • Poté spusťte model v evaluačním režimu a zaznamenejte metriky
for epoch in range(num_epochs):

model.train() for step, batch in enumerate(train_dataloader): # Perform training step
model.eval() for step, batch in enumerate(eval_dataloader): # Perform evaluation step
# Log evaluation metrics
Efficient AI Model Training with PyTorch

Uvnitř evaluační smyčky

metric = evaluate.load("glue", "mrpc")
model.eval()
for step, batch in enumerate(eval_dataloader):

with torch.no_grad(): outputs = model(**batch) predictions = outputs.logits.argmax(dim=-1)
predictions, references = accelerator.gather_for_metrics((predictions, batch["labels"]))
metric.add_batch(predictions=predictions, references=references)
eval_metric = metric.compute() print(f"Eval metrics: \n{eval_metric}")
Eval metrics: 
{'accuracy': 0.81, 'f1': 0.77}
Efficient AI Model Training with PyTorch

Zaznamenávání metrik po evaluaci

  • Nástroje pro sledování: záznamy metrik; příklady jsou TensorBoard a MLflow
  • log_with: použití všech nástrojů pro sledování experimentů
  • .init_trackers(): inicializace nástrojů pro sledování
  • .log(): sledování accuracy, f1, epoch
  • .end_training(): ukončení sledování
accelerator = Accelerator(project_dir=".",
                          log_with="all")

accelerator.init_trackers("my_project")
for epoch in range(num_epochs): # Training loop is here # Evaluation loop is here accelerator.log({
"accuracy": eval_metric["accuracy"], "f1": eval_metric["f1"],
}, step=epoch)
accelerator.end_training()
Efficient AI Model Training with PyTorch

Pojďme cvičit!

Efficient AI Model Training with PyTorch

Preparing Video For Download...