Předzpracování obrázků a zvuku pro trénování

Efficient AI Model Training with PyTorch

Dennis Lee

Data Engineer, Amazon

Příprava obrázků a zvuku

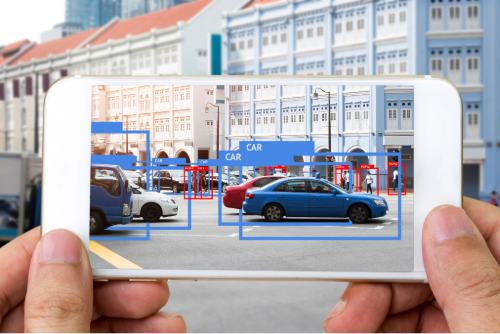
Aplikace pro obrázky

  • Klasifikace obrázků pro rozpoznávání objektů
  • Sharding dat


Ukázka aplikace pro detekci objektů zobrazující auta na ulici. Aplikace běží na telefonu držen v rukou před pouliční scénou.

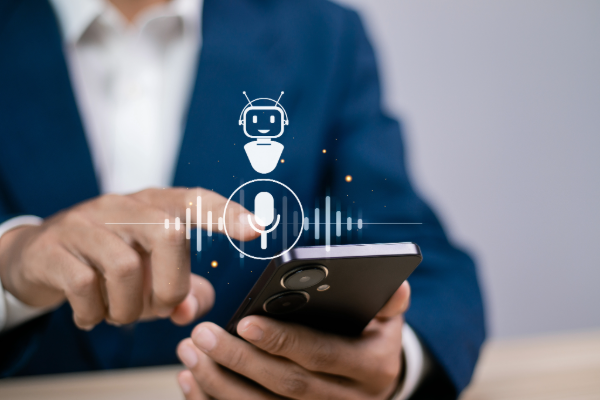
Aplikace pro zvuk

  • Ovládání hlasem
  • Příklad: „Ztlum hlasitost"


Ukázka hlasové asistenční technologie pro zrakově postižené umožňující hlasové ovládání telefonu.

Efficient AI Model Training with PyTorch

Práce s ukázkovým obrazovým datasetem

print(dataset)
Dataset({
    features: ['img', 'label'],
    num_rows: 1000
})
print(dataset[0]["img"])
<PIL.JpegImagePlugin.JpegImageFile image mode=RGB size=720x480>
Efficient AI Model Training with PyTorch

Standardizace formátu obrázků

  • Formát obrázků: šířka, výška
  • Standardizace hodnot pixelů: průměr, směrodatná odchylka
  • AutoImageProcessor načte všechny kroky předzpracování
from transformers import AutoImageProcessor
model = "microsoft/swin-tiny-patch4-window7-224"

image_processor = AutoImageProcessor.from_pretrained(model)
Efficient AI Model Training with PyTorch

Standardizace formátu obrázků

dataset = dataset.map(
    lambda examples: {

"pixel_values": [
image_processor(image, return_tensors="pt").pixel_values for image in examples["img"] ]}, batched=True)
print(dataset)
Dataset({
    features: ['img', 'label', 'pixel_values'],
    num_rows: 1000
})
Efficient AI Model Training with PyTorch

Práce s ukázkovým zvukovým datasetem

print(dataset)
DatasetDict({
    train: Dataset({

features: ['file', 'audio',
'label'], num_rows: 1000 }), ... })
Efficient AI Model Training with PyTorch

Standardizace formátu zvuku

  • Standardizace počtu vzorků
  • Vzorkovací frekvence: počet vzorků za sekundu
  • Maximální délka: počet sekund zvuku
sampling_rate = 16000  # 16 kHz

max_duration = 1 # 1 second
max_length = sampling_rate * max_duration
print(f"max_length = {max_length:,} samples")
max_length = 16,000 samples
Efficient AI Model Training with PyTorch

Standardizace formátu zvuku

from transformers import AutoFeatureExtractor

model = "facebook/wav2vec2-base"
feature_extractor = AutoFeatureExtractor.from_pretrained(model)


def preprocess_function(split_data):
audio_arrays = [x["array"] for x in split_data["audio"]]
inputs = feature_extractor(audio_arrays,
sampling_rate=feature_extractor.sampling_rate, max_length=int(feature_extractor.sampling_rate * max_duration),
truncation=True) return inputs
Efficient AI Model Training with PyTorch

Použití funkce předzpracování

  • Mapování preprocess_function na dataset
  • remove_columns: odebrání sloupců audio a file
  • batched: zpracování příkladů v dávkách
dataset = dataset["train"].map(preprocess_function,

remove_columns=["audio", "file"],
batched=True)
Efficient AI Model Training with PyTorch

Použití funkce předzpracování

print(dataset)
DatasetDict({
    train: Dataset({
        features: ['label', 'input_values'],
        num_rows: 1000
    })
Efficient AI Model Training with PyTorch

Příprava dat pro distribuované trénování

  • DataLoader: připraví data pro načítání a iteraci během trénování
  • accelerator.prepare(): umístí data na CPU nebo GPU podle dostupnosti
  • Sharding dat: každé GPU zpracovává část trénovacích dat, jako by si dělilo pizzu po kouscích
  • accelerator.prepare() funguje s PyTorch DataLoadery (torch.utils.data.DataLoader)
from accelerate import Accelerator
from torch.utils.data import DataLoader

dataloader = DataLoader(dataset, batch_size=32, shuffle=True)


accelerator = Accelerator() dataloader = accelerator.prepare(dataloader)
Efficient AI Model Training with PyTorch

Pojďme si to procvičit!

Efficient AI Model Training with PyTorch

Preparing Video For Download...