Trénink se smíšenou přesností pomocí 8-bit Adam

Efficient AI Model Training with PyTorch

Dennis Lee

Data Engineer, Amazon

Optimalizátory pro efektivní trénink
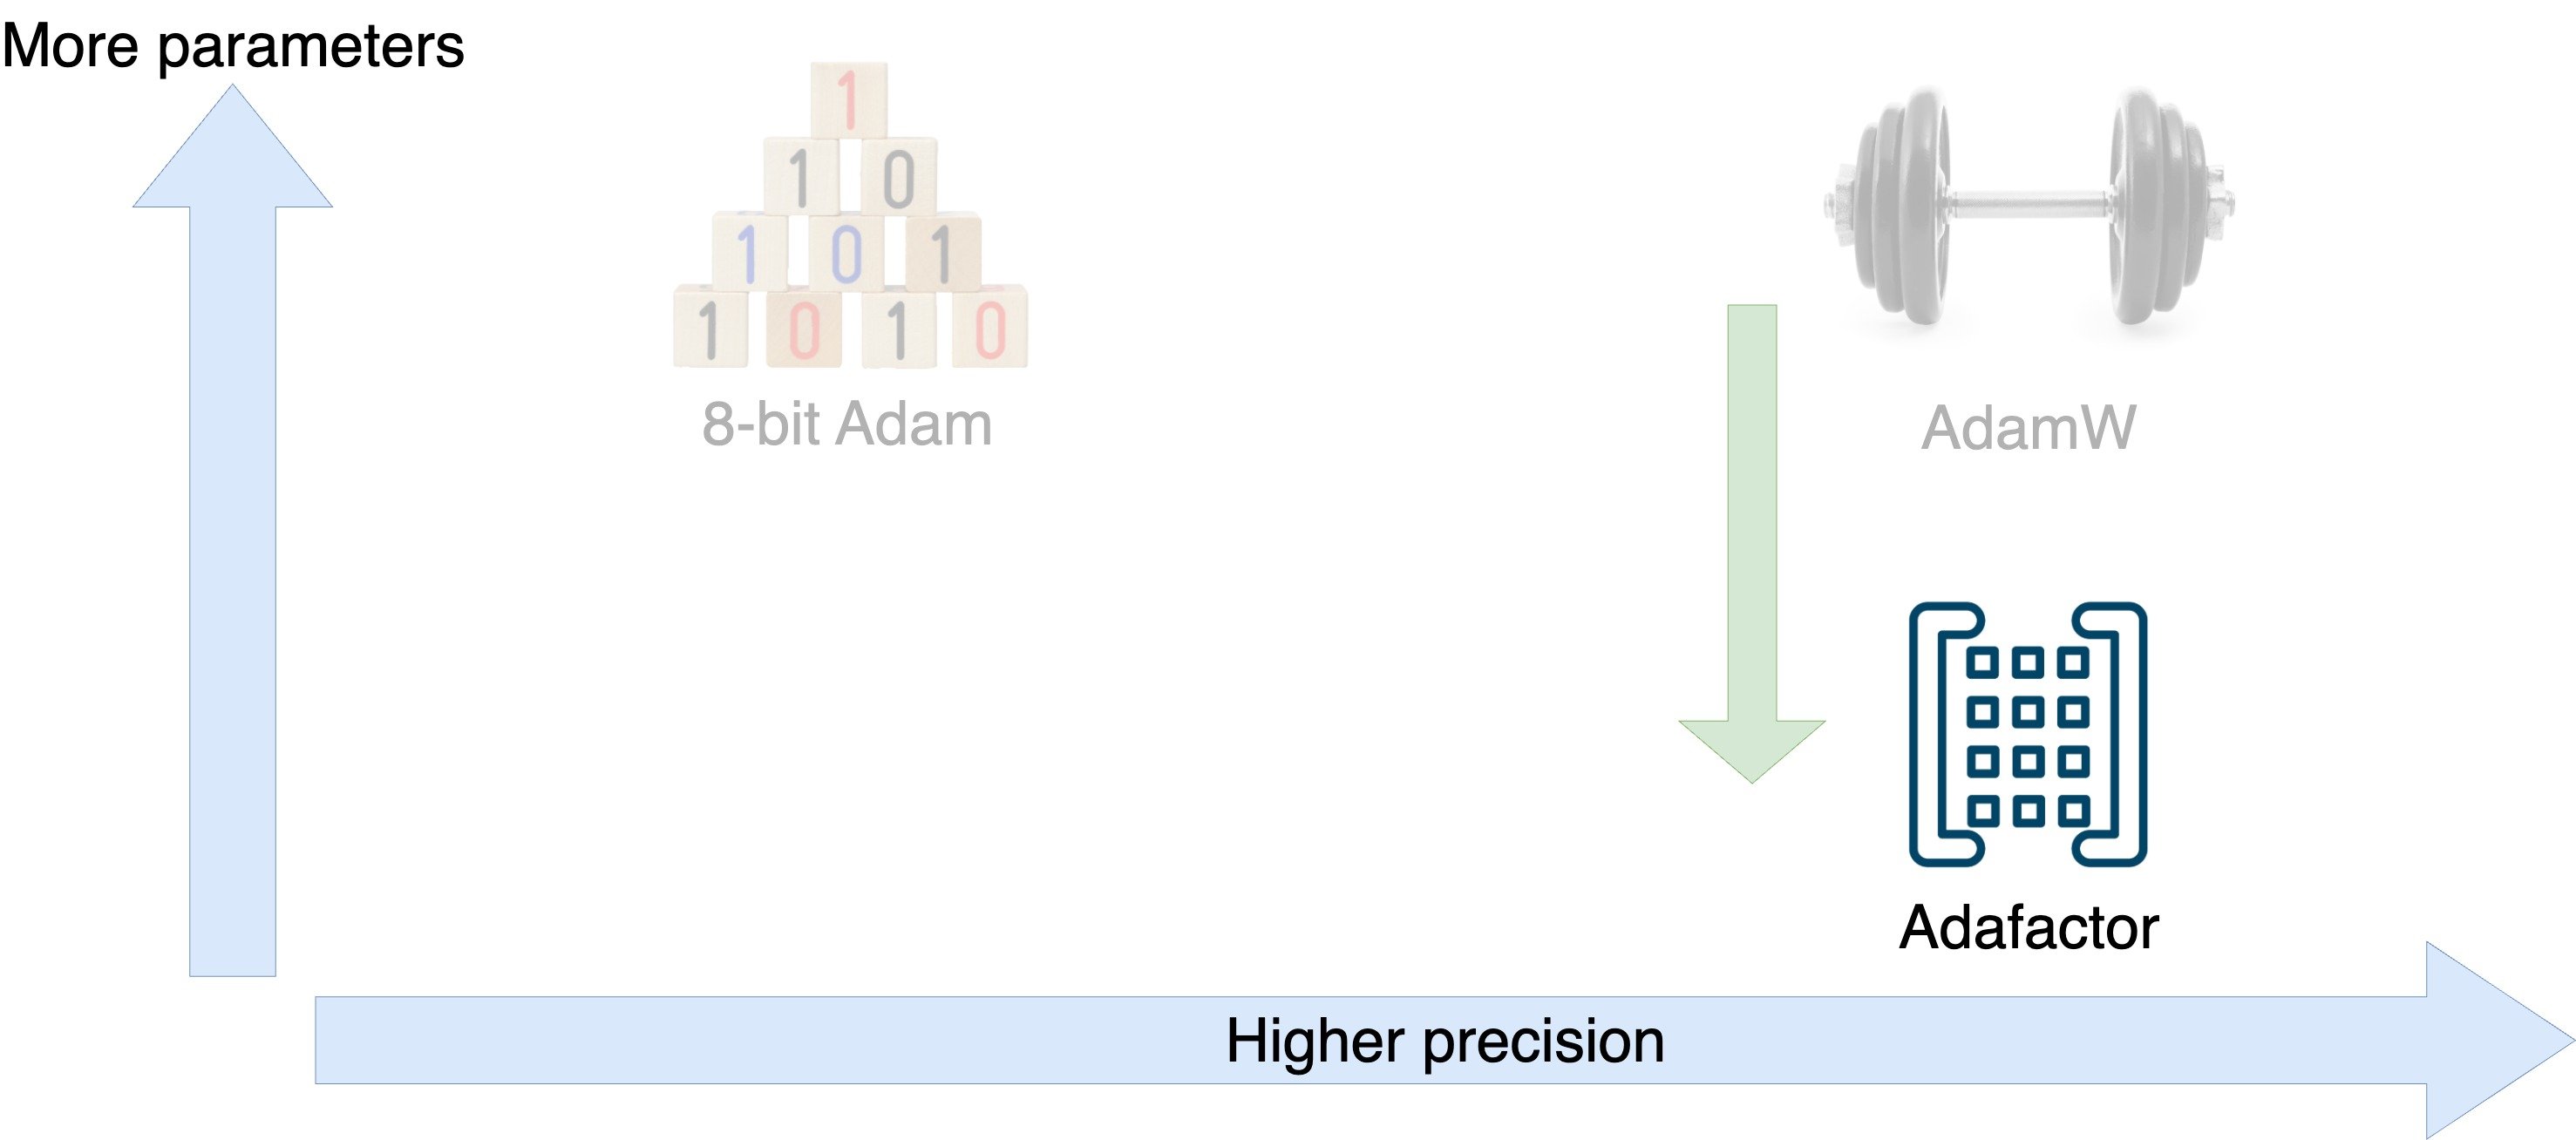
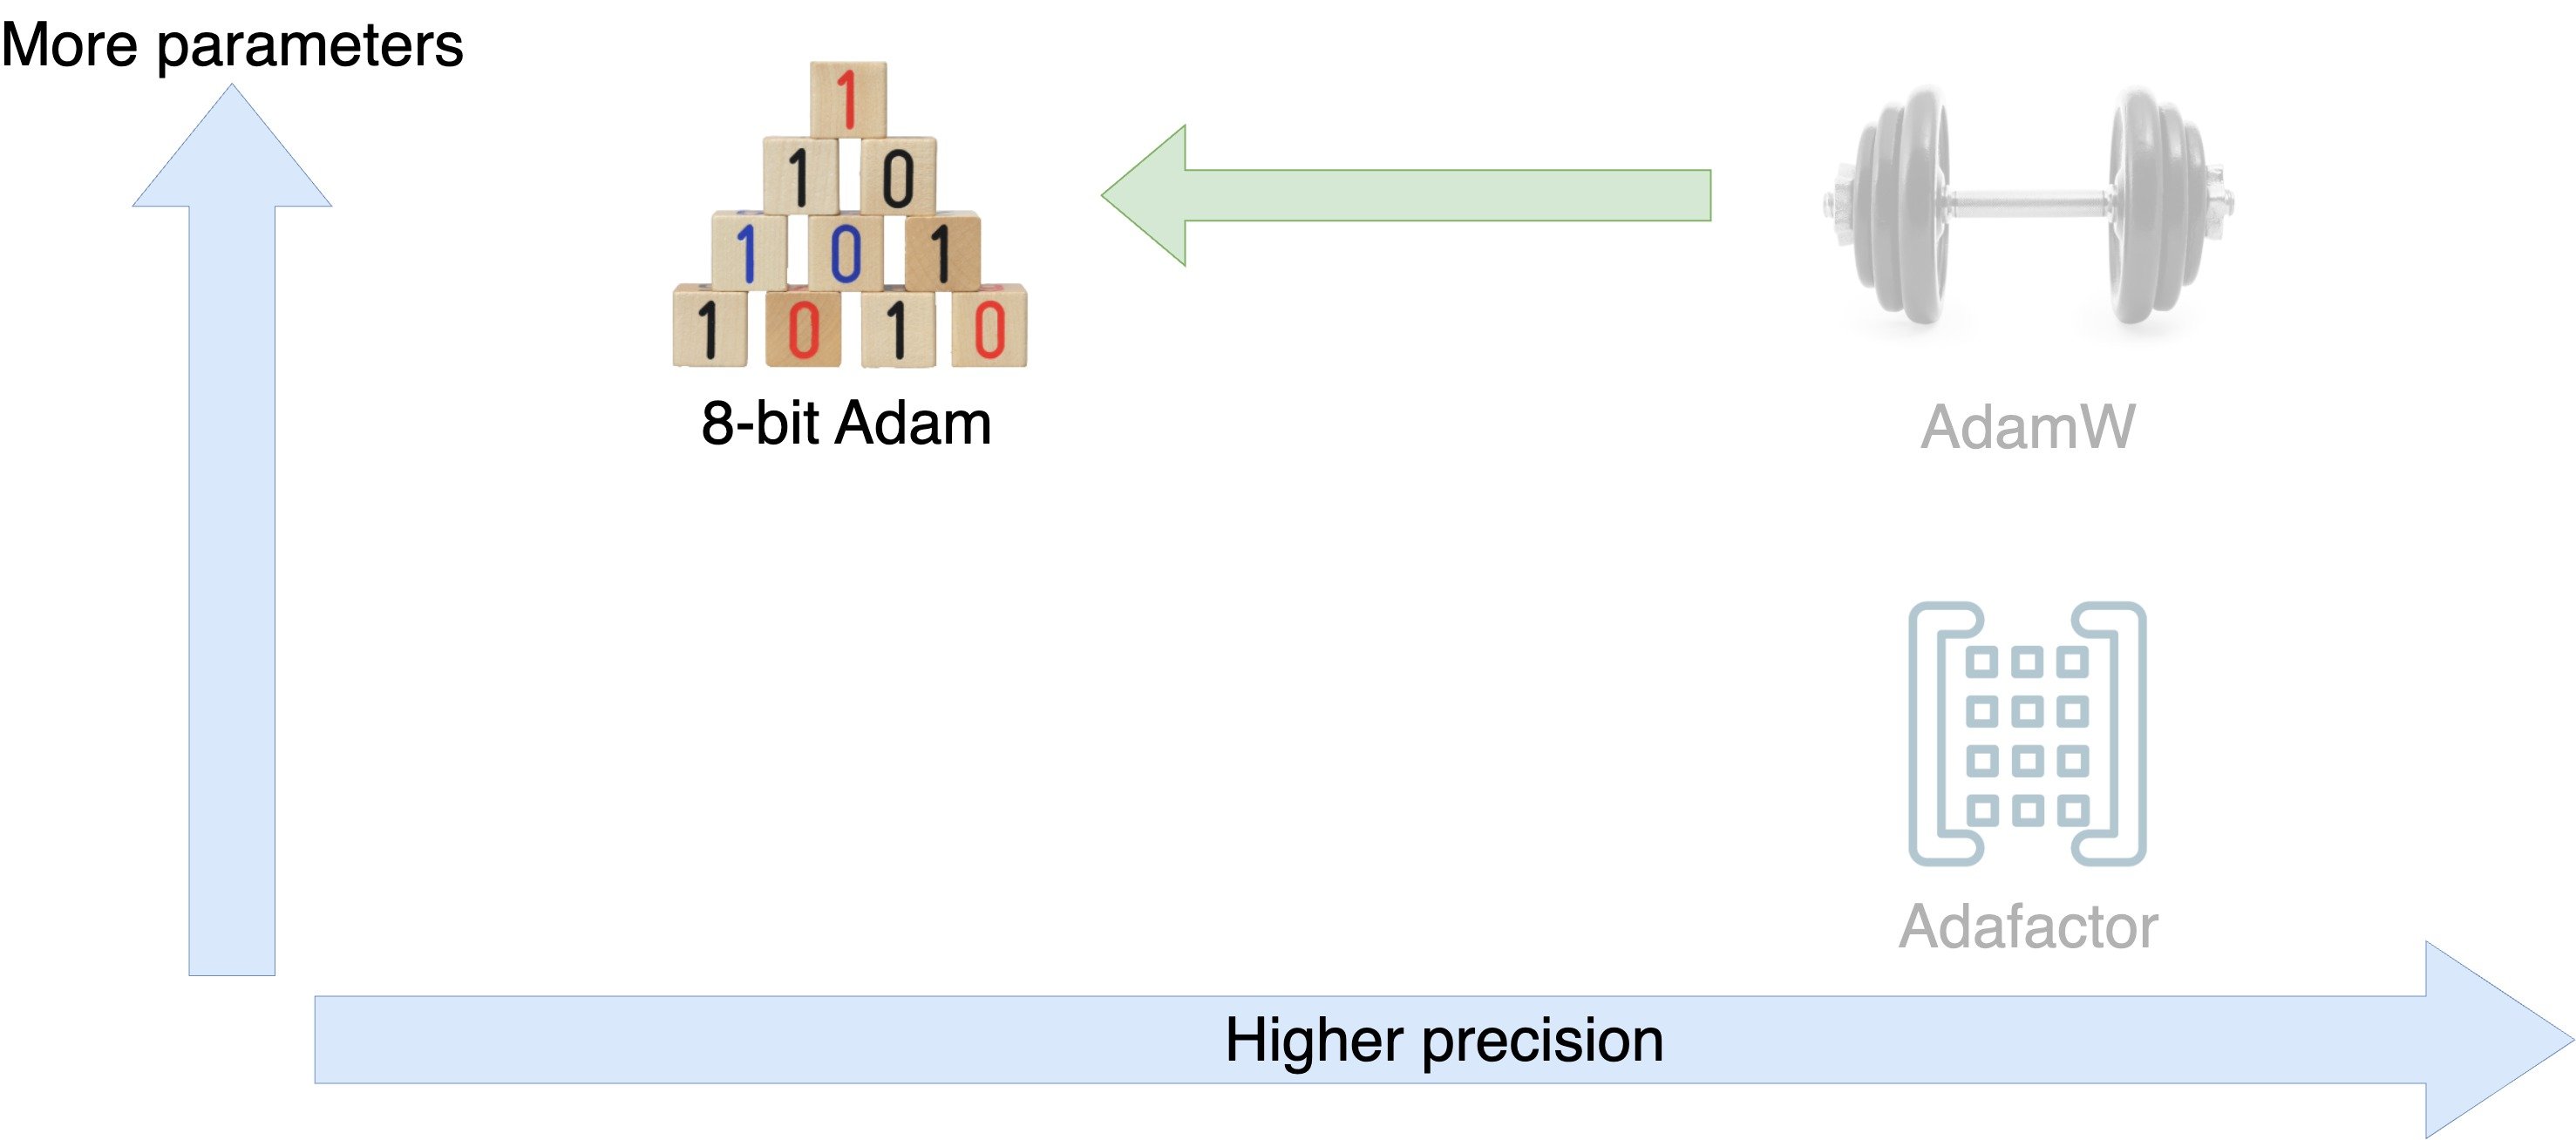
Diagram znázorňující kompromisy mezi počtem parametrů a přesností pro AdamW, Adafactor a 8-bit Adam.

Efficient AI Model Training with PyTorch

Optimalizátory pro efektivní trénink

Diagram znázorňující kompromisy mezi počtem parametrů a přesností pro AdamW, Adafactor a 8-bit Adam.

Efficient AI Model Training with PyTorch

Jak funguje 8-bit Adam?

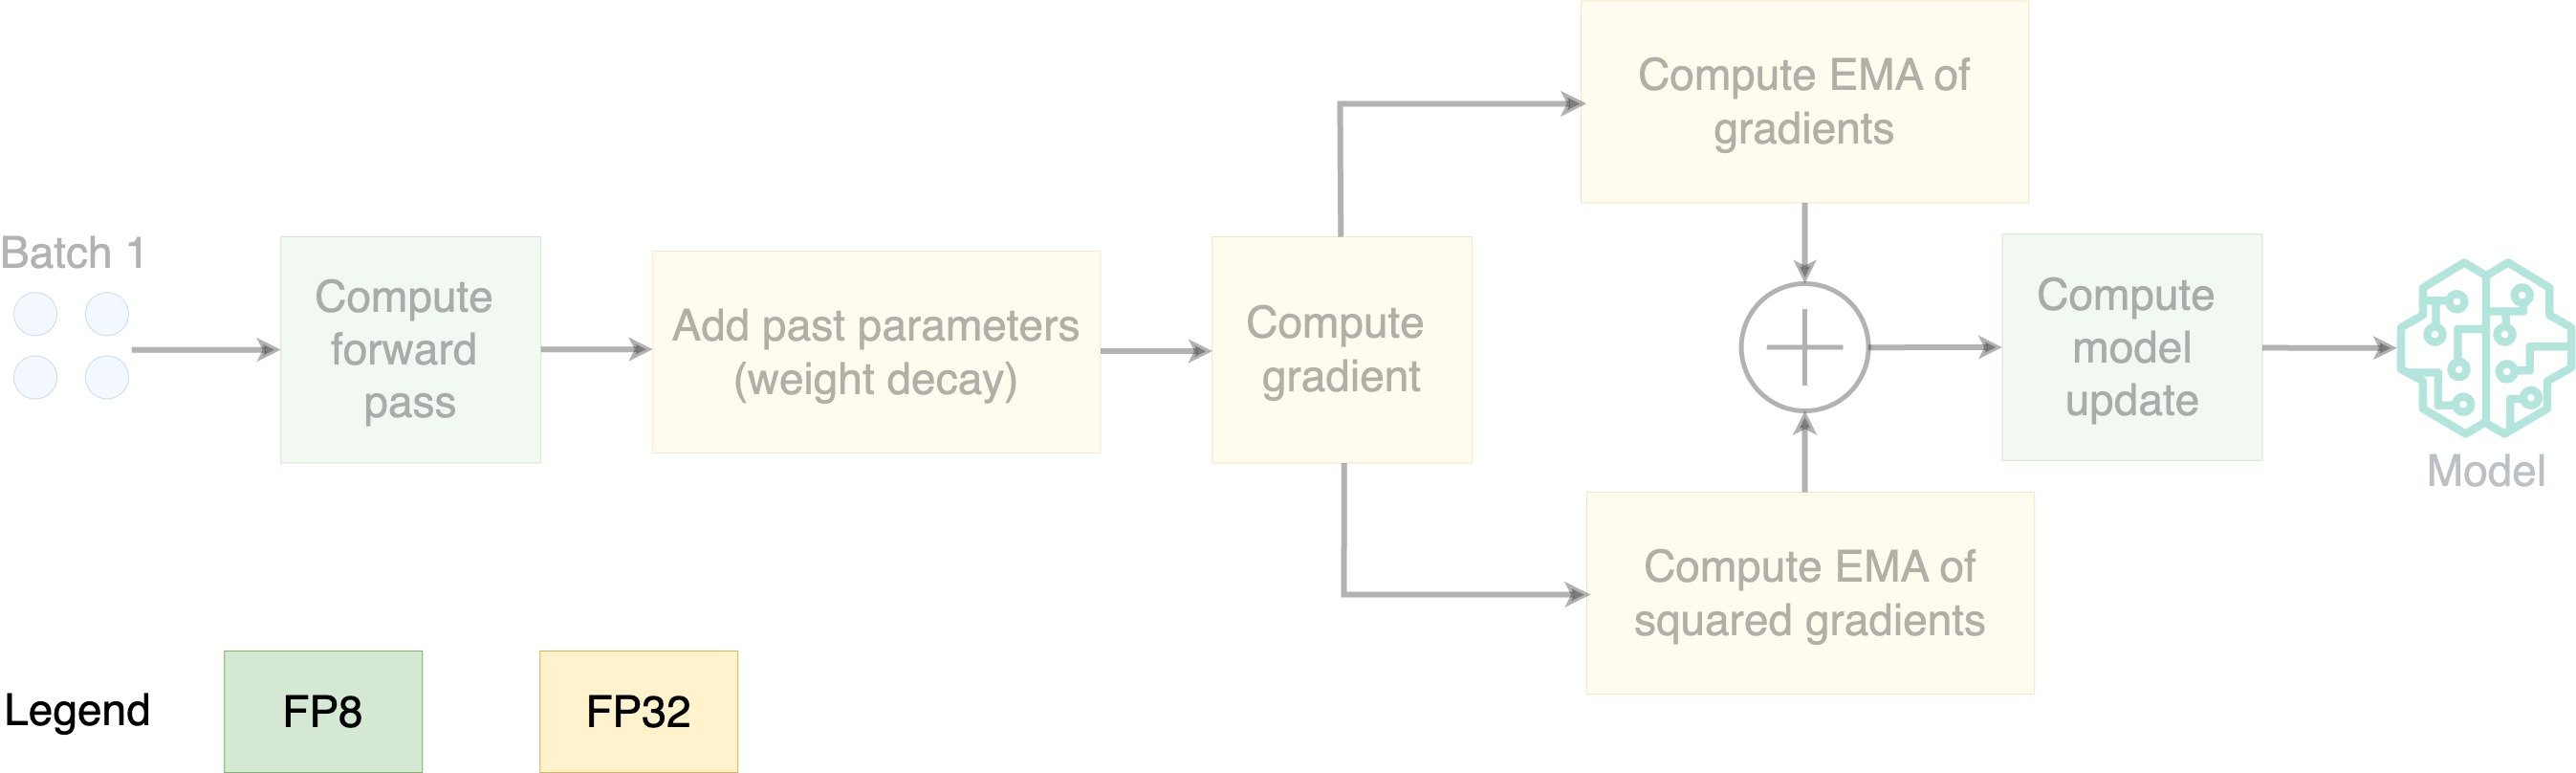
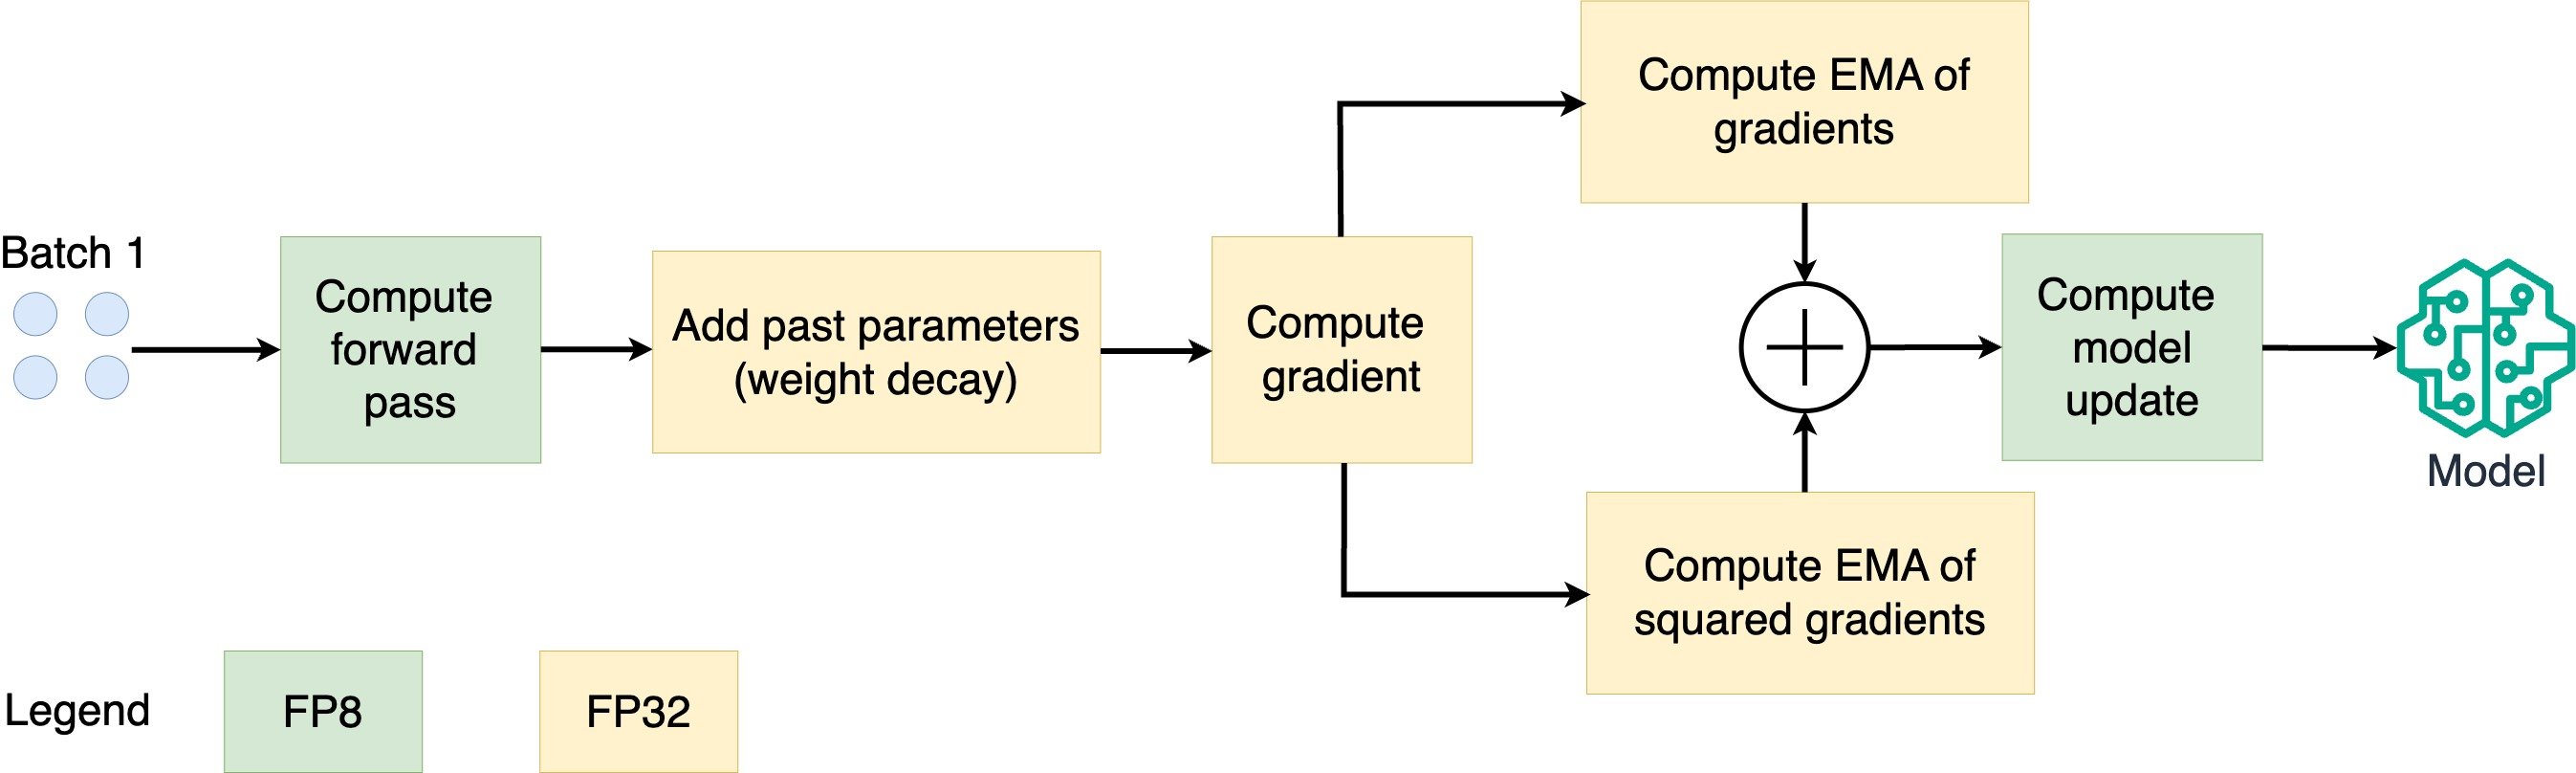
Diagram znázorňující kroky algoritmu 8-bit Adam.

  • Parametry ukládány v FP8; optimalizace v FP32
Efficient AI Model Training with PyTorch

Jak funguje 8-bit Adam?

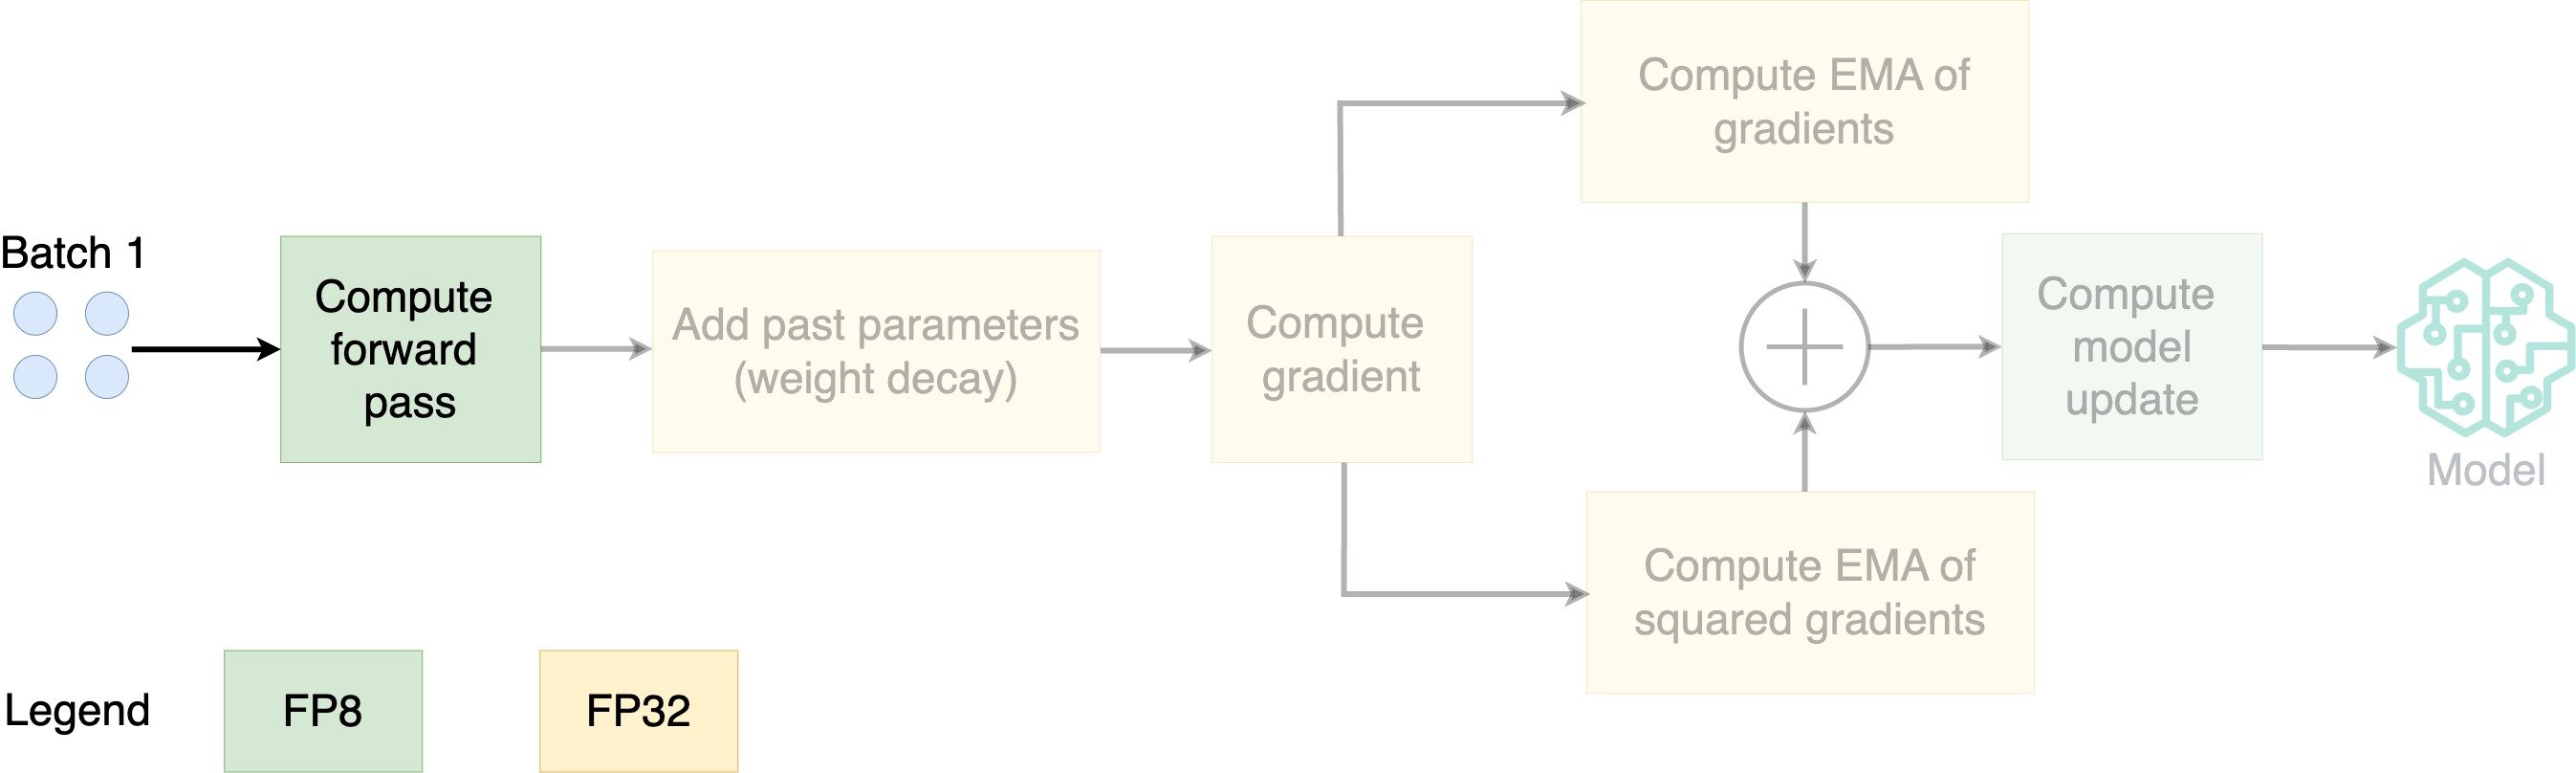
Diagram znázorňující kroky algoritmu 8-bit Adam.

  • Parametry ukládány v FP8; optimalizace v FP32
Efficient AI Model Training with PyTorch

Jak funguje 8-bit Adam?

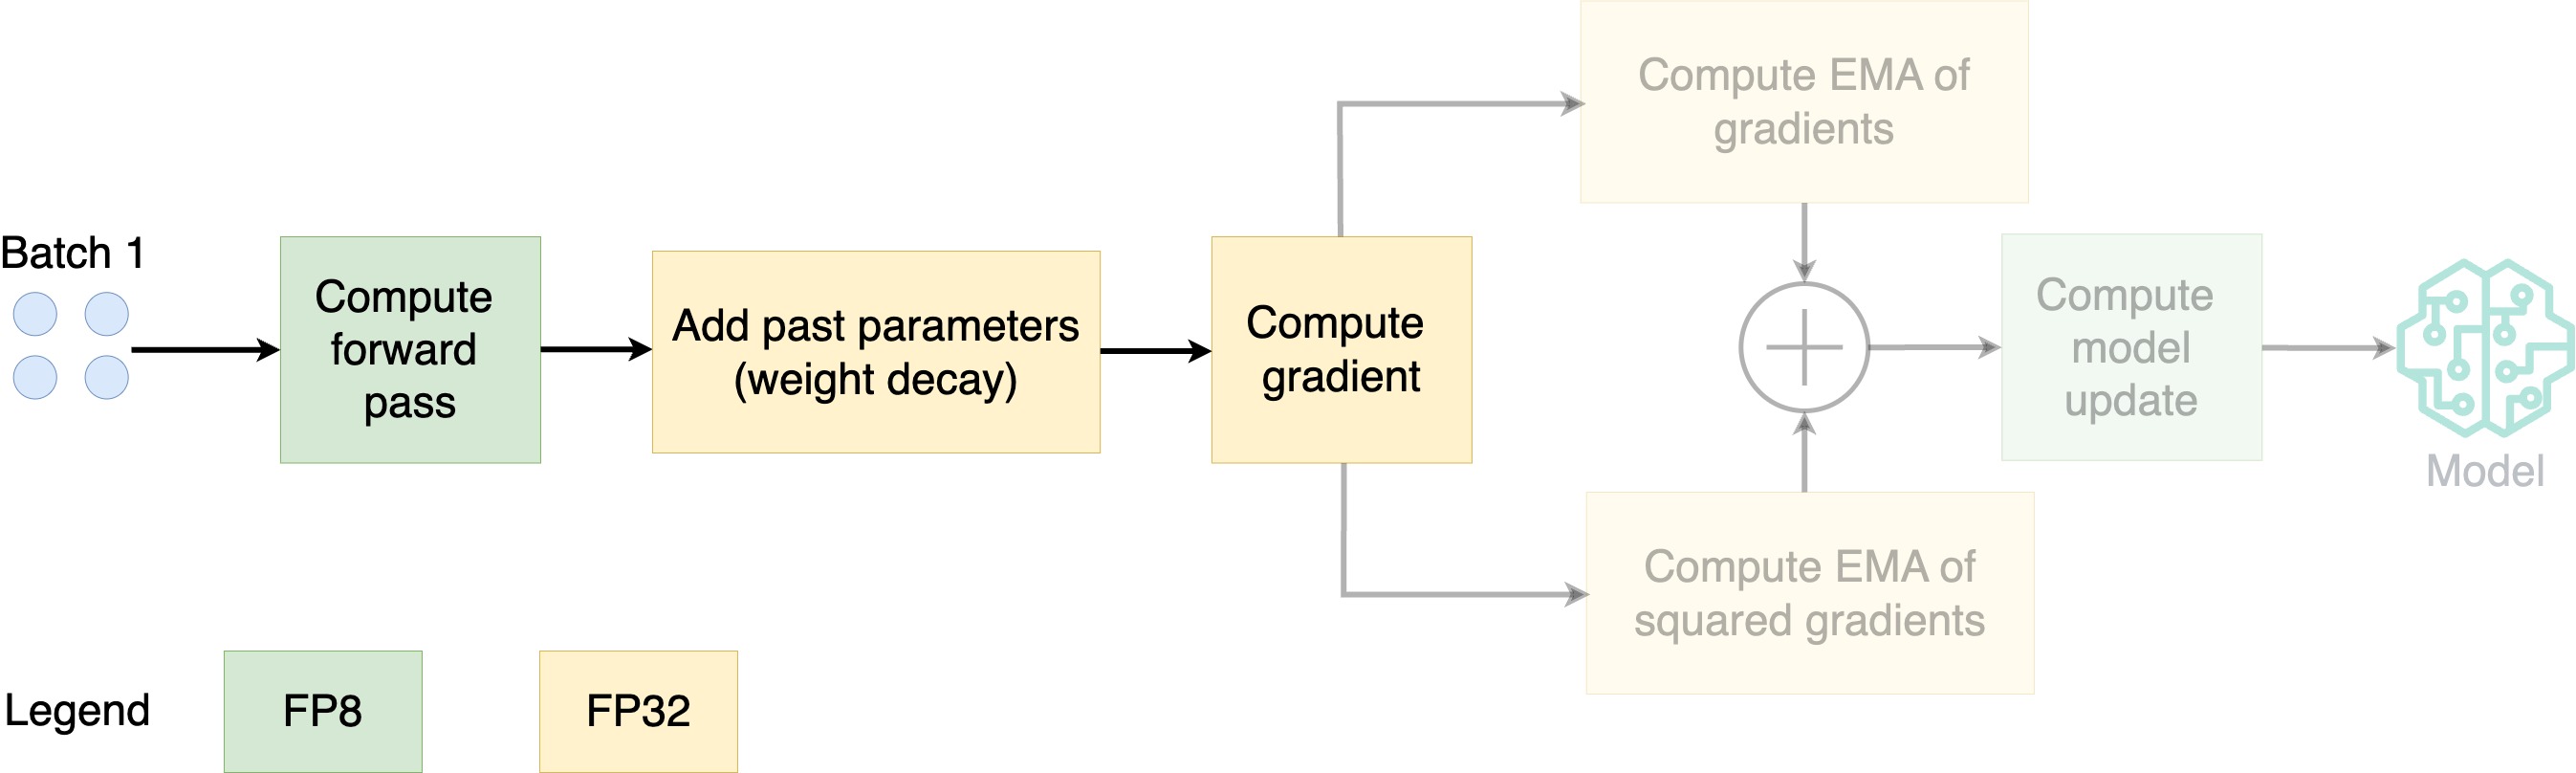
Diagram znázorňující kroky algoritmu 8-bit Adam.

  • Parametry ukládány v FP8; optimalizace v FP32
Efficient AI Model Training with PyTorch

Jak funguje 8-bit Adam?

Diagram znázorňující kroky algoritmu 8-bit Adam.

  • Parametry ukládány v FP8; optimalizace v FP32
  • EMA: exponenciální klouzavý průměr
  • Výpočet EMA gradientů a jejich druhých mocnin
Efficient AI Model Training with PyTorch

Jak funguje 8-bit Adam?

Diagram znázorňující kroky algoritmu 8-bit Adam.

  • Parametry ukládány v FP8; optimalizace v FP32
  • EMA: exponenciální klouzavý průměr
  • Výpočet EMA gradientů a jejich druhých mocnin
Efficient AI Model Training with PyTorch

Jak 8-bit Adam šetří paměť?

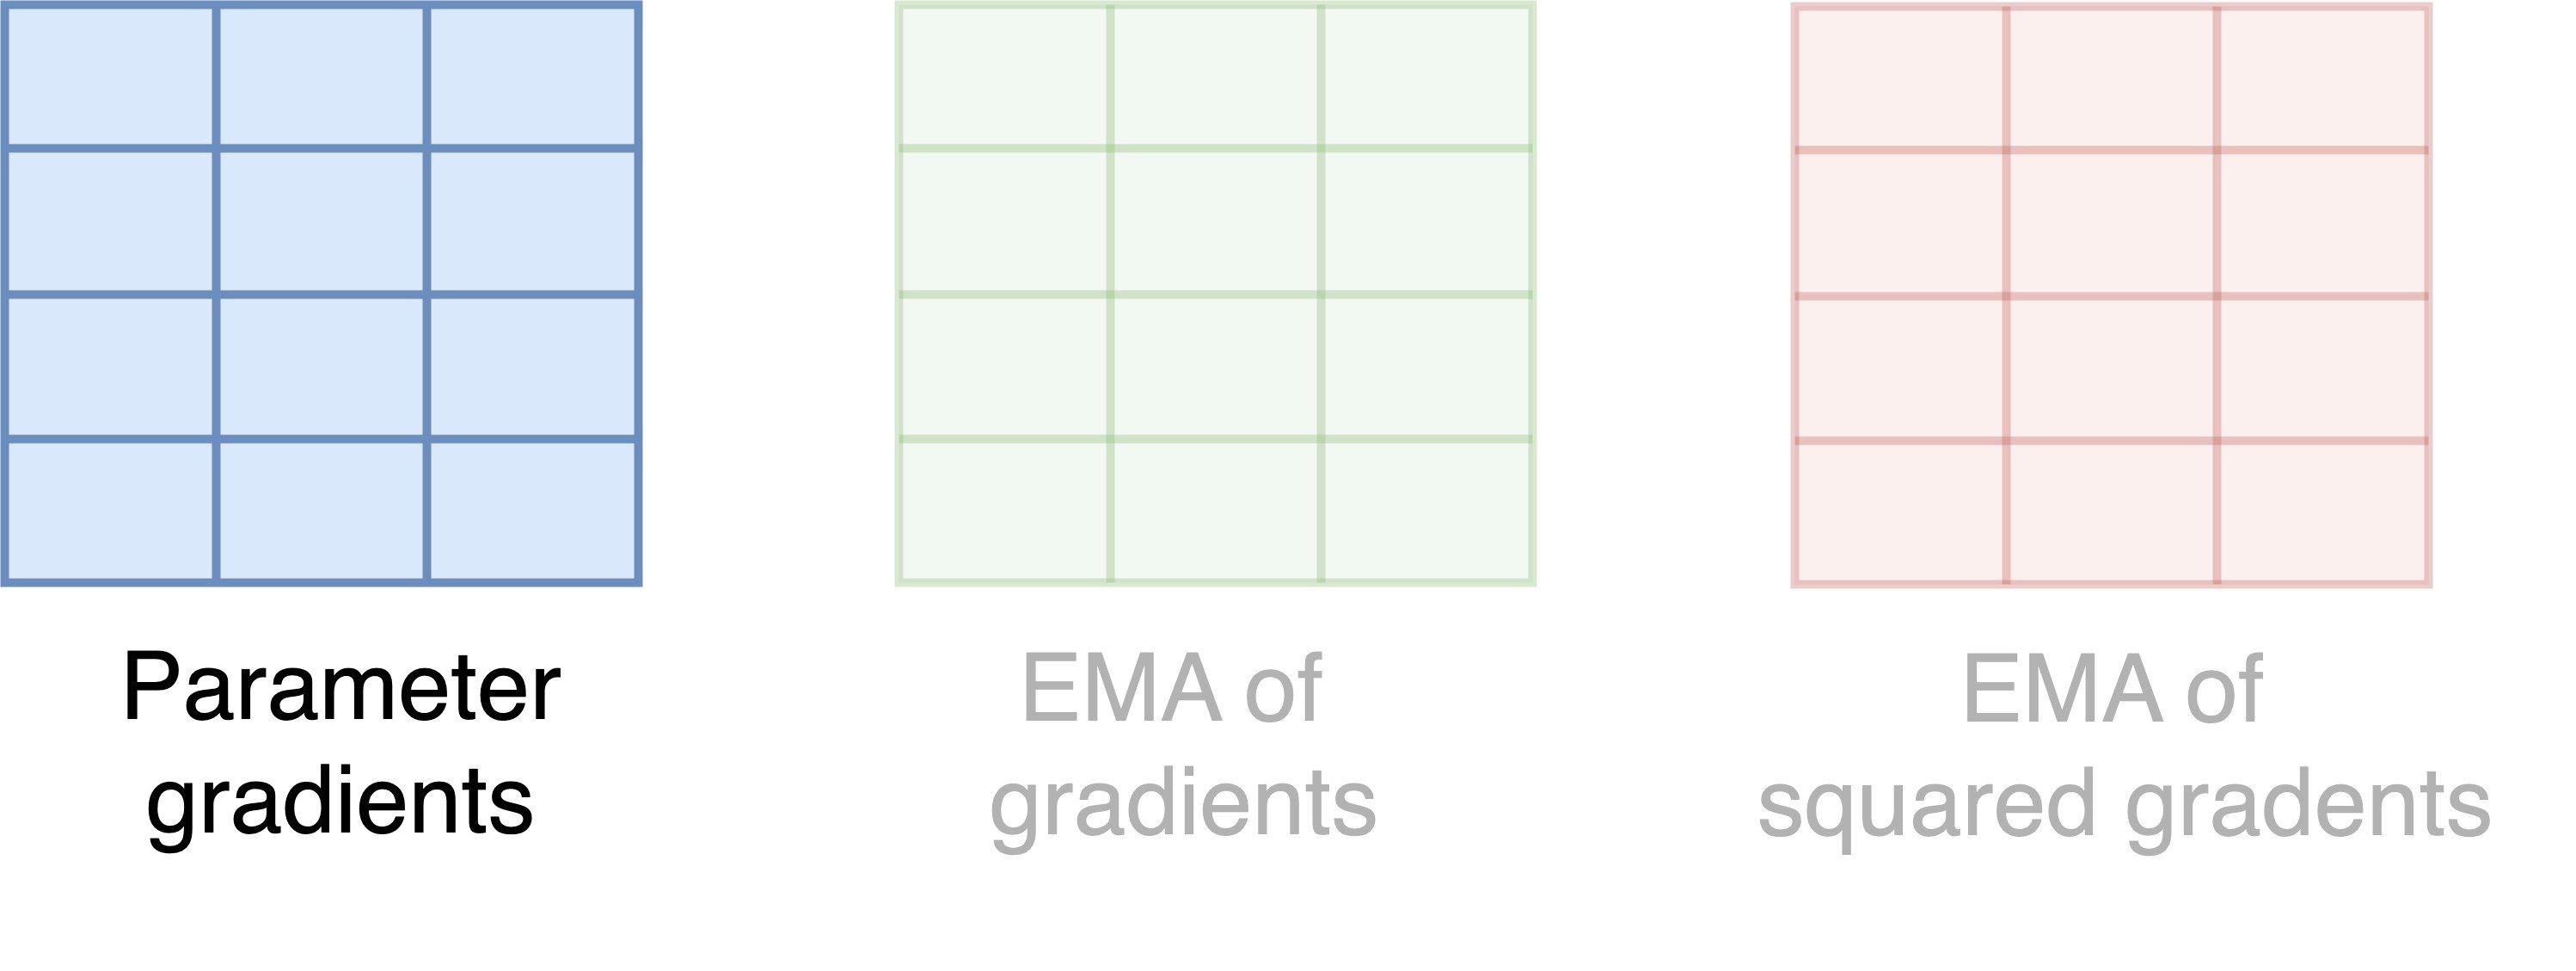
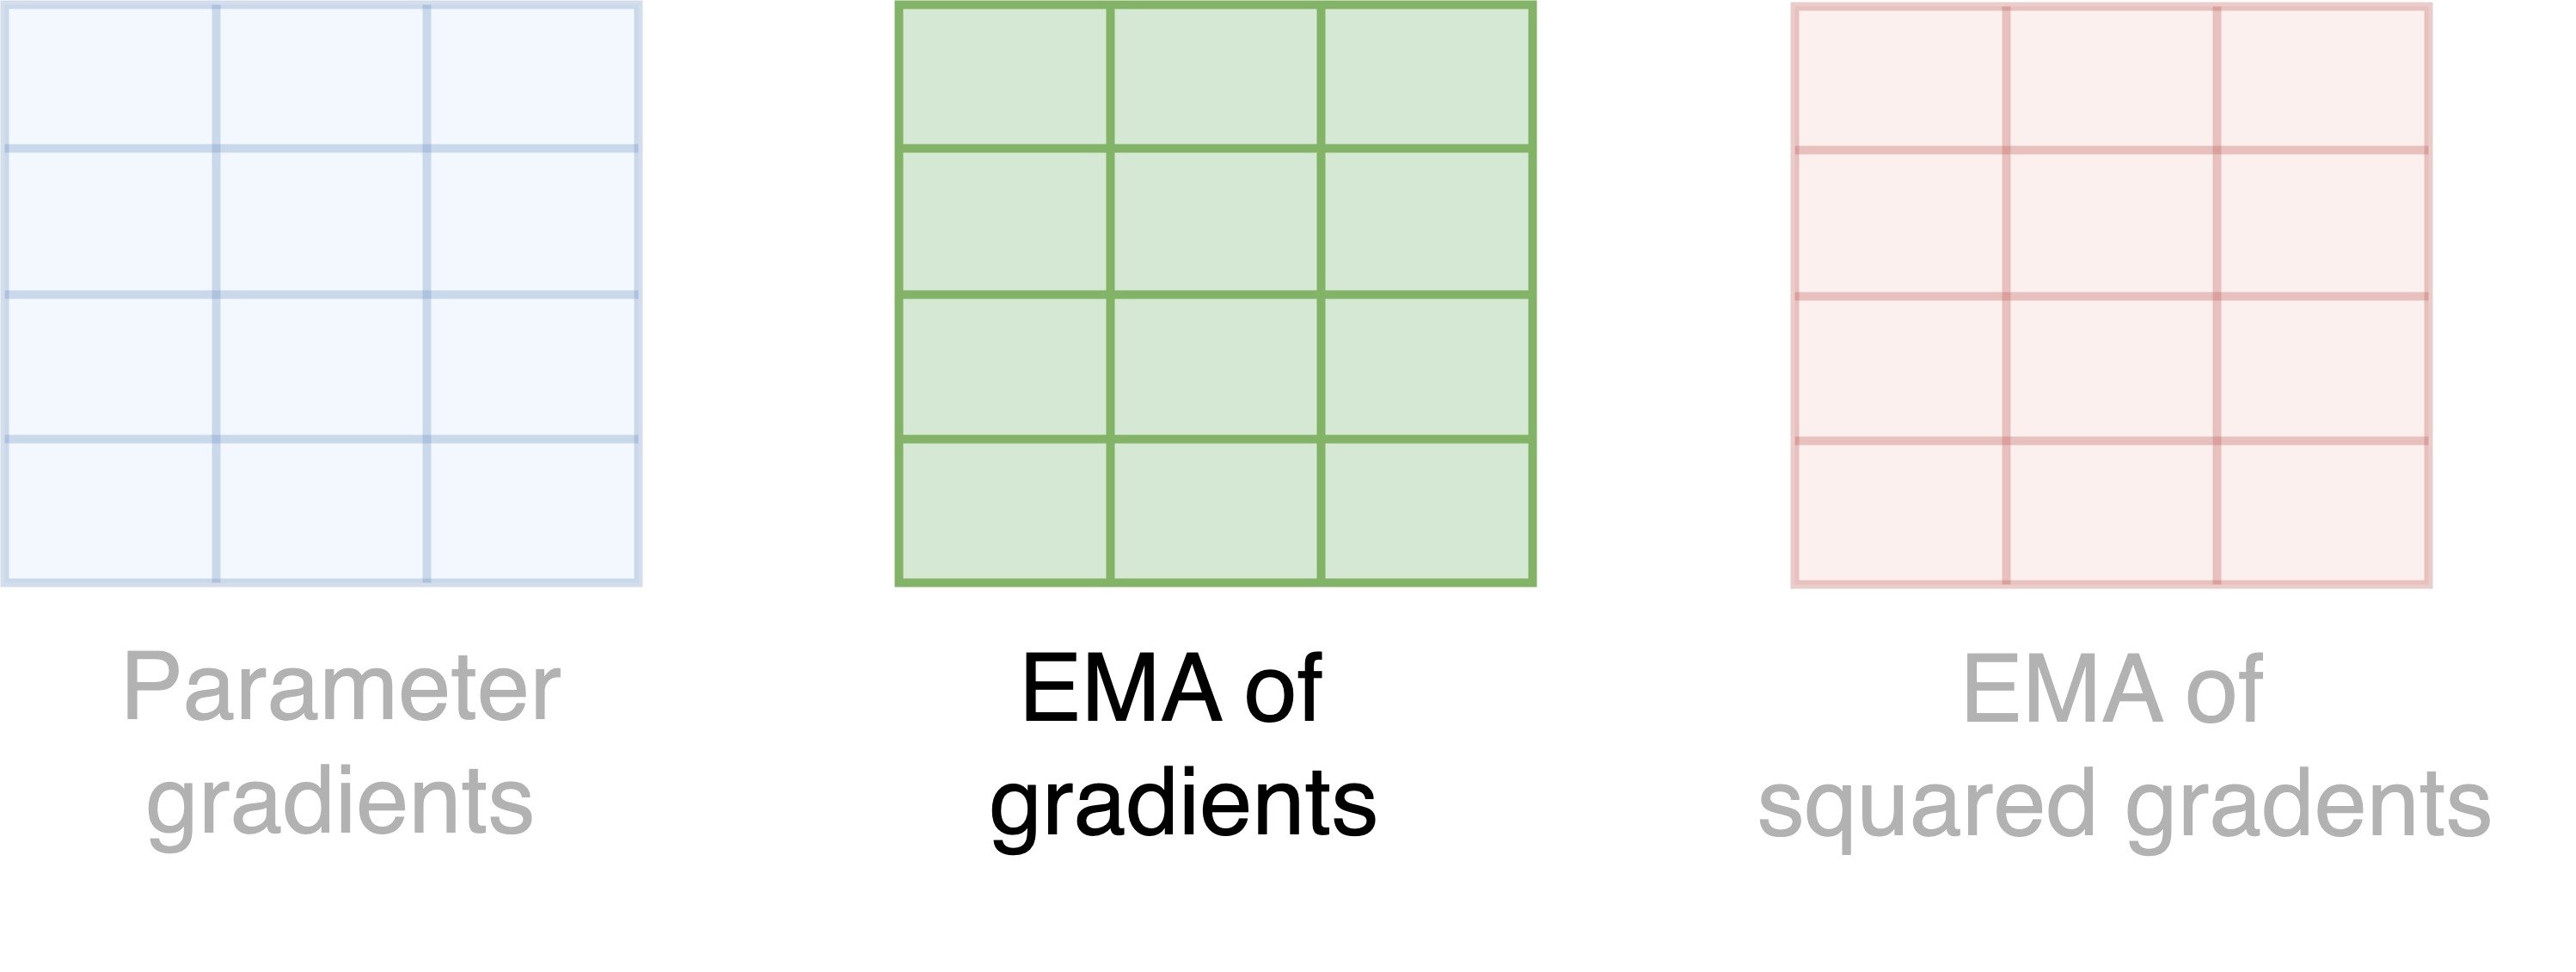
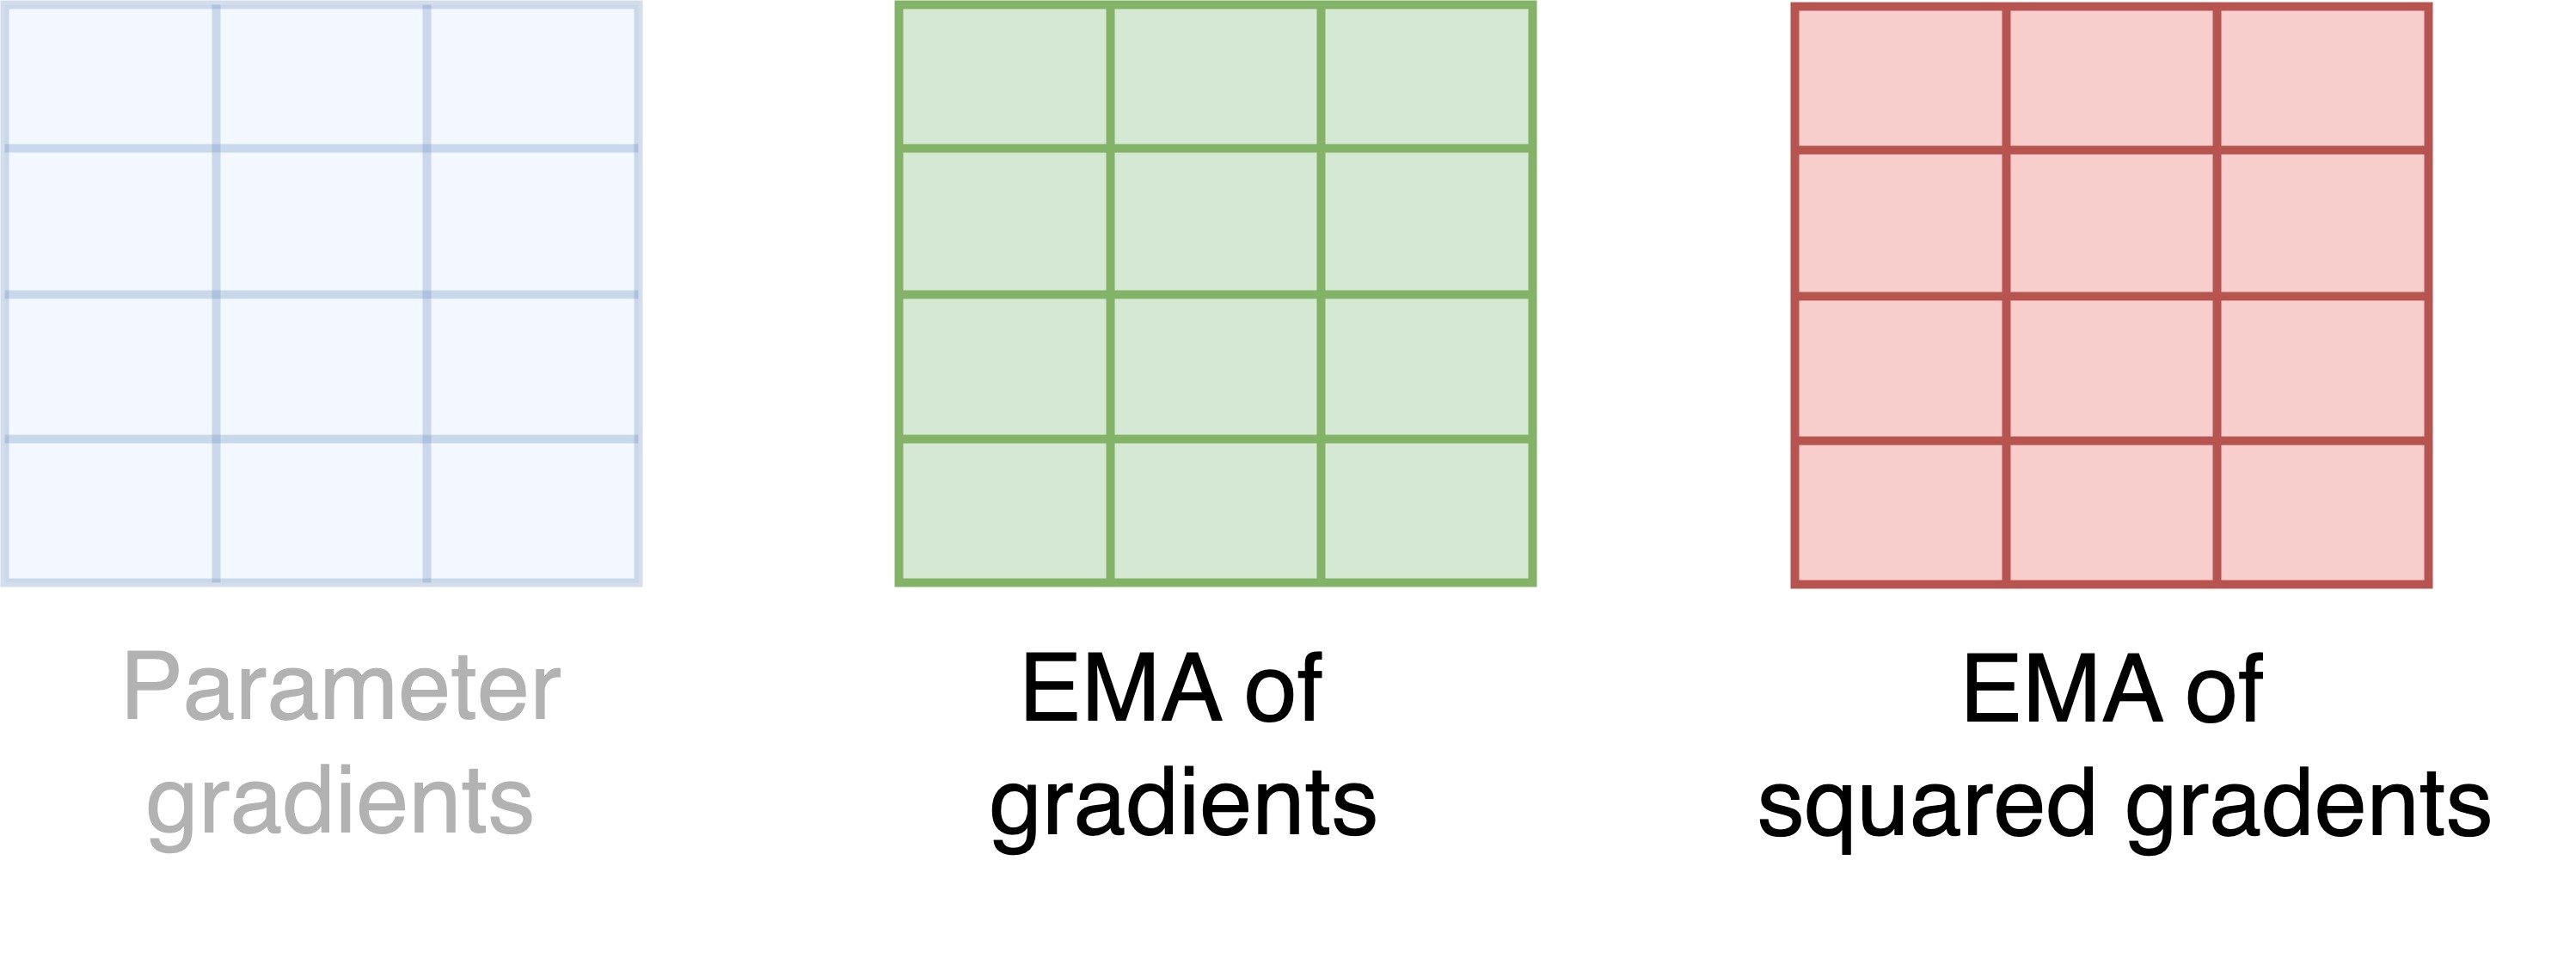
Diagram zobrazující gradienty parametrů, EMA gradientů a EMA druhých mocnin gradientů.

Efficient AI Model Training with PyTorch

Jak 8-bit Adam šetří paměť?

Diagram zobrazující gradienty parametrů, EMA gradientů a EMA druhých mocnin gradientů.

Efficient AI Model Training with PyTorch

Jak 8-bit Adam šetří paměť?

Diagram zobrazující gradienty parametrů, EMA gradientů a EMA druhých mocnin gradientů.

  • Každý čtverec je parametr, každá barva představuje stav
  • Paměť na parametr = 2 bajty = 1 bajt na stav × 2 stavy
  • Celková paměť = paměť na parametr (2 bajty) × počet parametrů
Efficient AI Model Training with PyTorch

Odhad paměťové náročnosti 8-bit Adam

model = AutoModelForSequenceClassification.from_pretrained(
    "distilbert-base-cased", return_dict=True)
num_parameters = sum(p.numel() for p in model.parameters())
print(f"Number of model parameters: {num_parameters:,}")
Number of model parameters: 65,783,042
estimated_memory = num_parameters * 2 / (1024 ** 2)
print(f"Estimated memory usage of 8-bit Adam: {estimated_memory:.0f} MB")
Estimated memory usage of 8-bit Adam: 125 MB
Efficient AI Model Training with PyTorch

Nastavení optimalizátoru 8-bit Adam

import bitsandbytes as bnb
from torch import nn
from transformers.trainer_pt_utils import get_parameter_names


args = TrainingArguments(output_dir="./results")
decay_parameters = get_parameter_names(model, [nn.LayerNorm])
decay_parameters = [name for name in decay_parameters if "bias" not in name]
  • Weight decay zabraňuje přeučení
  • decay_parameters: parametry, na které se aplikuje weight decay
  • get_parameter_names: vrátí názvy parametrů; ignoruje vrstvy nn.LayerNorm
  • Odebrání parametrů bias z decay_parameters
  • Weight decay se neaplikuje na normalizační vrstvy a bias
Efficient AI Model Training with PyTorch

Nastavení optimalizátoru 8-bit Adam

optimizer_grouped_parameters = [{"params": [p for n, p in model.named_parameters() 
                                            if n in decay_parameters],
                                 "weight_decay": args.weight_decay},

{"params": [p for n, p in model.named_parameters() if n not in decay_parameters], "weight_decay": 0.0}]
adam_bnb_optim = bnb.optim.Adam8bit(optimizer_grouped_parameters,
betas=(args.adam_beta1, args.adam_beta2),
eps=args.adam_epsilon,
lr=args.learning_rate)
  • optimizer_grouped_parameters: jedna skupina s weight decay, druhá bez
  • beta1, beta2: míra útlumu 1. a 2. momentu; vyšší = stabilní, pomalejší trénink
Efficient AI Model Training with PyTorch

Implementace 8-bit Adam pomocí Trainer

trainer = Trainer(model=model,
                  args=training_args,
                  train_dataset=train_dataset,
                  eval_dataset=validation_dataset,
                  optimizers=(adam_bnb_optim, None),
                  compute_metrics=compute_metrics)

trainer.train()
{'epoch': 1.0, 'eval_loss': 0.63, 'eval_accuracy': 0.67, 'eval_f1': 0.62}
{'epoch': 2.0, 'eval_loss': 0.61, 'eval_accuracy': 0.71, 'eval_f1': 0.66}
Efficient AI Model Training with PyTorch

Implementace 8-bit Adam pomocí Accelerator

model, adam_bnb_optim, train_dataloader, lr_scheduler = \
    accelerator.prepare(model, adam_bnb_optim, train_dataloader, lr_scheduler)


for batch in train_dataloader: inputs, targets = batch["input_ids"], batch["labels"] outputs = model(inputs, labels=targets) loss = outputs.loss accelerator.backward(loss) adam_bnb_optim.step() lr_scheduler.step() adam_bnb_optim.zero_grad() print(f"Loss = {loss}")
Loss = 0.75
Efficient AI Model Training with PyTorch

Výpočet paměťové náročnosti 8-bit Adam

total_size_megabytes, total_num_elements = \
    compute_optimizer_size(trainer.optimizer.state.values())
print(f"Number of 8-bit Adam parameters: {total_num_elements:,}")
print(f"8-bit Adam size: {total_size_megabytes:.0f} MB")
Number of 8-bit Adam parameters: 131,566,188
8-bit Adam size: 128 MB
  • Srovnání s AdamW: 8-bit Adam využívá 1/4 paměti
Number of AdamW parameters: 131,566,188
AdamW size: 502 MB
Efficient AI Model Training with PyTorch

Pojďme si procvičit!

Efficient AI Model Training with PyTorch

Preparing Video For Download...