Gradient checkpointing a lokální SGD

Efficient AI Model Training with PyTorch

Dennis Lee

Data Engineer, Amazon

Zvyšování efektivity trénování


Ikony znázorňující paměťovou, komunikační a výpočetní efektivitu.

Efficient AI Model Training with PyTorch

Gradient checkpointing zlepšuje paměťovou efektivitu


Ikony znázorňující paměťovou, komunikační a výpočetní efektivitu.

Efficient AI Model Training with PyTorch

Lokální SGD řeší komunikační efektivitu


Ikony znázorňující paměťovou, komunikační a výpočetní efektivitu.

Efficient AI Model Training with PyTorch

Co je gradient checkpointing?

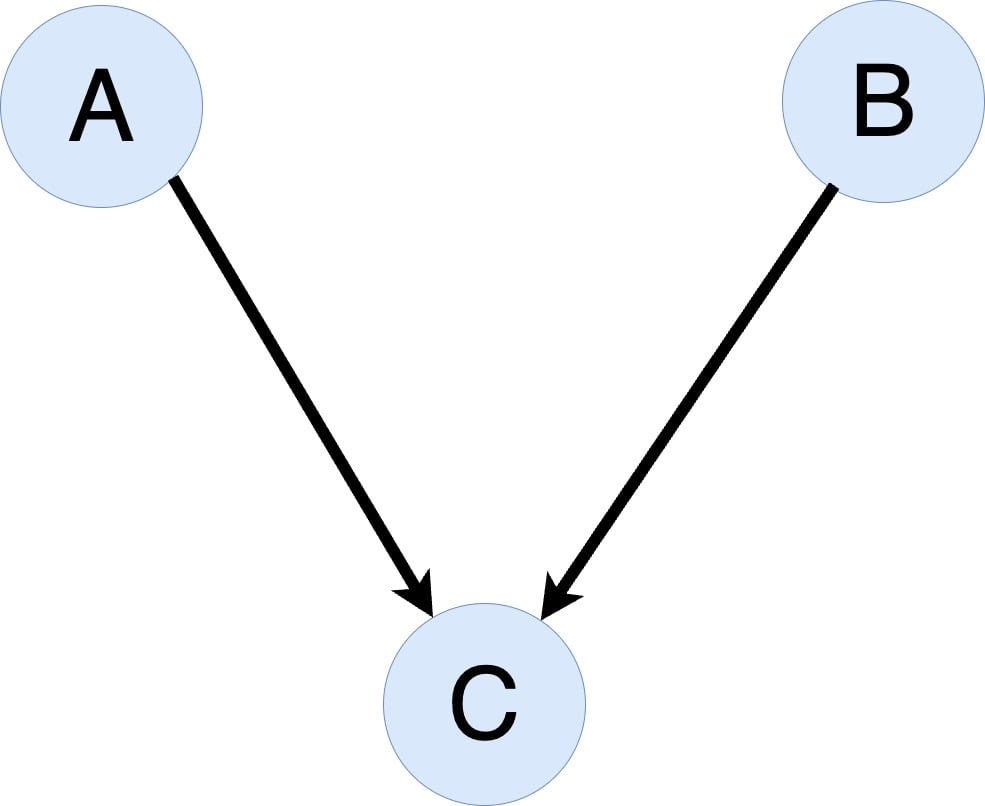
  • Gradient checkpointing: snížení paměti výběrem aktivací k uložení
  • Příklad: výpočet A + B = C

Graf znázorňující gradient checkpointing s uzly a hranami

Efficient AI Model Training with PyTorch

Co je gradient checkpointing?

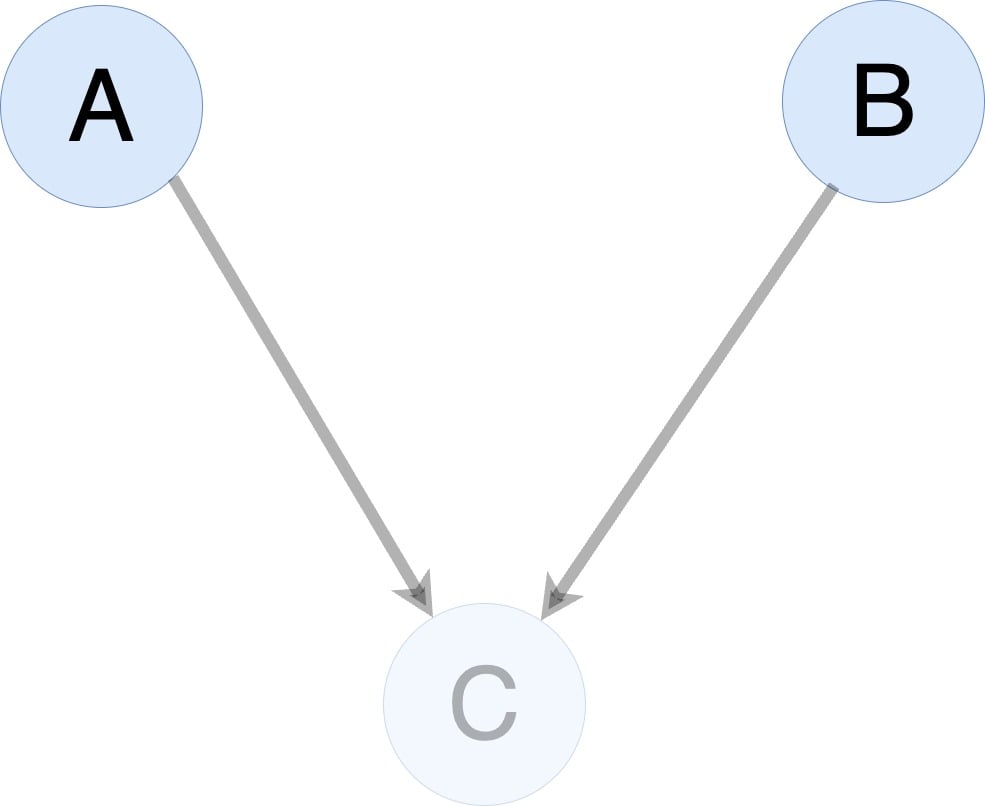
  • Gradient checkpointing: snížení paměti výběrem aktivací k uložení
  • Příklad: výpočet A + B = C
    • Nejprve výpočet A, B, pak C

Graf znázorňující gradient checkpointing s uzly a hranami

Efficient AI Model Training with PyTorch

Co je gradient checkpointing?

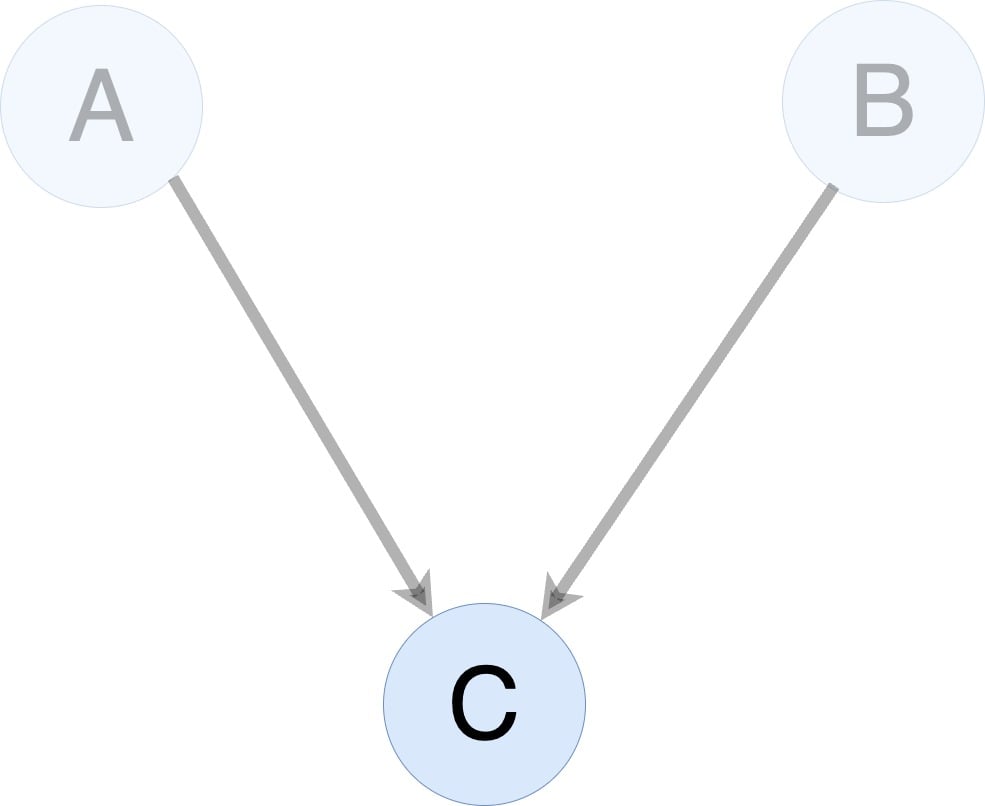
  • Gradient checkpointing: snížení paměti výběrem aktivací k uložení
  • Příklad: výpočet A + B = C
    • Nejprve výpočet A, B, pak C
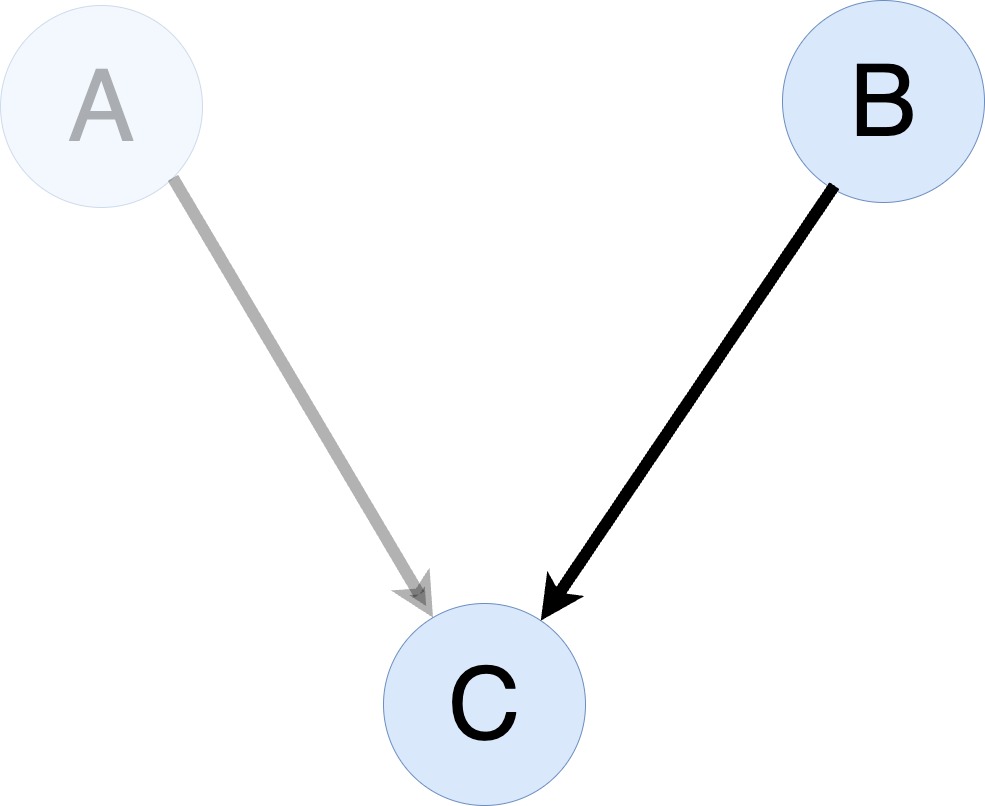
    • A, B nejsou potřeba pro zbytek dopředného průchodu
  • Uložit, nebo odstranit A a B?
    • Bez gradient checkpointingu: uložit A, B
    • Gradient checkpointing: odstranit A, B
    • Přepočítat A, B při zpětném průchodu
    • Je-li přepočet B nákladný, uložit ho

Graf znázorňující gradient checkpointing s uzly a hranami

Efficient AI Model Training with PyTorch

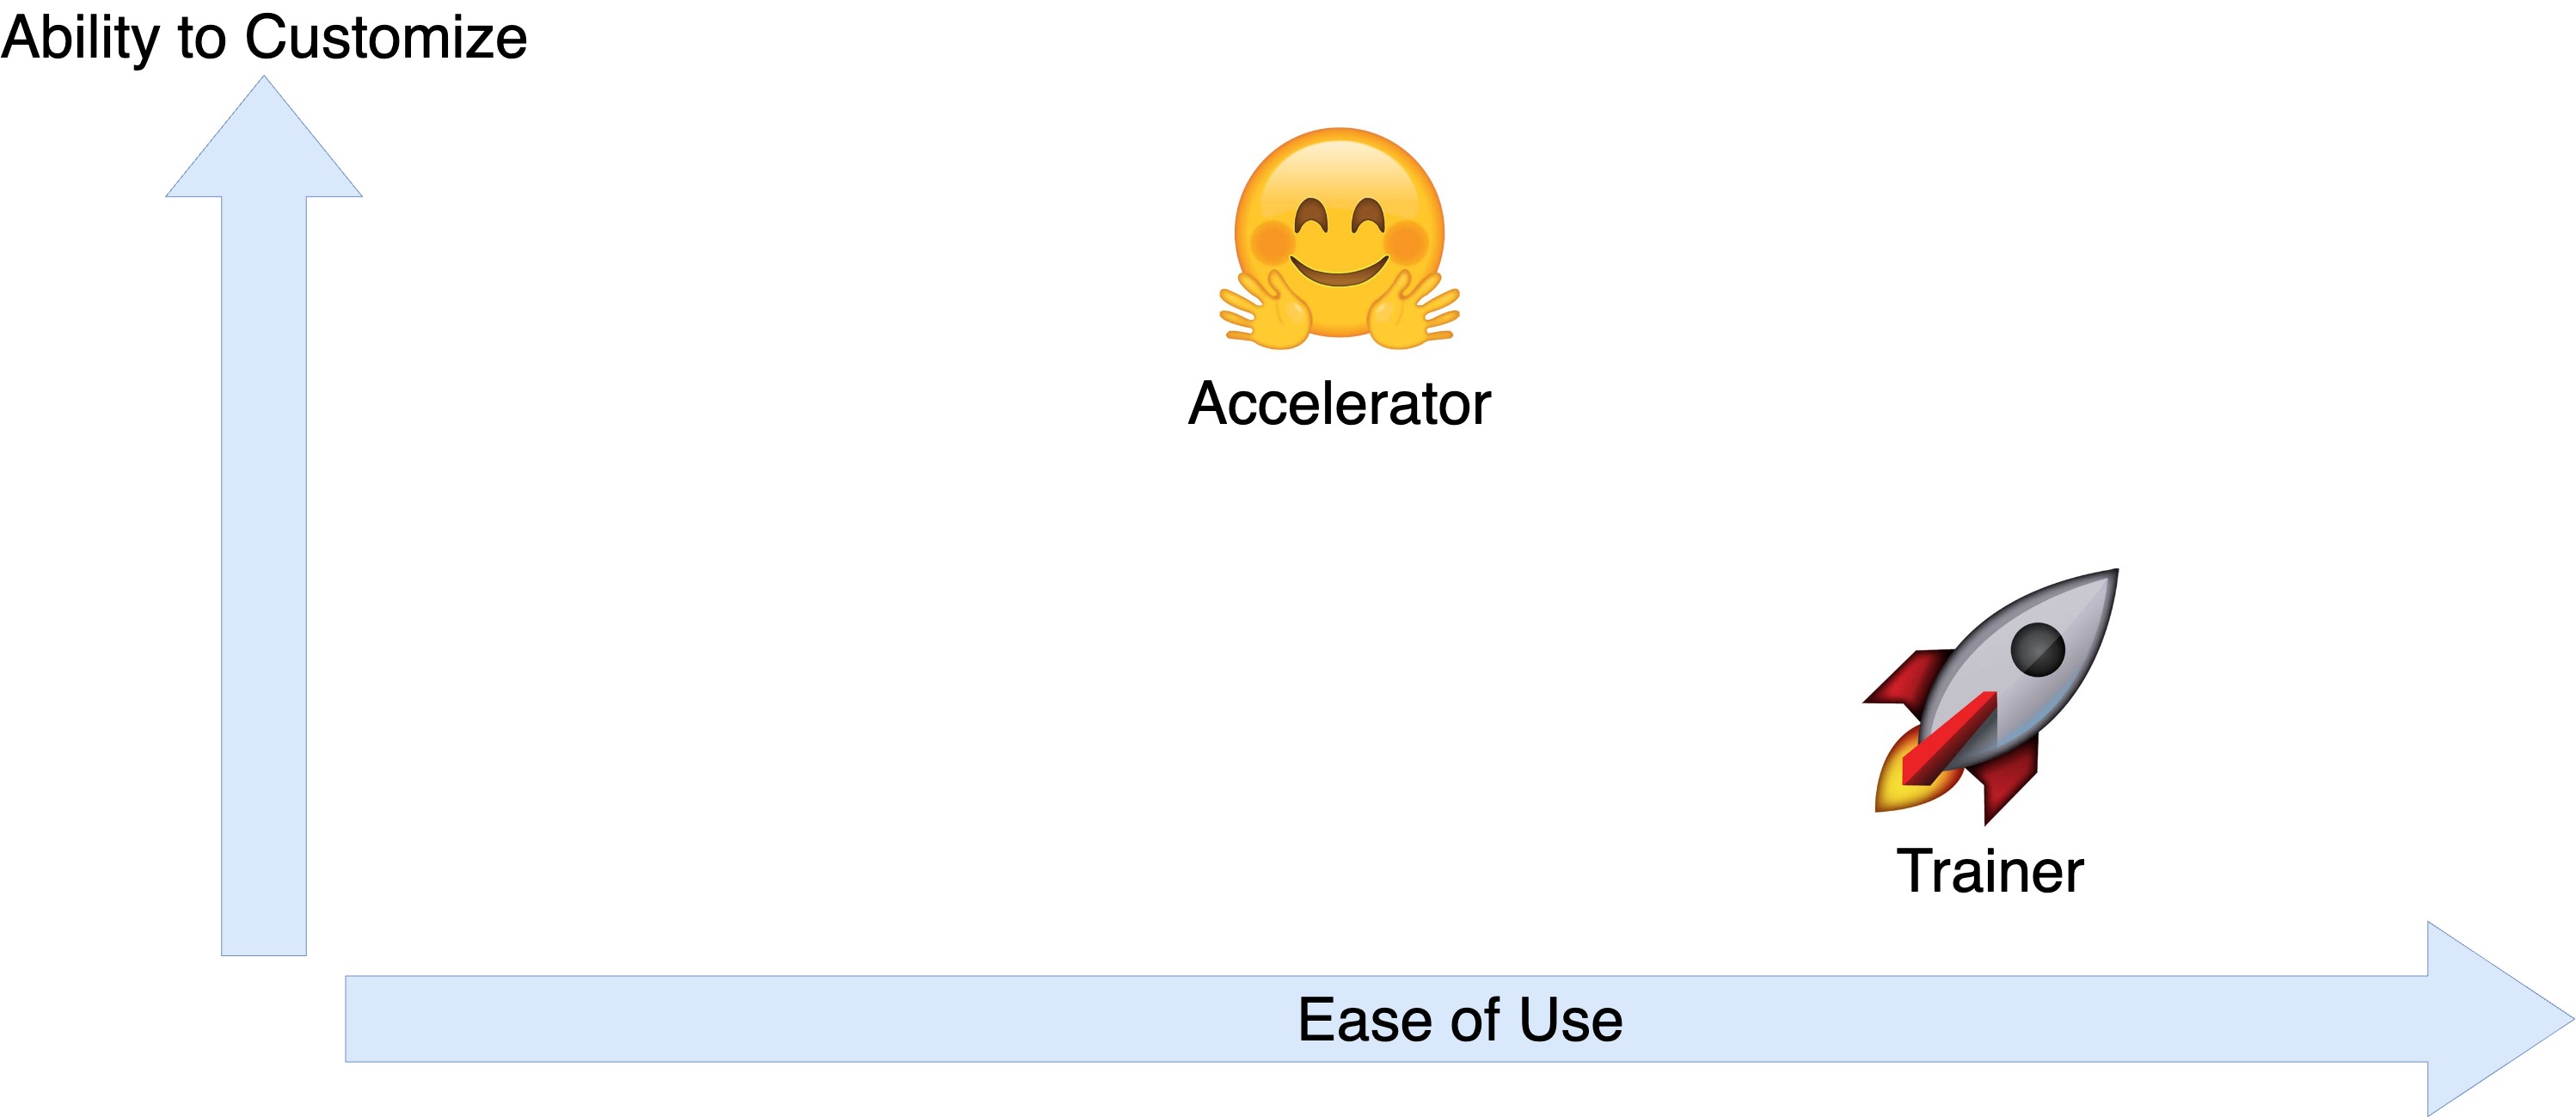
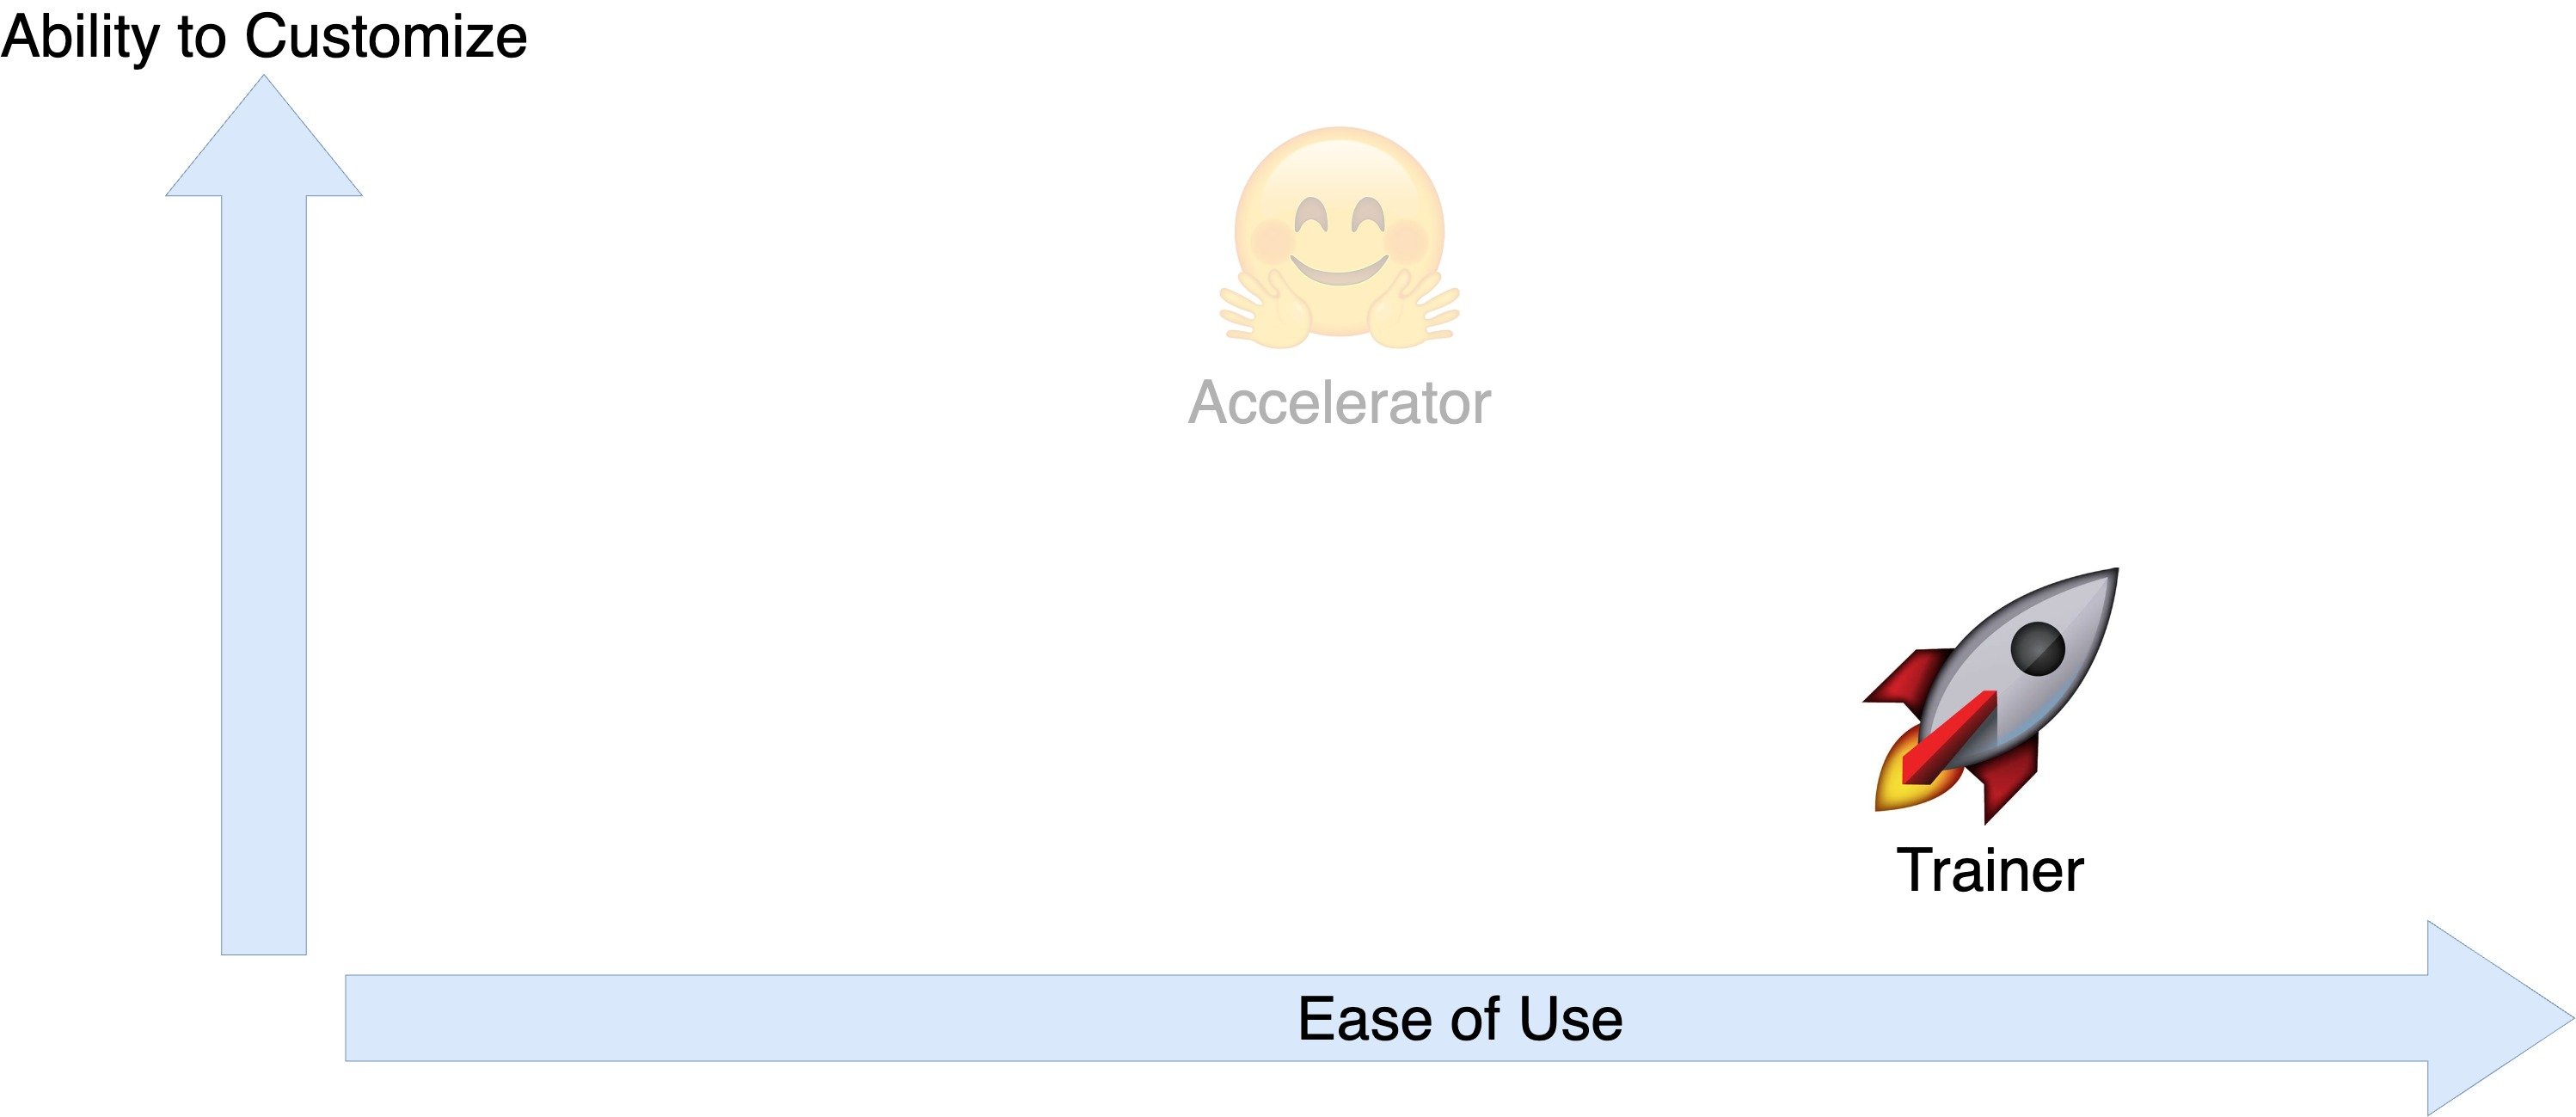
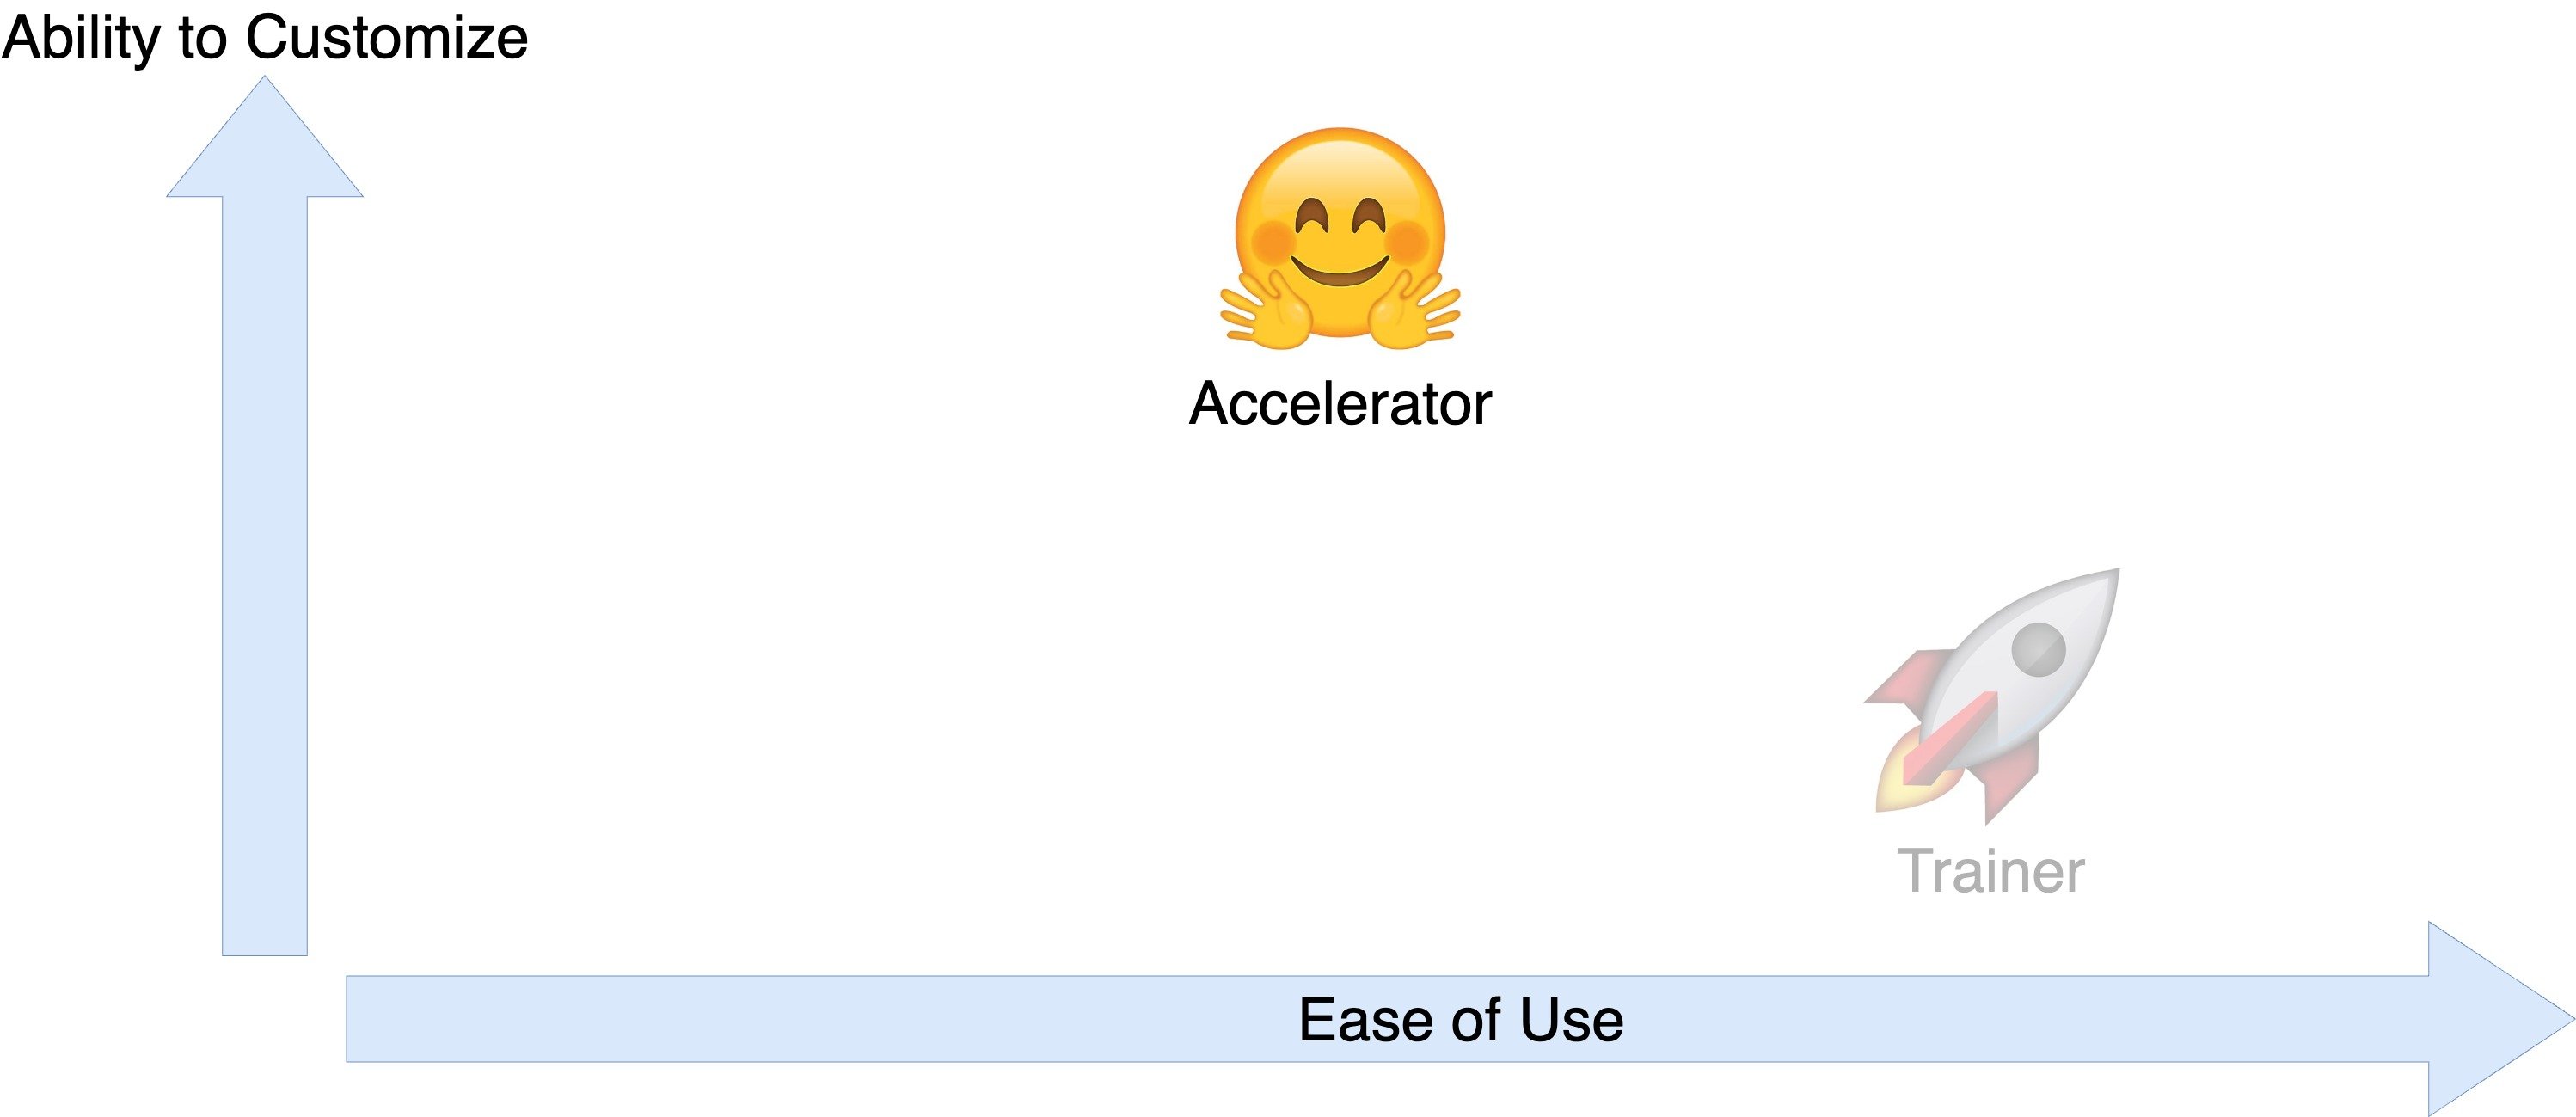
Trainer a Accelerator

Graf porovnávající snadnost použití a možnosti přizpůsobení pro Accelerator a Trainer.

Efficient AI Model Training with PyTorch

Trainer a Accelerator

Graf porovnávající snadnost použití a možnosti přizpůsobení pro Accelerator a Trainer.

Efficient AI Model Training with PyTorch

Gradient checkpointing s Trainerem

training_args = TrainingArguments(output_dir="./results",
                                  evaluation_strategy="epoch",
                                  gradient_accumulation_steps=4)


Efficient AI Model Training with PyTorch

Gradient checkpointing s Trainerem

training_args = TrainingArguments(output_dir="./results",
                                  evaluation_strategy="epoch",
                                  gradient_accumulation_steps=4,
                                  gradient_checkpointing=True)

trainer = Trainer(model=model, args=training_args, train_dataset=dataset["train"], eval_dataset=dataset["validation"], compute_metrics=compute_metrics)
trainer.train()
{'epoch': 1.0, 'eval_loss': 0.73, 'eval_accuracy': 0.03, 'eval_f1': 0.05}
Efficient AI Model Training with PyTorch

Z Traineru na Accelerator

Graf porovnávající snadnost použití a možnosti přizpůsobení pro Accelerator a Trainer.

Efficient AI Model Training with PyTorch

Gradient checkpointing s Acceleratorem

accelerator = Accelerator(gradient_accumulation_steps=2)


for index, batch in enumerate(dataloader):
    with accelerator.accumulate(model):
        inputs, targets = batch["input_ids"], batch["labels"]
        outputs = model(inputs, labels=targets)
        loss = outputs.loss
        accelerator.backward(loss)
        optimizer.step()
        lr_scheduler.step()
        optimizer.zero_grad()
Efficient AI Model Training with PyTorch

Gradient checkpointing s Acceleratorem

accelerator = Accelerator(gradient_accumulation_steps=2)
model.gradient_checkpointing_enable()

for index, batch in enumerate(dataloader):
    with accelerator.accumulate(model):
        inputs, targets = batch["input_ids"], batch["labels"]
        outputs = model(inputs, labels=targets)
        loss = outputs.loss
        accelerator.backward(loss)
        optimizer.step()
        lr_scheduler.step()
        optimizer.zero_grad()
Efficient AI Model Training with PyTorch

Lokální SGD zlepšuje komunikační efektivitu


Ikony znázorňující paměťovou, komunikační a výpočetní efektivitu.

Efficient AI Model Training with PyTorch

Co je lokální SGD?

Diagram znázorňující fungování lokálního SGD se synchronizací gradientů po určitém počtu kroků.

  • Každé zařízení počítá gradienty paralelně
Efficient AI Model Training with PyTorch

Co je lokální SGD?

Diagram znázorňující fungování lokálního SGD se synchronizací gradientů po určitém počtu kroků.

  • Každé zařízení počítá gradienty paralelně
  • Synchronizace gradientů: řídicí uzel aktualizuje parametry modelu na každém zařízení
  • Lokální SGD: snížení frekvence synchronizace gradientů
Efficient AI Model Training with PyTorch

Lokální SGD s Acceleratorem


for index, batch in enumerate(dataloader):
    with accelerator.accumulate(model):
        inputs, targets = batch["input_ids"], batch["labels"]
        outputs = model(inputs, labels=targets)
        loss = outputs.loss
        accelerator.backward(loss)
        optimizer.step()
        lr_scheduler.step()
        optimizer.zero_grad()

Efficient AI Model Training with PyTorch

Lokální SGD s Acceleratorem

from accelerate.local_sgd import LocalSGD

with LocalSGD(accelerator=accelerator, model=model, local_sgd_steps=8, 
              enabled=True) as local_sgd:
    for index, batch in enumerate(dataloader):
        with accelerator.accumulate(model):
            inputs, targets = batch["input_ids"], batch["labels"]
            outputs = model(inputs, labels=targets)
            loss = outputs.loss
            accelerator.backward(loss)
            optimizer.step()
            lr_scheduler.step()
            optimizer.zero_grad()
            local_sgd.step()
Efficient AI Model Training with PyTorch

Pojďme si procvičit!

Efficient AI Model Training with PyTorch

Preparing Video For Download...