Ajuster les modèles avec Trainer

Entraînement efficace de modèles d’IA avec PyTorch

Dennis Lee

Data Engineer, Amazon

Préparation des données
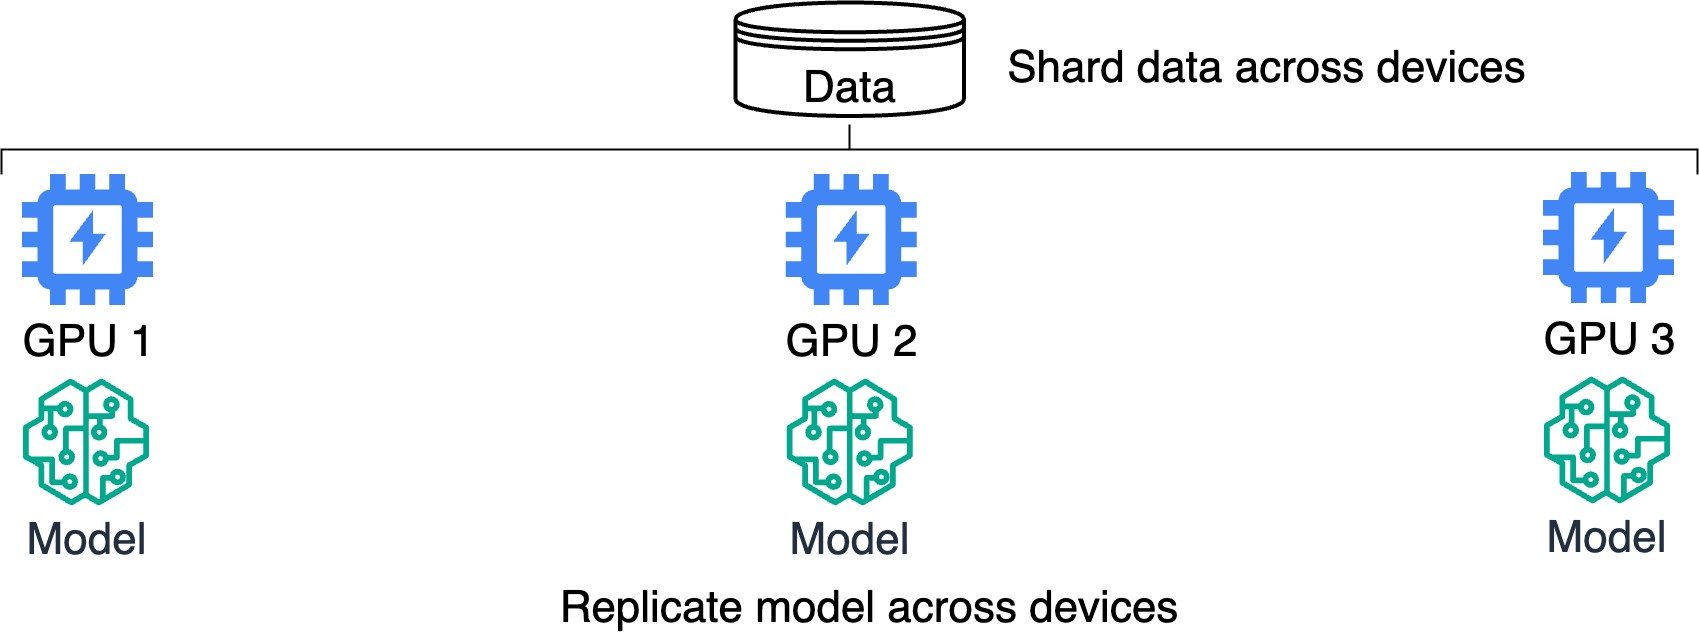
 

Schéma d'entraînement distribué montrant la réplication du modèle et le partitionnement des données.

Entraînement efficace de modèles d’IA avec PyTorch

Entraînement distribué


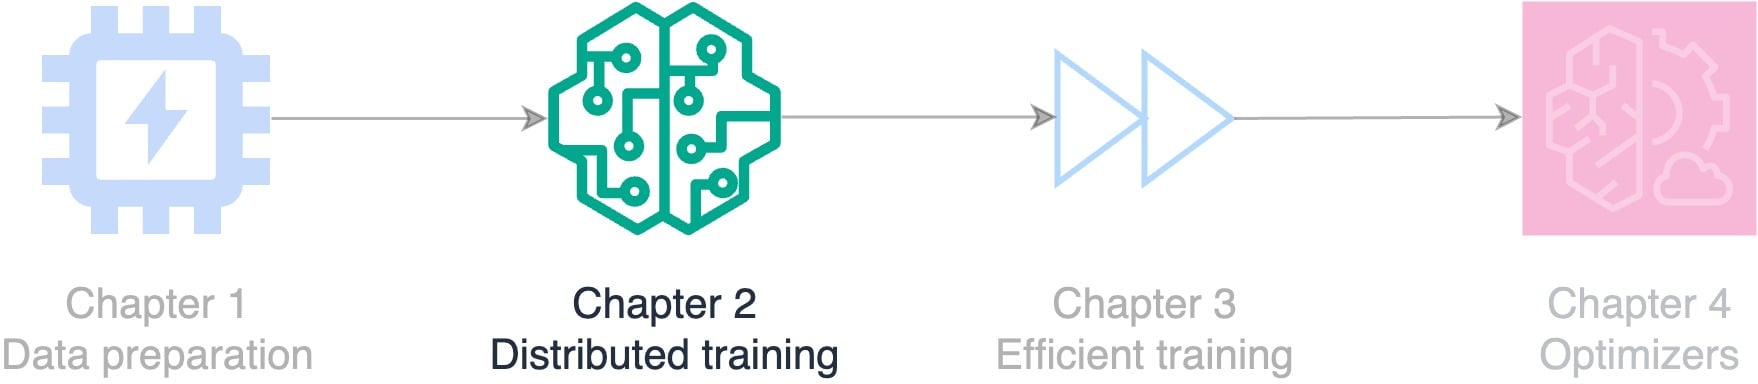
Organigramme illustrant les thèmes du cours : préparation des données, entraînement distribué, entraînement efficace et optimiseurs.

Entraînement efficace de modèles d’IA avec PyTorch

Trainer et Accelerator

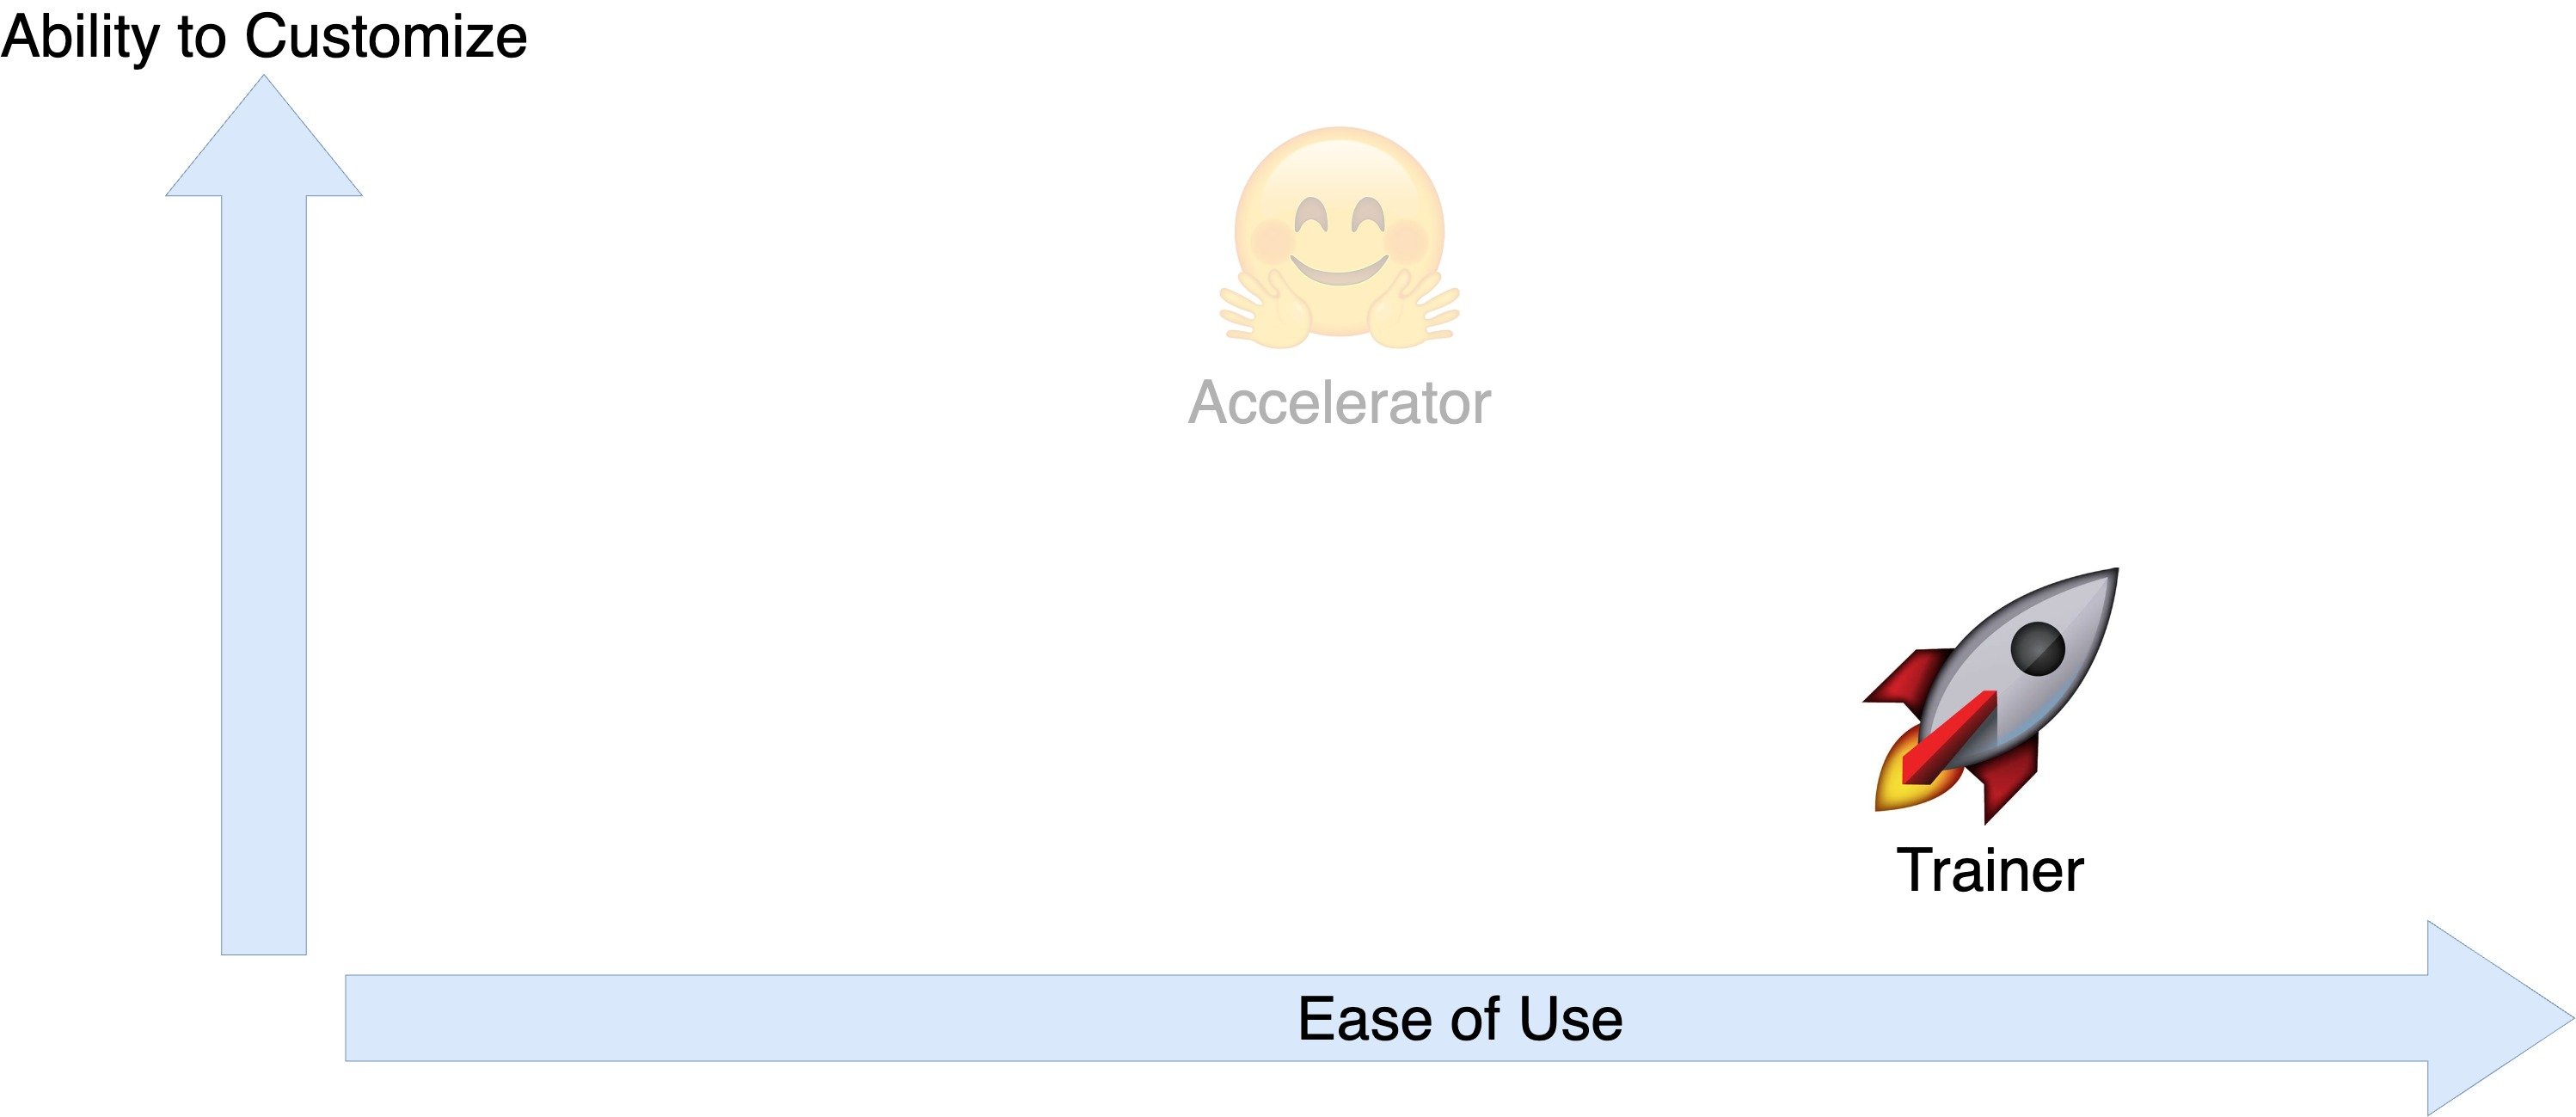
Graphique comparant la facilité d'utilisation et la capacité de personnalisation pour Accelerator et Trainer.

Entraînement efficace de modèles d’IA avec PyTorch

Trainer et Accelerator

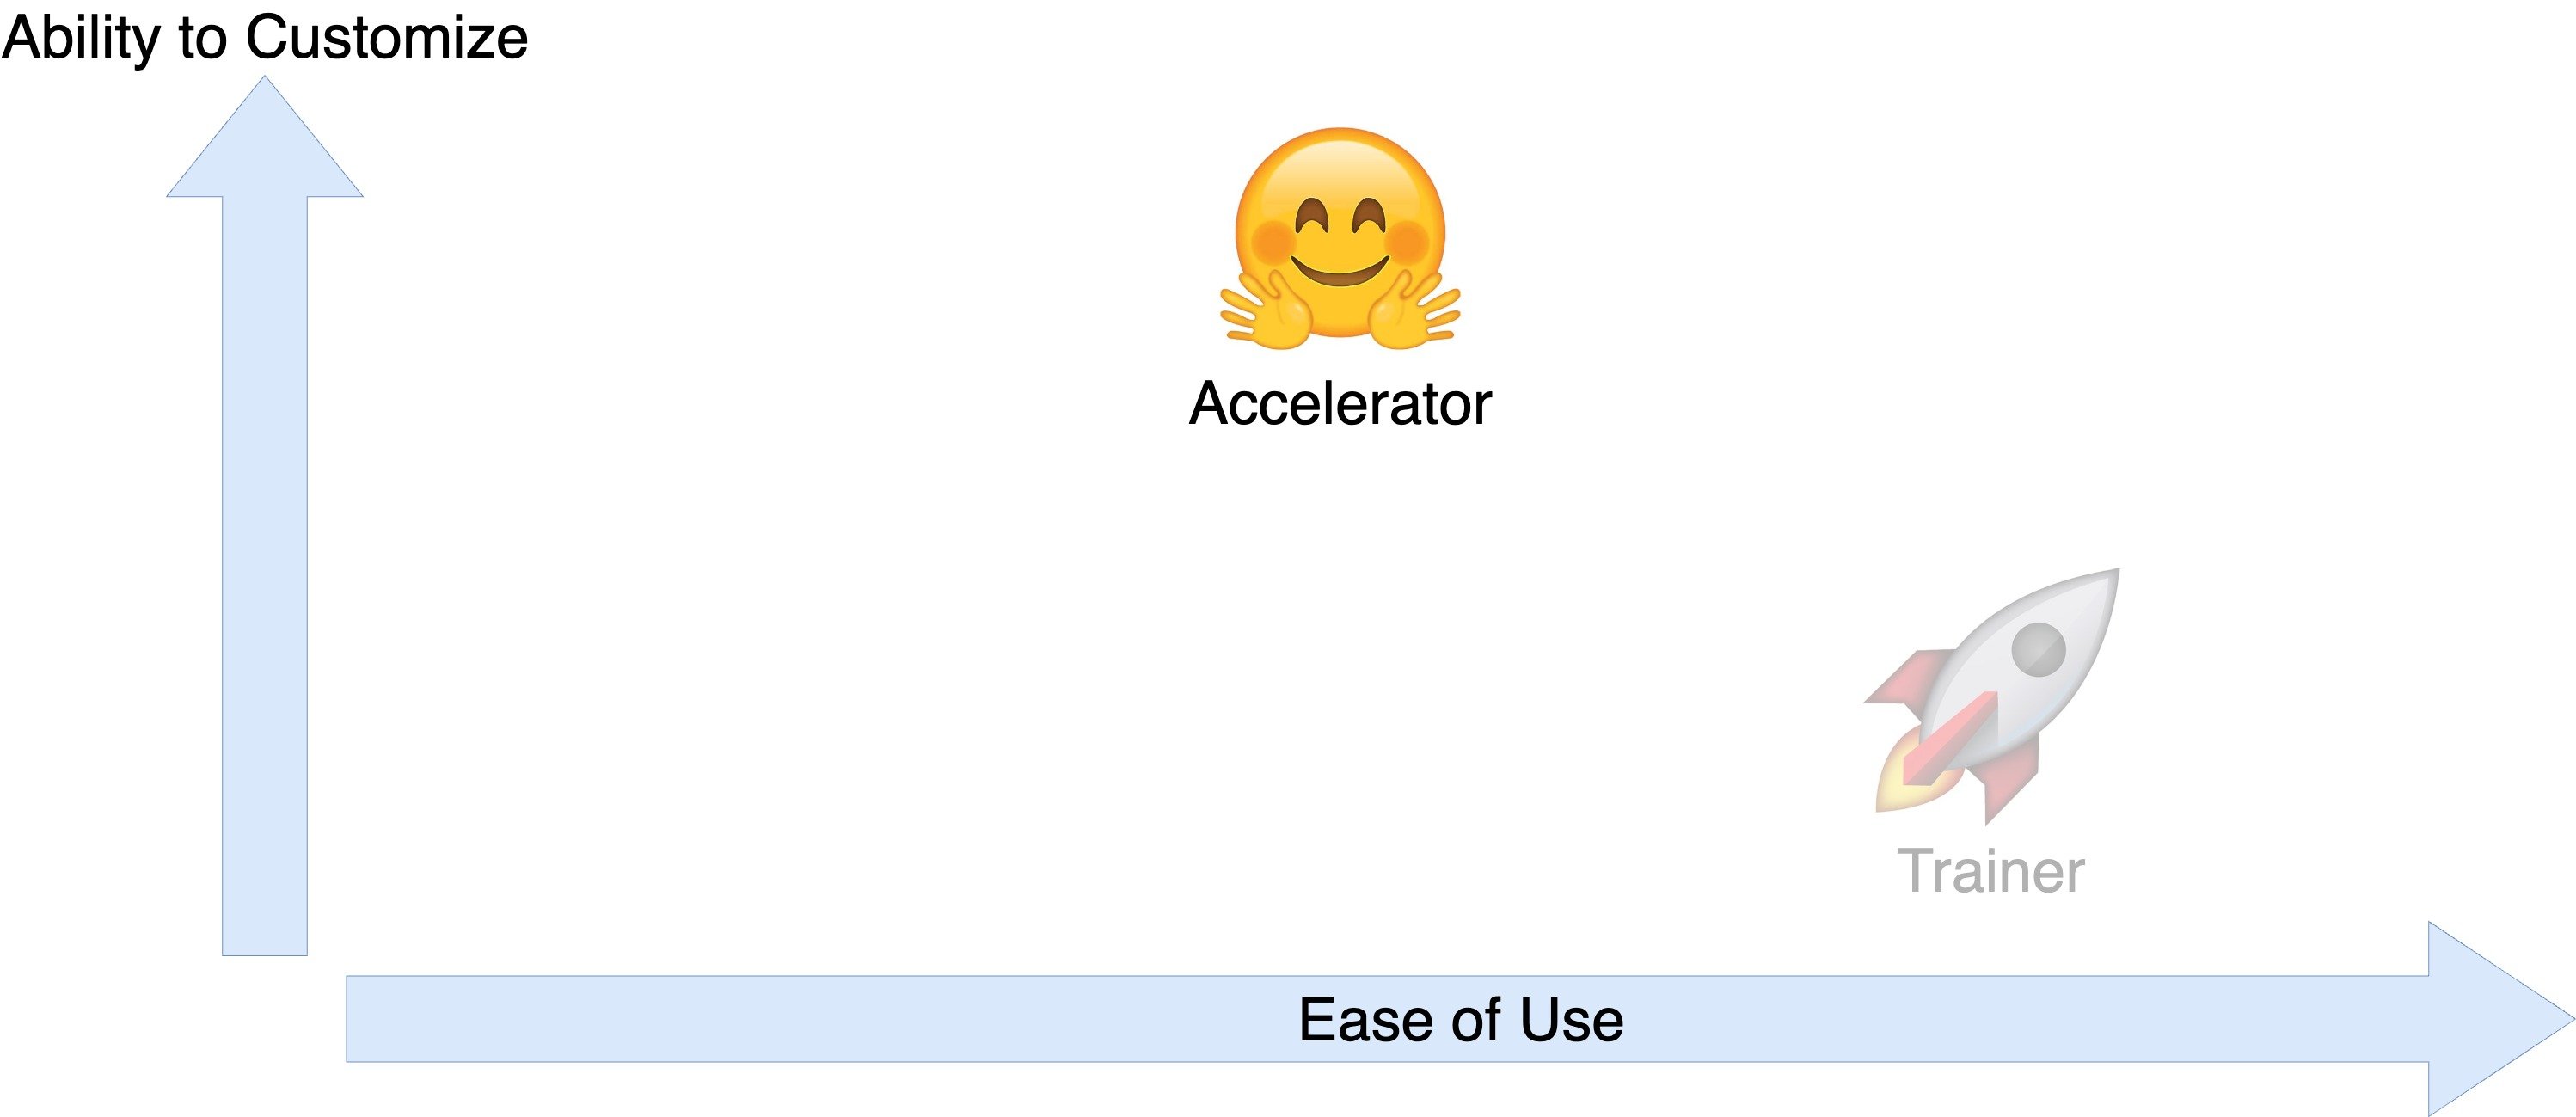
Graphique comparant la facilité d'utilisation et la capacité de personnalisation pour Accelerator et Trainer.

Entraînement efficace de modèles d’IA avec PyTorch

Booster l'entraînement avec Trainer

  • Bibliothèque Trainer

    from transformers import Trainer
    
  • Exécuter le modèle sur chaque appareil en parallèle

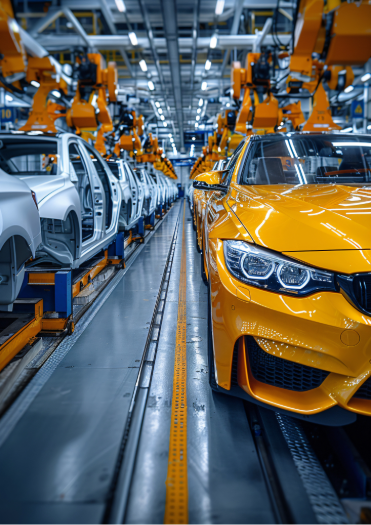
  • Accélérer l'entraînement, comme une chaîne de montage
  • Vérifier les entrées : jeu de données, modèle, métriques
  • Développer une analyse de sentiment pour le commerce en ligne

Image de fabrication de voitures sur des chaînes de montage, illustrant le traitement parallèle.

Entraînement efficace de modèles d’IA avec PyTorch

Jeu de données d'avis produit (sentiment)

print(dataset)
DatasetDict({
    train: Dataset({
        features: ['Text', 'Label'],
        num_rows: 1000
    }), ...})
print(f'"{dataset["train"]["Text"][0]}": {dataset["train"]["Label"][0]}')
"I love this product!": positive
Entraînement efficace de modèles d’IA avec PyTorch

Convertir les étiquettes en entiers

def map_labels(example):
    if example["Label"] == "negative":
        return {"labels": 0}

else: return {"labels": 1} dataset = dataset.map(map_labels)
print(f'First label: {dataset["train"]["labels"][0]}')
First label: 1
Entraînement efficace de modèles d’IA avec PyTorch

Définir le tokenizer et le modèle

  • Charger un modèle et un tokenizer préentraînés :
model = AutoModelForSequenceClassification.from_pretrained("distilbert-base-uncased", 
                                                           num_labels=2)

tokenizer = AutoTokenizer.from_pretrained("distilbert-base-uncased")
  • Appliquer le tokenizer au champ text :
def encode(examples):

return tokenizer(examples["Text"], padding="max_length", truncation=True, return_tensors="pt")
dataset = dataset.map(encode, batched=True)
print(f'The first tokenized review is {dataset["train"]["input_ids"][0]}.')
The first tokenized review is [101, 1045, 2293, 2023, 4031, 999, 102].
Entraînement efficace de modèles d’IA avec PyTorch

Définir les métriques d'évaluation

import evaluate


def compute_metrics(eval_predictions):
load_accuracy = evaluate.load("accuracy") load_f1 = evaluate.load("f1")
logits, labels = eval_predictions
predictions = np.argmax(logits, axis=-1)
accuracy = load_accuracy.compute(predictions=predictions, references=labels)[ "accuracy" ]
f1 = load_f1.compute(predictions=predictions, references=labels)["f1"]
return {"accuracy": accuracy, "f1": f1}
Entraînement efficace de modèles d’IA avec PyTorch

Paramètres d'entraînement

  • output_dir : où enregistrer le modèle
  • Spécifier les hyperparamètres (p. ex., learning_rate et weight_decay)
  • save_strategy : enregistrer après chaque époque
  • evaluation_strategy : évaluer après chaque époque
from transformers import (
    TrainingArguments)

training_args = TrainingArguments(
    output_dir="output_folder",

learning_rate=2e-5, per_device_train_batch_size=16, per_device_eval_batch_size=16, num_train_epochs=2, weight_decay=0.01,
save_strategy="epoch", evaluation_strategy="epoch", )
Entraînement efficace de modèles d’IA avec PyTorch

Configurer Trainer

from transformers import Trainer

trainer = Trainer(model=model,

args=training_args,
train_dataset=dataset["train"], eval_dataset=dataset["validation"],
compute_metrics=compute_metrics)
trainer.train()
{'epoch': 1.0, 'eval_loss': 0.79, 'eval_accuracy': 0.00, 'eval_f1': 0.00}
{'epoch': 2.0, 'eval_loss': 0.65, 'eval_accuracy': 0.11, 'eval_f1': 0.15}
print(trainer.args.device)
cpu
Entraînement efficace de modèles d’IA avec PyTorch

Analyse de sentiment pour le commerce en ligne

sample_review = "This product is amazing!"

input_ids = tokenizer.encode(sample_review, return_tensors='pt') print(f"Tokenized review: {input_ids}")
Tokenized review: tensor([[ 101, 2023, 4031, 2003, 6429,  999,  102 ]])
Entraînement efficace de modèles d’IA avec PyTorch

Analyse de sentiment pour le commerce en ligne

output = model(input_ids)
print(f"Output logits: {output.logits}")
Output logits: tensor([[ -0.0538, 0.1300 ]])
predicted_label = torch.argmax(output.logits, dim=1).item()
print(f"Predicted label: {predicted_label}")
Predicted label: 1
sentiment = "Negative" if predicted_label == 0 else "Positive"
print(f'The sentiment of the product review is "{sentiment}."')
The sentiment of the product review is "Positive."
Entraînement efficace de modèles d’IA avec PyTorch

Points de contrôle avec Trainer

  • Reprendre depuis le dernier point de contrôle, comme mettre un film sur pause
trainer.train(resume_from_checkpoint=True)
{'epoch': 3.0, 'eval_loss': 0.29, 'eval_accuracy': 0.37, 'eval_f1': 0.51}
{'epoch': 4.0, 'eval_loss': 0.23, 'eval_accuracy': 0.46, 'eval_f1': 0.58}
  • Reprendre depuis un point précis enregistré dans le répertoire de sortie
trainer.train(resume_from_checkpoint="model/checkpoint-1000")
Entraînement efficace de modèles d’IA avec PyTorch

Passons à la pratique !

Entraînement efficace de modèles d’IA avec PyTorch

Preparing Video For Download...