Entraînement en précision mixte avec Adam 8 bits

Entraînement efficace de modèles d’IA avec PyTorch

Dennis Lee

Data Engineer, Amazon

Optimiseurs pour une formation efficace
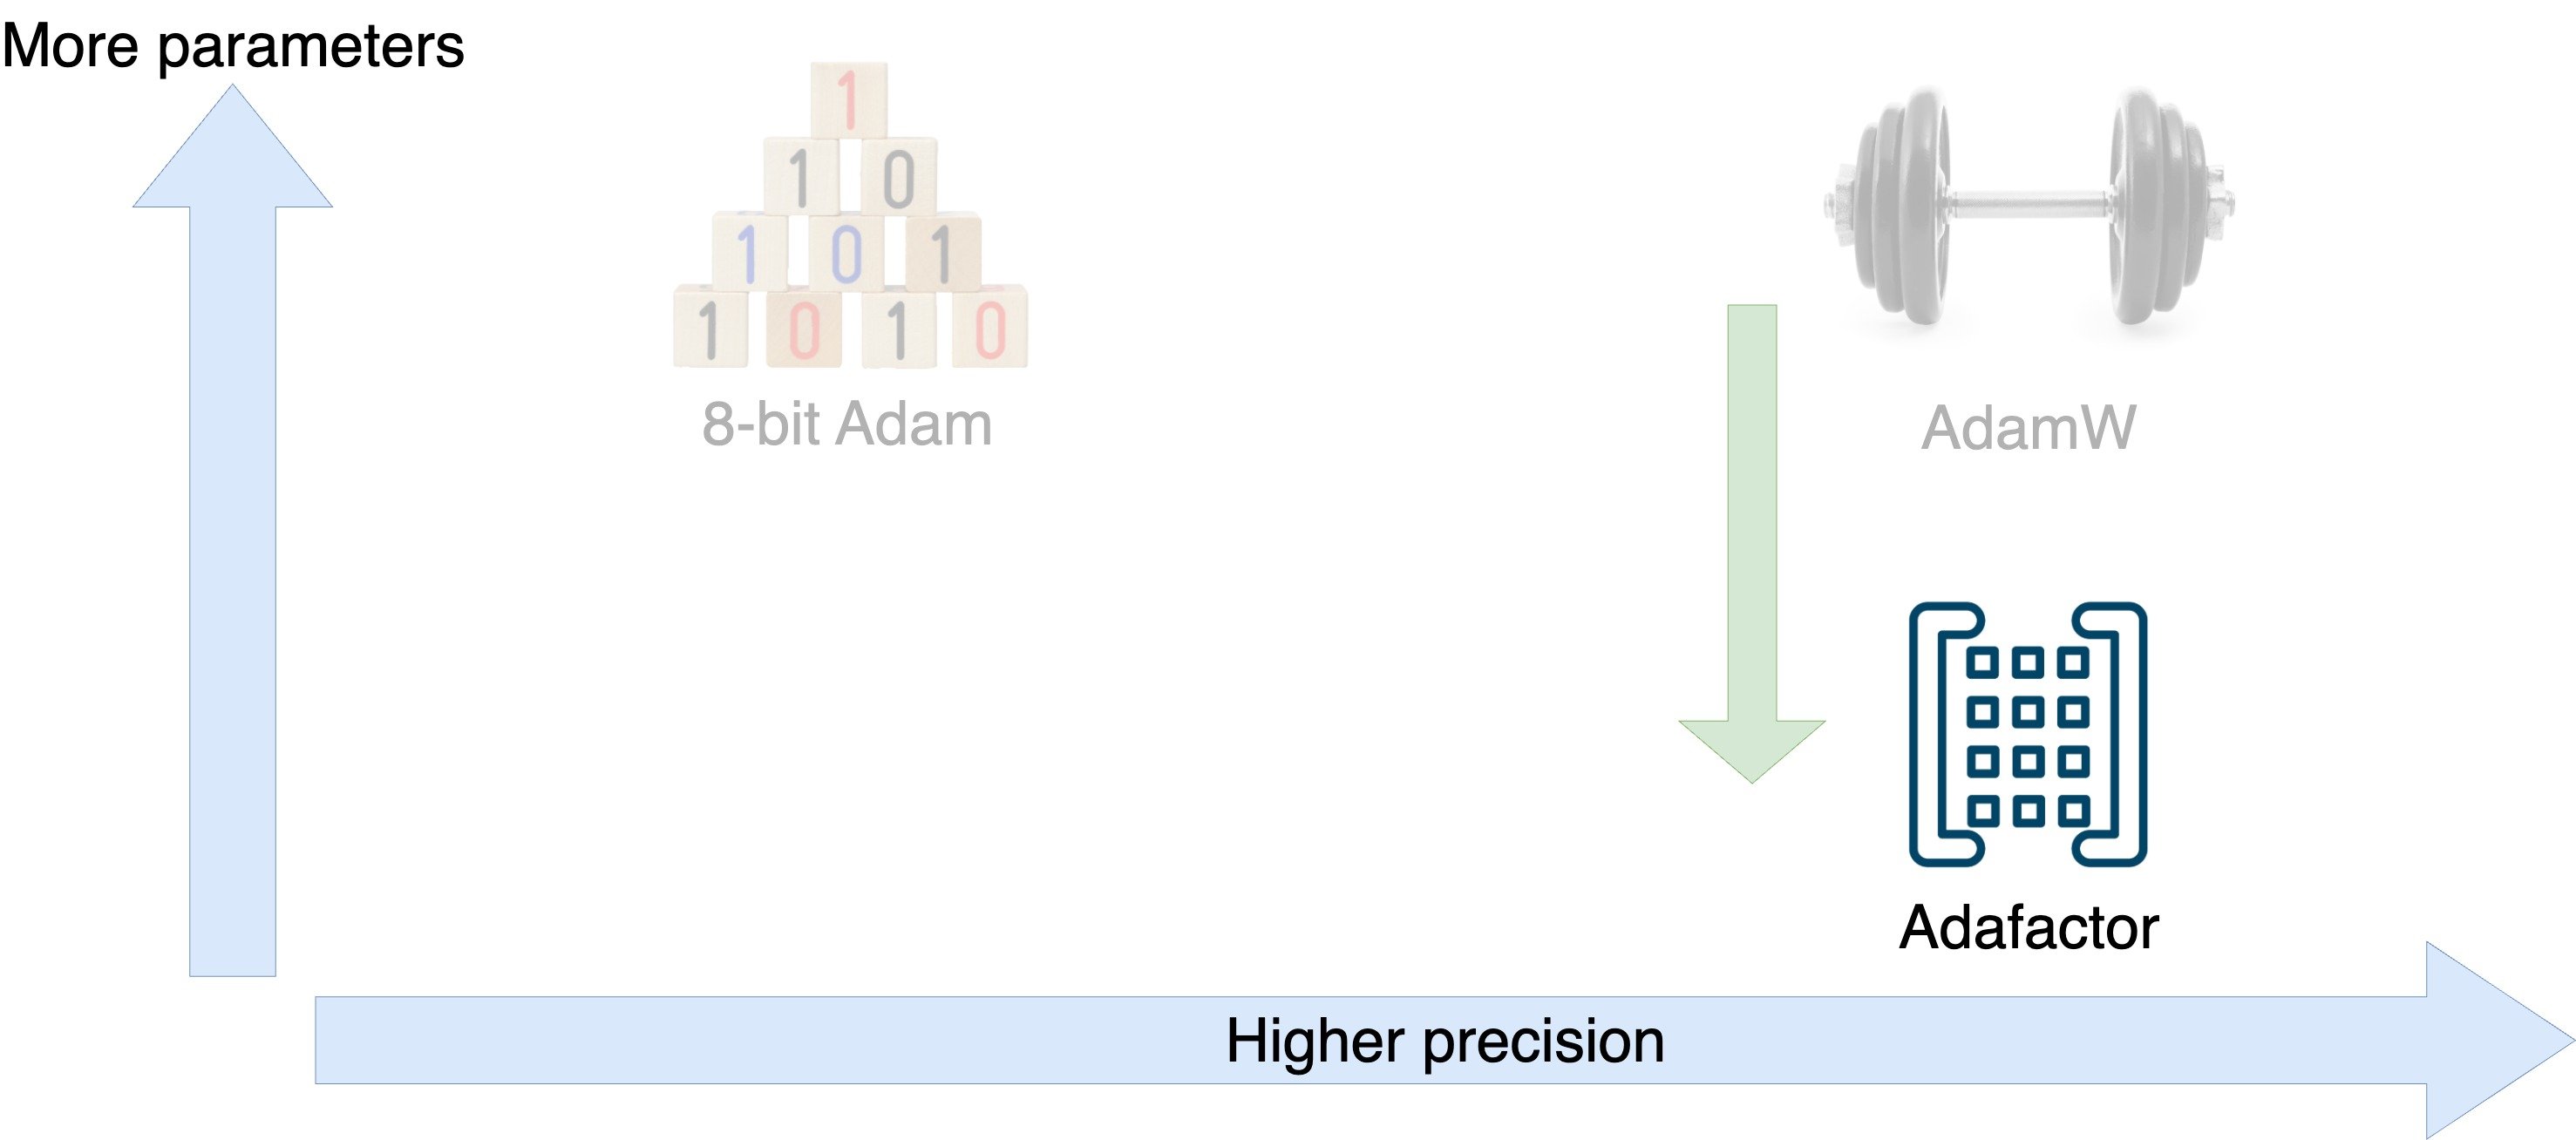
Schéma des compromis entre nombre de paramètres et précision pour AdamW, Adafactor et Adam 8 bits.

Entraînement efficace de modèles d’IA avec PyTorch

Optimiseurs pour une formation efficace
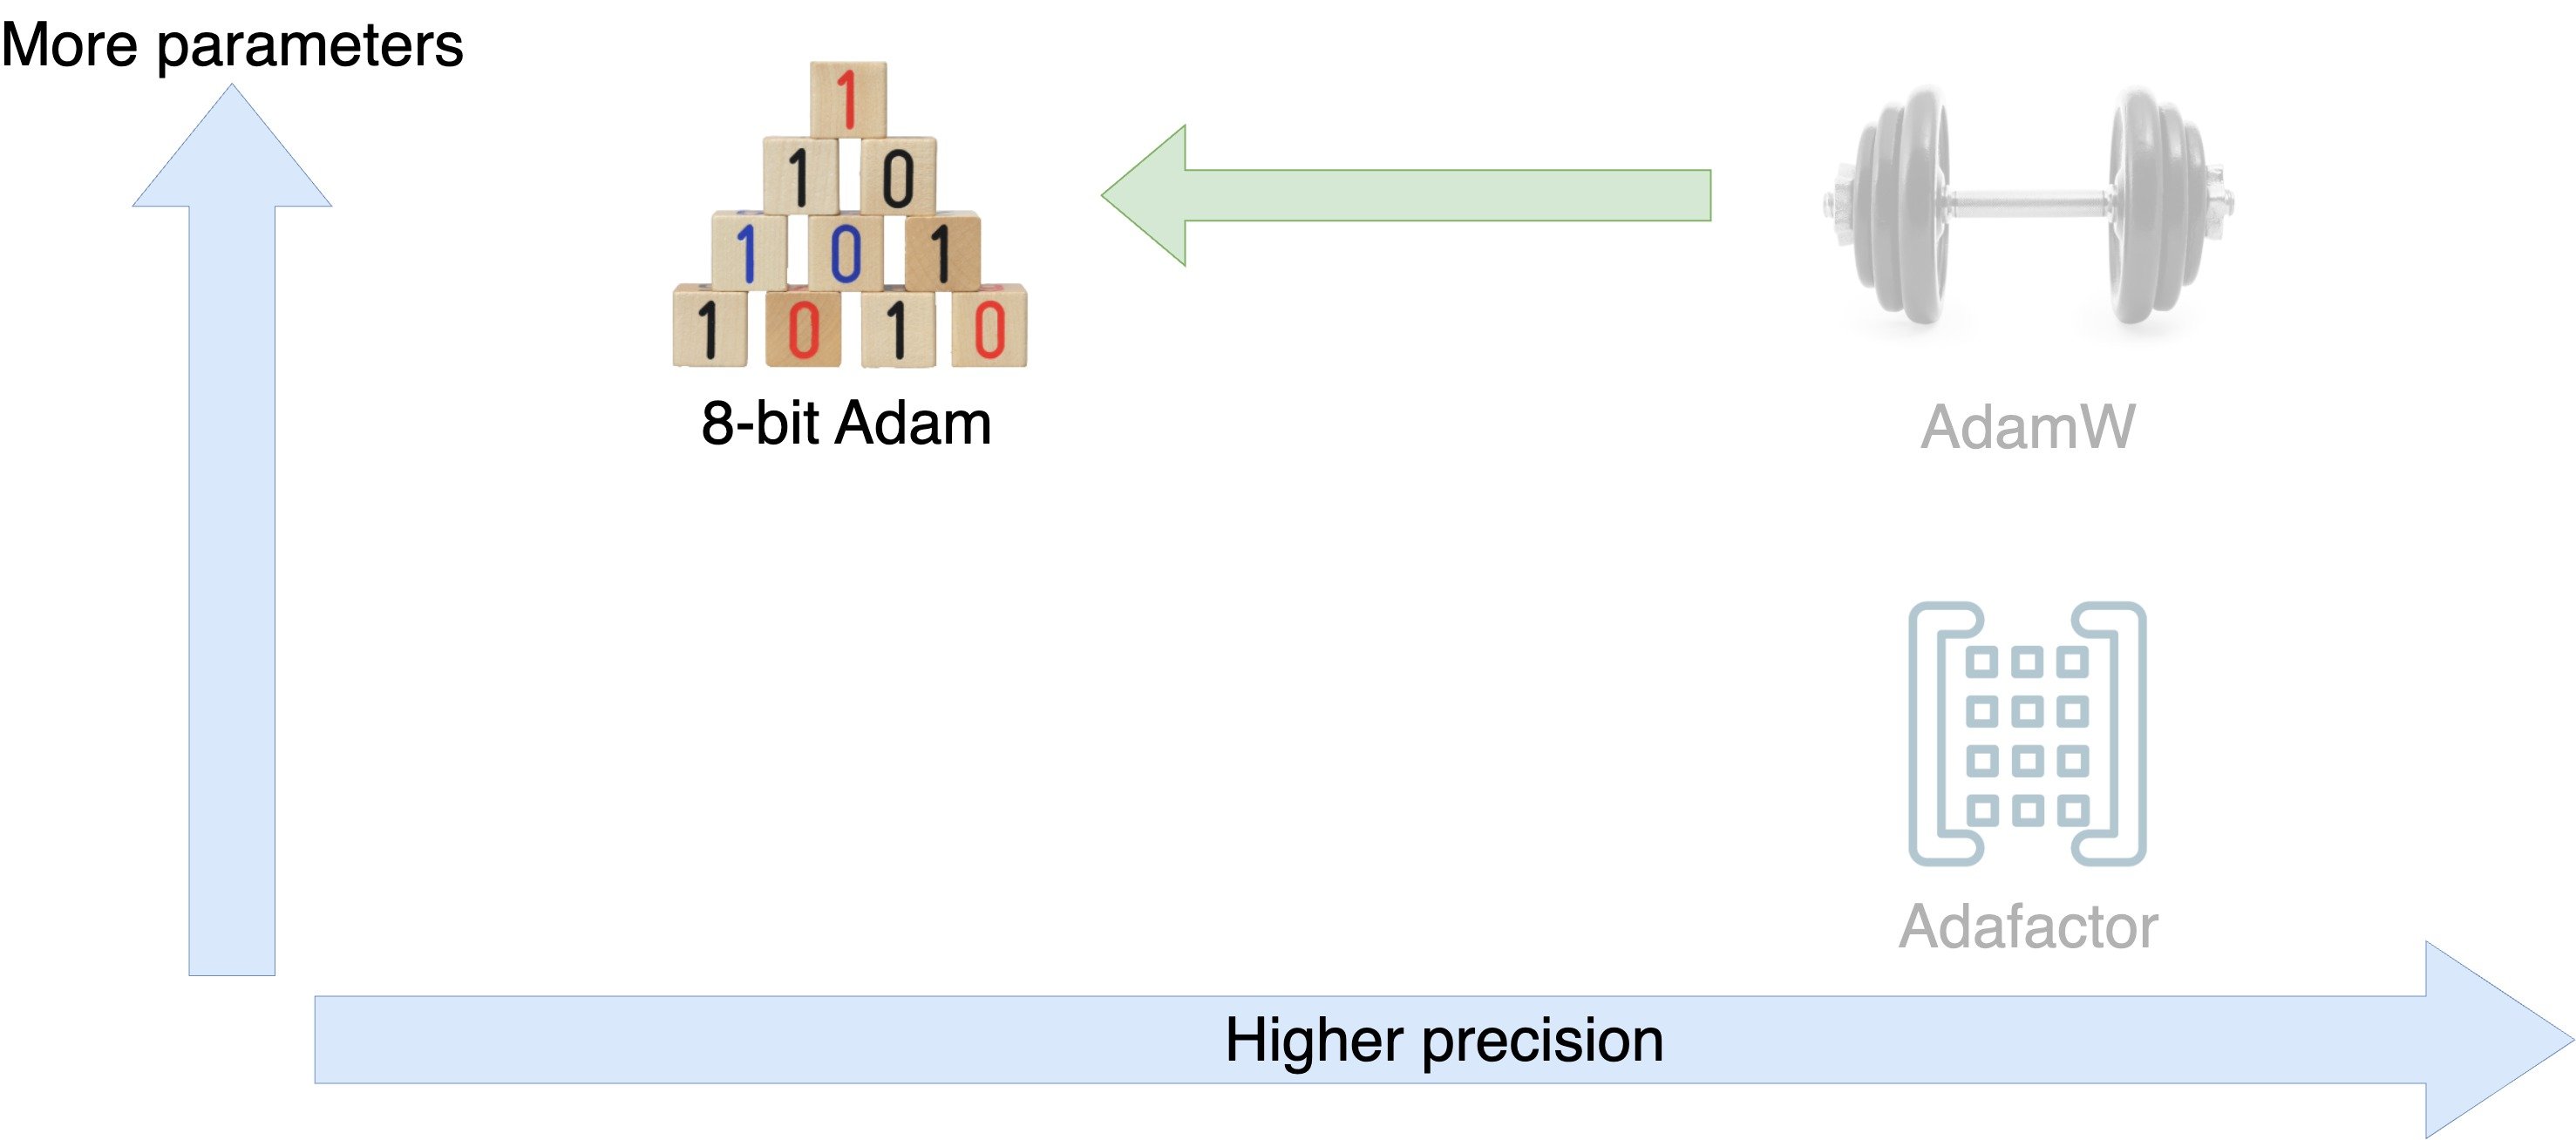
Schéma des compromis entre nombre de paramètres et précision pour AdamW, Adafactor et Adam 8 bits.

Entraînement efficace de modèles d’IA avec PyTorch

Comment fonctionne Adam 8 bits?

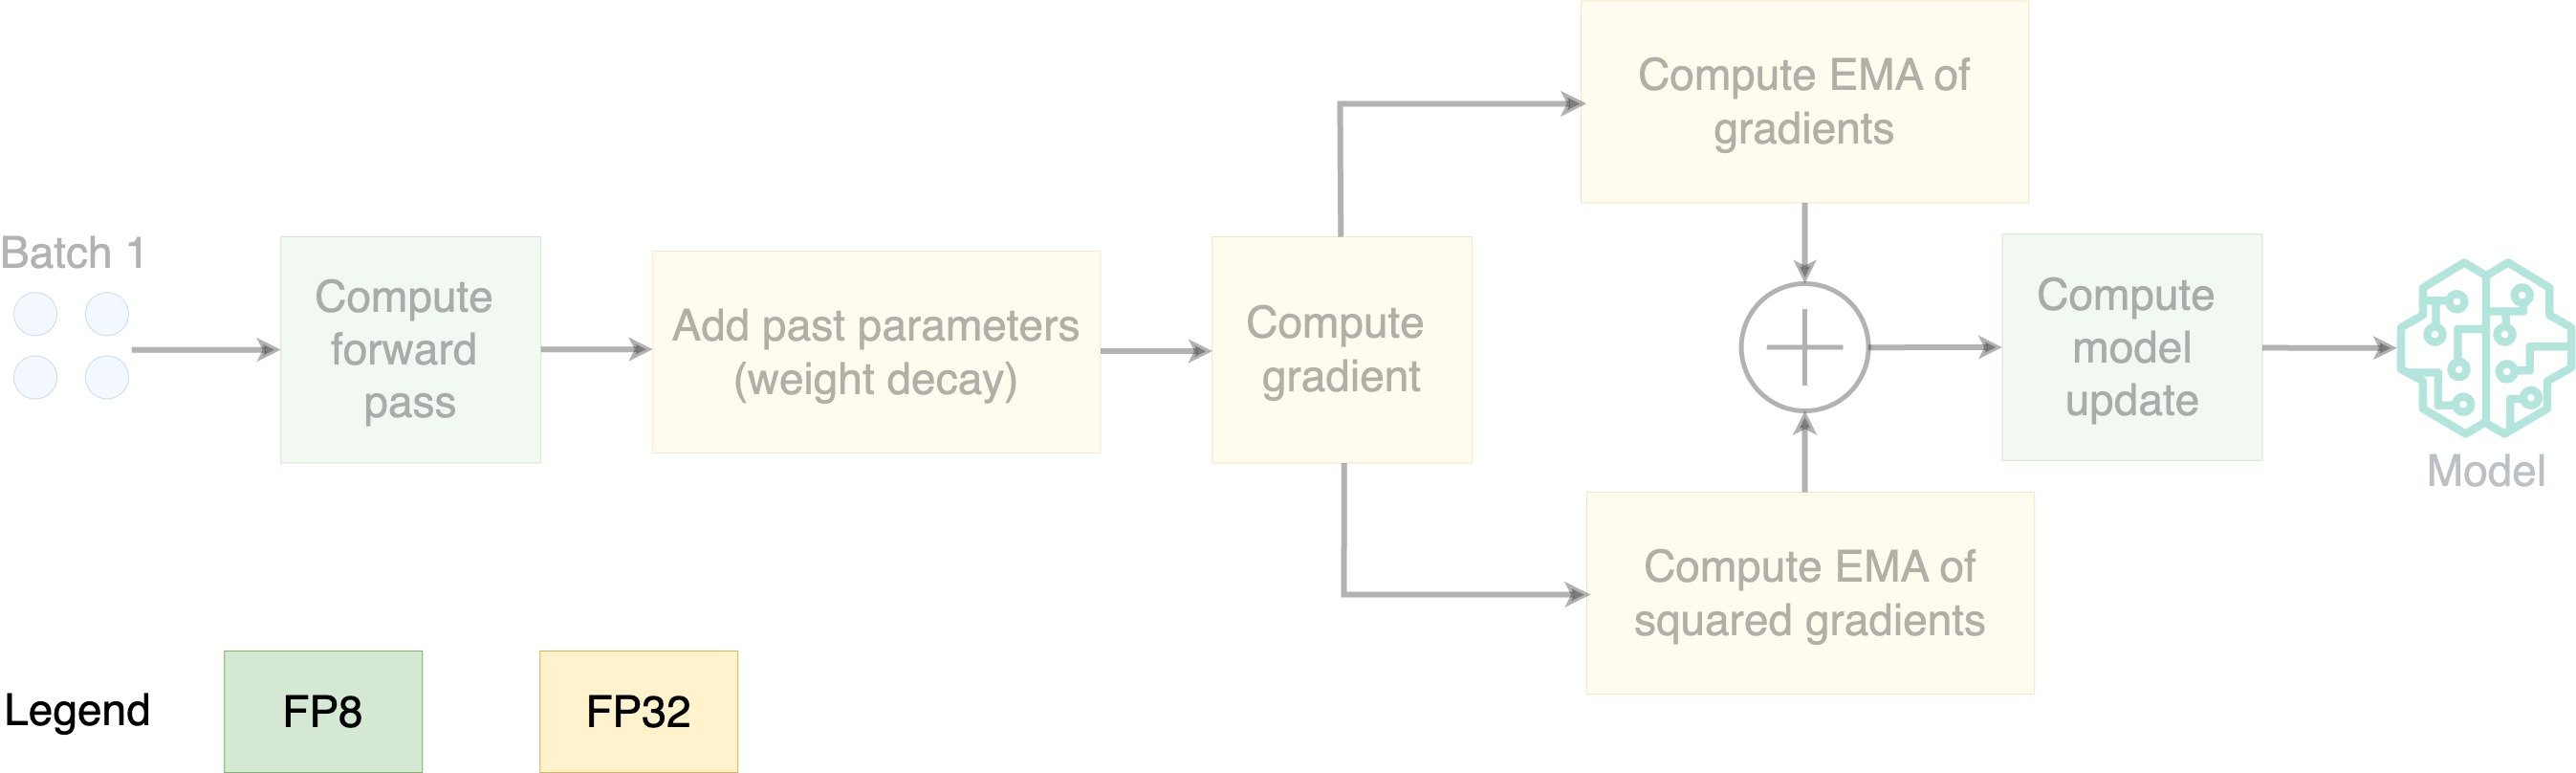
Schéma des étapes d’Adam 8 bits.

  • Stocker les paramètres en FP8; optimiser en FP32
Entraînement efficace de modèles d’IA avec PyTorch

Comment fonctionne Adam 8 bits?

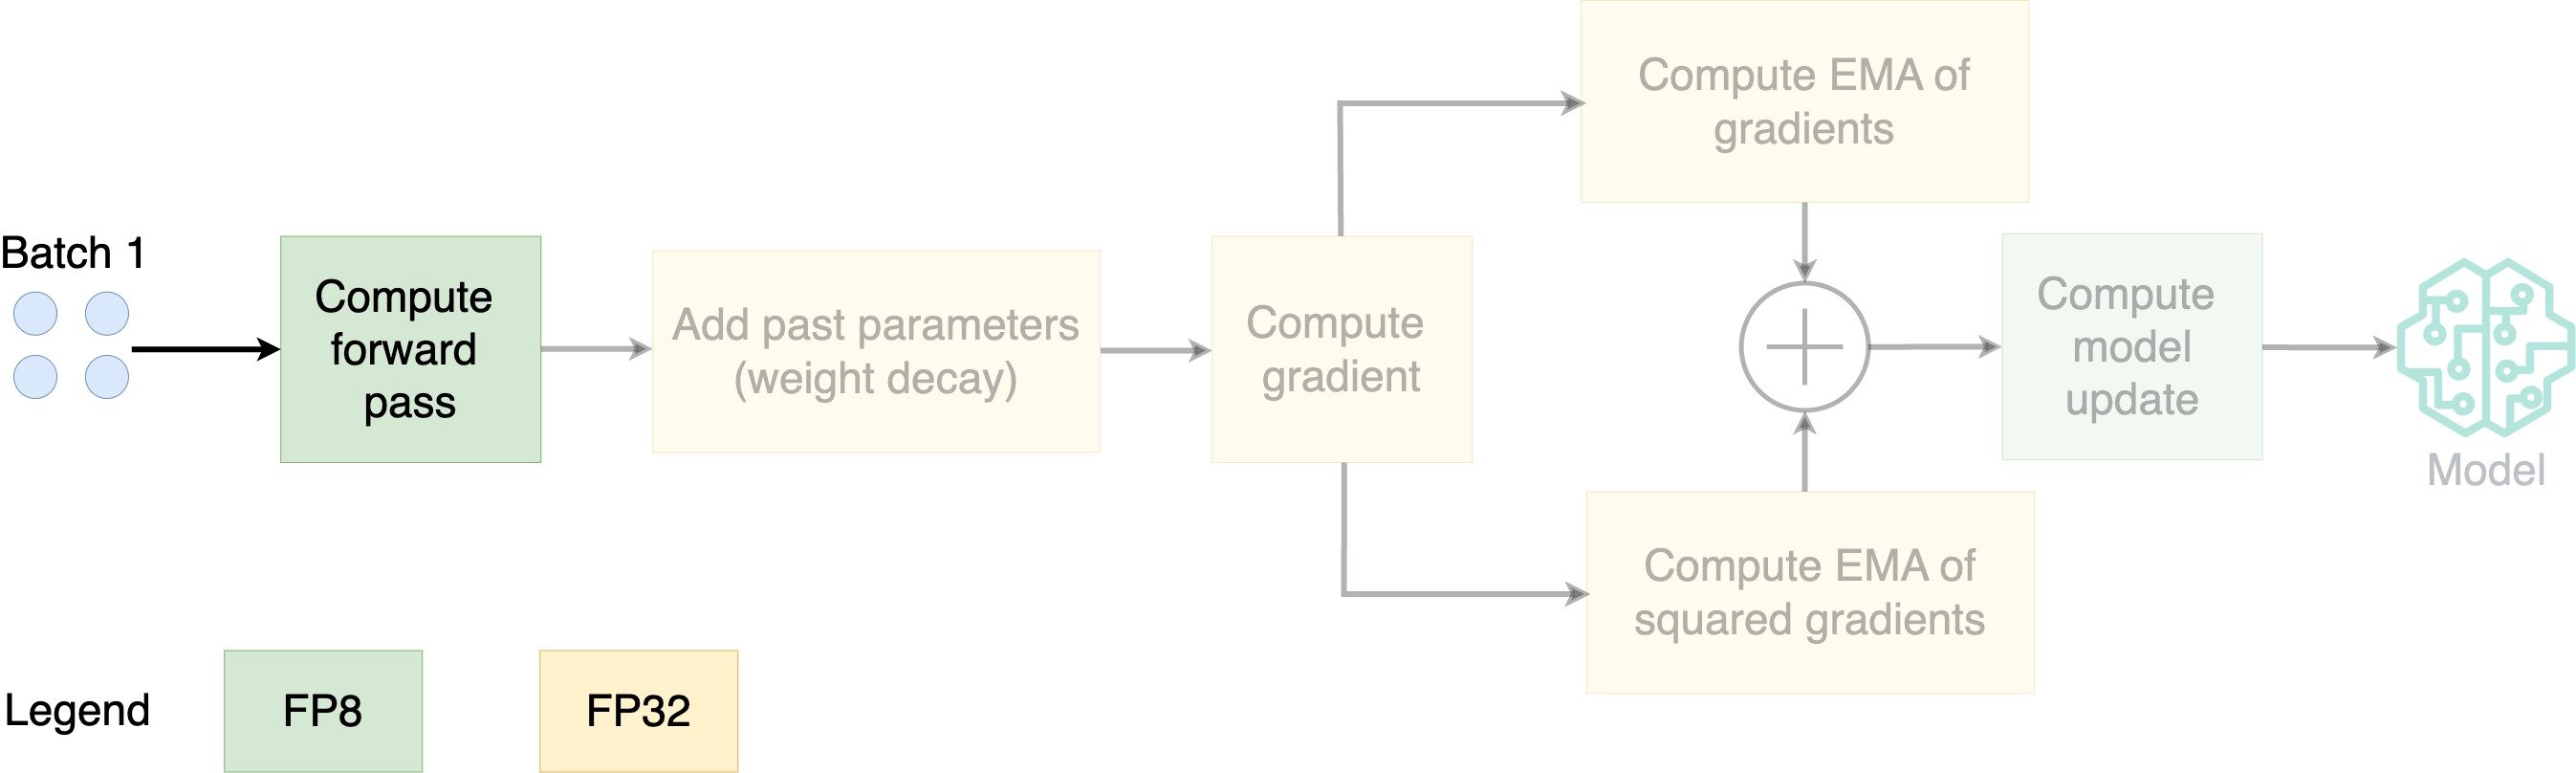
Schéma des étapes d’Adam 8 bits.

  • Stocker les paramètres en FP8; optimiser en FP32
Entraînement efficace de modèles d’IA avec PyTorch

Comment fonctionne Adam 8 bits?

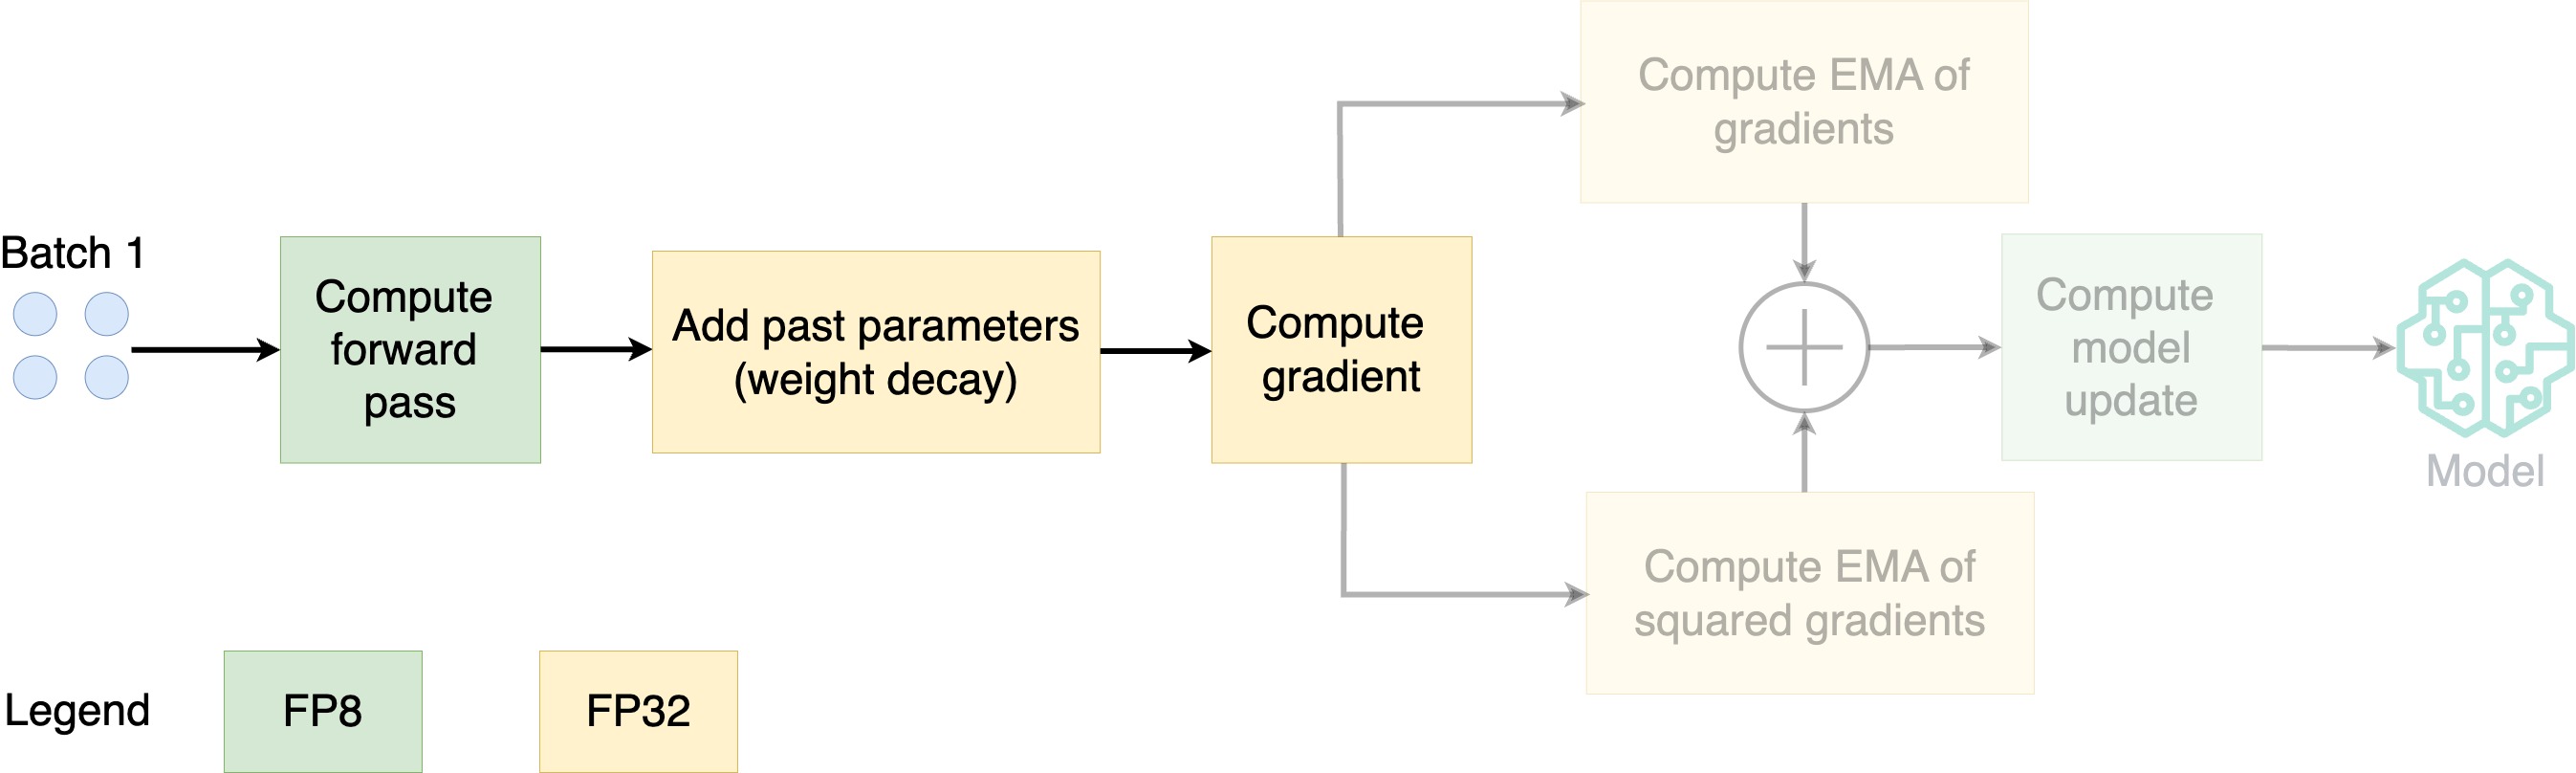
Schéma des étapes d’Adam 8 bits.

  • Stocker les paramètres en FP8; optimiser en FP32
Entraînement efficace de modèles d’IA avec PyTorch

Comment fonctionne Adam 8 bits?

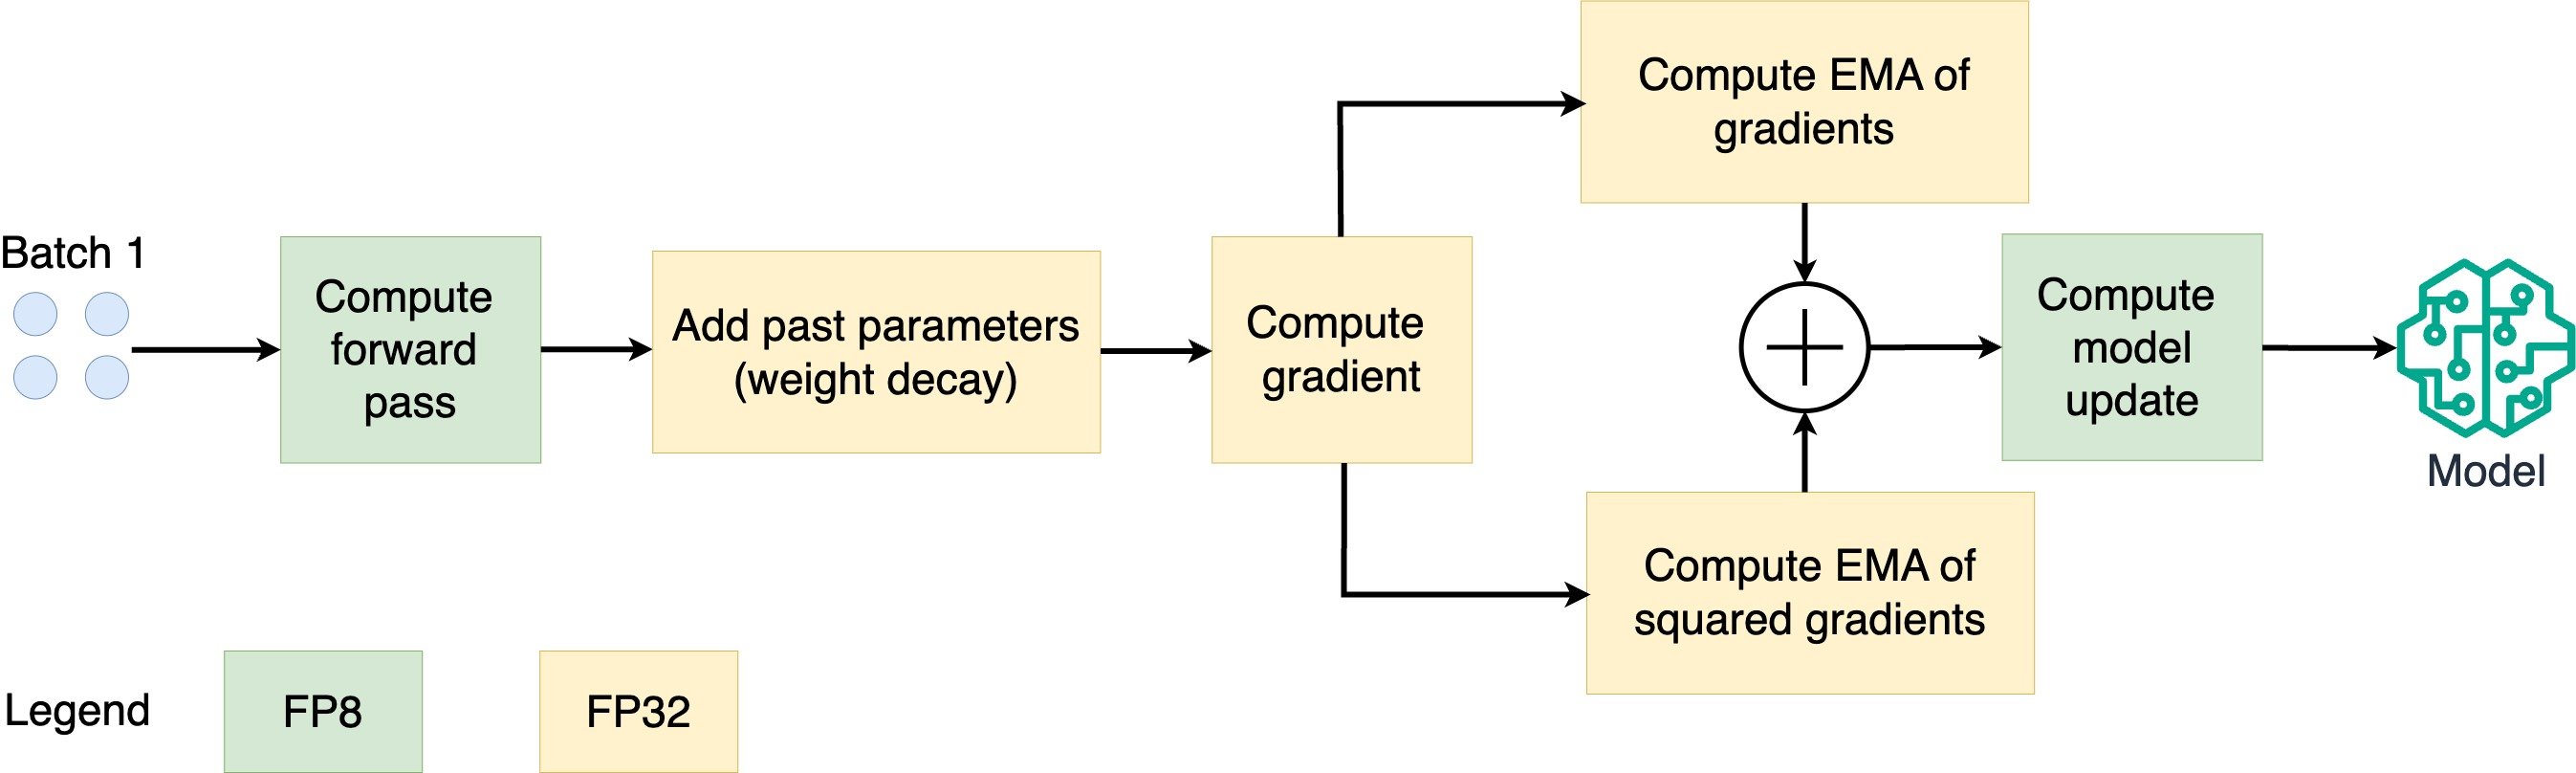
Schéma des étapes d’Adam 8 bits.

  • Stocker les paramètres en FP8; optimiser en FP32
  • EMA : moyenne mobile exponentielle
  • Calculer l’EMA des gradients et des gradients au carré
Entraînement efficace de modèles d’IA avec PyTorch

Comment fonctionne Adam 8 bits?

Schéma des étapes d’Adam 8 bits.

  • Stocker les paramètres en FP8; optimiser en FP32
  • EMA : moyenne mobile exponentielle
  • Calculer l’EMA des gradients et des gradients au carré
Entraînement efficace de modèles d’IA avec PyTorch

Comment Adam 8 bits économise-t-il la mémoire?
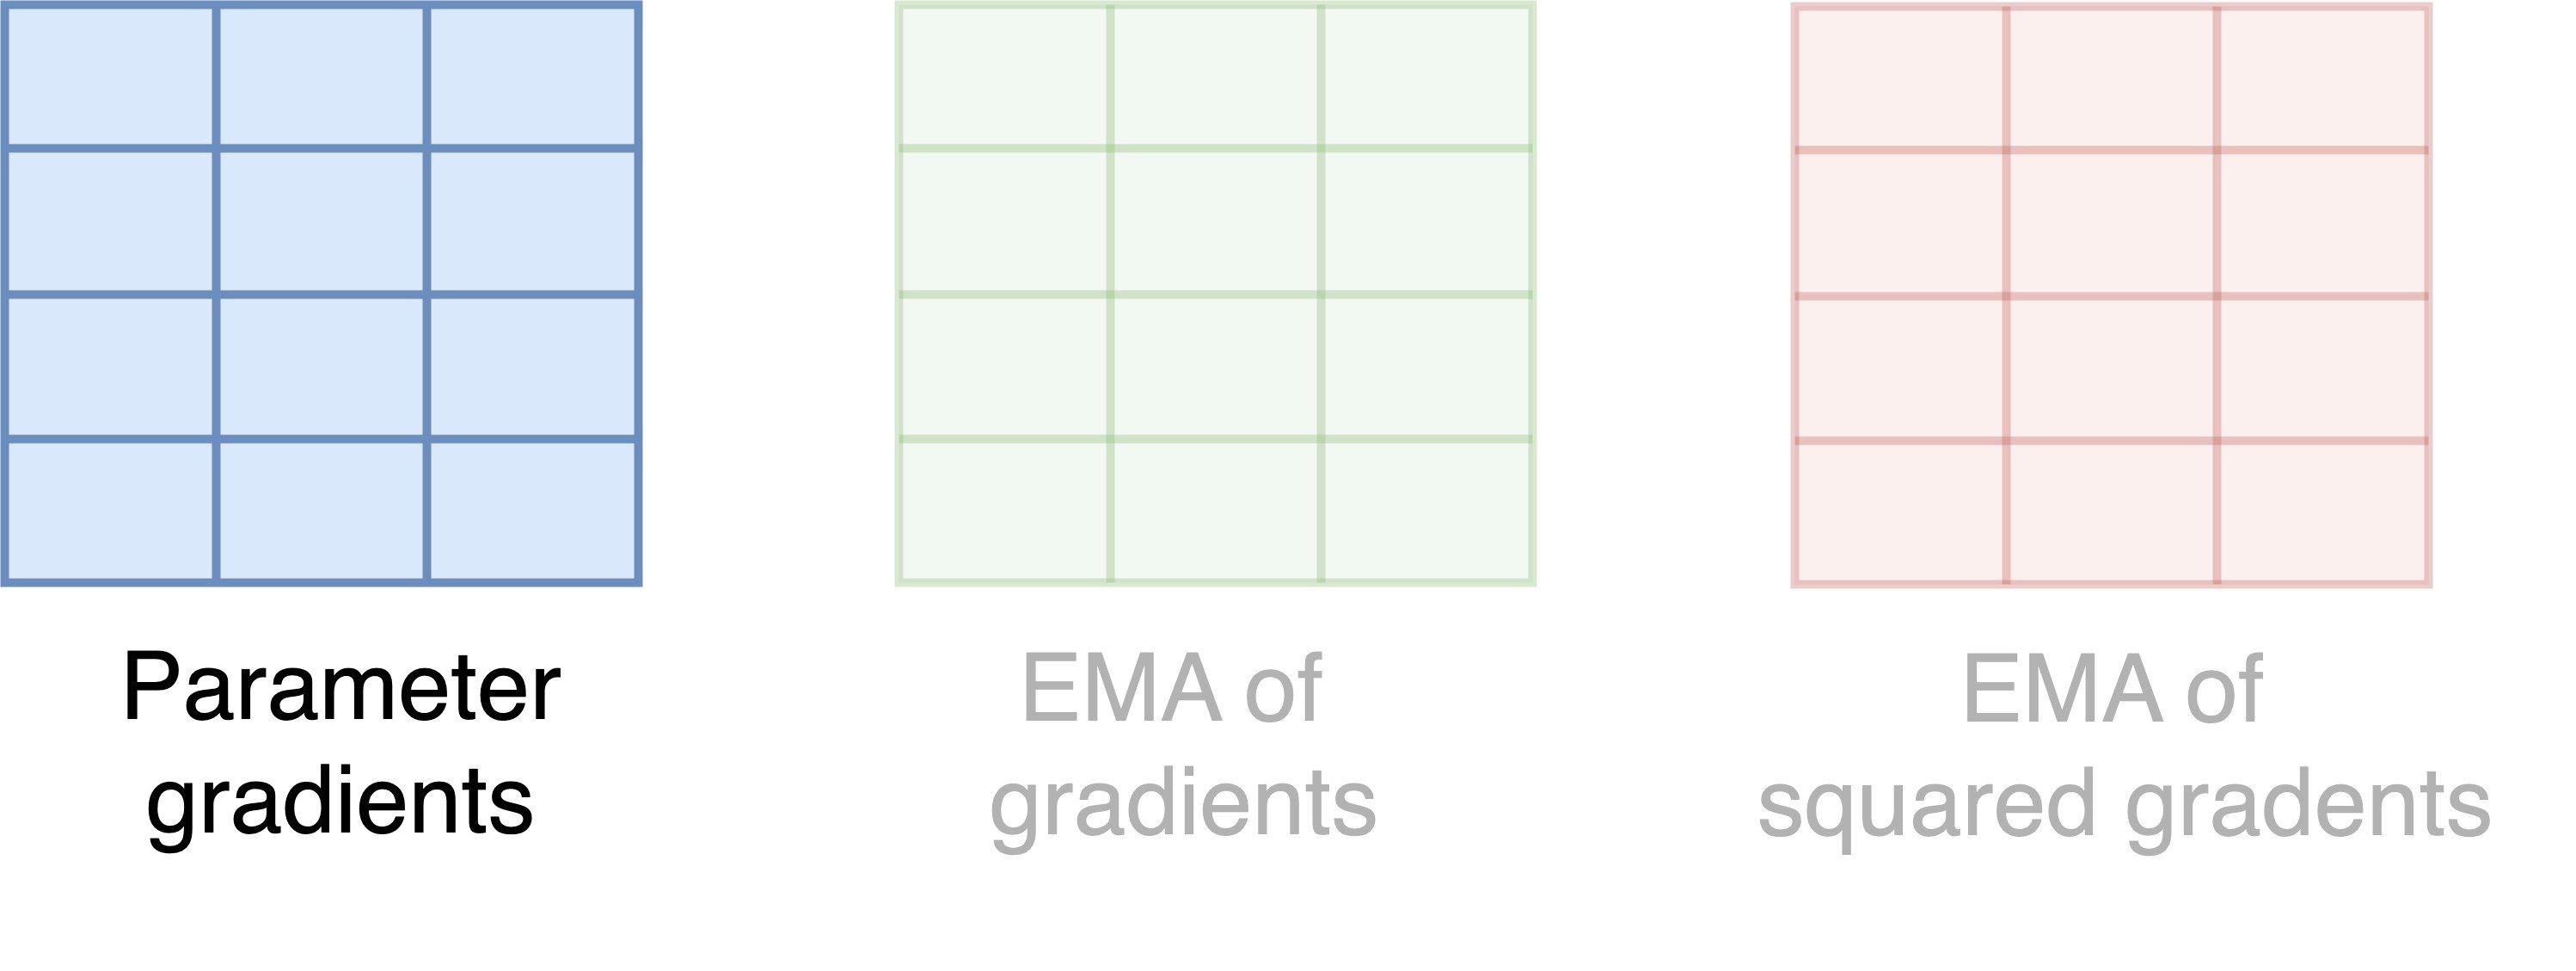
Schéma montrant les gradients des paramètres, l’EMA des gradients et l’EMA des gradients au carré.

Entraînement efficace de modèles d’IA avec PyTorch

Comment Adam 8 bits économise-t-il la mémoire?
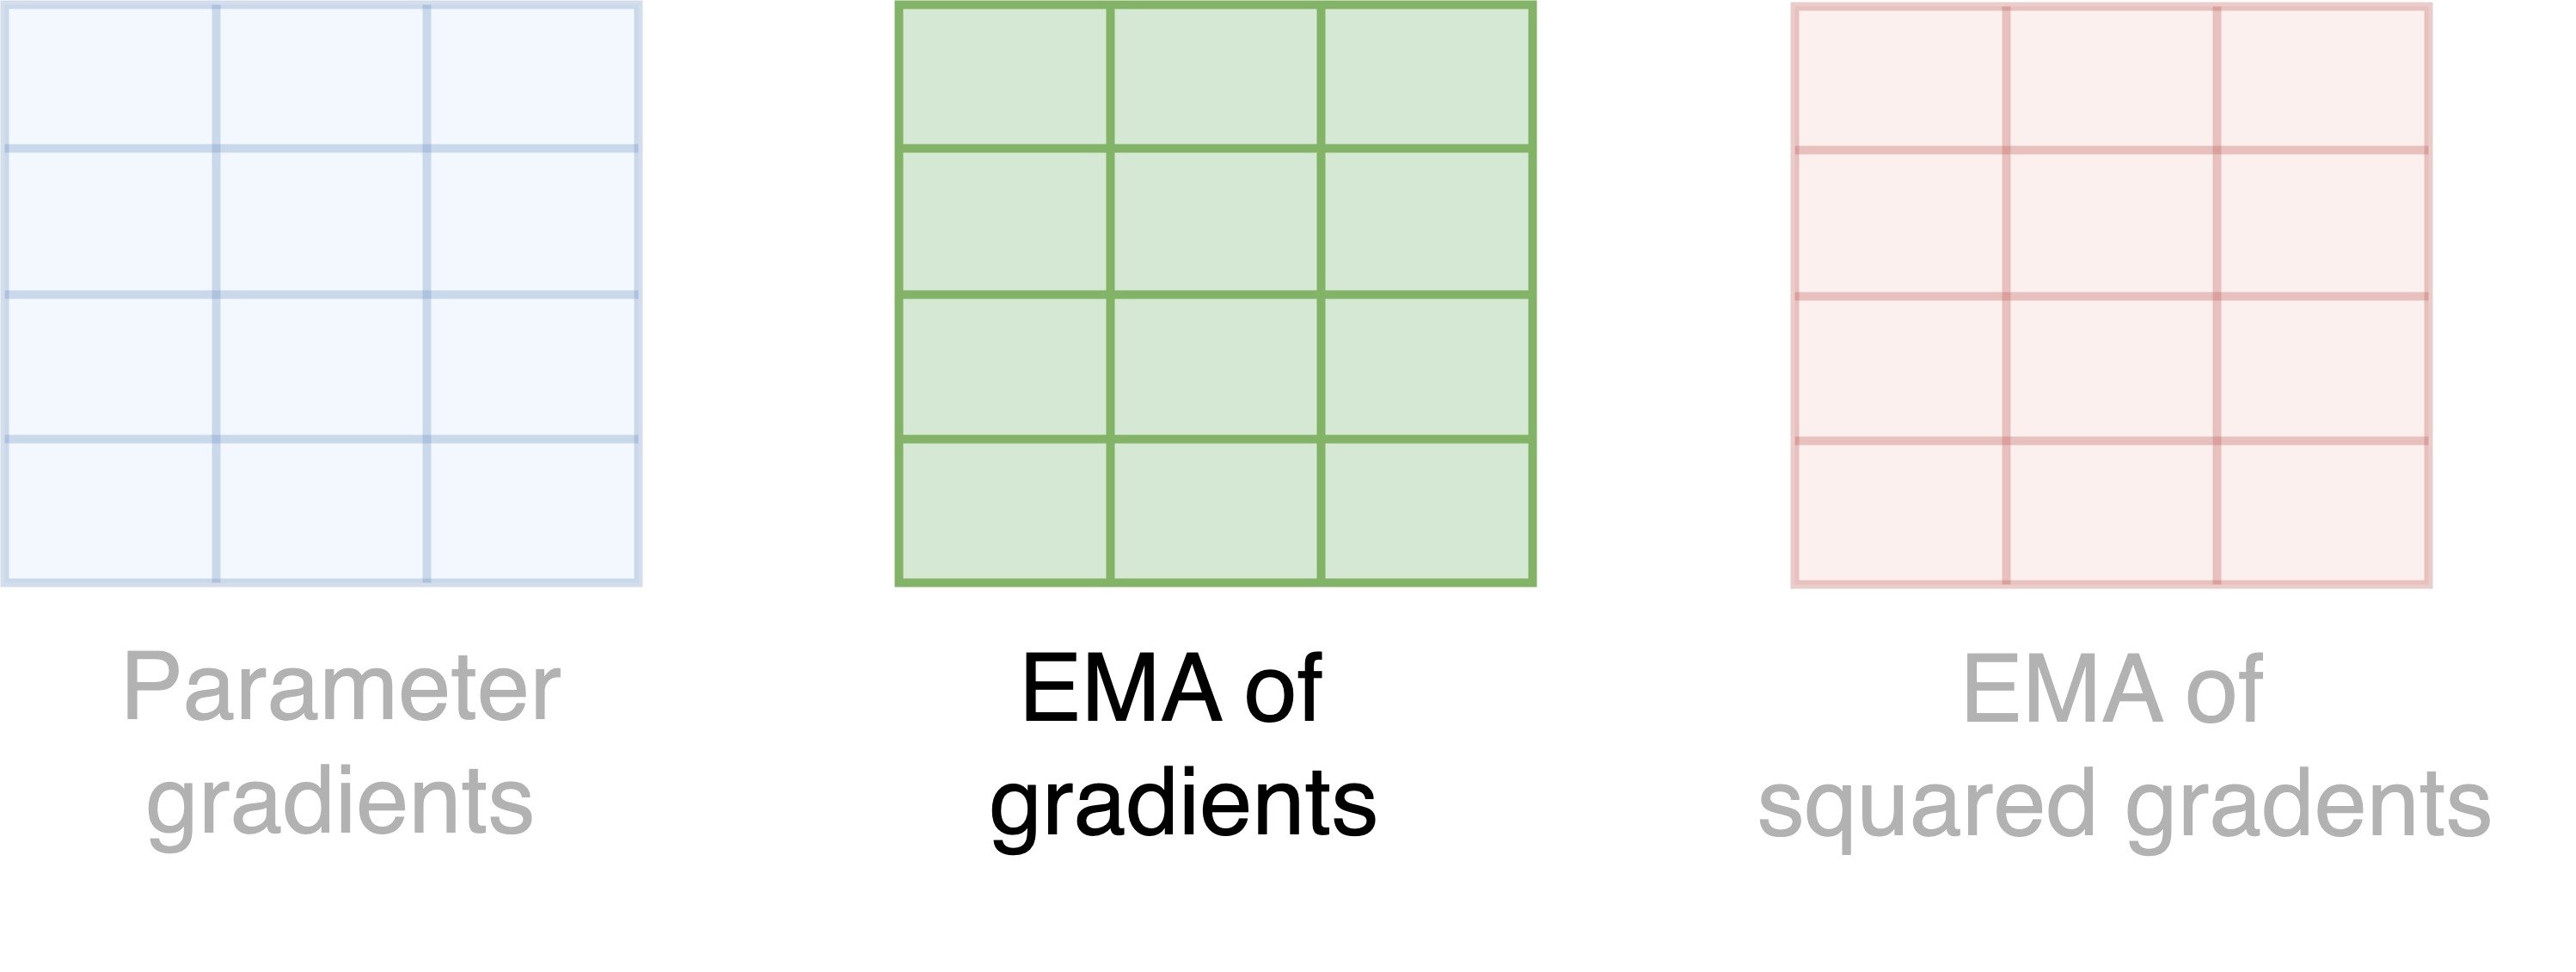
Schéma montrant les gradients des paramètres, l’EMA des gradients et l’EMA des gradients au carré.

Entraînement efficace de modèles d’IA avec PyTorch

Comment Adam 8 bits économise-t-il la mémoire?
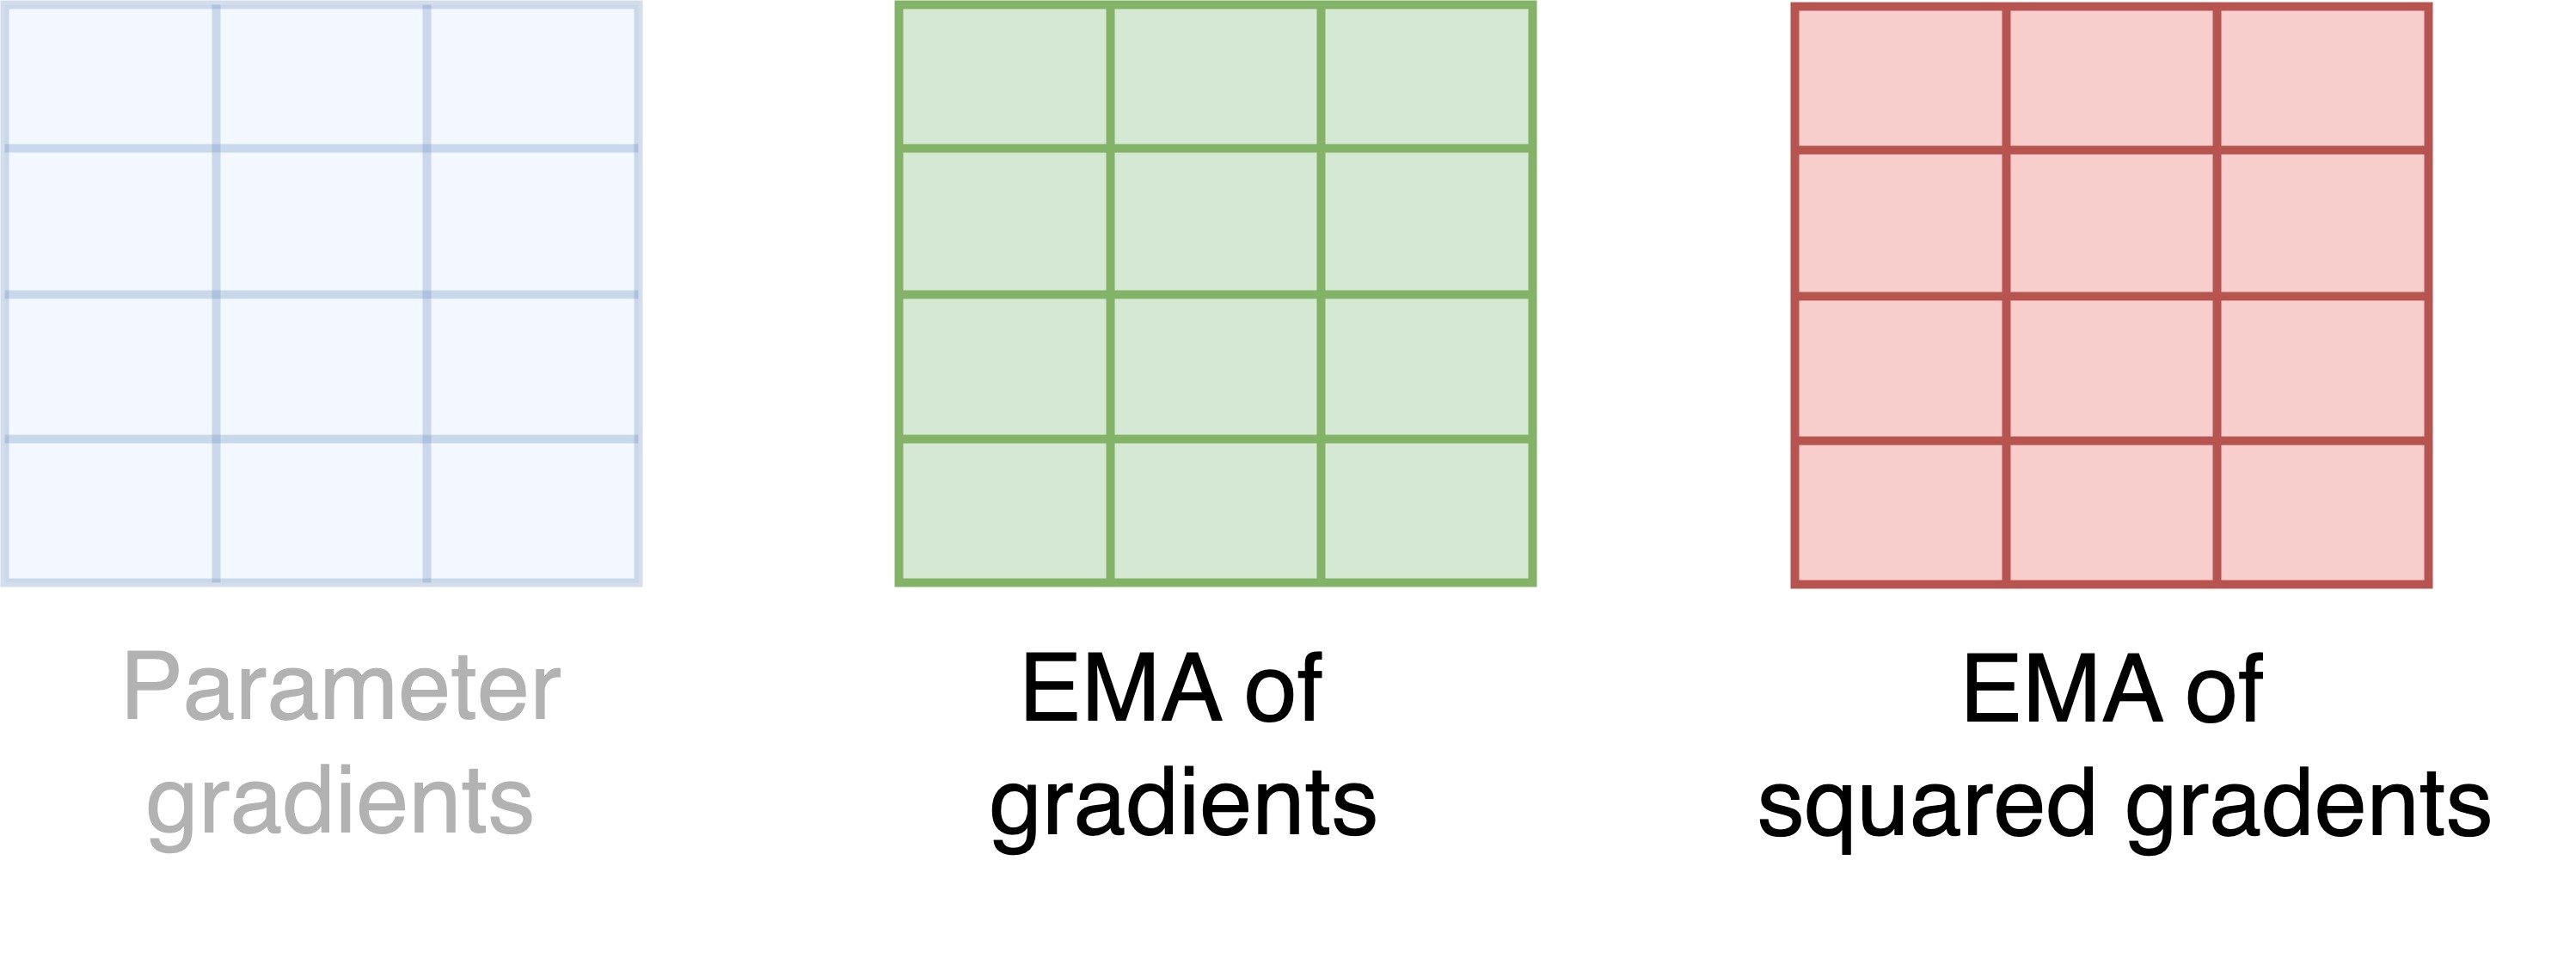
Schéma montrant les gradients des paramètres, l’EMA des gradients et l’EMA des gradients au carré.

  • Chaque carré est un paramètre; chaque couleur, un état
  • Mémoire par paramètre = 2 octets = 1 octet par état × 2 états
  • Mémoire totale = Mémoire par paramètre (2 octets) × Nombre de paramètres
Entraînement efficace de modèles d’IA avec PyTorch

Estimer la mémoire utilisée par Adam 8 bits

model = AutoModelForSequenceClassification.from_pretrained(
    "distilbert-base-cased", return_dict=True)
num_parameters = sum(p.numel() for p in model.parameters())
print(f"Number of model parameters: {num_parameters:,}")
Number of model parameters: 65,783,042
estimated_memory = num_parameters * 2 / (1024 ** 2)
print(f"Estimated memory usage of 8-bit Adam: {estimated_memory:.0f} MB")
Estimated memory usage of 8-bit Adam: 125 MB
Entraînement efficace de modèles d’IA avec PyTorch

Configurer l’optimiseur Adam 8 bits

import bitsandbytes as bnb
from torch import nn
from transformers.trainer_pt_utils import get_parameter_names


args = TrainingArguments(output_dir="./results")
decay_parameters = get_parameter_names(model, [nn.LayerNorm])
decay_parameters = [name for name in decay_parameters if "bias" not in name]
  • Le weight decay réduit le surapprentissage
  • decay_parameters : paramètres auxquels appliquer le weight decay
  • get_parameter_names : retourne les noms; ignore les couches nn.LayerNorm
  • Retirer les paramètres bias de decay_parameters
  • Ne pas appliquer de weight decay aux normalisations ni aux biais
Entraînement efficace de modèles d’IA avec PyTorch

Configurer l’optimiseur Adam 8 bits

optimizer_grouped_parameters = [{"params": [p for n, p in model.named_parameters() 
                                            if n in decay_parameters],
                                 "weight_decay": args.weight_decay},

{"params": [p for n, p in model.named_parameters() if n not in decay_parameters], "weight_decay": 0.0}]
adam_bnb_optim = bnb.optim.Adam8bit(optimizer_grouped_parameters,
betas=(args.adam_beta1, args.adam_beta2),
eps=args.adam_epsilon,
lr=args.learning_rate)
  • optimizer_grouped_parameters : un groupe avec weight decay; l’autre sans
  • beta1, beta2 : taux de décroissance des 1er et 2e moments; plus hauts = plus stable, entraînement plus lent
Entraînement efficace de modèles d’IA avec PyTorch

Implémenter Adam 8 bits avec Trainer

trainer = Trainer(model=model,
                  args=training_args,
                  train_dataset=train_dataset,
                  eval_dataset=validation_dataset,
                  optimizers=(adam_bnb_optim, None),
                  compute_metrics=compute_metrics)

trainer.train()
{'epoch': 1.0, 'eval_loss': 0.63, 'eval_accuracy': 0.67, 'eval_f1': 0.62}
{'epoch': 2.0, 'eval_loss': 0.61, 'eval_accuracy': 0.71, 'eval_f1': 0.66}
Entraînement efficace de modèles d’IA avec PyTorch

Implémenter Adam 8 bits avec Accelerator

model, adam_bnb_optim, train_dataloader, lr_scheduler = \
    accelerator.prepare(model, adam_bnb_optim, train_dataloader, lr_scheduler)


for batch in train_dataloader: inputs, targets = batch["input_ids"], batch["labels"] outputs = model(inputs, labels=targets) loss = outputs.loss accelerator.backward(loss) adam_bnb_optim.step() lr_scheduler.step() adam_bnb_optim.zero_grad() print(f"Loss = {loss}")
Loss = 0.75
Entraînement efficace de modèles d’IA avec PyTorch

Calculer la mémoire utilisée par Adam 8 bits

total_size_megabytes, total_num_elements = \
    compute_optimizer_size(trainer.optimizer.state.values())
print(f"Number of 8-bit Adam parameters: {total_num_elements:,}")
print(f"8-bit Adam size: {total_size_megabytes:.0f} MB")
Number of 8-bit Adam parameters: 131,566,188
8-bit Adam size: 128 MB
  • Comparaison avec AdamW : Adam 8 bits utilise 1/4 de la mémoire
Number of AdamW parameters: 131,566,188
AdamW size: 502 MB
Entraînement efficace de modèles d’IA avec PyTorch

Passons à la pratique !

Entraînement efficace de modèles d’IA avec PyTorch

Preparing Video For Download...