Accelerator से मॉडलों का मूल्यांकन

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

Dennis Lee

Data Engineer, Amazon

मॉडल को evaluation मोड में क्यों रखें?

  • Training मोड
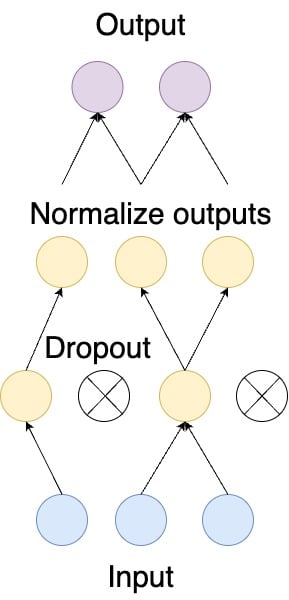
    • Dropout: कुछ neurons को शून्य करें
    • Batch normalization

Dropout और batch normalization कई लेयर्स (इनपुट, हिडन, आउटपुट) वाला न्यूरल नेटवर्क आरेख। ओवरफिटिंग रोकने हेतु हिडन लेयर्स पर dropout लगाया गया है, और प्रत्येक लेयर के आउटपुट को एक्टिवेशन से पहले normalize करने के लिए batch normalization प्रयोग हुआ है।

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

मॉडल को evaluation मोड में क्यों रखें?

  • Training मोड
    • Dropout: कुछ neurons को शून्य करें
    • Batch normalization
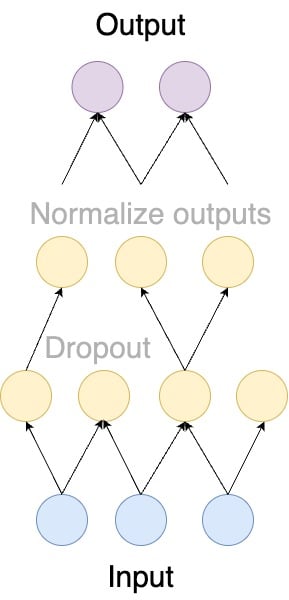
  • Evaluation मोड इन लेयर्स को निष्क्रिय करता है
  • model.eval() evaluation मोड सक्रिय करता है

Dropout और batch normalization कई लेयर्स (इनपुट, हिडन, आउटपुट) वाला न्यूरल नेटवर्क आरेख। ओवरफिटिंग रोकने हेतु हिडन लेयर्स पर dropout लगाया गया है, और प्रत्येक लेयर के आउटपुट को एक्टिवेशन से पहले normalize करने के लिए batch normalization प्रयोग हुआ है।

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

torch.no_grad() से gradients बंद करें

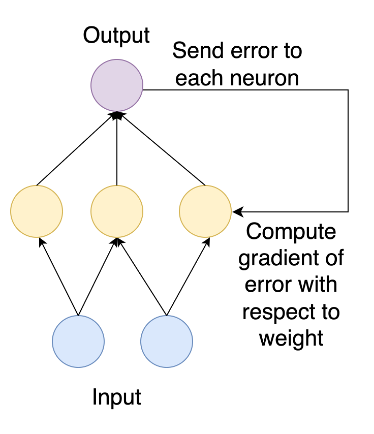
  • Training में gradients की गणना आवश्यक है
  • torch.no_grad() gradients निष्क्रिय करता है
  • दोनों कॉल करें: model.eval और torch.no_grad
model.eval()
with torch.no_grad():
    outputs = model(**inputs)

Backpropagation में gradients की गणना एक न्यूरल नेटवर्क का आरेख जो backpropagation दर्शाता है, जहाँ प्रत्येक लेयर पर gradients वज़न समायोजित करने हेतु निकाले जाते हैं। त्रुटियाँ आउटपुट से हिडन लेयर्स तक पीछे की ओर प्रवाहित होकर gradient descent से वज़न अपडेट करती हैं।

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

Validation डेटासेट तैयार करें

  • MRPC डेटासेट का validation split लोड करें
validation_dataset = load_dataset("glue", "mrpc", split="validation")
  • Validation डेटासेट को tokenize करें
def encode(examples):
    return tokenizer(examples["sentence1"], 
                      examples["sentence2"],
                      truncation=True,
                      padding="max_length")

validation_dataset = validation_dataset.map(encode, batched=True)
PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

एक epoch का जीवन: प्रशिक्षण व मूल्यांकन लूप

  • हर epoch में train व validation डेटासेट पर इटेरेट करें
  • पहले मॉडल को training मोड में चलाएँ
  • फिर evaluation मोड में चलाएँ और मेट्रिक्स लॉग करें
for epoch in range(num_epochs):

model.train() for step, batch in enumerate(train_dataloader): # Perform training step
model.eval() for step, batch in enumerate(eval_dataloader): # Perform evaluation step
# Log evaluation metrics
PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

Evaluation लूप के अंदर

metric = evaluate.load("glue", "mrpc")
model.eval()
for step, batch in enumerate(eval_dataloader):

with torch.no_grad(): outputs = model(**batch) predictions = outputs.logits.argmax(dim=-1)
predictions, references = accelerator.gather_for_metrics((predictions, batch["labels"]))
metric.add_batch(predictions=predictions, references=references)
eval_metric = metric.compute() print(f"Eval metrics: \n{eval_metric}")
Eval metrics: 
{'accuracy': 0.81, 'f1': 0.77}
PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

मूल्यांकन के बाद मेट्रिक्स लॉग करें

  • ट्रैकिंग टूल्स: मेट्रिक्स लॉग करने वाले नोटबुक; उदाहरण: TensorBoard, MLflow
  • log_with: सभी experiment ट्रैकिंग टूल्स उपयोग करें
  • .init_trackers(): ट्रैकिंग टूल्स इनिशियलाइज़ करें
  • .log(): accuracy, f1, epoch ट्रैक करें
  • .end_training(): ट्रैकिंग समाप्त करें
accelerator = Accelerator(project_dir=".",
                          log_with="all")

accelerator.init_trackers("my_project")
for epoch in range(num_epochs): # Training loop is here # Evaluation loop is here accelerator.log({
"accuracy": eval_metric["accuracy"], "f1": eval_metric["f1"],
}, step=epoch)
accelerator.end_training()
PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

Ayo berlatih!

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

Preparing Video For Download...