Adafactor के साथ मेमोरी-कुशल प्रशिक्षण

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

Dennis Lee

Data Engineer, Amazon

प्रशिक्षण कुशलता के लिए ऑप्टिमाइज़र


AdamW, Adafactor, और 8-bit Adam के आइकन।

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

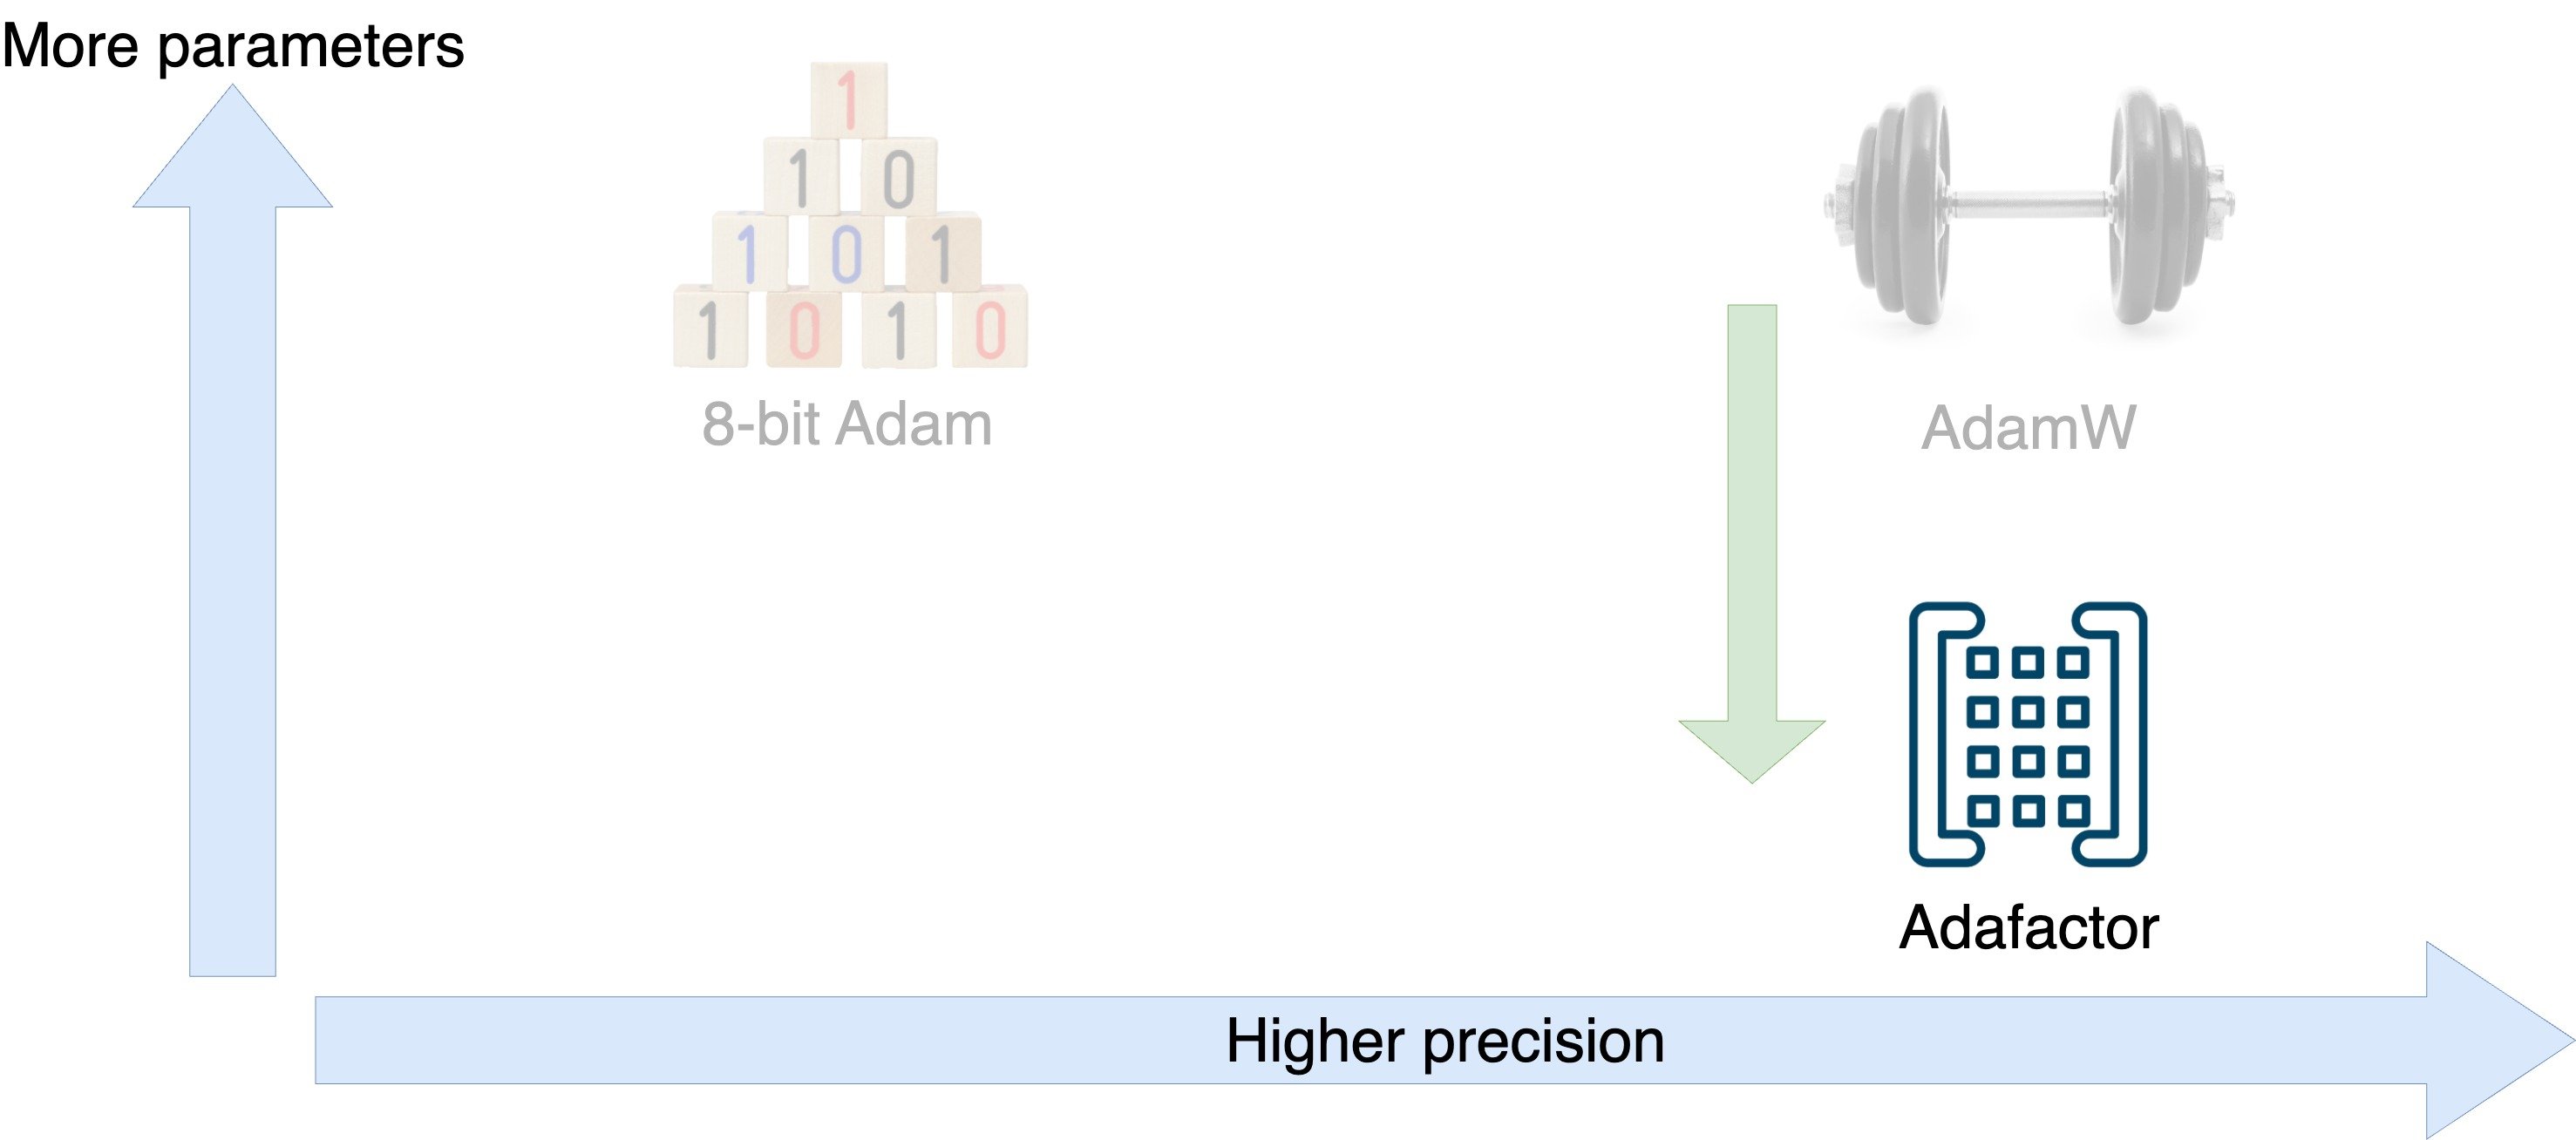
ऑप्टिमाइज़र ट्रेडऑफ

AdamW, Adafactor, और 8-bit Adam के लिए पैरामीटर संख्या और प्रिसीजन के बीच ट्रेडऑफ का आरेख।

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

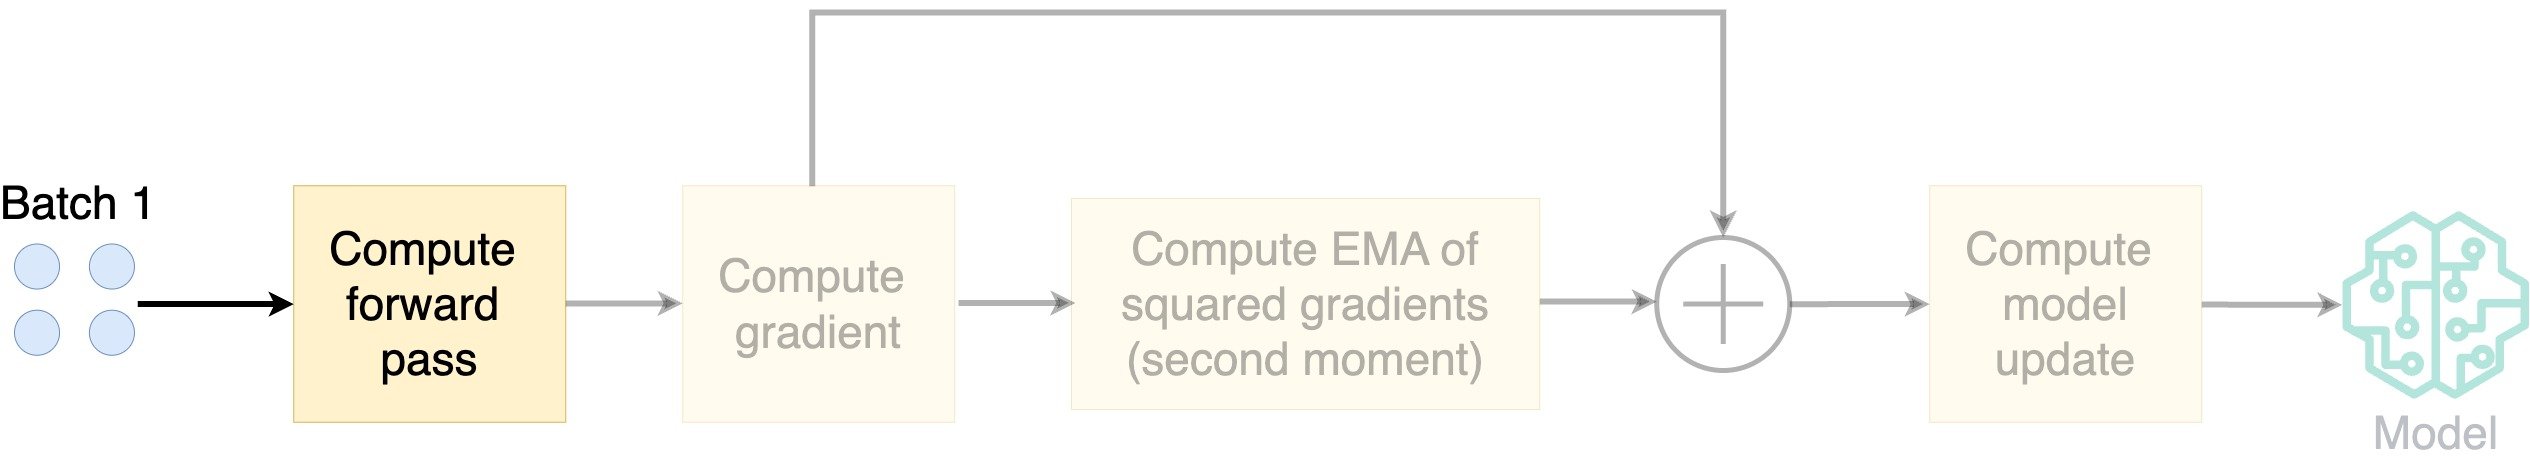
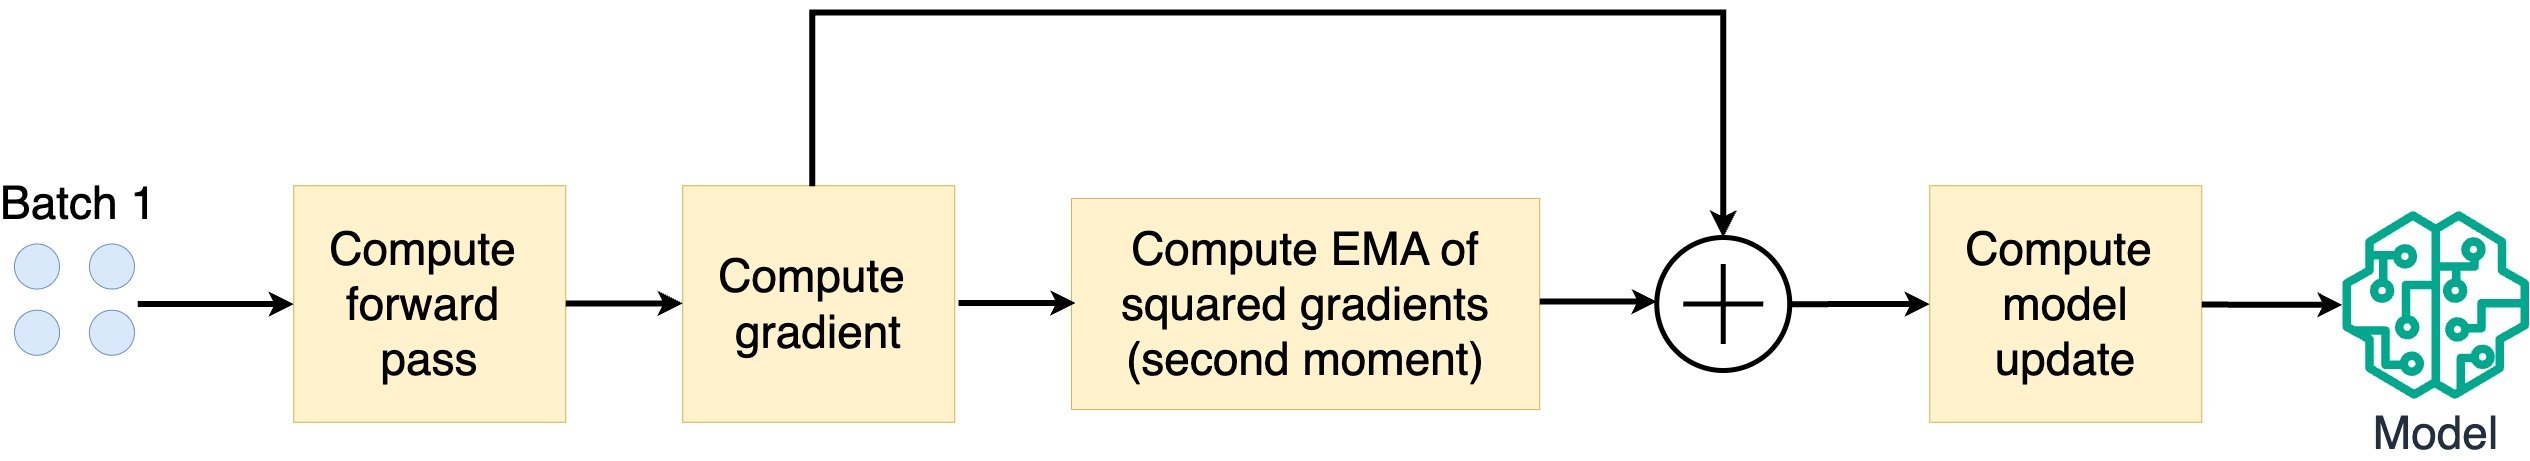
Adafactor कैसे काम करता है?


Adafactor के चरणों का आरेख।

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

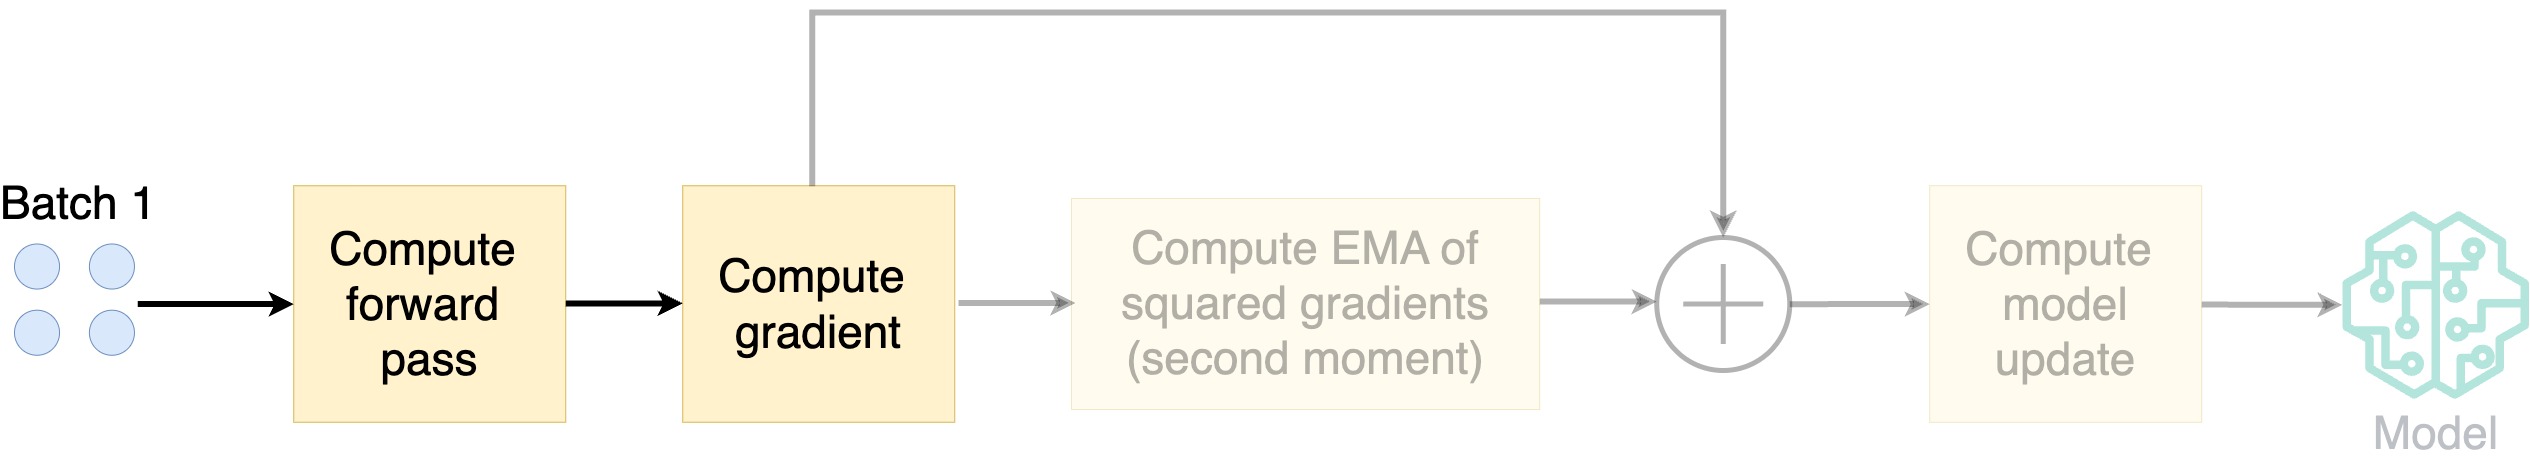
Adafactor कैसे काम करता है?


Adafactor के चरणों का आरेख।

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

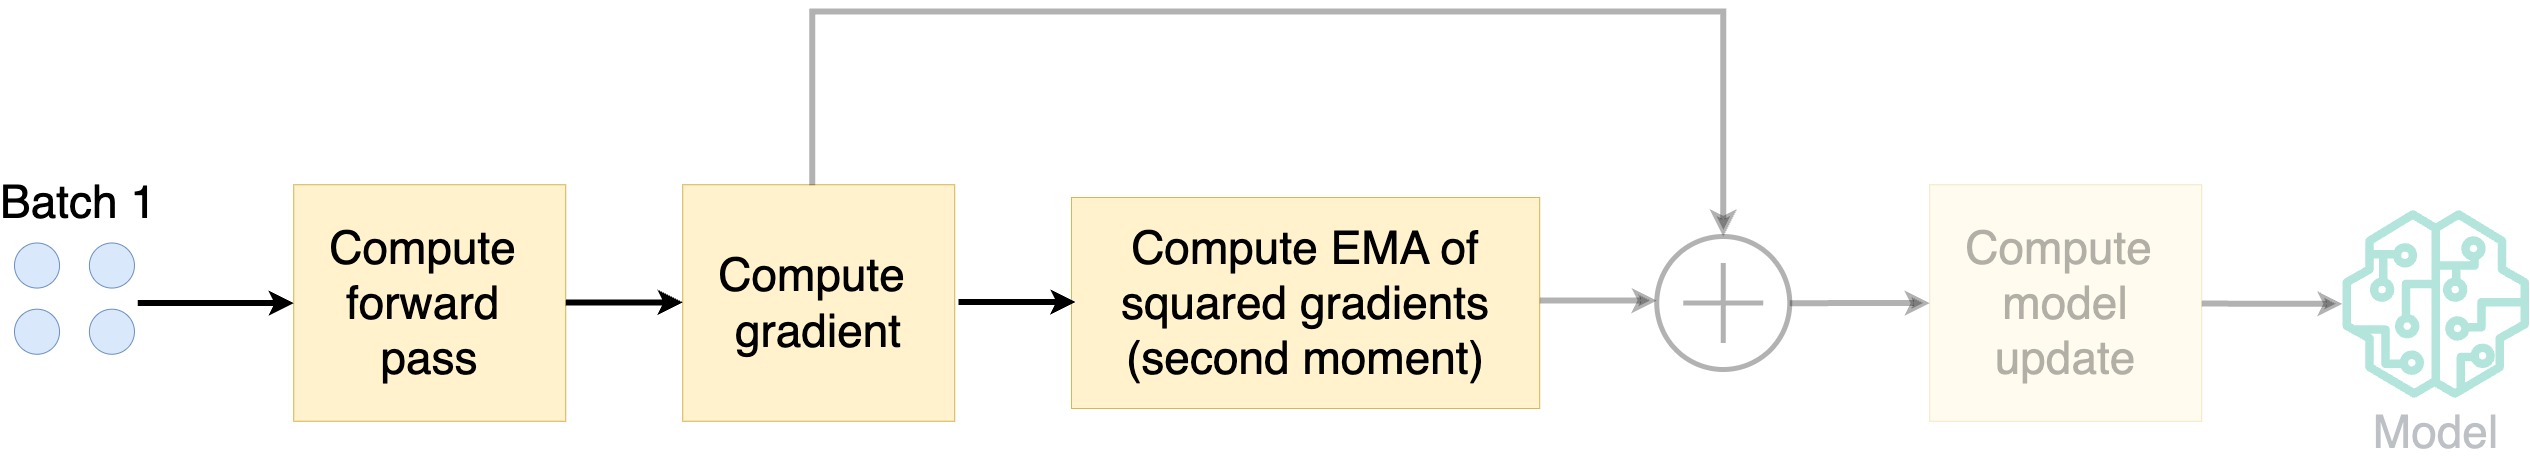
Adafactor कैसे काम करता है?


Adafactor के चरणों का आरेख।


  • EMA: एक्सपोनेंशियल मूविंग एवरेज
  • सेकंड मोमेंट: स्क्वायर्ड ग्रेडिएंट्स का EMA
PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

Adafactor कैसे काम करता है?


Adafactor के चरणों का आरेख।


  • EMA: एक्सपोनेंशियल मूविंग एवरेज
  • सेकंड मोमेंट: स्क्वायर्ड ग्रेडिएंट्स का EMA
PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

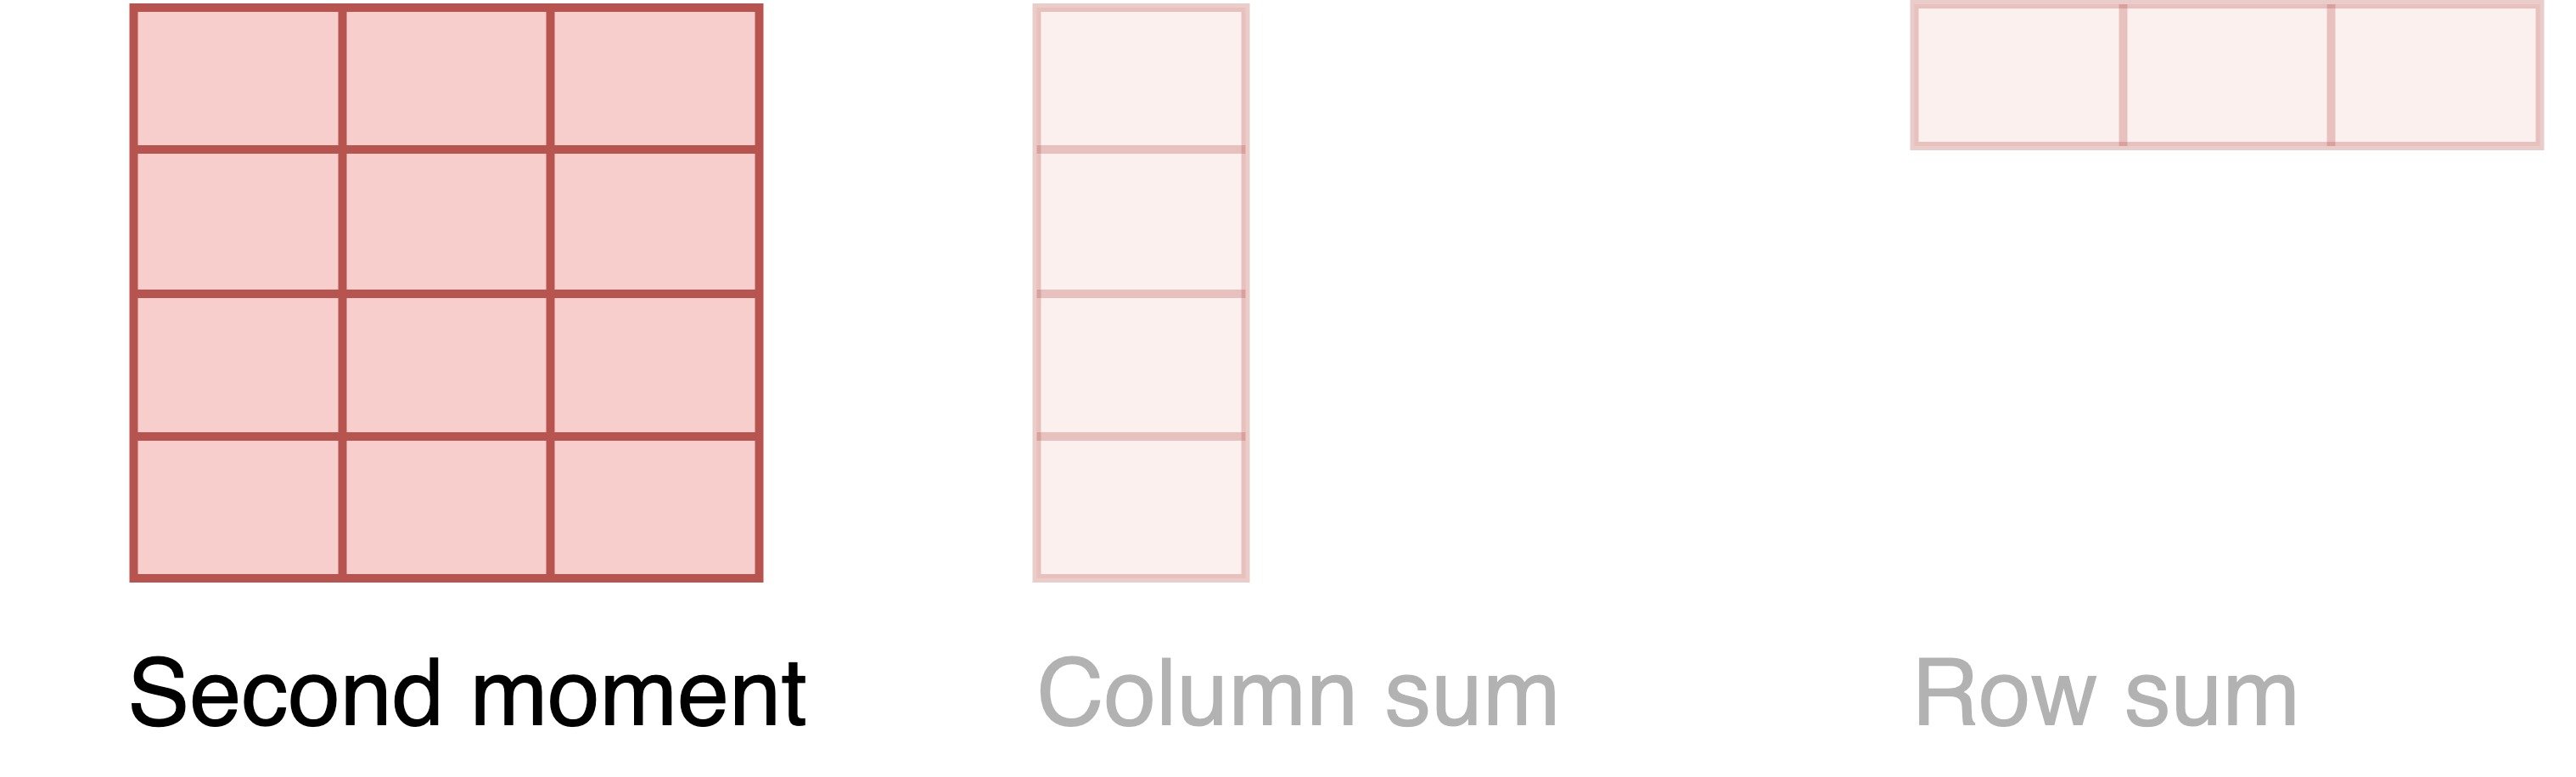
Adafactor मेमोरी कैसे बचाता है?


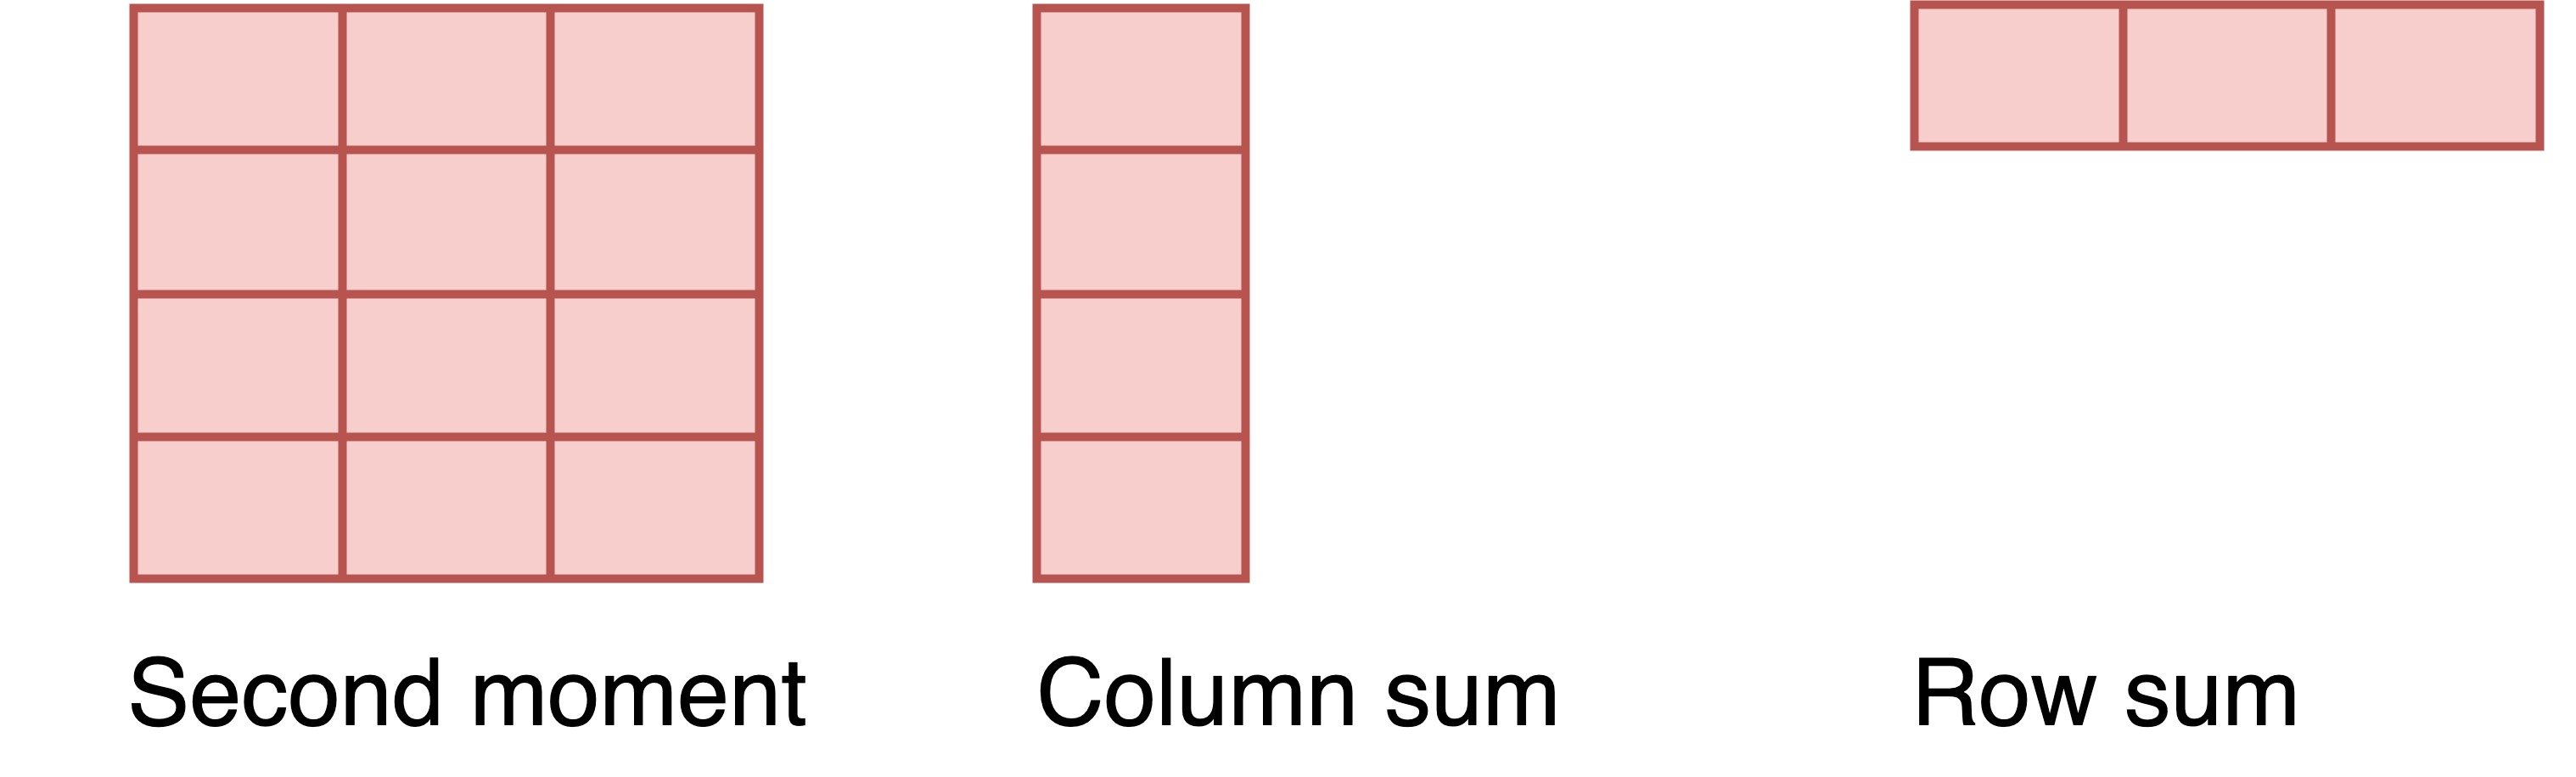
सेकंड मोमेंट मैट्रिक्स, कॉलम सम, और रो सम का आरेख।

  • सेकंड मोमेंट मैट्रिक्स न रखकर मेमोरी बचाएँ
PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

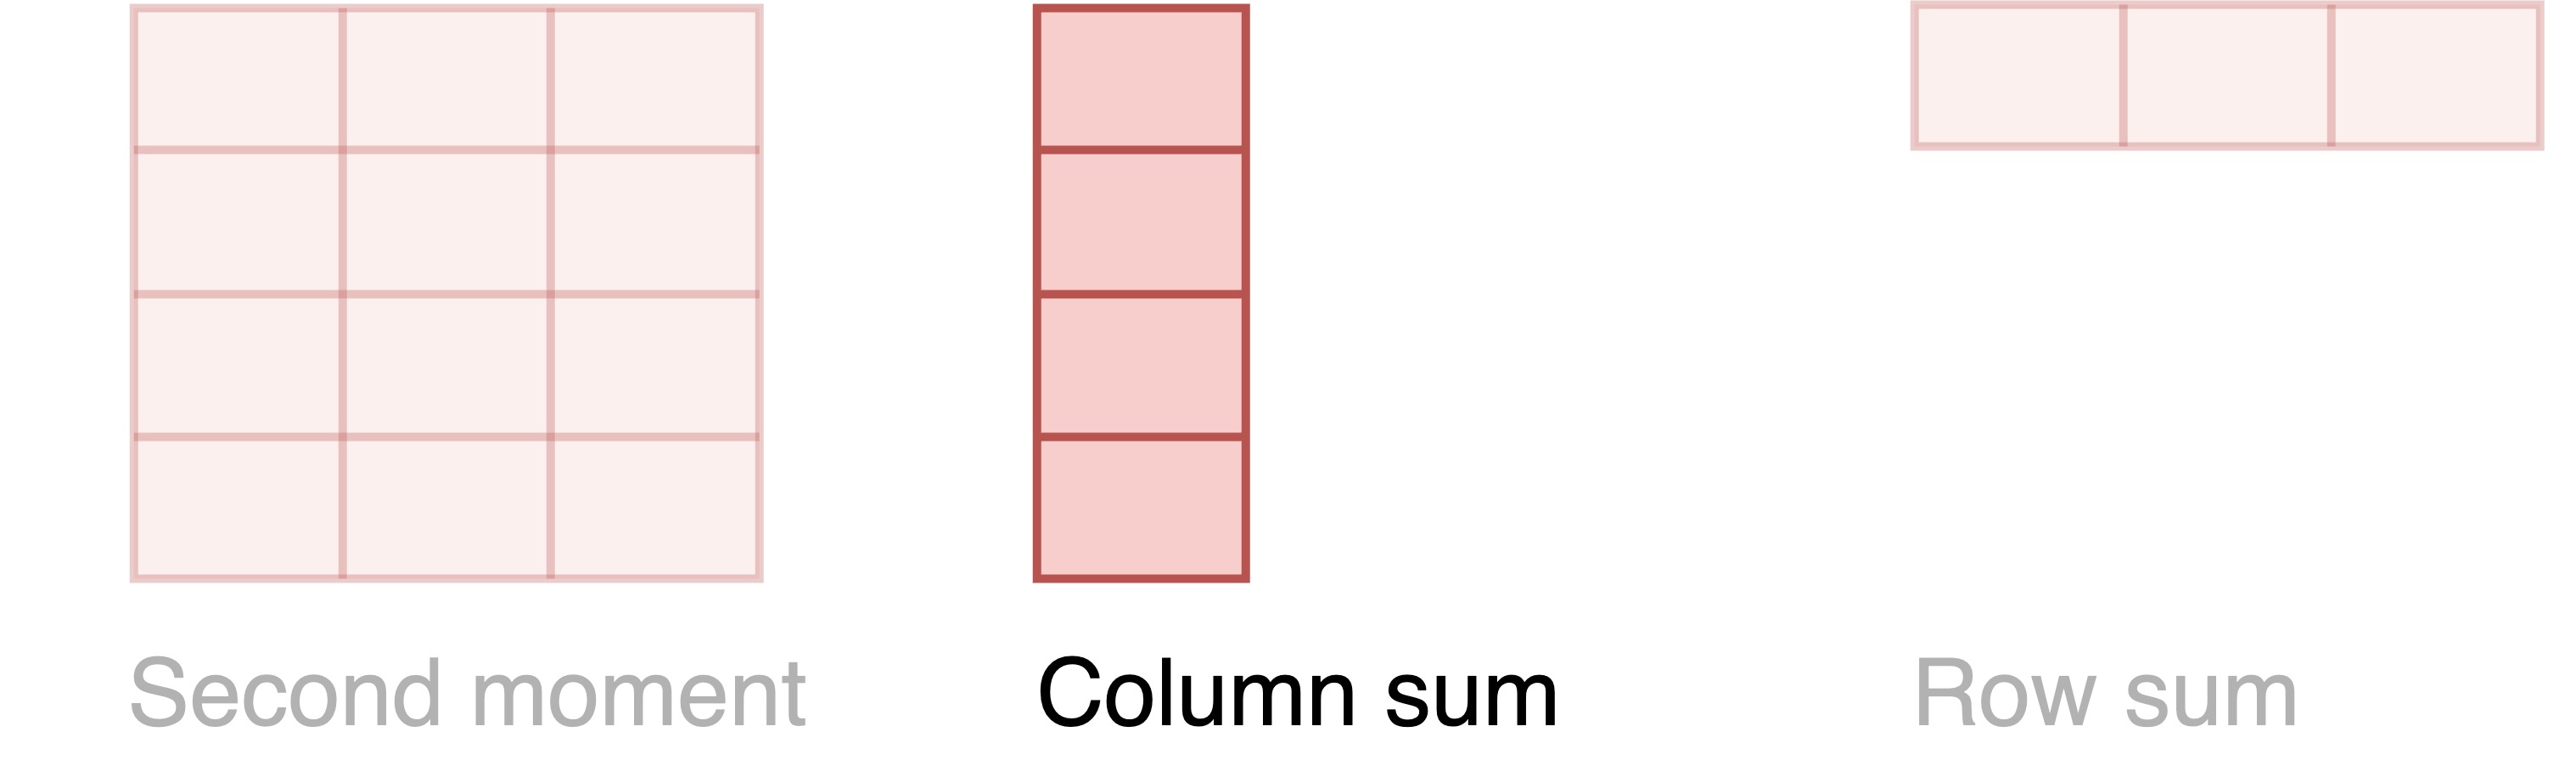
Adafactor मेमोरी कैसे बचाता है?


सेकंड मोमेंट मैट्रिक्स, कॉलम सम, और रो सम का आरेख।

  • सेकंड मोमेंट मैट्रिक्स न रखकर मेमोरी बचाएँ
  • इसके बजाय, मैट्रिक्स का कॉलम सम और रो सम रखें
PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

Adafactor मेमोरी कैसे बचाता है?


सेकंड मोमेंट मैट्रिक्स, कॉलम सम, और रो सम का आरेख।

  • सेकंड मोमेंट मैट्रिक्स न रखकर मेमोरी बचाएँ
  • इसके बजाय, मैट्रिक्स का कॉलम सम और रो सम रखें
PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

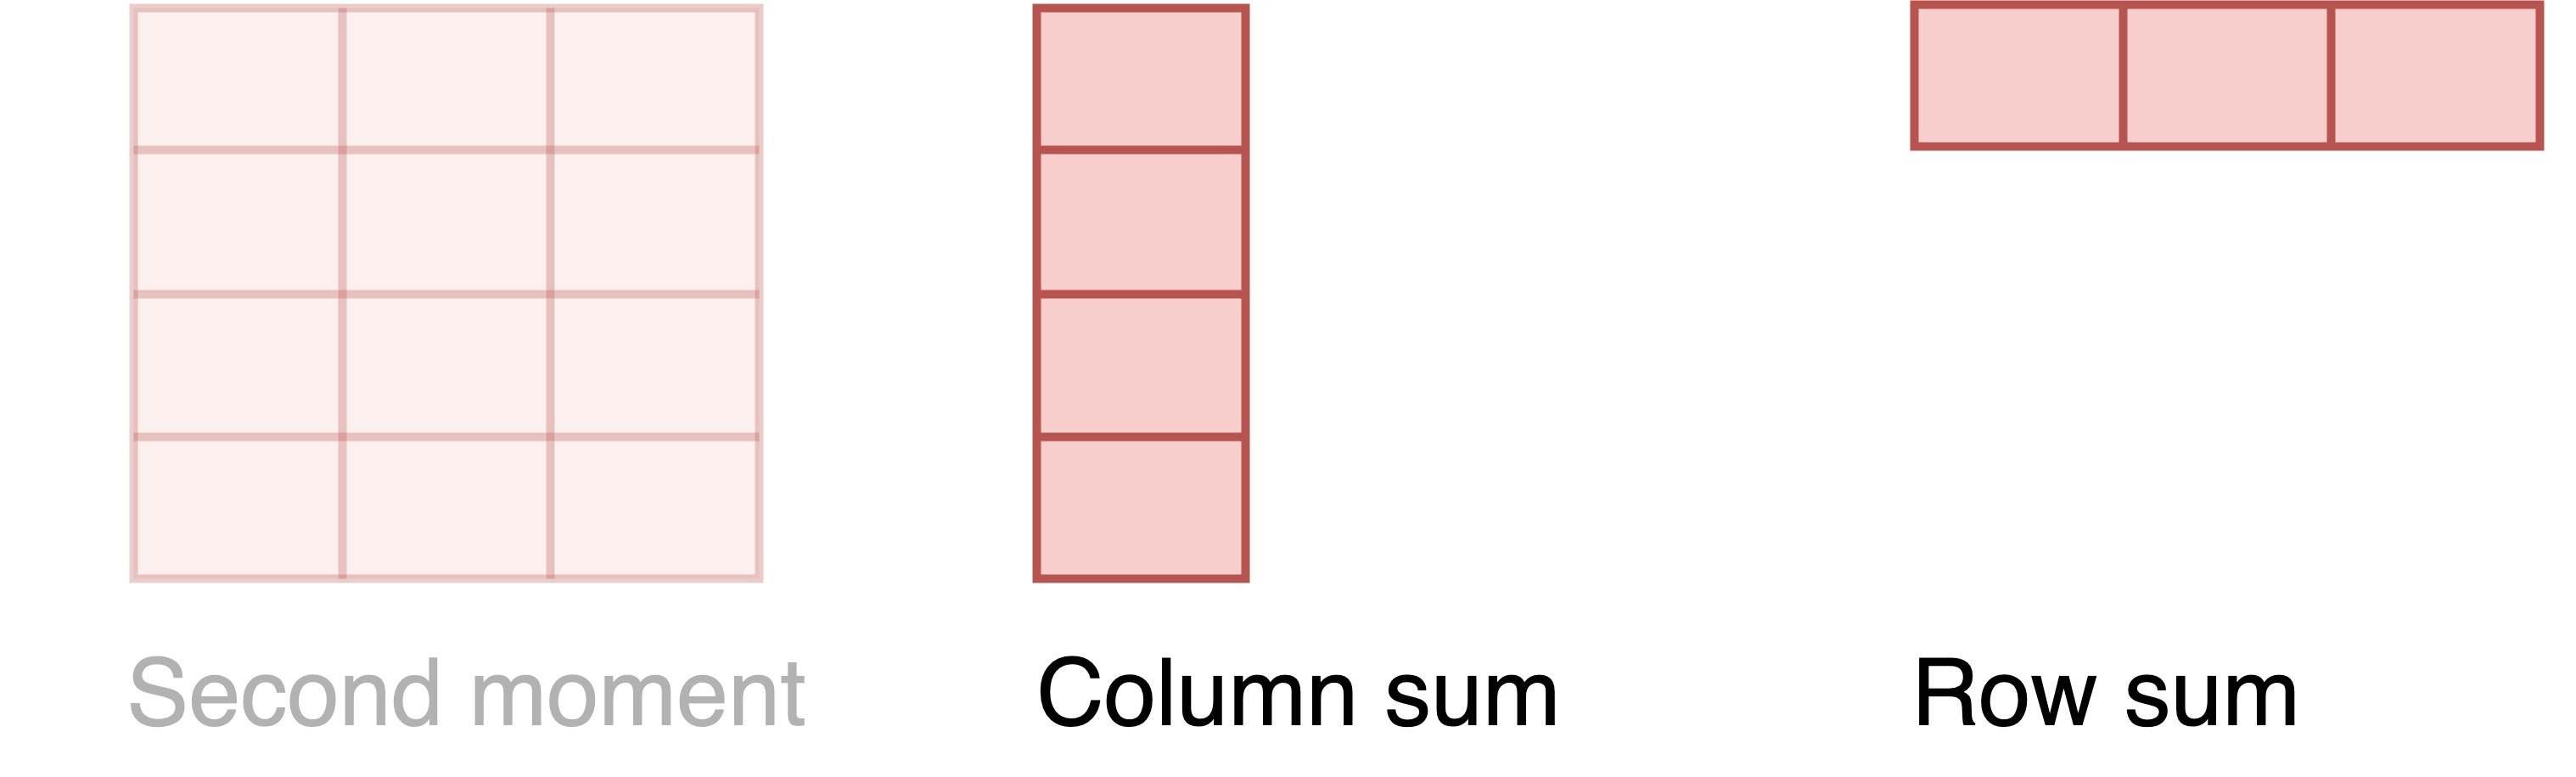
Adafactor मेमोरी कैसे बचाता है?


सेकंड मोमेंट मैट्रिक्स, कॉलम सम, और रो सम का आरेख।

  • सेकंड मोमेंट मैट्रिक्स न रखकर मेमोरी बचाएँ
  • इसके बजाय, मैट्रिक्स का कॉलम सम और रो सम रखें
  • कॉलम और रो सम को गुणा कर फुल मैट्रिक्स का अनुमान लगाएँ
PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

Trainer और Accelerator का इम्प्लीमेंटेशन
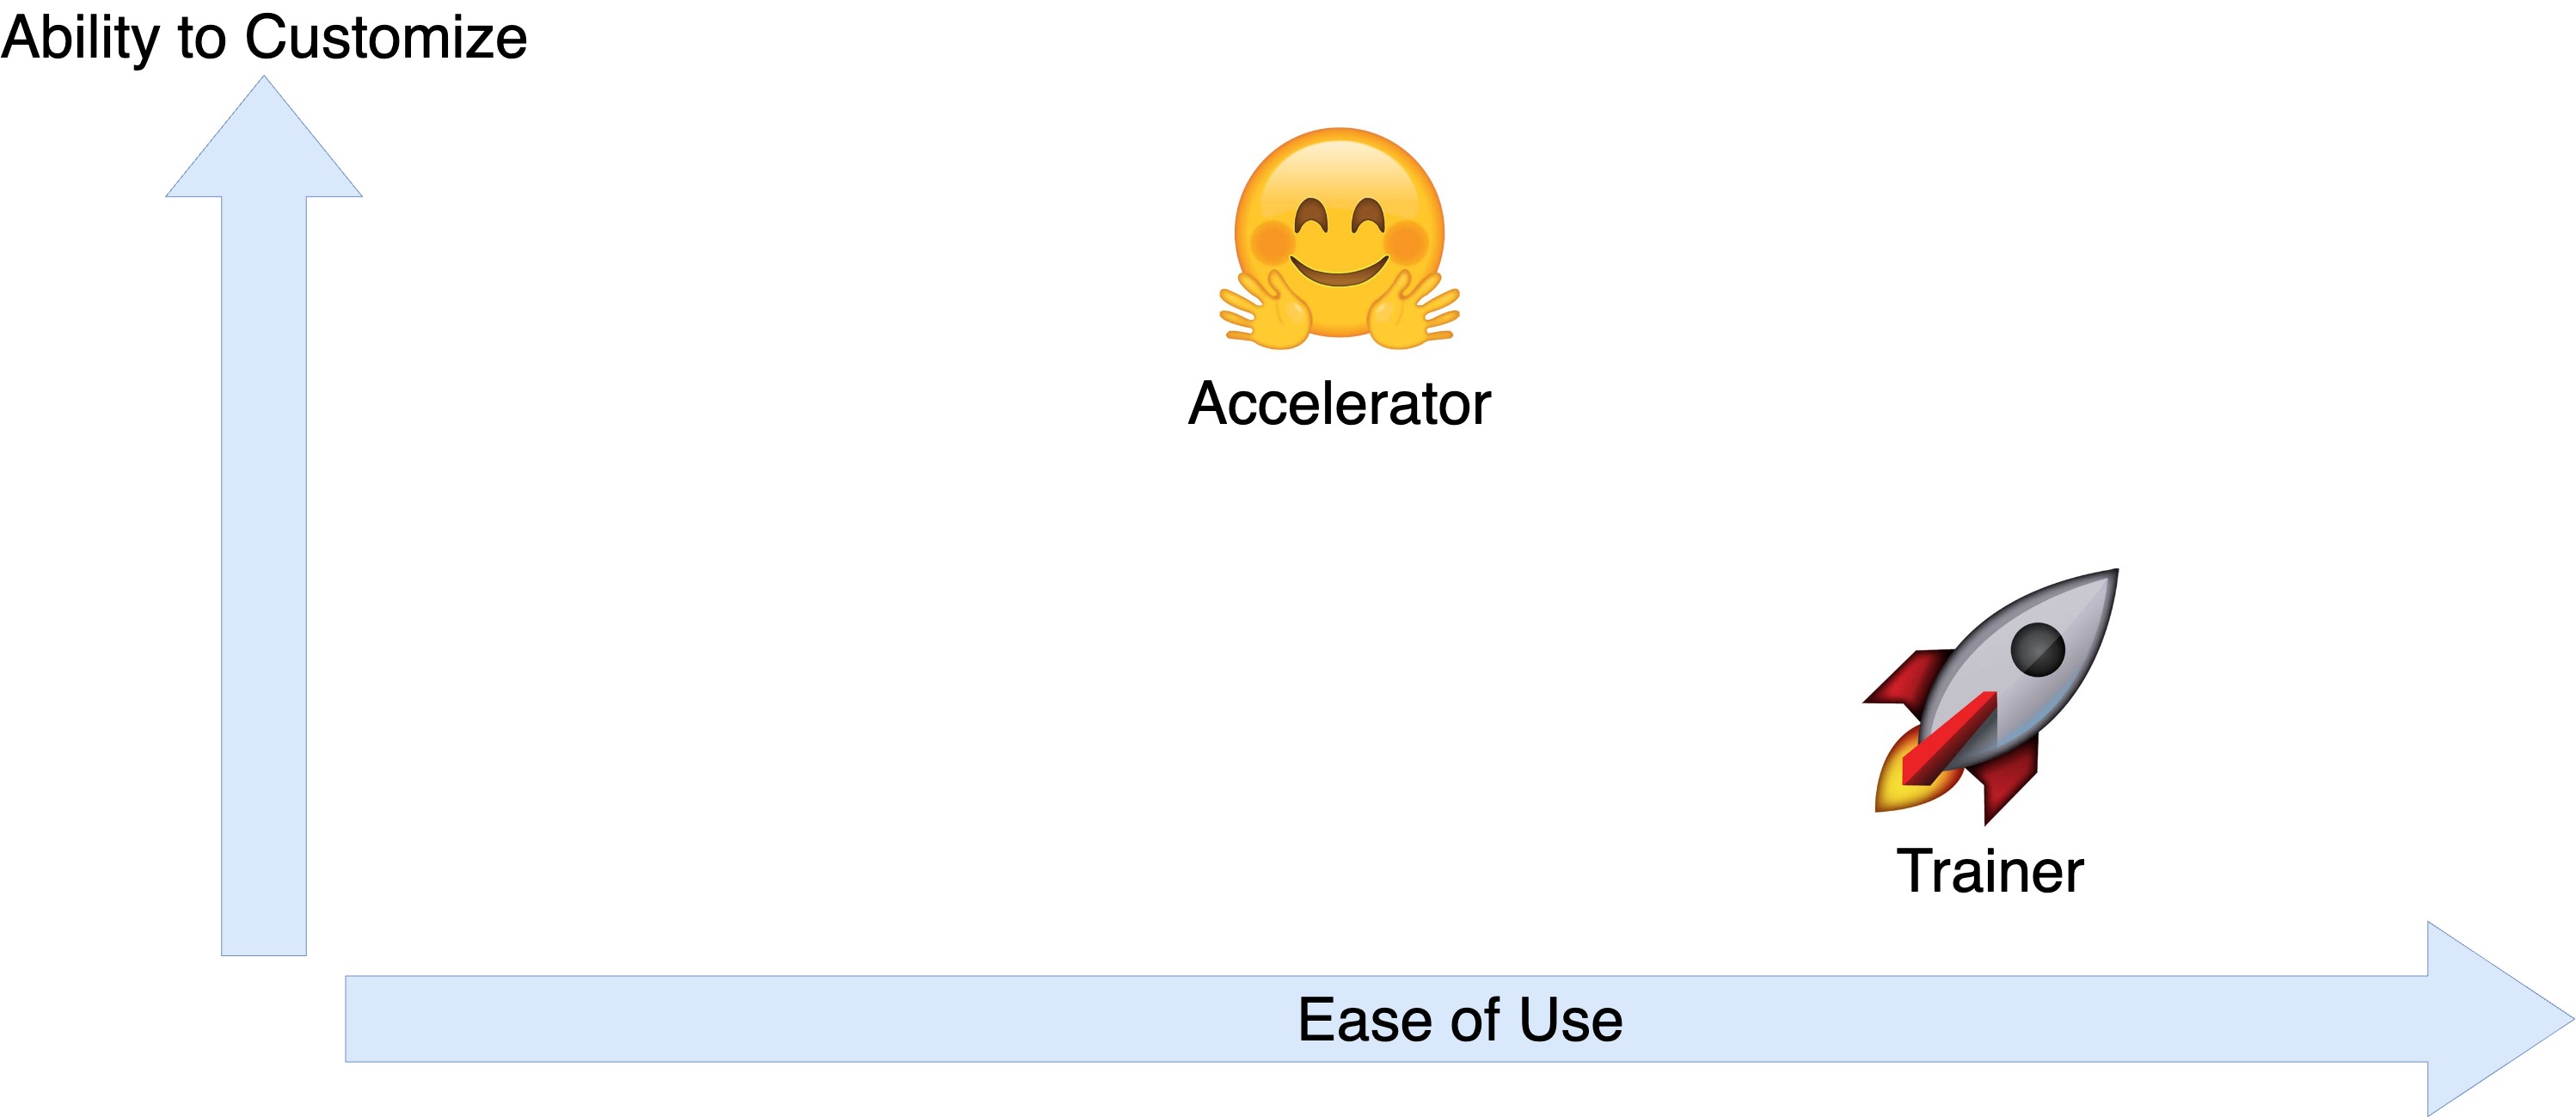
Accelerator और Trainer के लिए उपयोग में सरलता बनाम कस्टमाइज़ेशन का चार्ट।

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

Trainer के साथ Adafactor लागू करें

training_args = TrainingArguments(output_dir="./results",
                                  evaluation_strategy="epoch",

optim="adafactor")
trainer = Trainer(model=model, args=training_args, train_dataset=train_dataset, eval_dataset=validation_dataset, compute_metrics=compute_metrics) trainer.train()
{'epoch': 1.0, 'eval_accuracy': 0.6, 'eval_f1': 0.5}
PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

Accelerator के साथ Adafactor लागू करें

# Assumes PyTorch 2.5 or higher
from torch.optim import Adafactor

optimizer = Adafactor(params=model.parameters(), lr=lr)
for batch in train_dataloader: inputs, targets = batch["input_ids"], batch["labels"] outputs = model(inputs, labels=targets) loss = outputs.loss accelerator.backward(loss) optimizer.step() lr_scheduler.step() optimizer.zero_grad() print(f"Loss = {loss}")
Loss = 0.71
PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

ऑप्टिमाइज़र स्टेट जाँचें

  • state के माध्यम से optimizer एक्सेस करें
optimizer_state = optimizer.state.values()
  • या trainer के माध्यम से optimizer एक्सेस करें
optimizer_state = trainer.optimizer.state.values()
print(optimizer_state)
dict_values([{'step': tensor(3.),
              'exp_avg_sq_row': tensor([1.0000e-30, 1.0000e-30, 1.0000e-30,  ...]), 
              'exp_avg_sq_col': tensor([4.6147e-11, 5.5115e-11, 1.6338e-10, ...])}, ...])
PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

Adafactor की मेमोरी उपयोग गणना करें

total_size_megabytes, total_num_elements = \
    compute_optimizer_size(trainer.optimizer.state.values())
print(f"Number of Adafactor parameters: {total_num_elements:,}")
print(f"Adafactor size: {total_size_megabytes:.0f} MB")
Number of Adafactor parameters: 178,712
Adafactor size: 1 MB
  • AdamW से तुलना: Adafactor बहुत कम मेमोरी लेता है!
Number of AdamW parameters: 131,566,188
AdamW size: 502 MB
PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

आइए अभ्यास करें!

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

Preparing Video For Download...