ग्रेडिएंट चेकपॉइंटिंग और लोकल SGD

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

Dennis Lee

Data Engineer, Amazon

ट्रेनिंग दक्षता बढ़ाना


मेमोरी, संचार, और कम्प्यूटेशन दक्षता दर्शाते आइकन्स.

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

ग्रेडिएंट चेकपॉइंटिंग से मेमोरी दक्षता बढ़ती है


मेमोरी, संचार, और कम्प्यूटेशन दक्षता दर्शाते आइकन्स.

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

लोकल SGD संचार दक्षता को संबोधित करता है


मेमोरी, संचार, और कम्प्यूटेशन दक्षता दर्शाते आइकन्स.

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

ग्रेडिएंट चेकपॉइंटिंग क्या है?

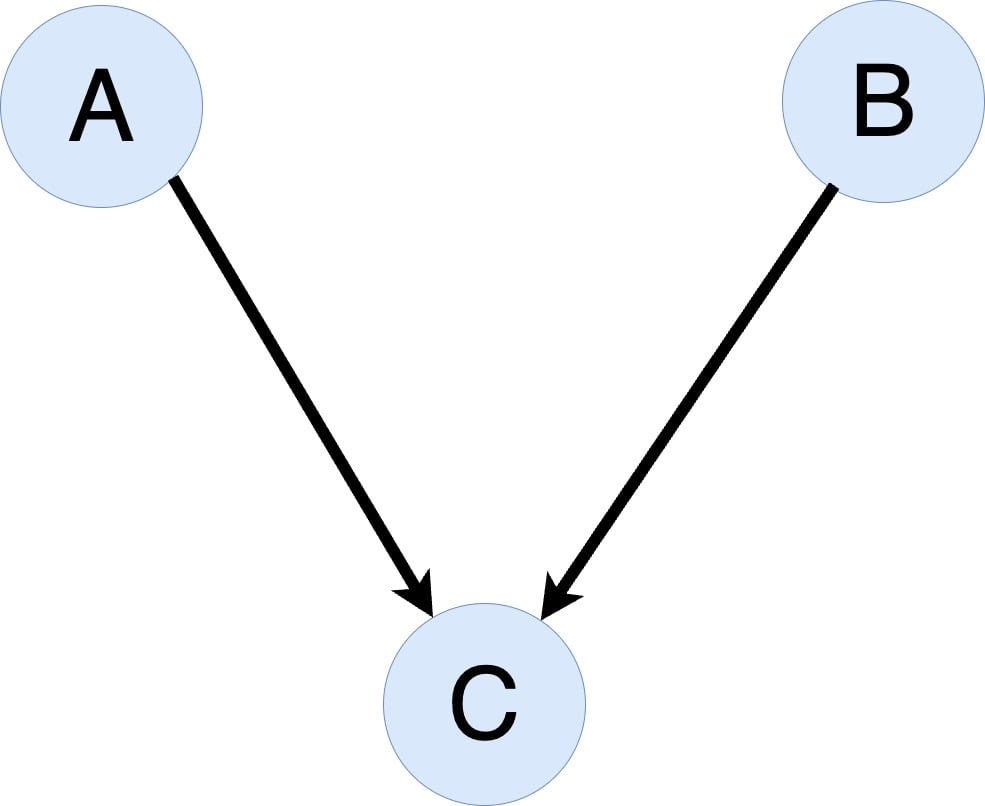
  • ग्रेडिएंट चेकपॉइंटिंग: किन एक्टिवेशन्स को सहेजना है चुनकर मेमोरी घटाएँ
  • उदाहरण: A + B = C गणना करें

नोड्स और एज के साथ ग्रेडिएंट चेकपॉइंटिंग दर्शाता ग्राफ

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

ग्रेडिएंट चेकपॉइंटिंग क्या है?

  • ग्रेडिएंट चेकपॉइंटिंग: किन एक्टिवेशन्स को सहेजना है चुनकर मेमोरी घटाएँ
  • उदाहरण: A + B = C गणना करें
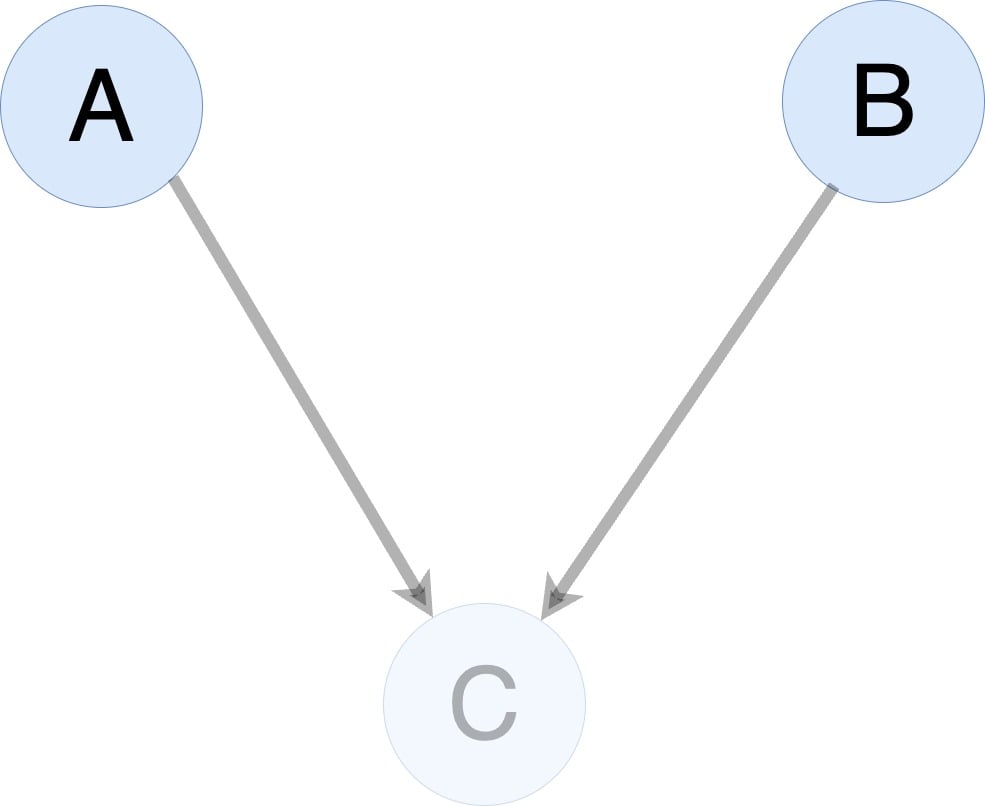
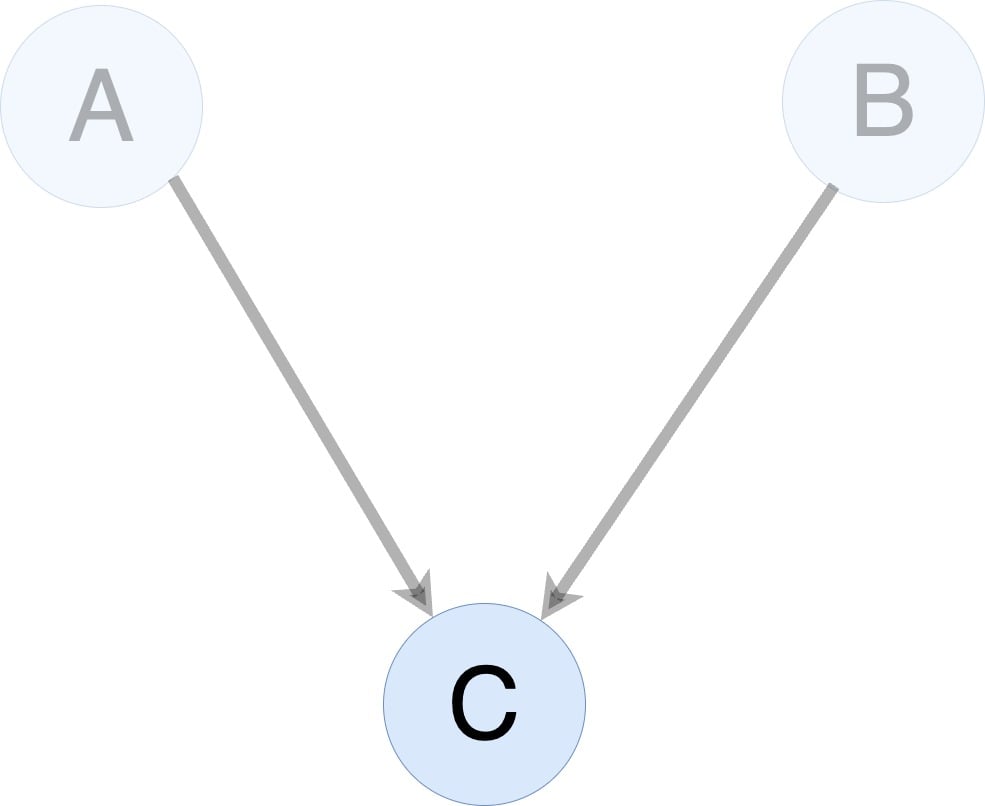
    • पहले A, B; फिर C गणना करें

नोड्स और एज के साथ ग्रेडिएंट चेकपॉइंटिंग दर्शाता ग्राफ

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

ग्रेडिएंट चेकपॉइंटिंग क्या है?

  • ग्रेडिएंट चेकपॉइंटिंग: किन एक्टिवेशन्स को सहेजना है चुनकर मेमोरी घटाएँ
  • उदाहरण: A + B = C गणना करें
    • पहले A, B; फिर C गणना करें
    • आगे के फॉरवर्ड पास में A, B आवश्यक नहीं
  • क्या हमें A और B सहेजने चाहिए या हटाने चाहिए?

नोड्स और एज के साथ ग्रेडिएंट चेकपॉइंटिंग दर्शाता ग्राफ

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

ग्रेडिएंट चेकपॉइंटिंग क्या है?

  • ग्रेडिएंट चेकपॉइंटिंग: किन एक्टिवेशन्स को सहेजना है चुनकर मेमोरी घटाएँ
  • उदाहरण: A + B = C गणना करें
    • पहले A, B; फिर C गणना करें
    • आगे के फॉरवर्ड पास में A, B आवश्यक नहीं
  • क्या हमें A और B सहेजने चाहिए या हटाने चाहिए?
    • बिना ग्रेडिएंट चेकपॉइंटिंग: A, B सहेजें

नोड्स और एज के साथ ग्रेडिएंट चेकपॉइंटिंग दर्शाता ग्राफ

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

ग्रेडिएंट चेकपॉइंटिंग क्या है?

  • ग्रेडिएंट चेकपॉइंटिंग: किन एक्टिवेशन्स को सहेजना है चुनकर मेमोरी घटाएँ
  • उदाहरण: A + B = C गणना करें
    • पहले A, B; फिर C गणना करें
    • आगे के फॉरवर्ड पास में A, B आवश्यक नहीं
  • क्या हमें A और B सहेजने चाहिए या हटाने चाहिए?
    • बिना ग्रेडिएंट चेकपॉइंटिंग: A, B सहेजें
    • ग्रेडिएंट चेकपॉइंटिंग: A, B हटाएँ

नोड्स और एज के साथ ग्रेडिएंट चेकपॉइंटिंग दर्शाता ग्राफ

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

ग्रेडिएंट चेकपॉइंटिंग क्या है?

  • ग्रेडिएंट चेकपॉइंटिंग: किन एक्टिवेशन्स को सहेजना है चुनकर मेमोरी घटाएँ
  • उदाहरण: A + B = C गणना करें
    • पहले A, B; फिर C गणना करें
    • आगे के फॉरवर्ड पास में A, B आवश्यक नहीं
  • क्या हमें A और B सहेजने चाहिए या हटाने चाहिए?
    • बिना ग्रेडिएंट चेकपॉइंटिंग: A, B सहेजें
    • ग्रेडिएंट चेकपॉइंटिंग: A, B हटाएँ
    • बैकवर्ड पास में A, B पुनः गणना करें

नोड्स और एज के साथ ग्रेडिएंट चेकपॉइंटिंग दर्शाता ग्राफ

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

ग्रेडिएंट चेकपॉइंटिंग क्या है?

  • ग्रेडिएंट चेकपॉइंटिंग: किन एक्टिवेशन्स को सहेजना है चुनकर मेमोरी घटाएँ
  • उदाहरण: A + B = C गणना करें
    • पहले A, B; फिर C गणना करें
    • आगे के फॉरवर्ड पास में A, B आवश्यक नहीं
  • क्या हमें A और B सहेजने चाहिए या हटाने चाहिए?
    • बिना ग्रेडिएंट चेकपॉइंटिंग: A, B सहेजें
    • ग्रेडिएंट चेकपॉइंटिंग: A, B हटाएँ
    • बैकवर्ड पास में A, B पुनः गणना करें
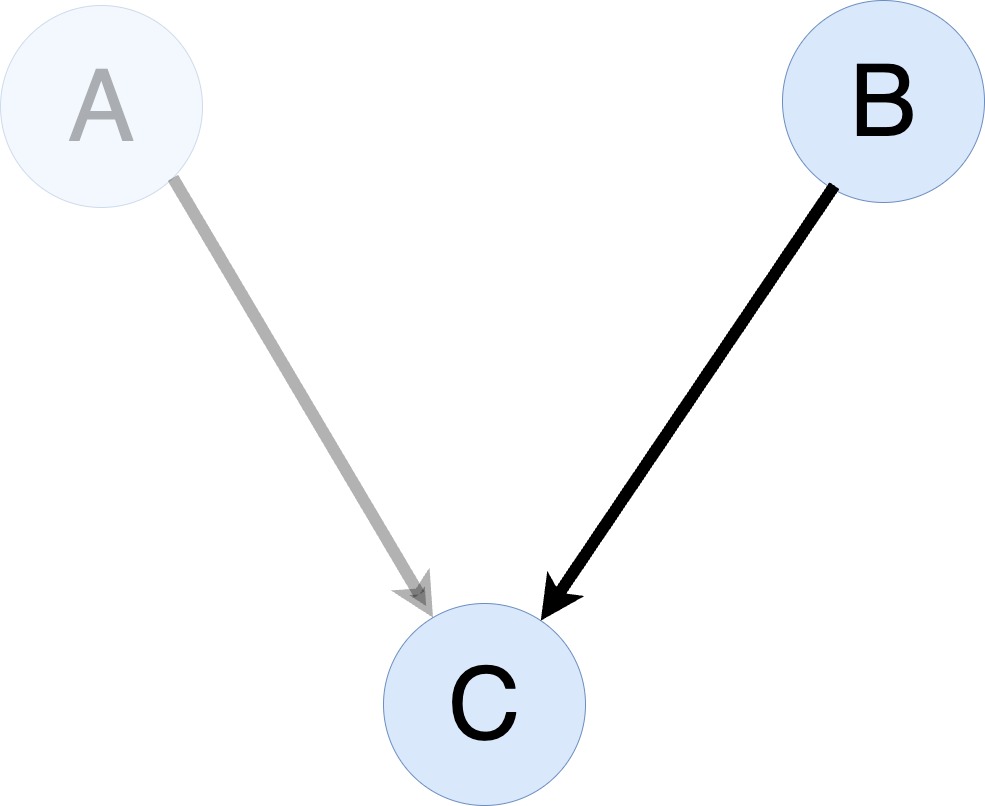
    • यदि B पुनर्गणना महँगा है, तो उसे सहेजें

नोड्स और एज के साथ ग्रेडिएंट चेकपॉइंटिंग दर्शाता ग्राफ

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

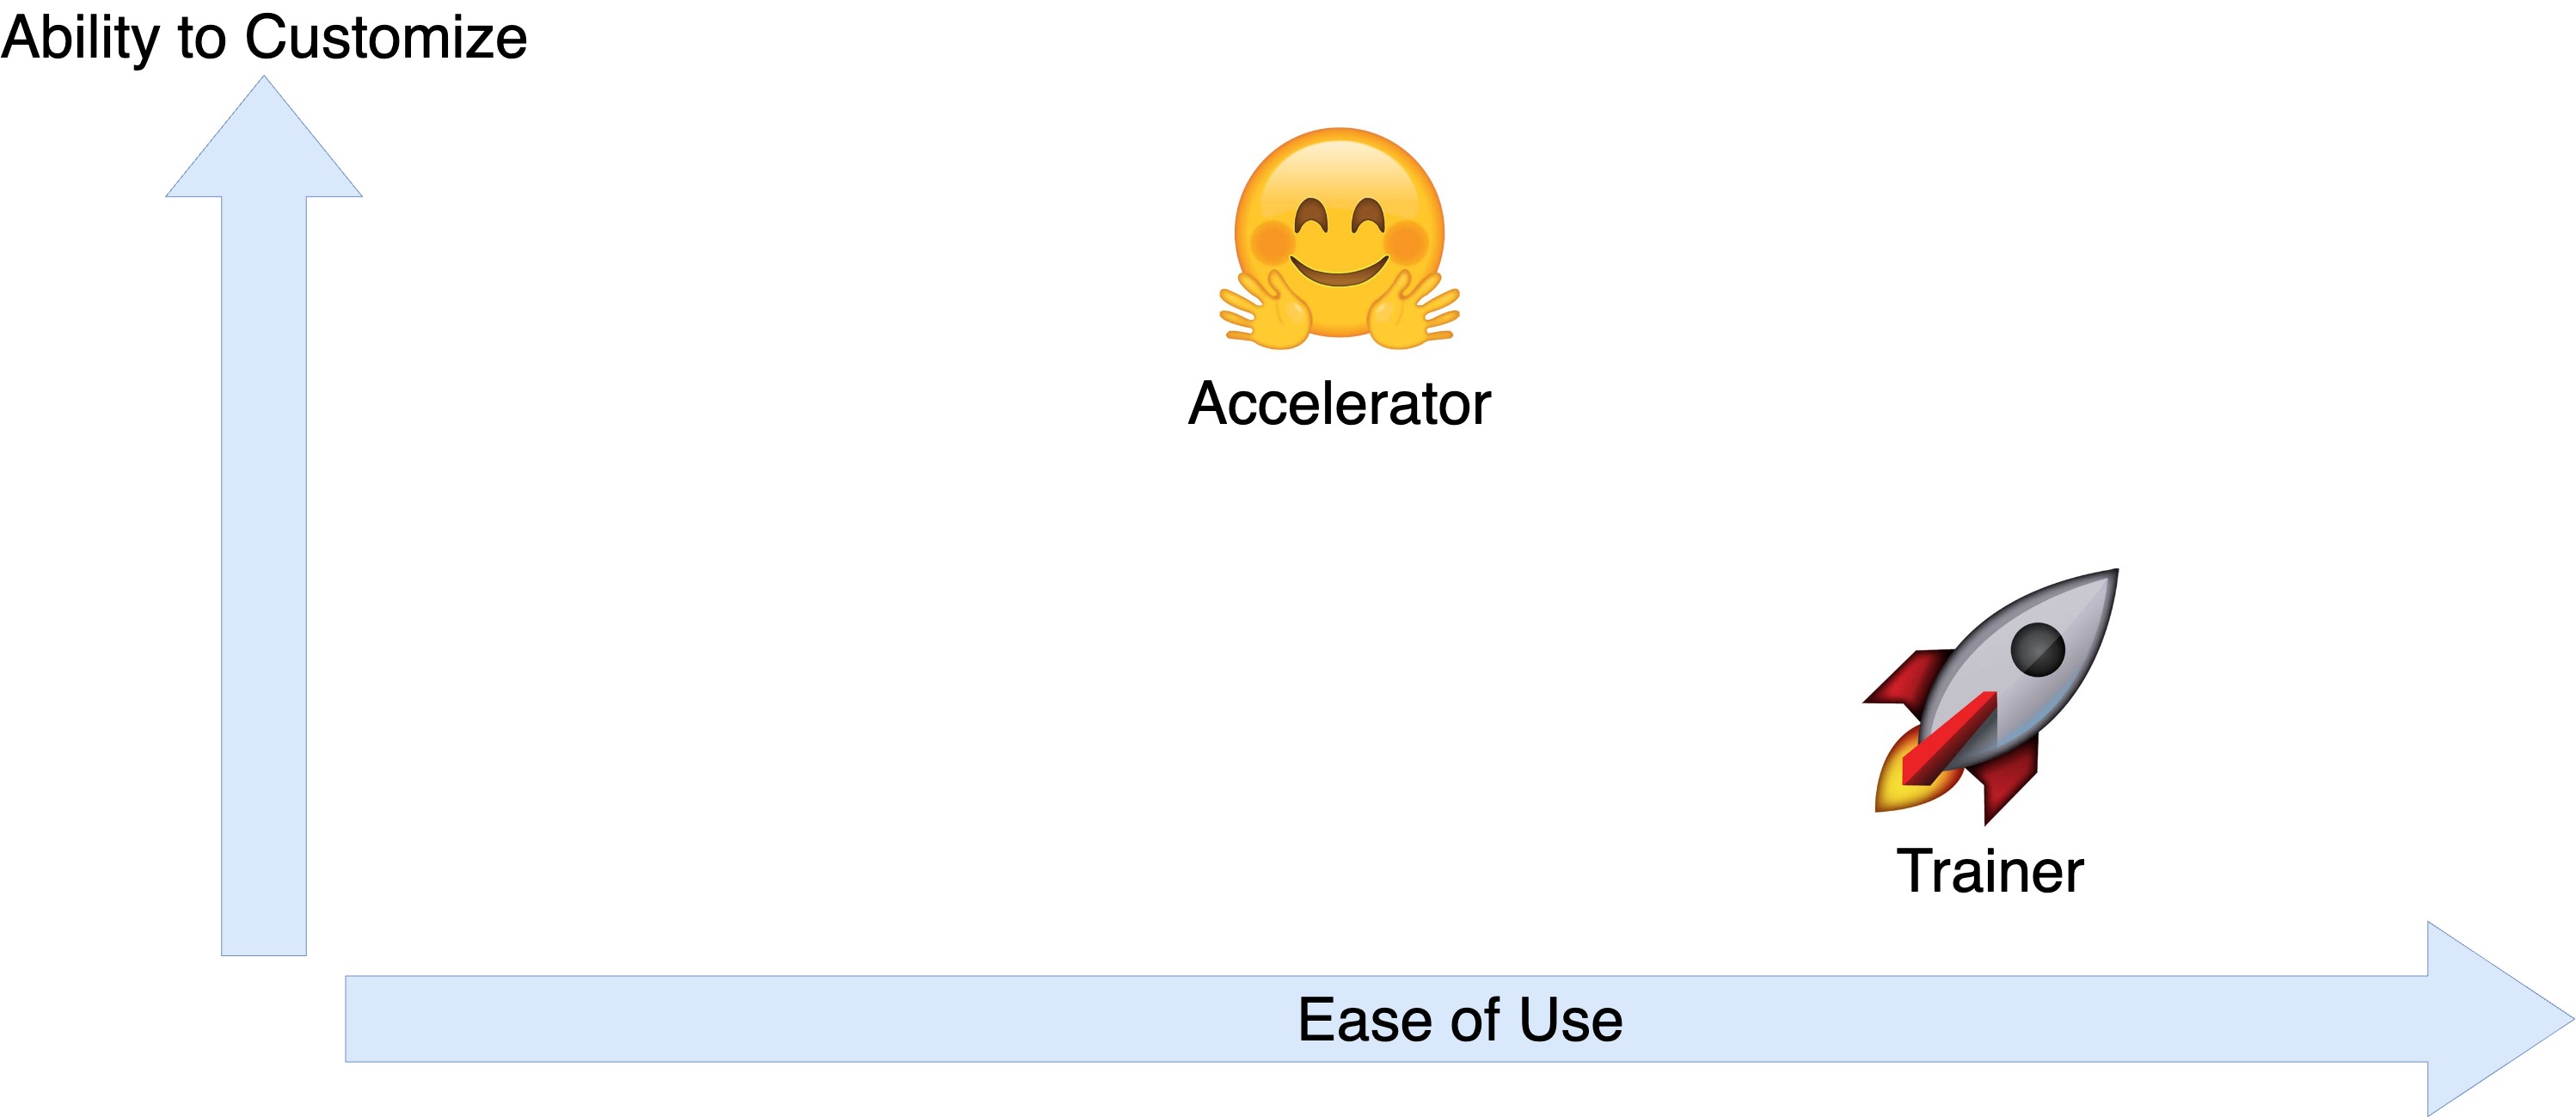
Trainer और Accelerator

Accelerator और Trainer के लिए उपयोग-सुगमता बनाम अनुकूलन-क्षमता तुलना चार्ट.

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

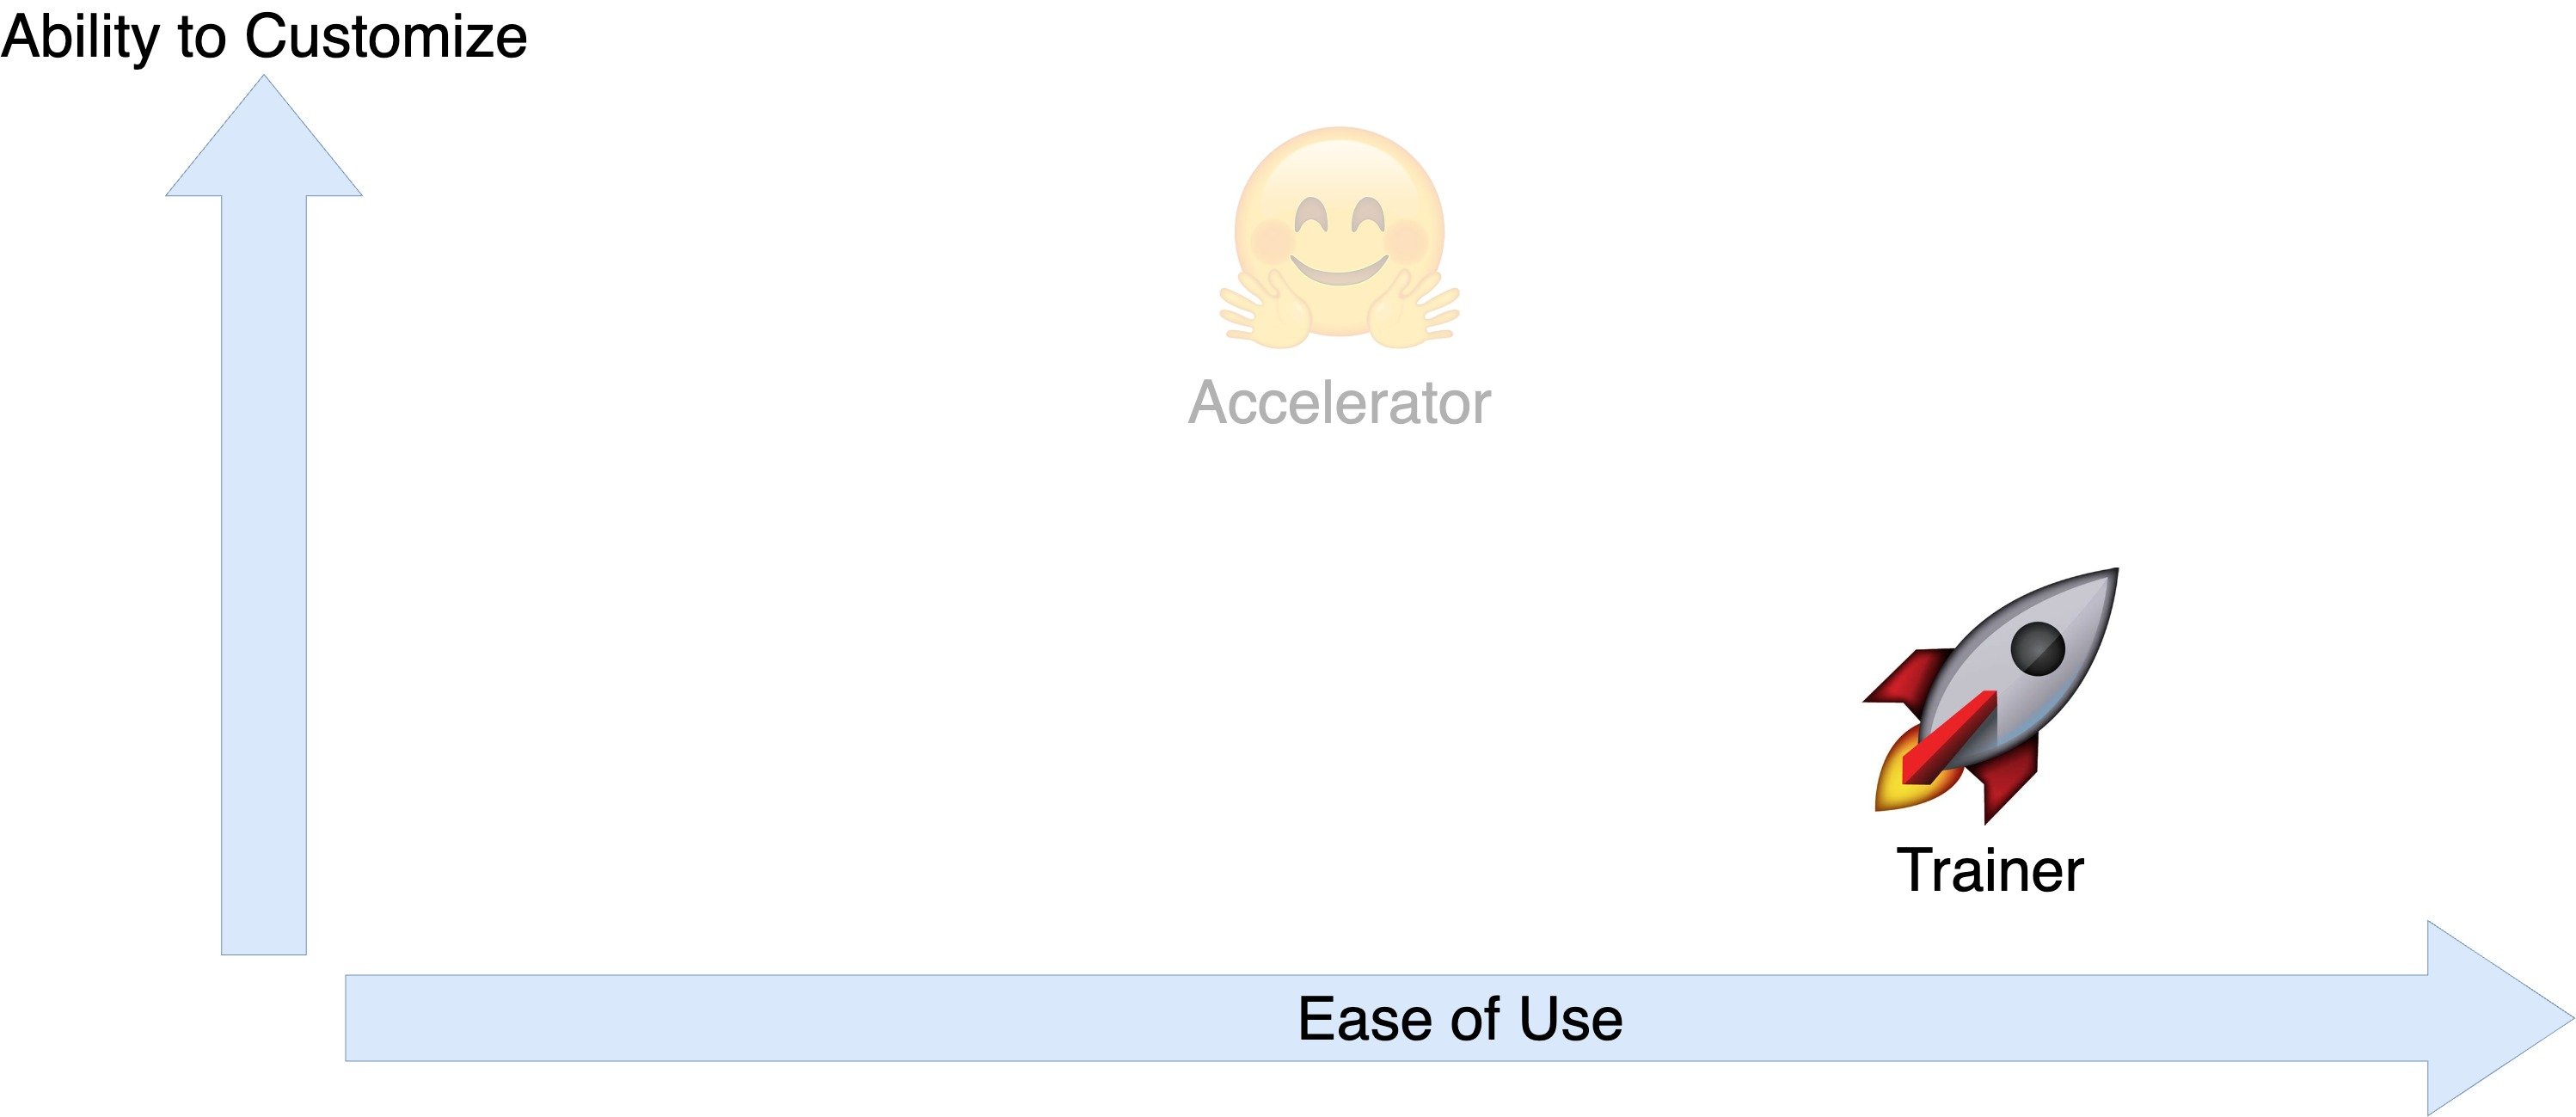
Trainer और Accelerator

Accelerator और Trainer के लिए उपयोग-सुगमता बनाम अनुकूलन-क्षमता तुलना चार्ट.

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

Trainer के साथ ग्रेडिएंट चेकपॉइंटिंग

training_args = TrainingArguments(output_dir="./results",
                                  evaluation_strategy="epoch",
                                  gradient_accumulation_steps=4)


PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

Trainer के साथ ग्रेडिएंट चेकपॉइंटिंग

training_args = TrainingArguments(output_dir="./results",
                                  evaluation_strategy="epoch",
                                  gradient_accumulation_steps=4,
                                  gradient_checkpointing=True)

trainer = Trainer(model=model, args=training_args, train_dataset=dataset["train"], eval_dataset=dataset["validation"], compute_metrics=compute_metrics)
trainer.train()
{'epoch': 1.0, 'eval_loss': 0.73, 'eval_accuracy': 0.03, 'eval_f1': 0.05}
PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

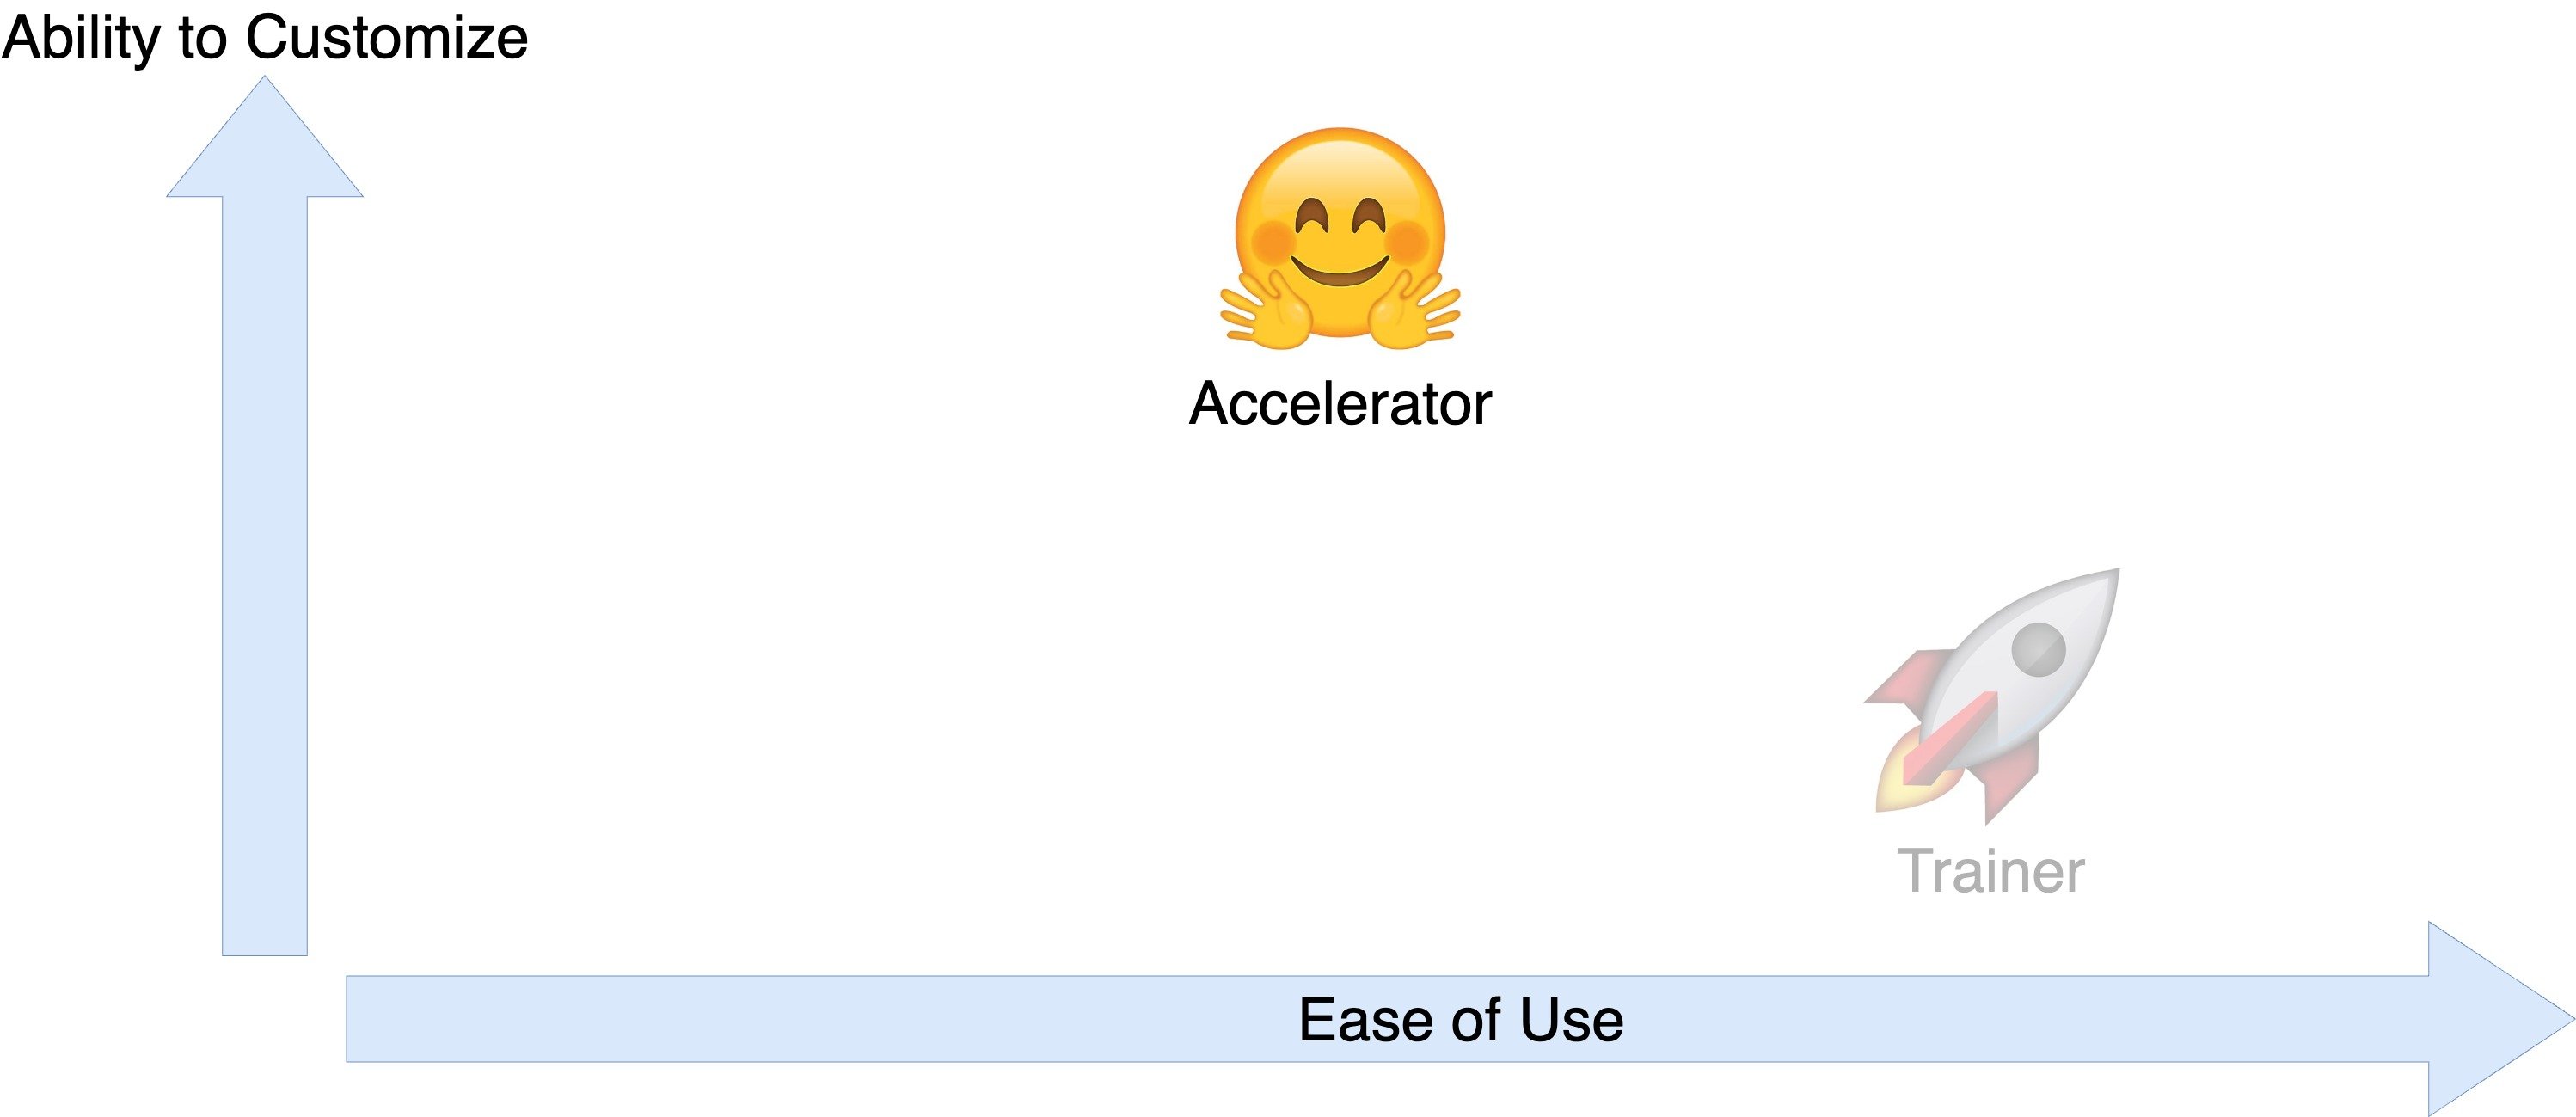
Trainer से Accelerator तक

Accelerator और Trainer के लिए उपयोग-सुगमता बनाम अनुकूलन-क्षमता तुलना चार्ट.

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

Accelerator के साथ ग्रेडिएंट चेकपॉइंटिंग

accelerator = Accelerator(gradient_accumulation_steps=2)


for index, batch in enumerate(dataloader):
    with accelerator.accumulate(model):
        inputs, targets = batch["input_ids"], batch["labels"]
        outputs = model(inputs, labels=targets)
        loss = outputs.loss
        accelerator.backward(loss)
        optimizer.step()
        lr_scheduler.step()
        optimizer.zero_grad()
PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

Accelerator के साथ ग्रेडिएंट चेकपॉइंटिंग

accelerator = Accelerator(gradient_accumulation_steps=2)
model.gradient_checkpointing_enable()

for index, batch in enumerate(dataloader):
    with accelerator.accumulate(model):
        inputs, targets = batch["input_ids"], batch["labels"]
        outputs = model(inputs, labels=targets)
        loss = outputs.loss
        accelerator.backward(loss)
        optimizer.step()
        lr_scheduler.step()
        optimizer.zero_grad()
PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

लोकल SGD से संचार दक्षता बढ़ती है


मेमोरी, संचार, और कम्प्यूटेशन दक्षता दर्शाते आइकन्स.

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

लोकल SGD क्या है?

कुछ स्टेप्स बाद ग्रेडिएंट सिंक्रोनाइज़ेशन से लोकल SGD कैसे काम करता है, दर्शाता चित्र.

  • प्रत्येक डिवाइस समानांतर में ग्रेडिएंट्स गणना करता है
PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

लोकल SGD क्या है?

कुछ स्टेप्स बाद ग्रेडिएंट सिंक्रोनाइज़ेशन से लोकल SGD कैसे काम करता है, दर्शाता चित्र.

  • प्रत्येक डिवाइस समानांतर में ग्रेडिएंट्स गणना करता है
  • ग्रेडिएंट सिंक्रोनाइज़ेशन: ड्राइवर नोड हर डिवाइस पर मॉडल पैरामीटर्स अपडेट करता है
  • लोकल SGD: ग्रेडिएंट सिंक्रोनाइज़ेशन की आवृत्ति घटाएँ
PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

Accelerator के साथ लोकल SGD


for index, batch in enumerate(dataloader):
    with accelerator.accumulate(model):
        inputs, targets = batch["input_ids"], batch["labels"]
        outputs = model(inputs, labels=targets)
        loss = outputs.loss
        accelerator.backward(loss)
        optimizer.step()
        lr_scheduler.step()
        optimizer.zero_grad()

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

Accelerator के साथ लोकल SGD

from accelerate.local_sgd import LocalSGD

with LocalSGD(accelerator=accelerator, model=model, local_sgd_steps=8, 
              enabled=True) as local_sgd:
    for index, batch in enumerate(dataloader):
        with accelerator.accumulate(model):
            inputs, targets = batch["input_ids"], batch["labels"]
            outputs = model(inputs, labels=targets)
            loss = outputs.loss
            accelerator.backward(loss)
            optimizer.step()
            lr_scheduler.step()
            optimizer.zero_grad()

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

Accelerator के साथ लोकल SGD

from accelerate.local_sgd import LocalSGD

with LocalSGD(accelerator=accelerator, model=model, local_sgd_steps=8, 
              enabled=True) as local_sgd:
    for index, batch in enumerate(dataloader):
        with accelerator.accumulate(model):
            inputs, targets = batch["input_ids"], batch["labels"]
            outputs = model(inputs, labels=targets)
            loss = outputs.loss
            accelerator.backward(loss)
            optimizer.step()
            lr_scheduler.step()
            optimizer.zero_grad()
            local_sgd.step()
PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

Passons à la pratique !

PyTorch के साथ कुशल AI मॉडल प्रशिक्षण

Preparing Video For Download...