Ajustați modelele cu Trainer

Antrenament eficient al modelelor AI cu PyTorch

Dennis Lee

Data Engineer, Amazon

Pregătirea datelor
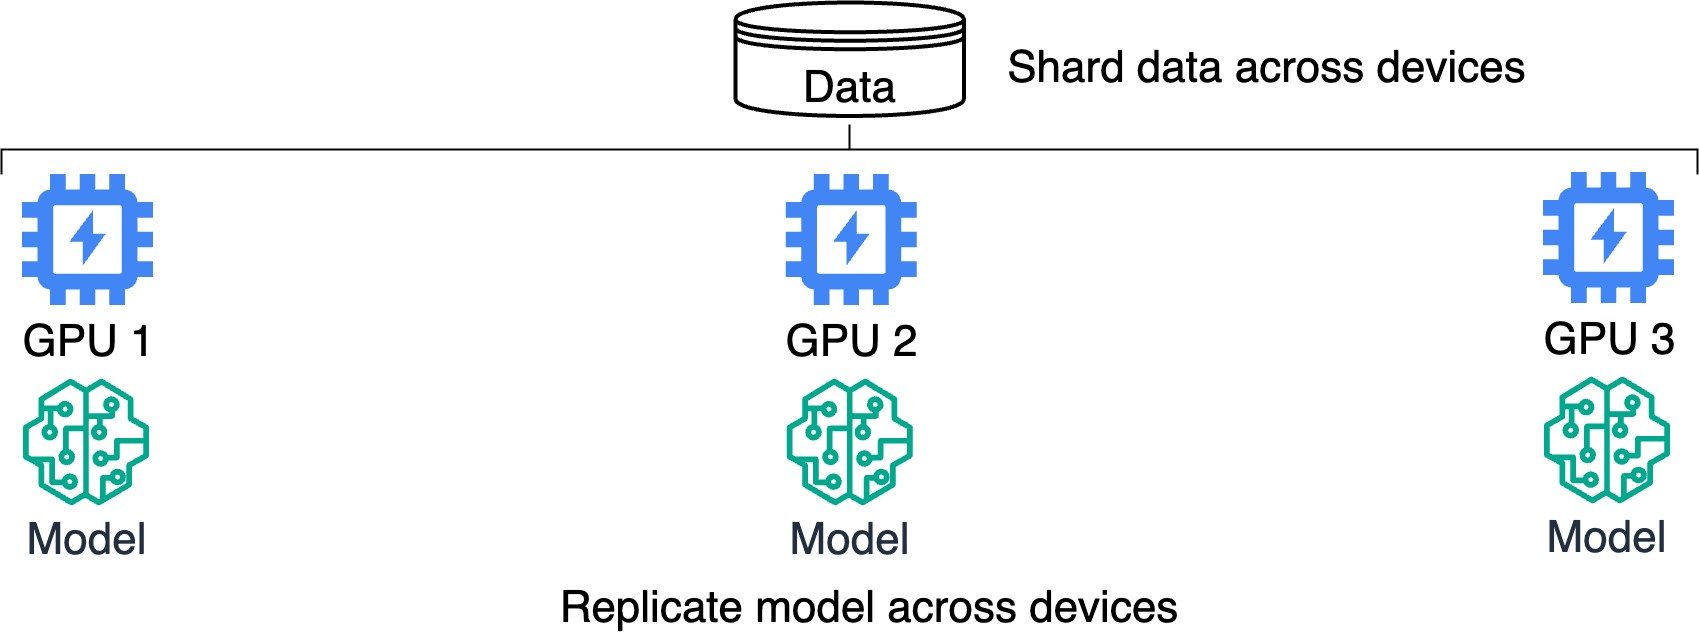
 

Diagramă a antrenamentului distribuit cu replicarea modelului și fragmentarea datelor.

Antrenament eficient al modelelor AI cu PyTorch

Antrenament distribuit


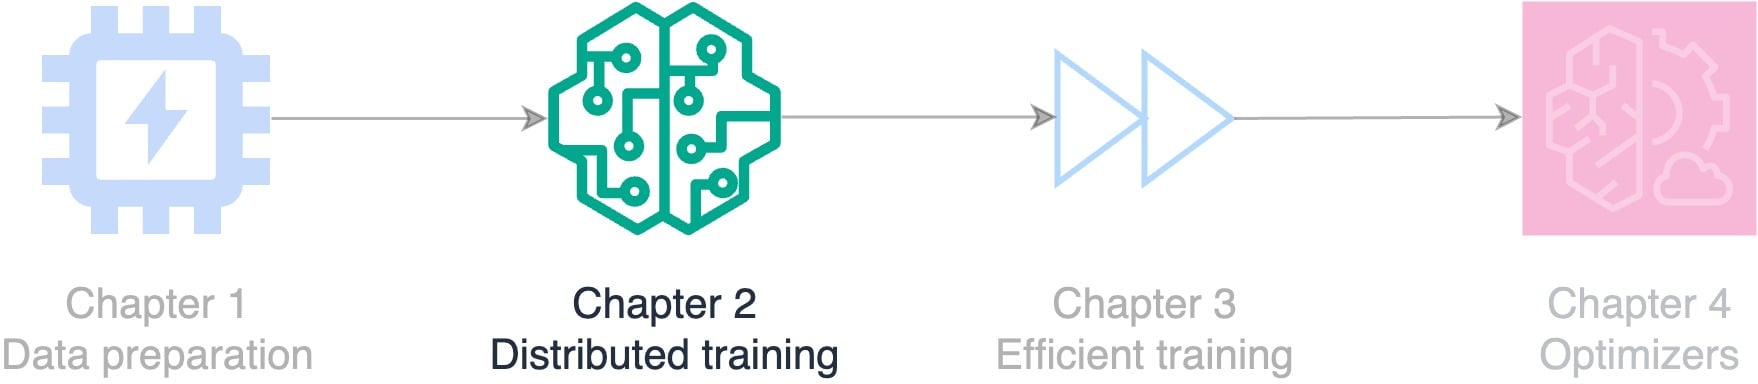
Diagramă ilustrând subiectele cursului: pregătirea datelor, antrenament distribuit, antrenament eficient și optimizatori.

Antrenament eficient al modelelor AI cu PyTorch

Trainer și Accelerator

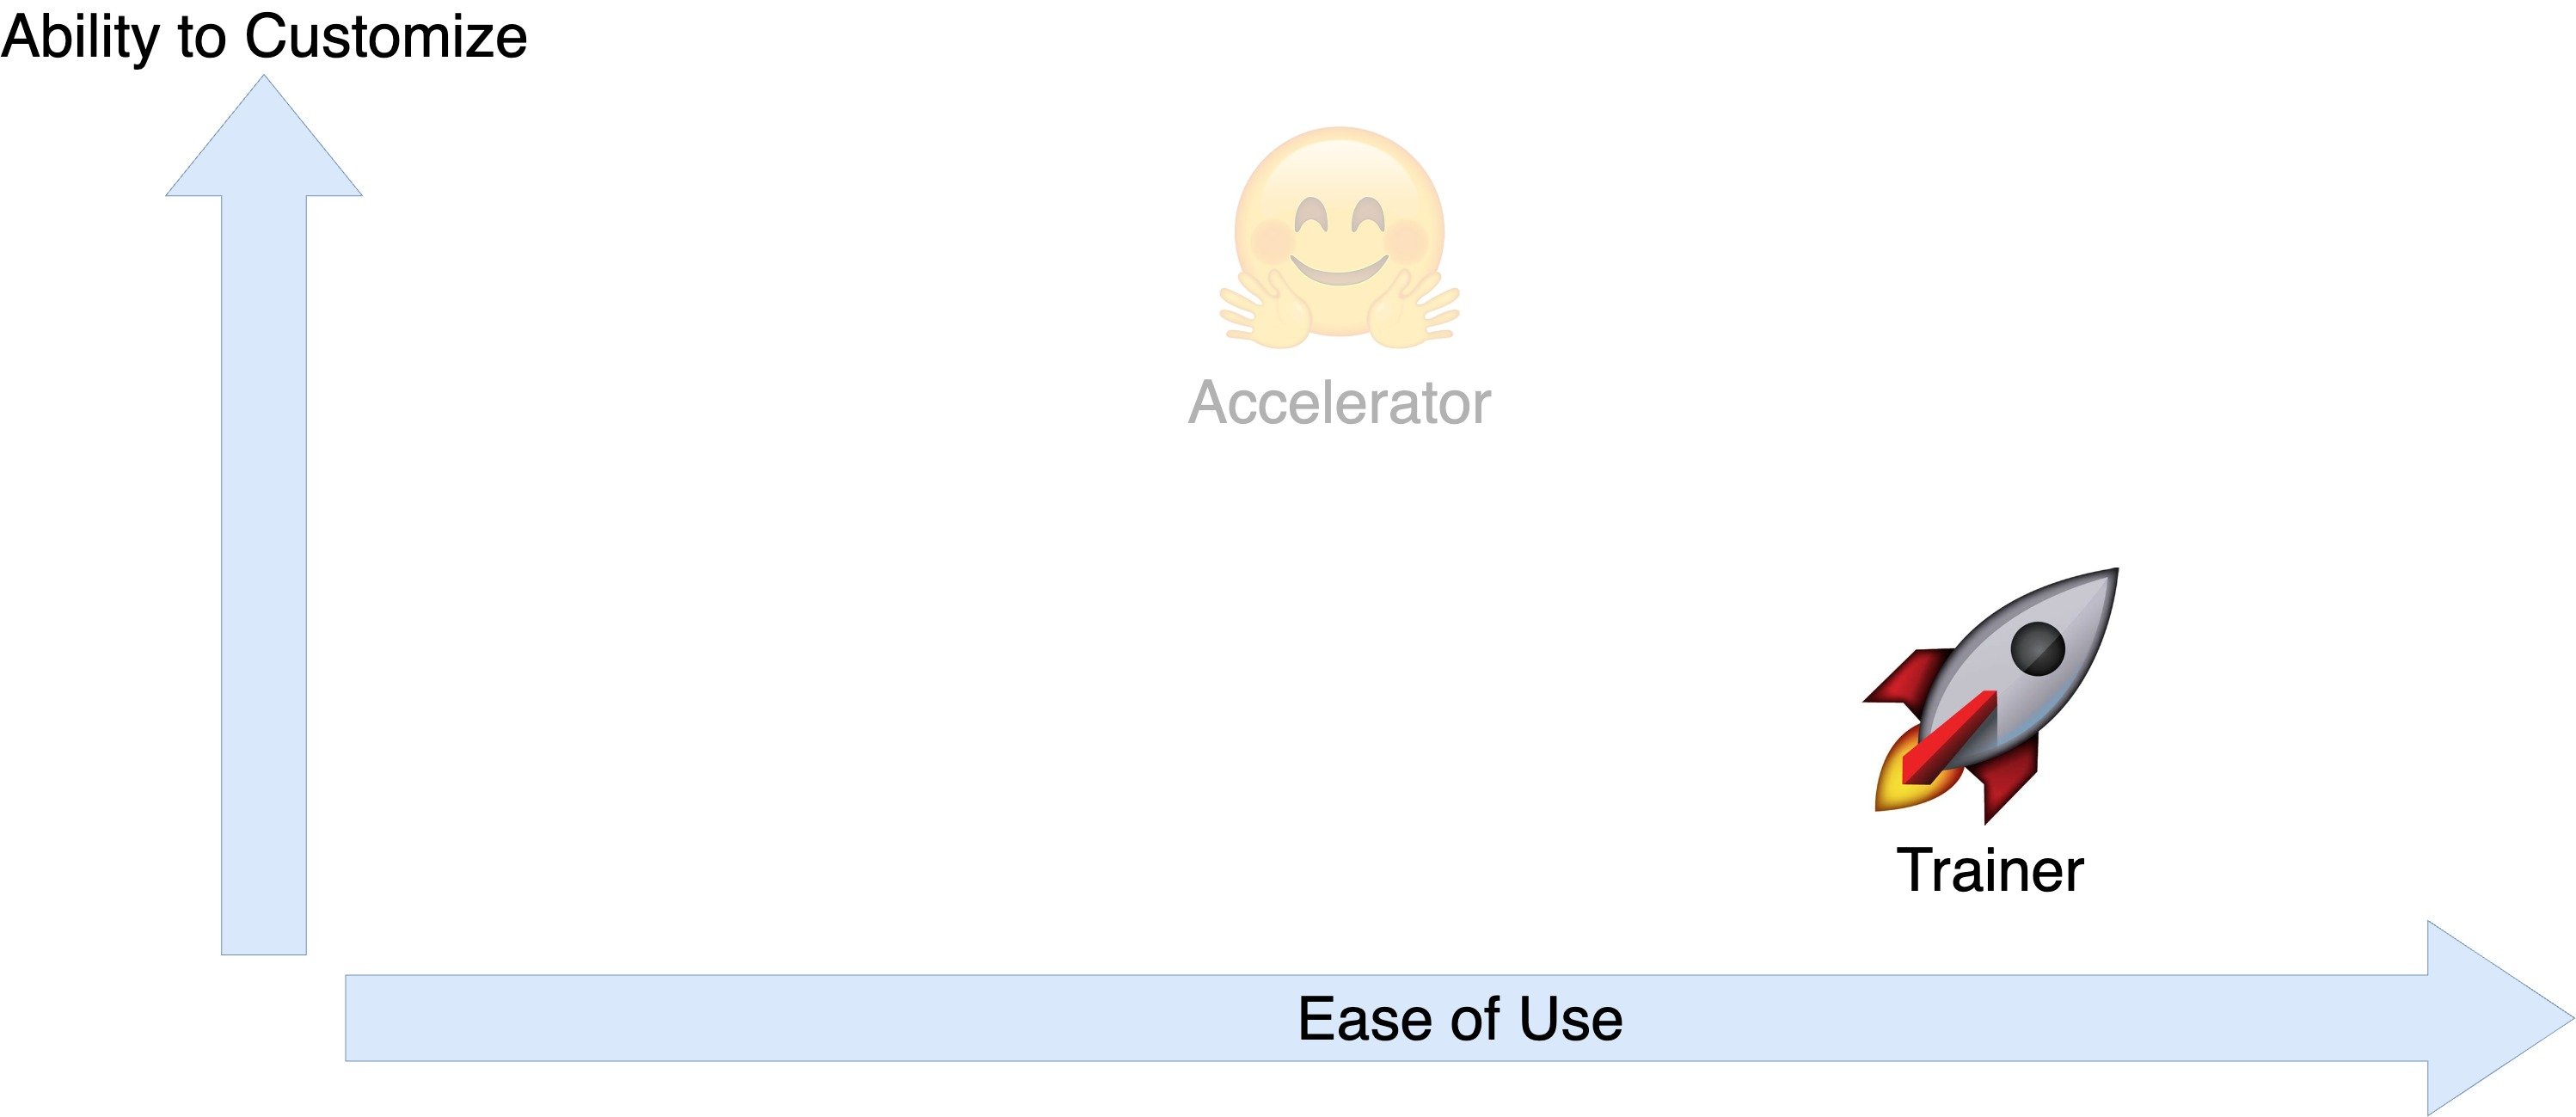
Grafic comparând ușurința utilizării față de capacitatea de personalizare pentru Accelerator și Trainer.

Antrenament eficient al modelelor AI cu PyTorch

Trainer și Accelerator

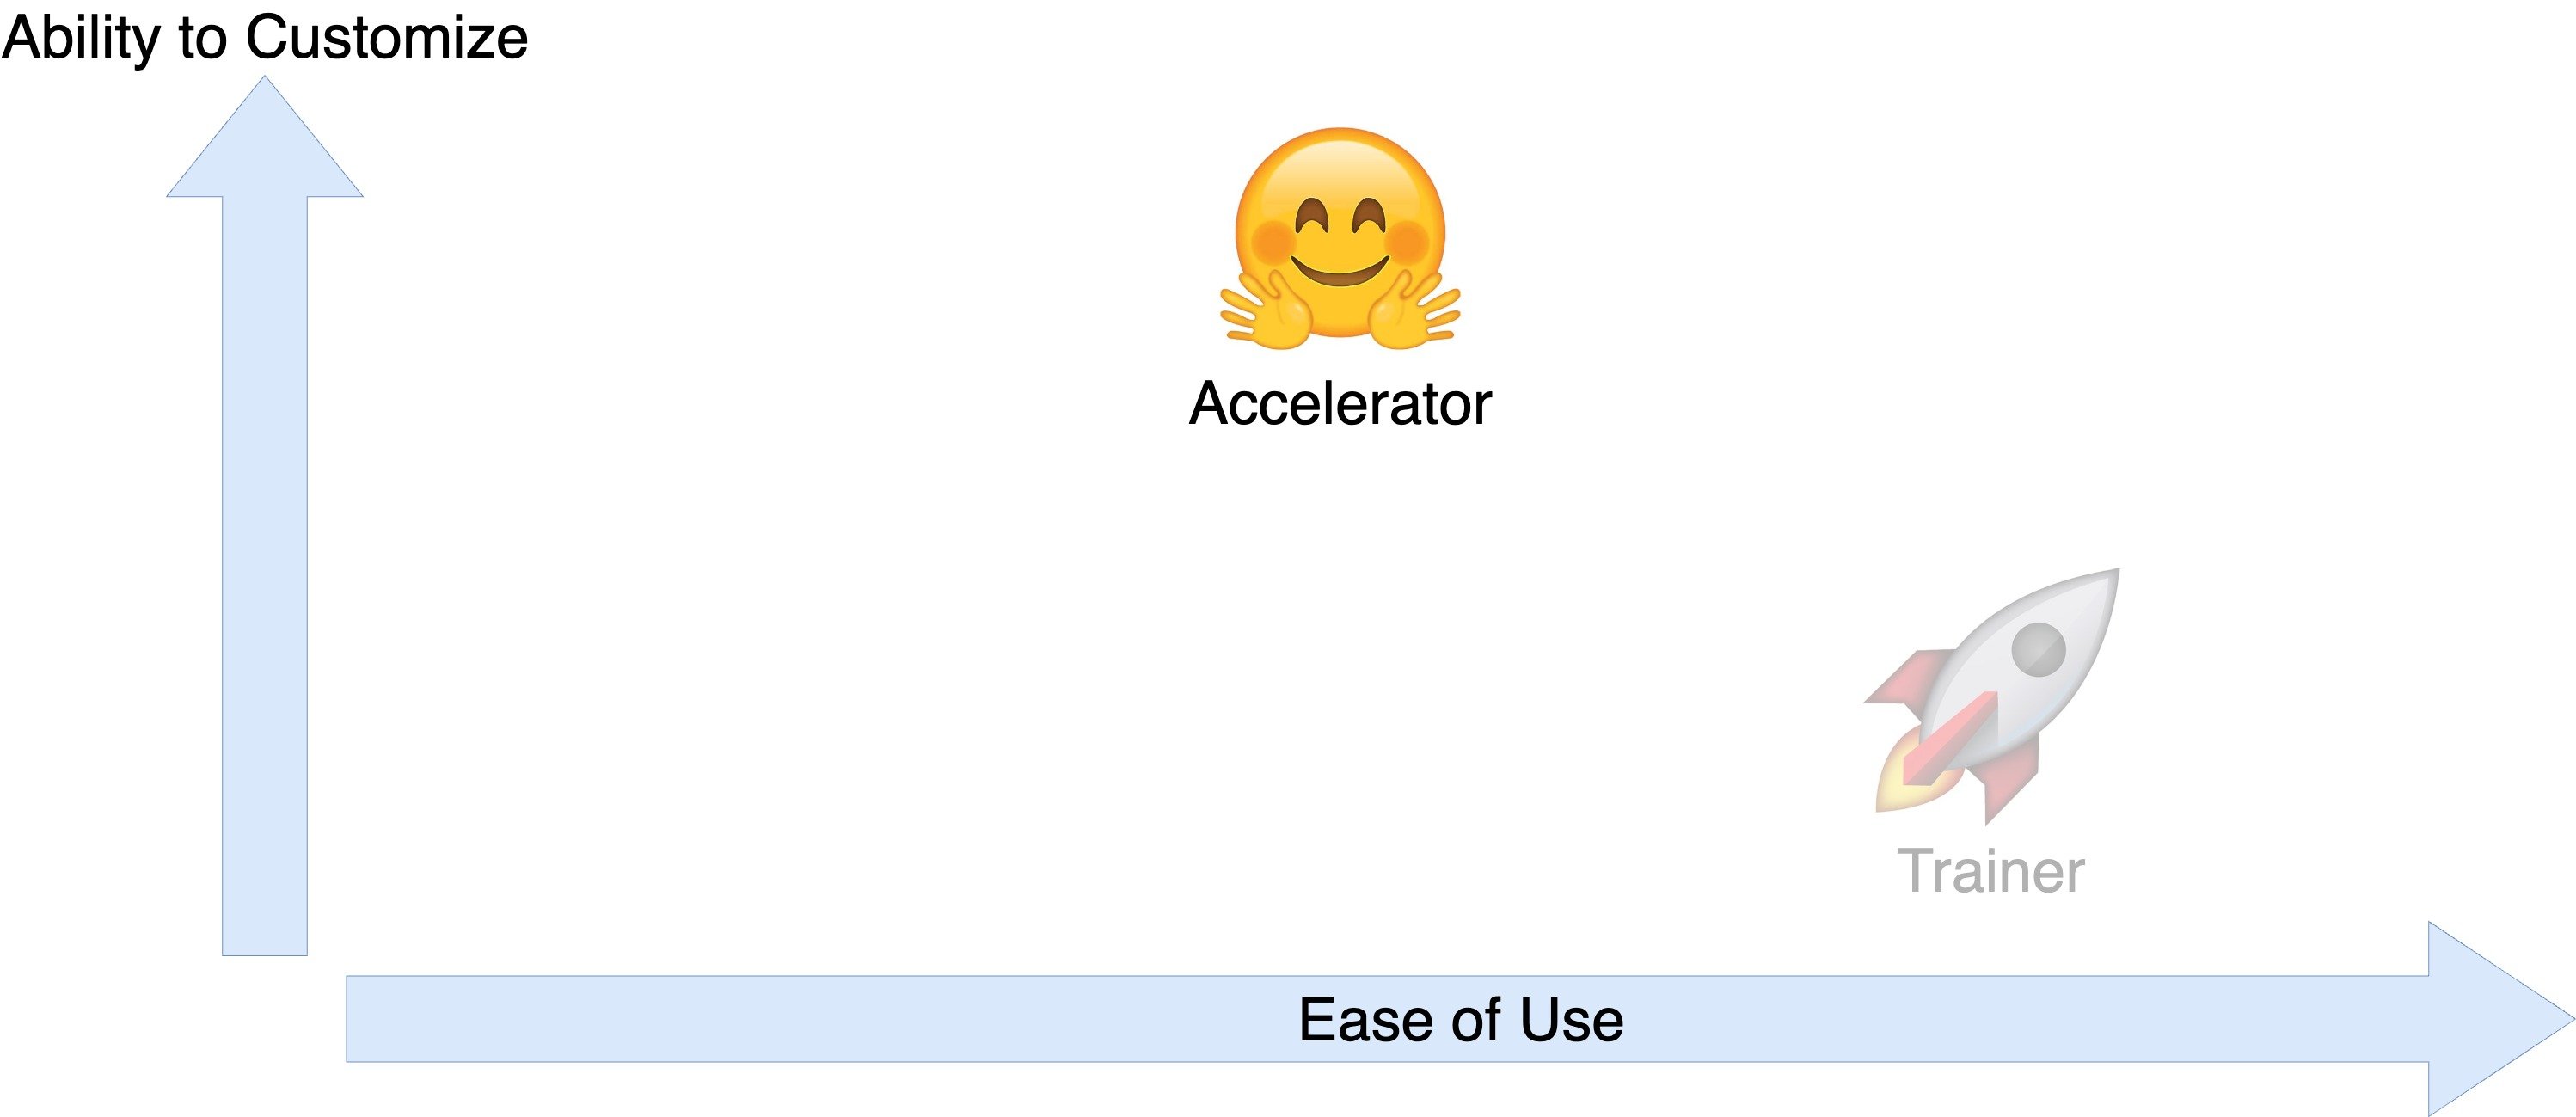
Grafic comparând ușurința utilizării față de capacitatea de personalizare pentru Accelerator și Trainer.

Antrenament eficient al modelelor AI cu PyTorch

Accelerați antrenamentul cu Trainer

  • Biblioteca Trainer

    from transformers import Trainer
    
  • Rulați modelul pe fiecare dispozitiv în paralel

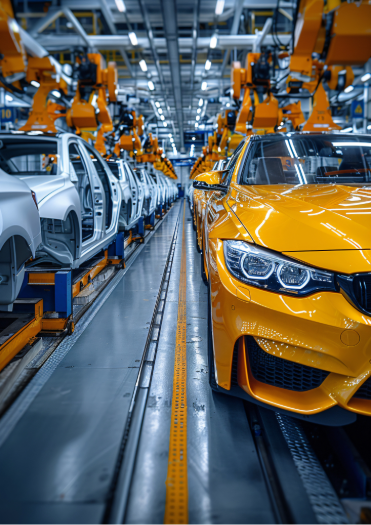
  • Accelerați antrenamentul, ca pe o linie de asamblare
  • Revizuiți intrările: set de date, model, metrici
  • Dezvoltați analiza sentimentului pentru e-commerce

Imagine cu fabricarea mașinilor pe linii de asamblare, ilustrând procesarea paralelă.

Antrenament eficient al modelelor AI cu PyTorch

Set de date pentru sentimentul recenziilor

print(dataset)
DatasetDict({
    train: Dataset({
        features: ['Text', 'Label'],
        num_rows: 1000
    }), ...})
print(f'"{dataset["train"]["Text"][0]}": {dataset["train"]["Label"][0]}')
"I love this product!": positive
Antrenament eficient al modelelor AI cu PyTorch

Convertiți etichetele în numere întregi

def map_labels(example):
    if example["Label"] == "negative":
        return {"labels": 0}

else: return {"labels": 1} dataset = dataset.map(map_labels)
print(f'First label: {dataset["train"]["labels"][0]}')
First label: 1
Antrenament eficient al modelelor AI cu PyTorch

Definiți tokenizatorul și modelul

  • Încărcați modelul pre-antrenat și tokenizatorul:
model = AutoModelForSequenceClassification.from_pretrained("distilbert-base-uncased", 
                                                           num_labels=2)

tokenizer = AutoTokenizer.from_pretrained("distilbert-base-uncased")
  • Aplicați tokenizatorul câmpului text:
def encode(examples):

return tokenizer(examples["Text"], padding="max_length", truncation=True, return_tensors="pt")
dataset = dataset.map(encode, batched=True)
print(f'The first tokenized review is {dataset["train"]["input_ids"][0]}.')
The first tokenized review is [101, 1045, 2293, 2023, 4031, 999, 102].
Antrenament eficient al modelelor AI cu PyTorch

Definiți metricile de evaluare

import evaluate


def compute_metrics(eval_predictions):
load_accuracy = evaluate.load("accuracy") load_f1 = evaluate.load("f1")
logits, labels = eval_predictions
predictions = np.argmax(logits, axis=-1)
accuracy = load_accuracy.compute(predictions=predictions, references=labels)[ "accuracy" ]
f1 = load_f1.compute(predictions=predictions, references=labels)["f1"]
return {"accuracy": accuracy, "f1": f1}
Antrenament eficient al modelelor AI cu PyTorch

Argumente de antrenament

  • output_dir: Unde se salvează modelul
  • Specificați hiperparametrii (ex.: learning_rate și weight_decay)
  • save_strategy: Salvați după fiecare epocă
  • evaluation_strategy: Evaluați metricile după fiecare epocă
from transformers import (
    TrainingArguments)

training_args = TrainingArguments(
    output_dir="output_folder",

learning_rate=2e-5, per_device_train_batch_size=16, per_device_eval_batch_size=16, num_train_epochs=2, weight_decay=0.01,
save_strategy="epoch", evaluation_strategy="epoch", )
Antrenament eficient al modelelor AI cu PyTorch

Configurarea Trainer

from transformers import Trainer

trainer = Trainer(model=model,

args=training_args,
train_dataset=dataset["train"], eval_dataset=dataset["validation"],
compute_metrics=compute_metrics)
trainer.train()
{'epoch': 1.0, 'eval_loss': 0.79, 'eval_accuracy': 0.00, 'eval_f1': 0.00}
{'epoch': 2.0, 'eval_loss': 0.65, 'eval_accuracy': 0.11, 'eval_f1': 0.15}
print(trainer.args.device)
cpu
Antrenament eficient al modelelor AI cu PyTorch

Analiza sentimentului pentru e-commerce

sample_review = "This product is amazing!"

input_ids = tokenizer.encode(sample_review, return_tensors='pt') print(f"Tokenized review: {input_ids}")
Tokenized review: tensor([[ 101, 2023, 4031, 2003, 6429,  999,  102 ]])
Antrenament eficient al modelelor AI cu PyTorch

Analiza sentimentului pentru e-commerce

output = model(input_ids)
print(f"Output logits: {output.logits}")
Output logits: tensor([[ -0.0538, 0.1300 ]])
predicted_label = torch.argmax(output.logits, dim=1).item()
print(f"Predicted label: {predicted_label}")
Predicted label: 1
sentiment = "Negative" if predicted_label == 0 else "Positive"
print(f'The sentiment of the product review is "{sentiment}."')
The sentiment of the product review is "Positive."
Antrenament eficient al modelelor AI cu PyTorch

Puncte de control cu Trainer

  • Reluați de la ultimul punct de control, ca la pauza unui film
trainer.train(resume_from_checkpoint=True)
{'epoch': 3.0, 'eval_loss': 0.29, 'eval_accuracy': 0.37, 'eval_f1': 0.51}
{'epoch': 4.0, 'eval_loss': 0.23, 'eval_accuracy': 0.46, 'eval_f1': 0.58}
  • Reluați de la un punct de control specific salvat în directorul de ieșire
trainer.train(resume_from_checkpoint="model/checkpoint-1000")
Antrenament eficient al modelelor AI cu PyTorch

Să exersăm!

Antrenament eficient al modelelor AI cu PyTorch

Preparing Video For Download...