Antrenament cu precizie mixtă folosind Adam pe 8 biți

Antrenament eficient al modelelor AI cu PyTorch

Dennis Lee

Data Engineer, Amazon

Optimizatori pentru eficiența antrenamentului
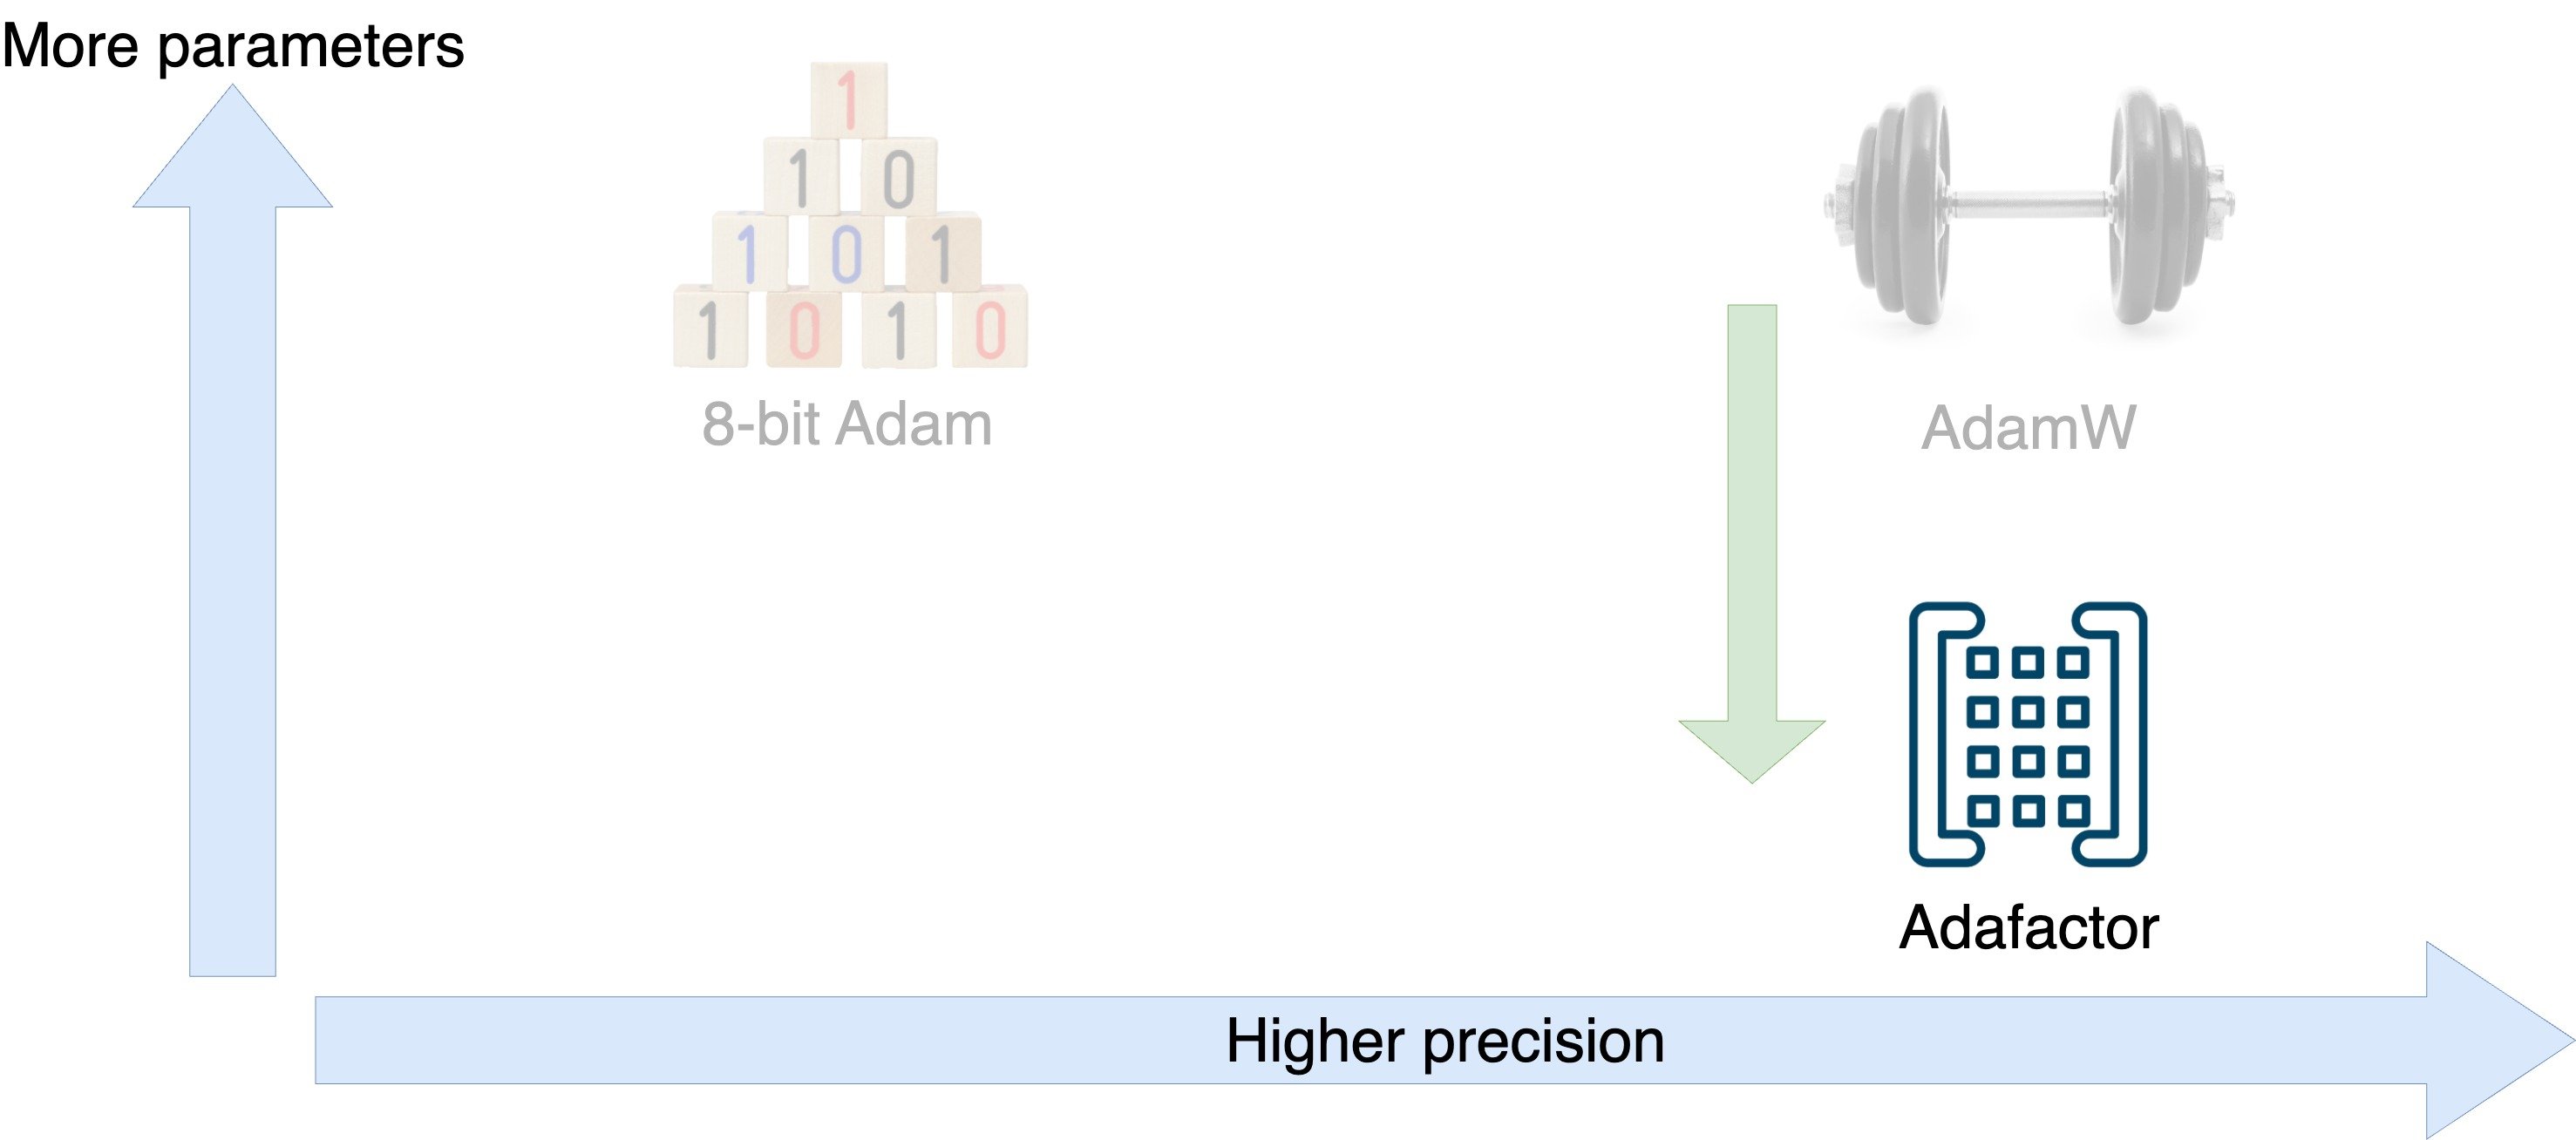
Diagramă cu compromisurile dintre numărul de parametri și precizie pentru AdamW, Adafactor și Adam pe 8 biți.

Antrenament eficient al modelelor AI cu PyTorch

Optimizatori pentru eficiența antrenamentului
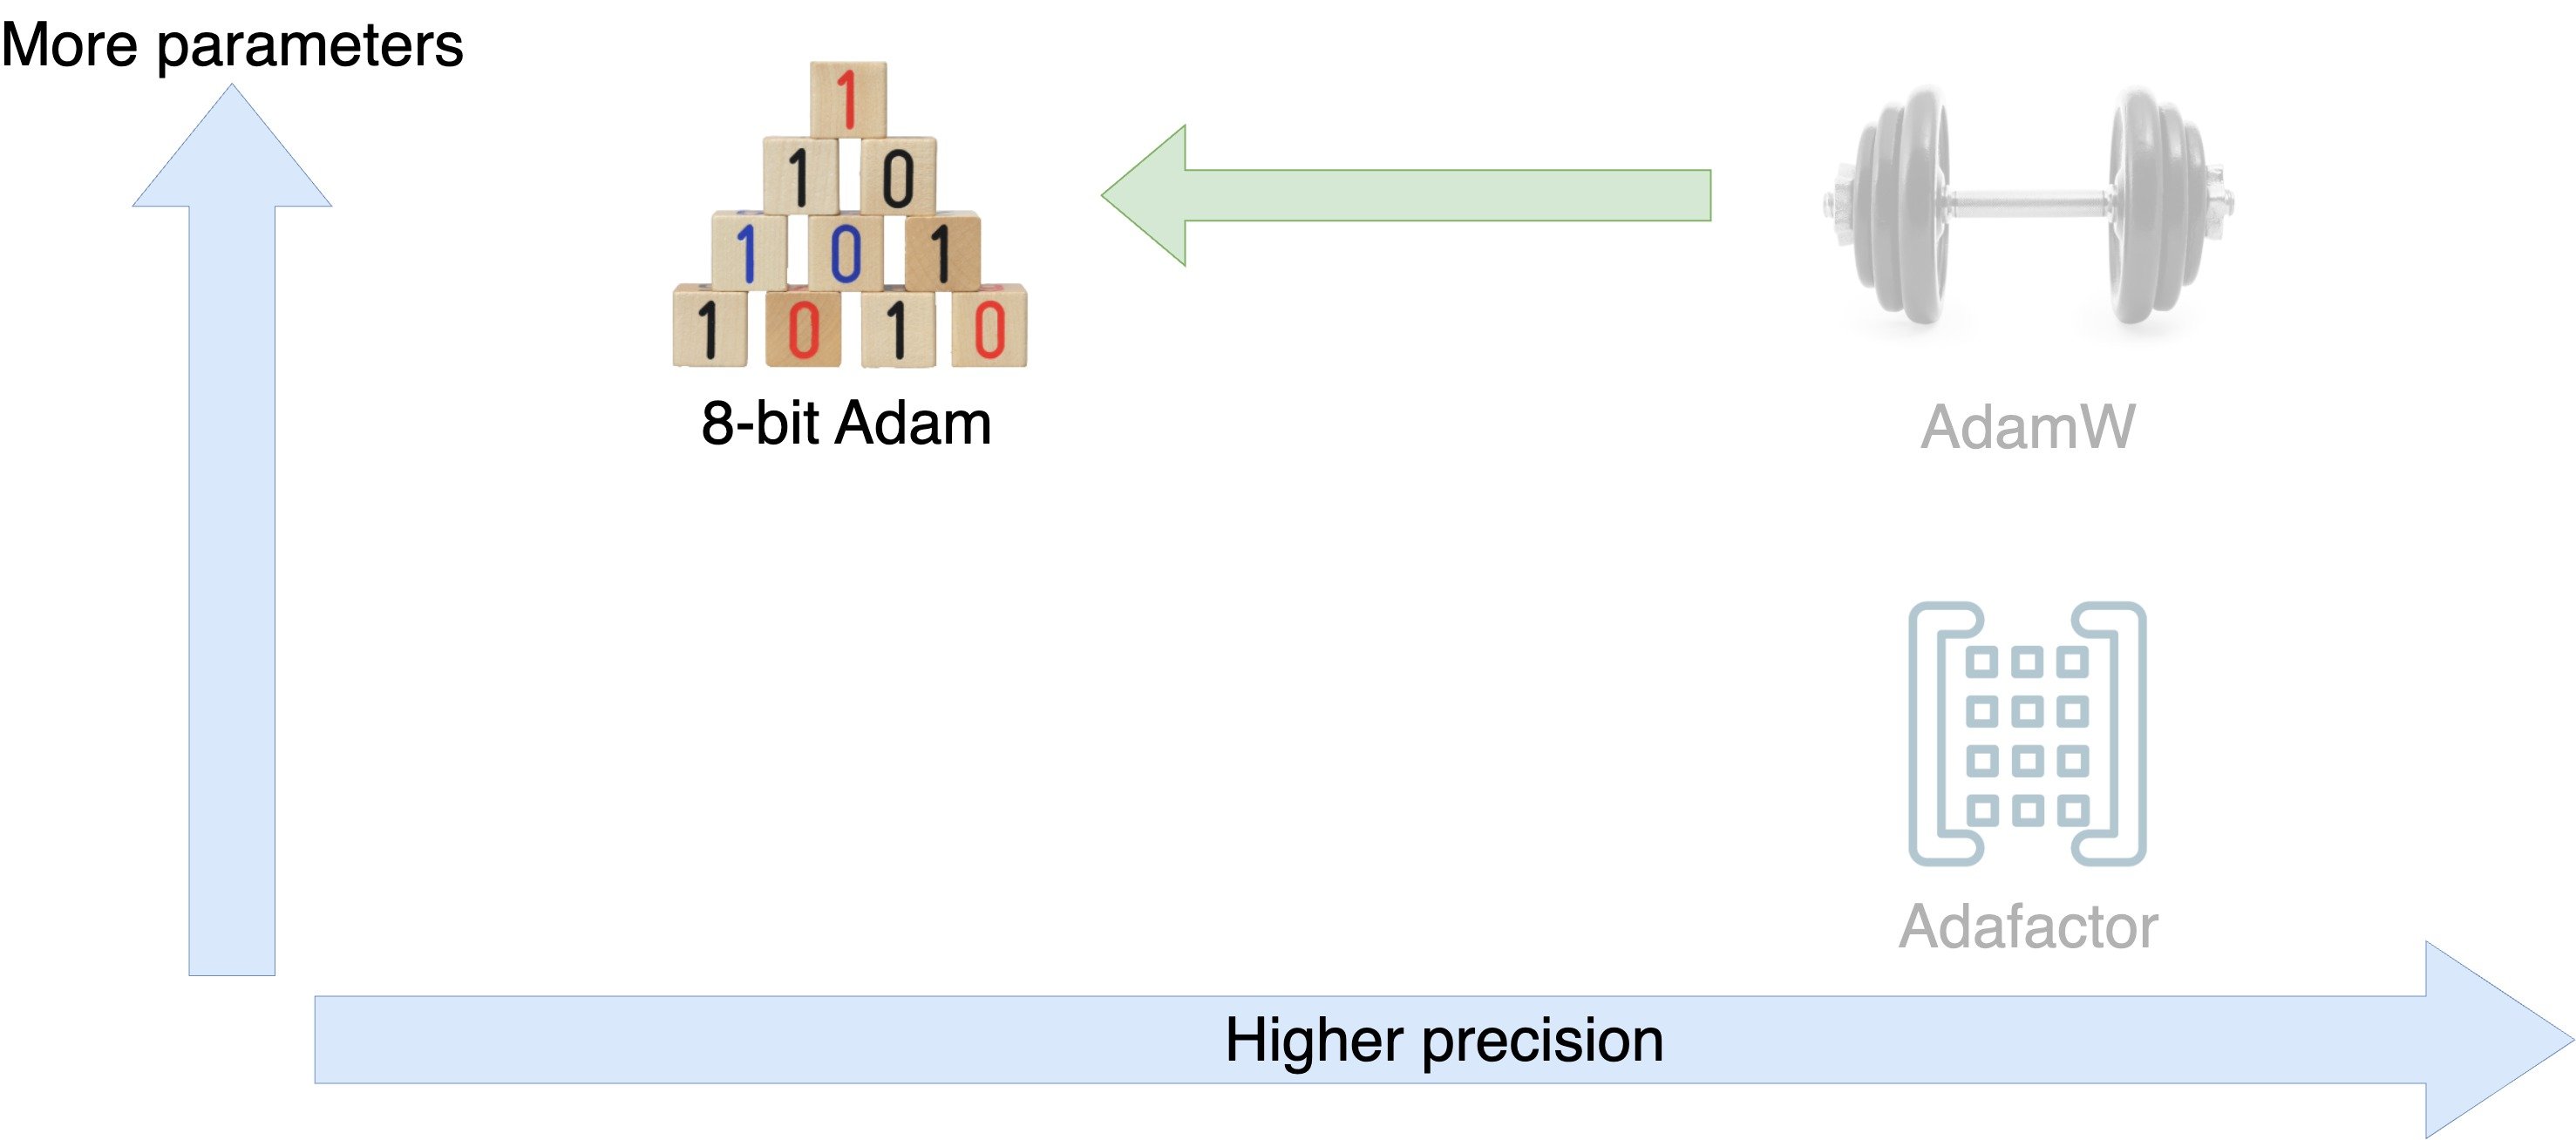
Diagramă cu compromisurile dintre numărul de parametri și precizie pentru AdamW, Adafactor și Adam pe 8 biți.

Antrenament eficient al modelelor AI cu PyTorch

Cum funcționează Adam pe 8 biți?

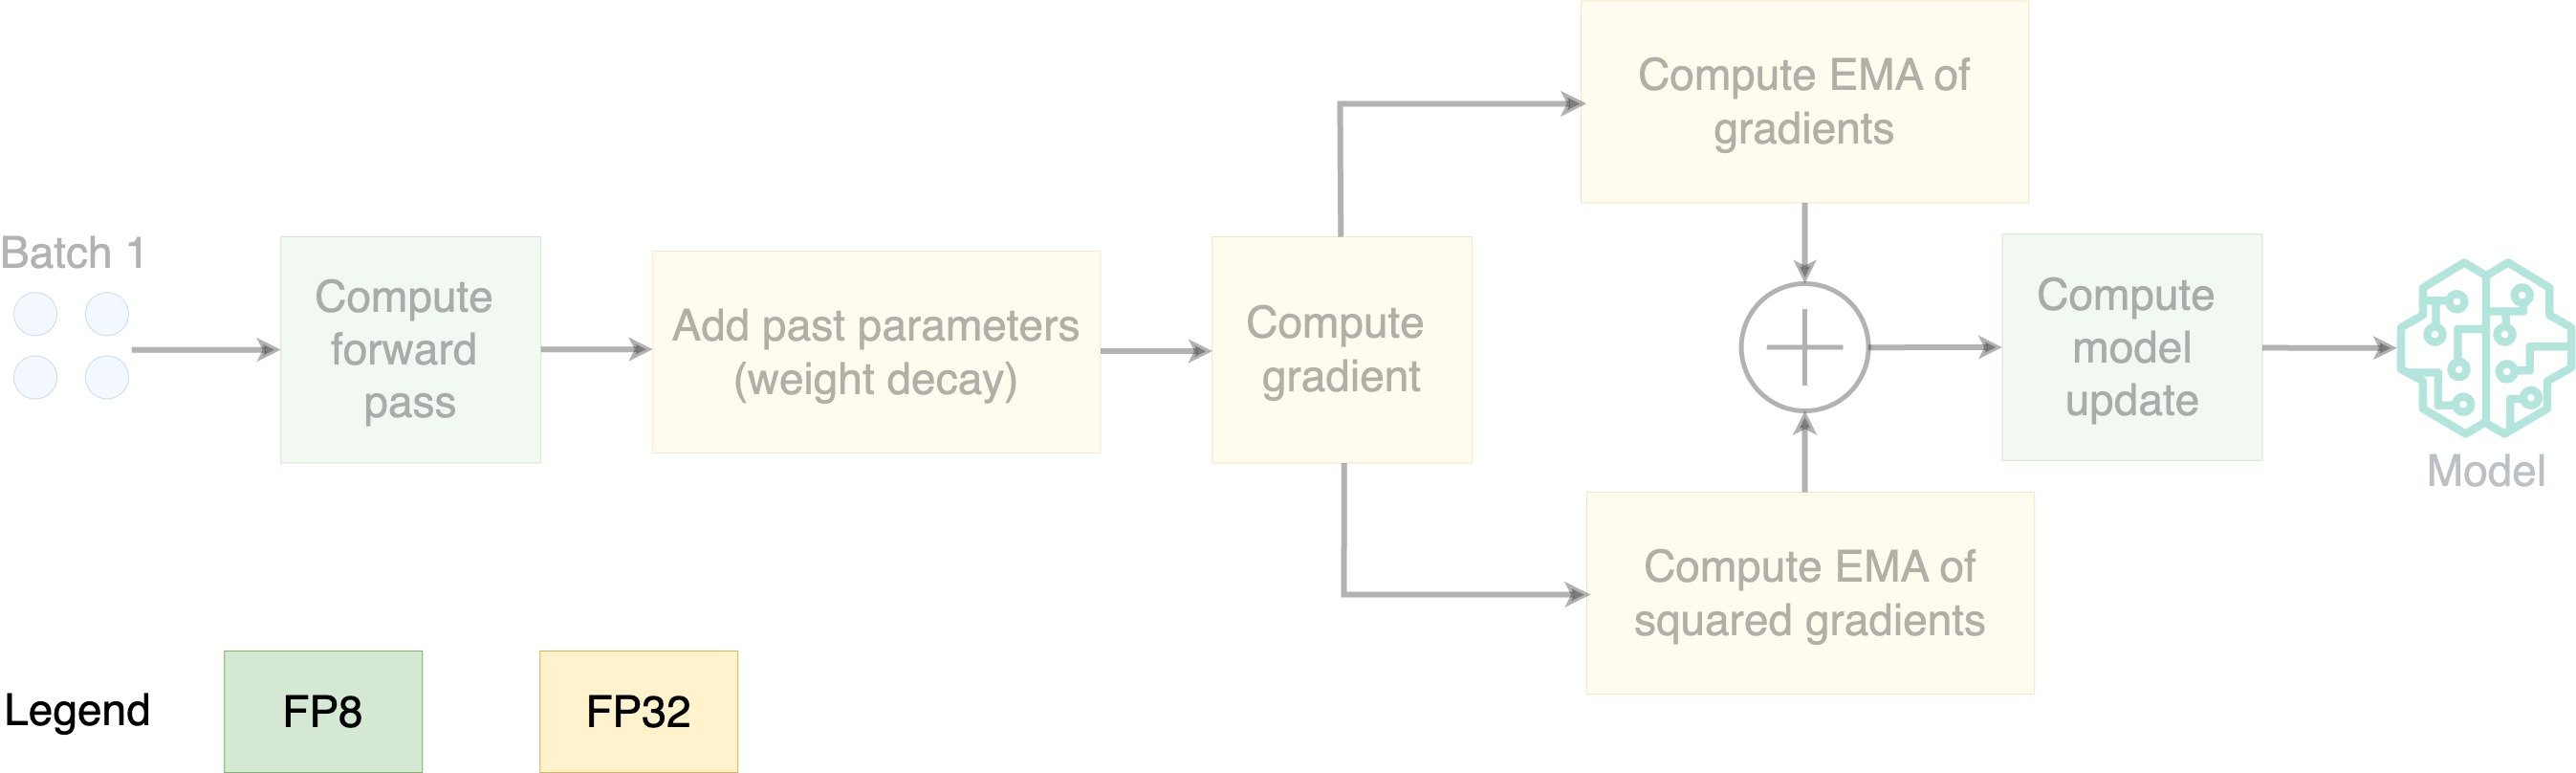
Diagramă cu pașii algoritmului Adam pe 8 biți.

  • Parametri stocați în FP8; optimizare în FP32
Antrenament eficient al modelelor AI cu PyTorch

Cum funcționează Adam pe 8 biți?

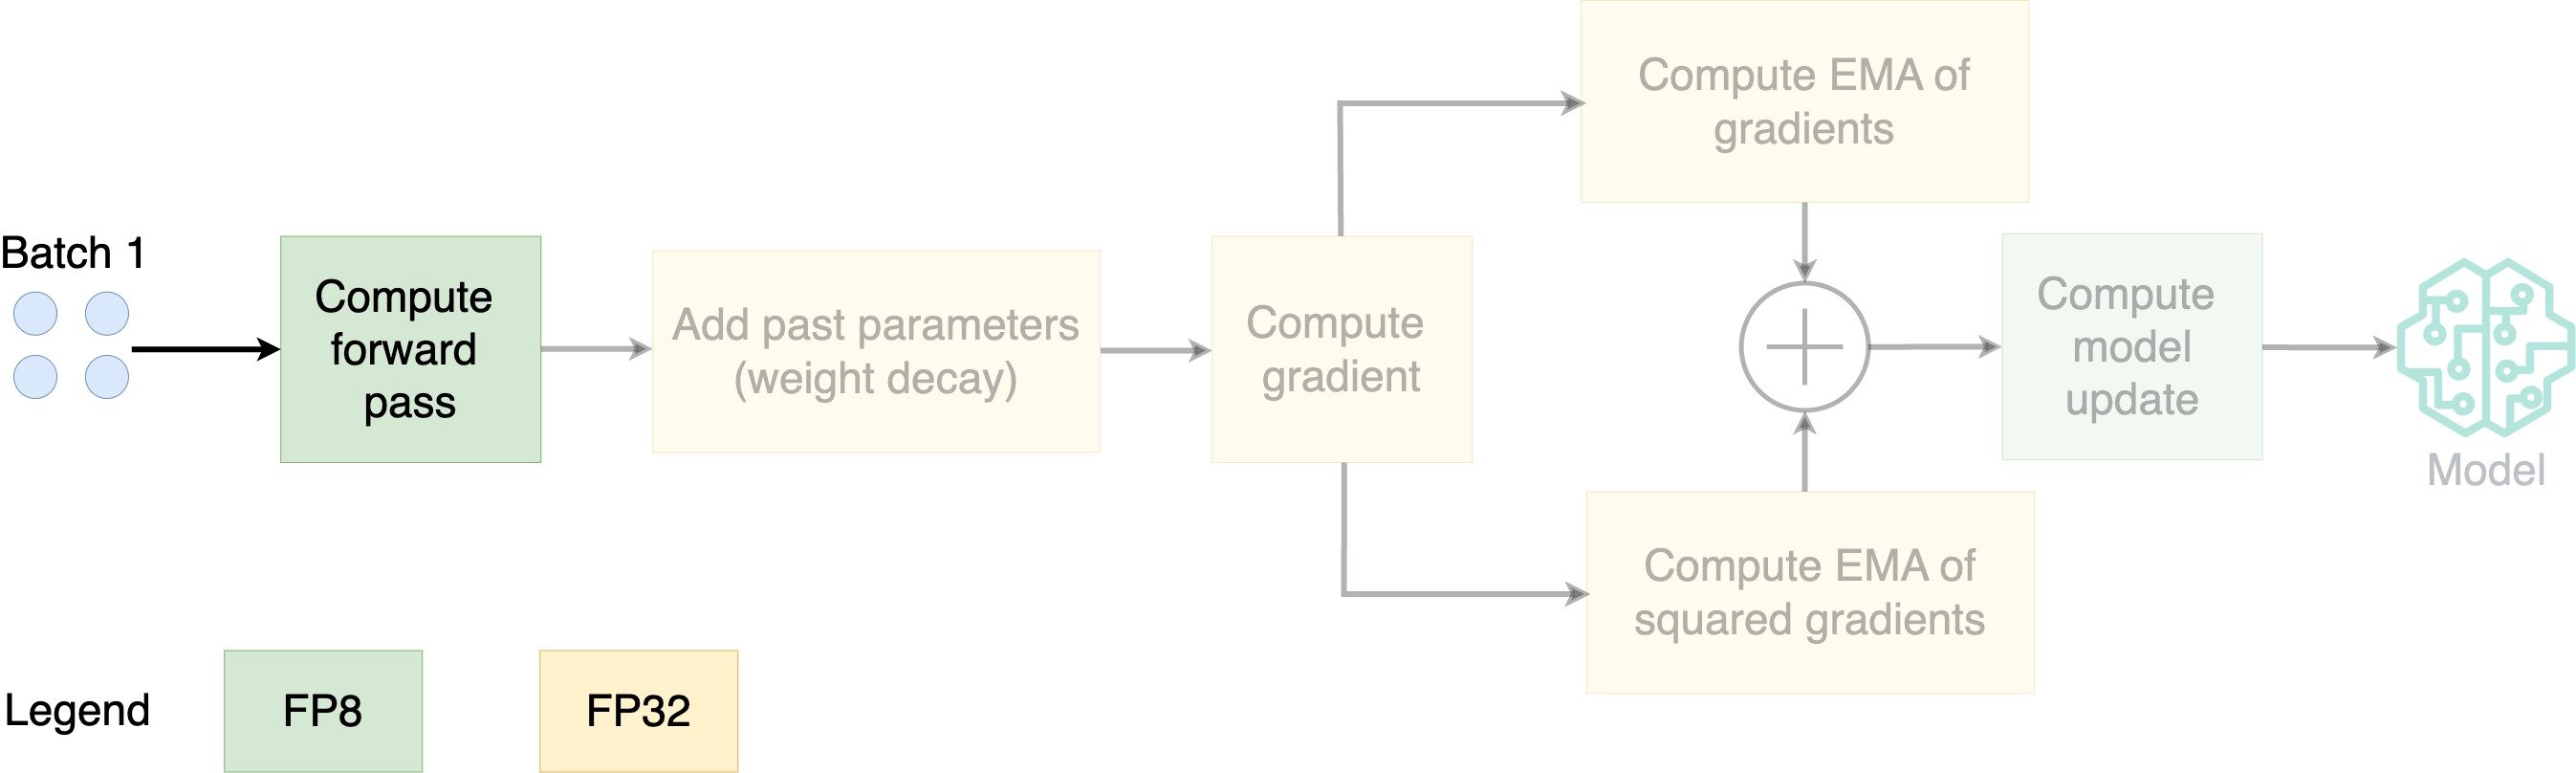
Diagramă cu pașii algoritmului Adam pe 8 biți.

  • Parametri stocați în FP8; optimizare în FP32
Antrenament eficient al modelelor AI cu PyTorch

Cum funcționează Adam pe 8 biți?

Diagramă cu pașii algoritmului Adam pe 8 biți.

  • Parametri stocați în FP8; optimizare în FP32
Antrenament eficient al modelelor AI cu PyTorch

Cum funcționează Adam pe 8 biți?

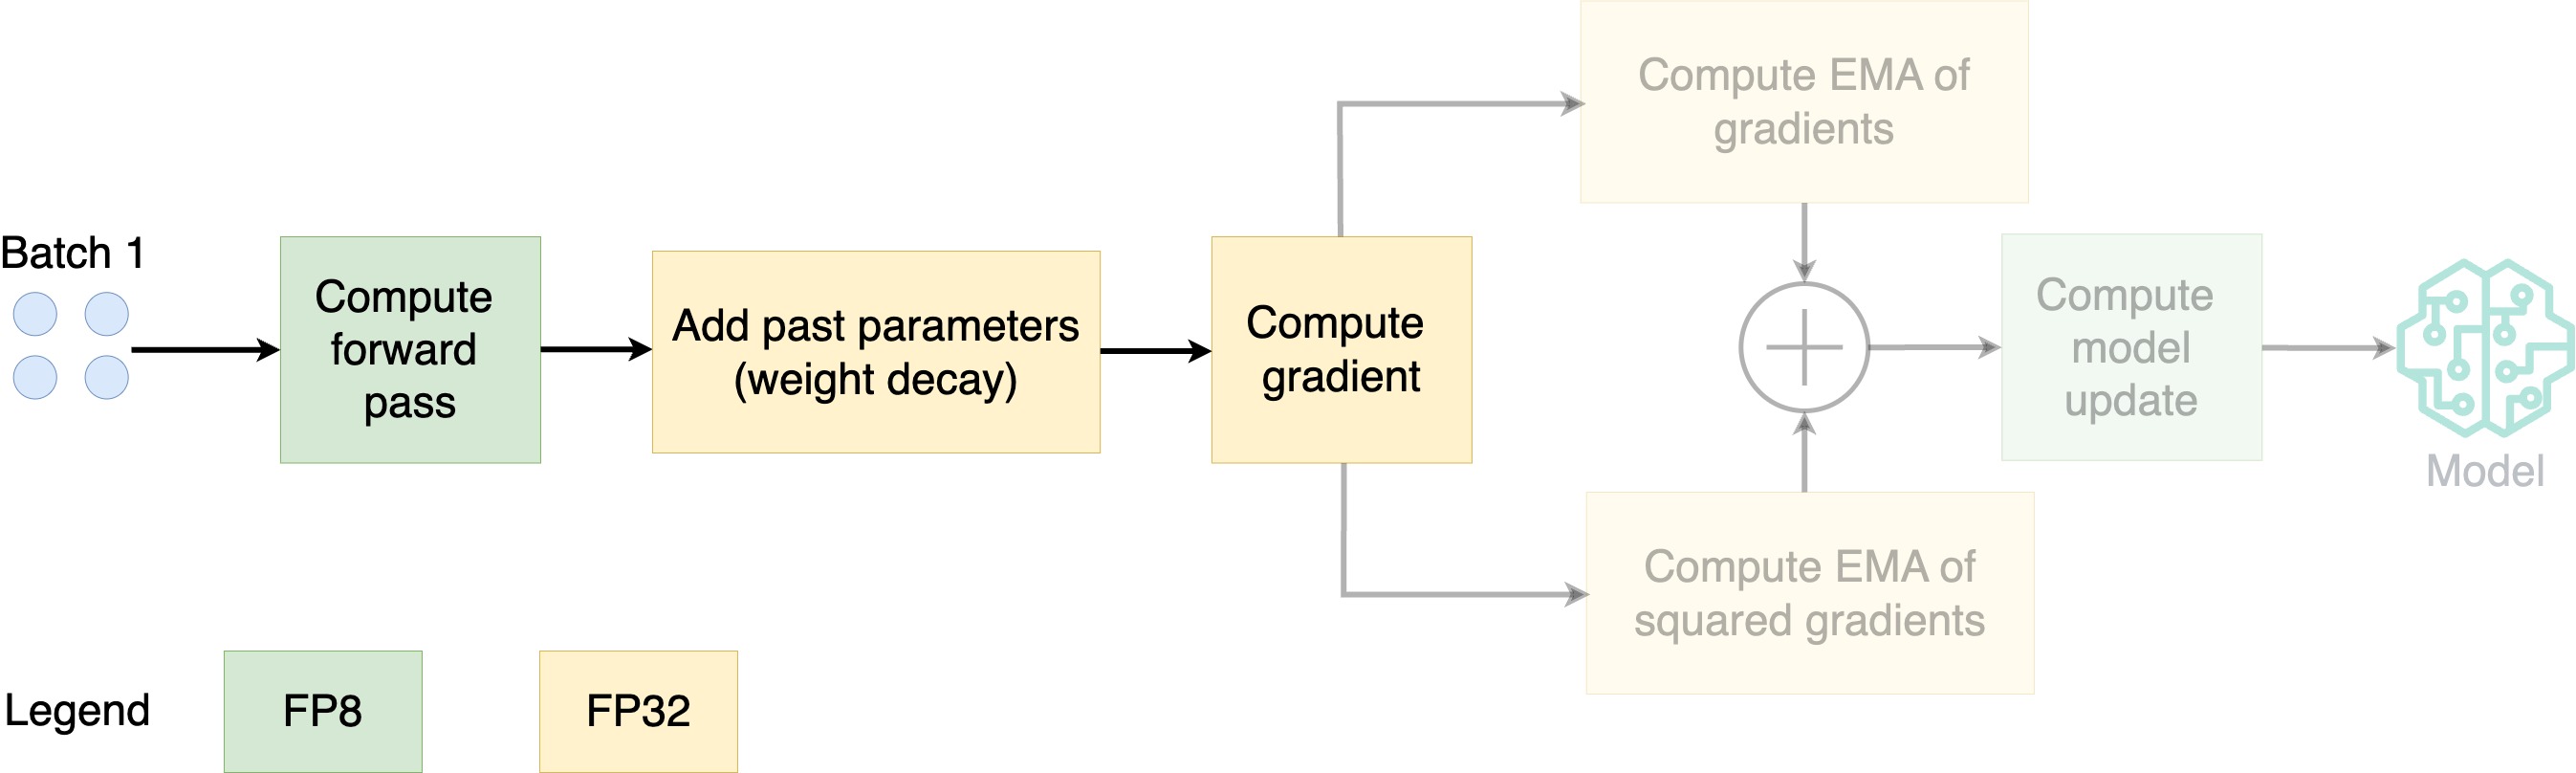
Diagramă cu pașii algoritmului Adam pe 8 biți.

  • Parametri stocați în FP8; optimizare în FP32
  • EMA: medie mobilă exponențială
  • Calculează EMA a gradienților și a gradienților la pătrat
Antrenament eficient al modelelor AI cu PyTorch

Cum funcționează Adam pe 8 biți?

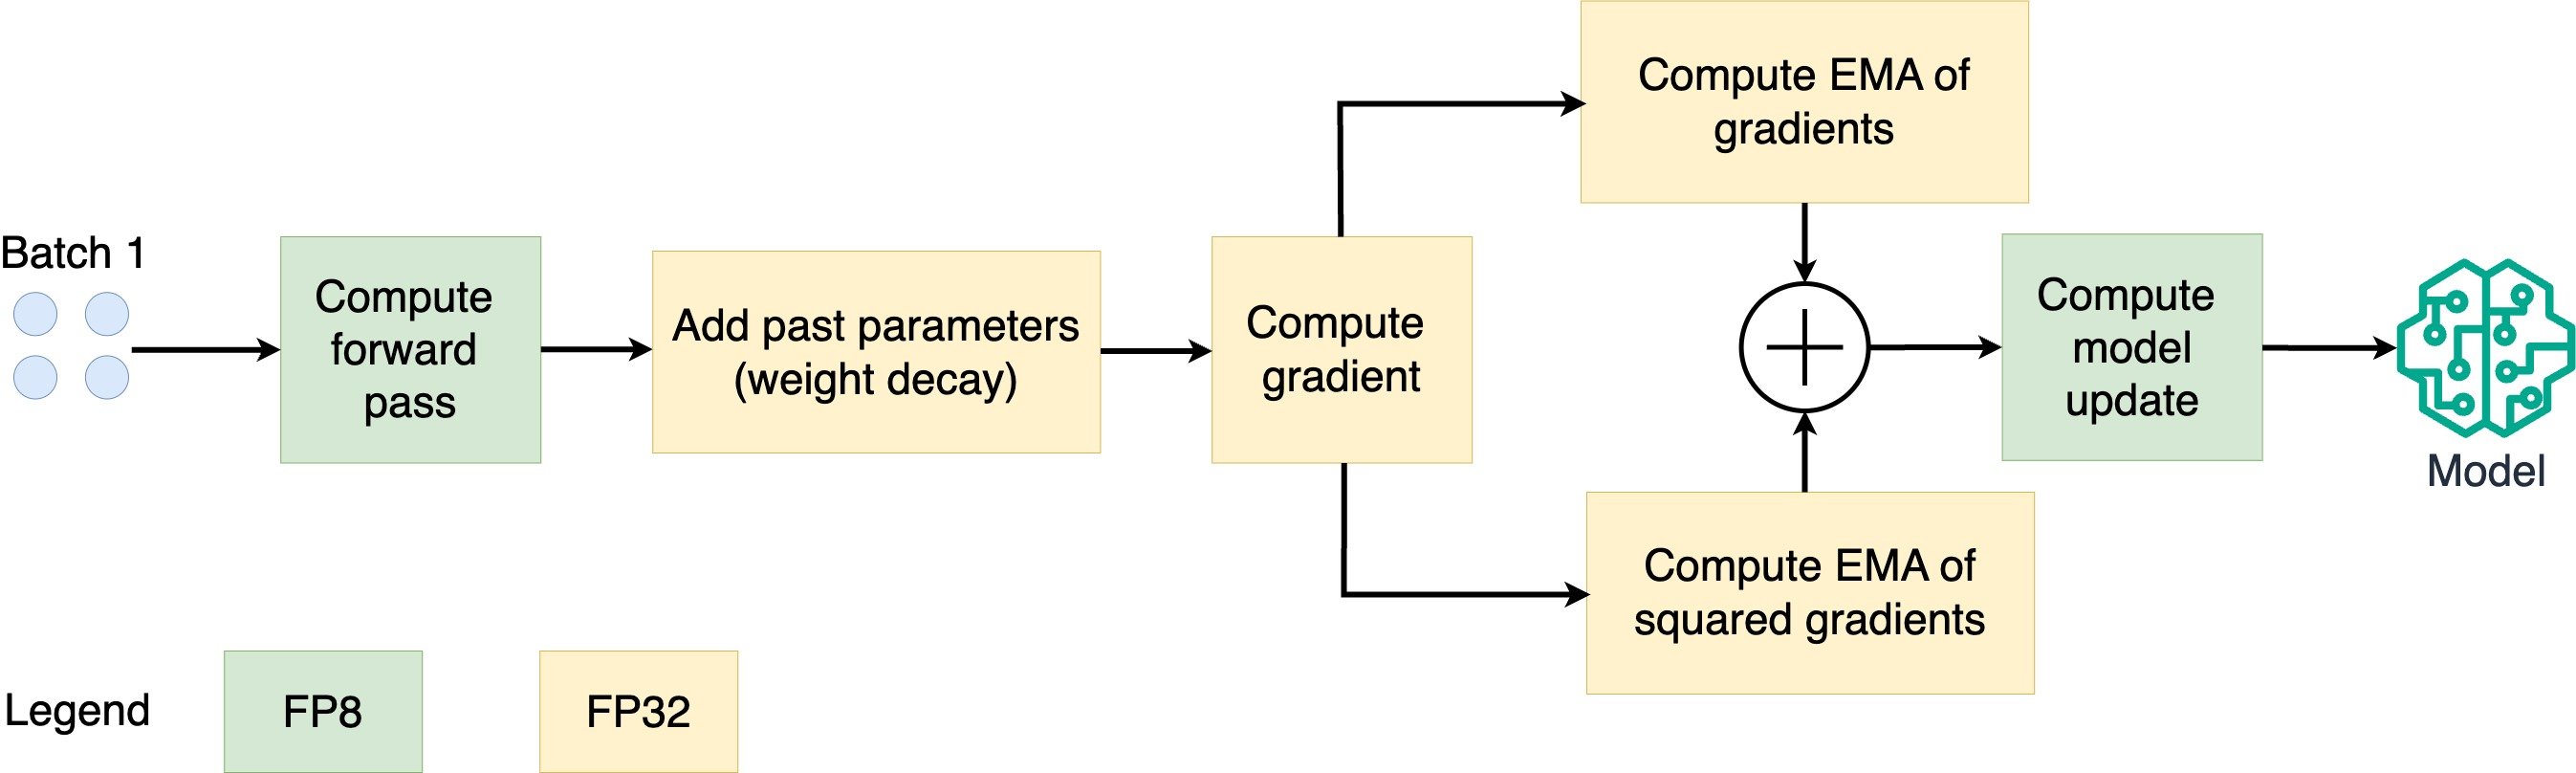
Diagramă cu pașii algoritmului Adam pe 8 biți.

  • Parametri stocați în FP8; optimizare în FP32
  • EMA: medie mobilă exponențială
  • Calculează EMA a gradienților și a gradienților la pătrat
Antrenament eficient al modelelor AI cu PyTorch

Cum economisește memorie Adam pe 8 biți?
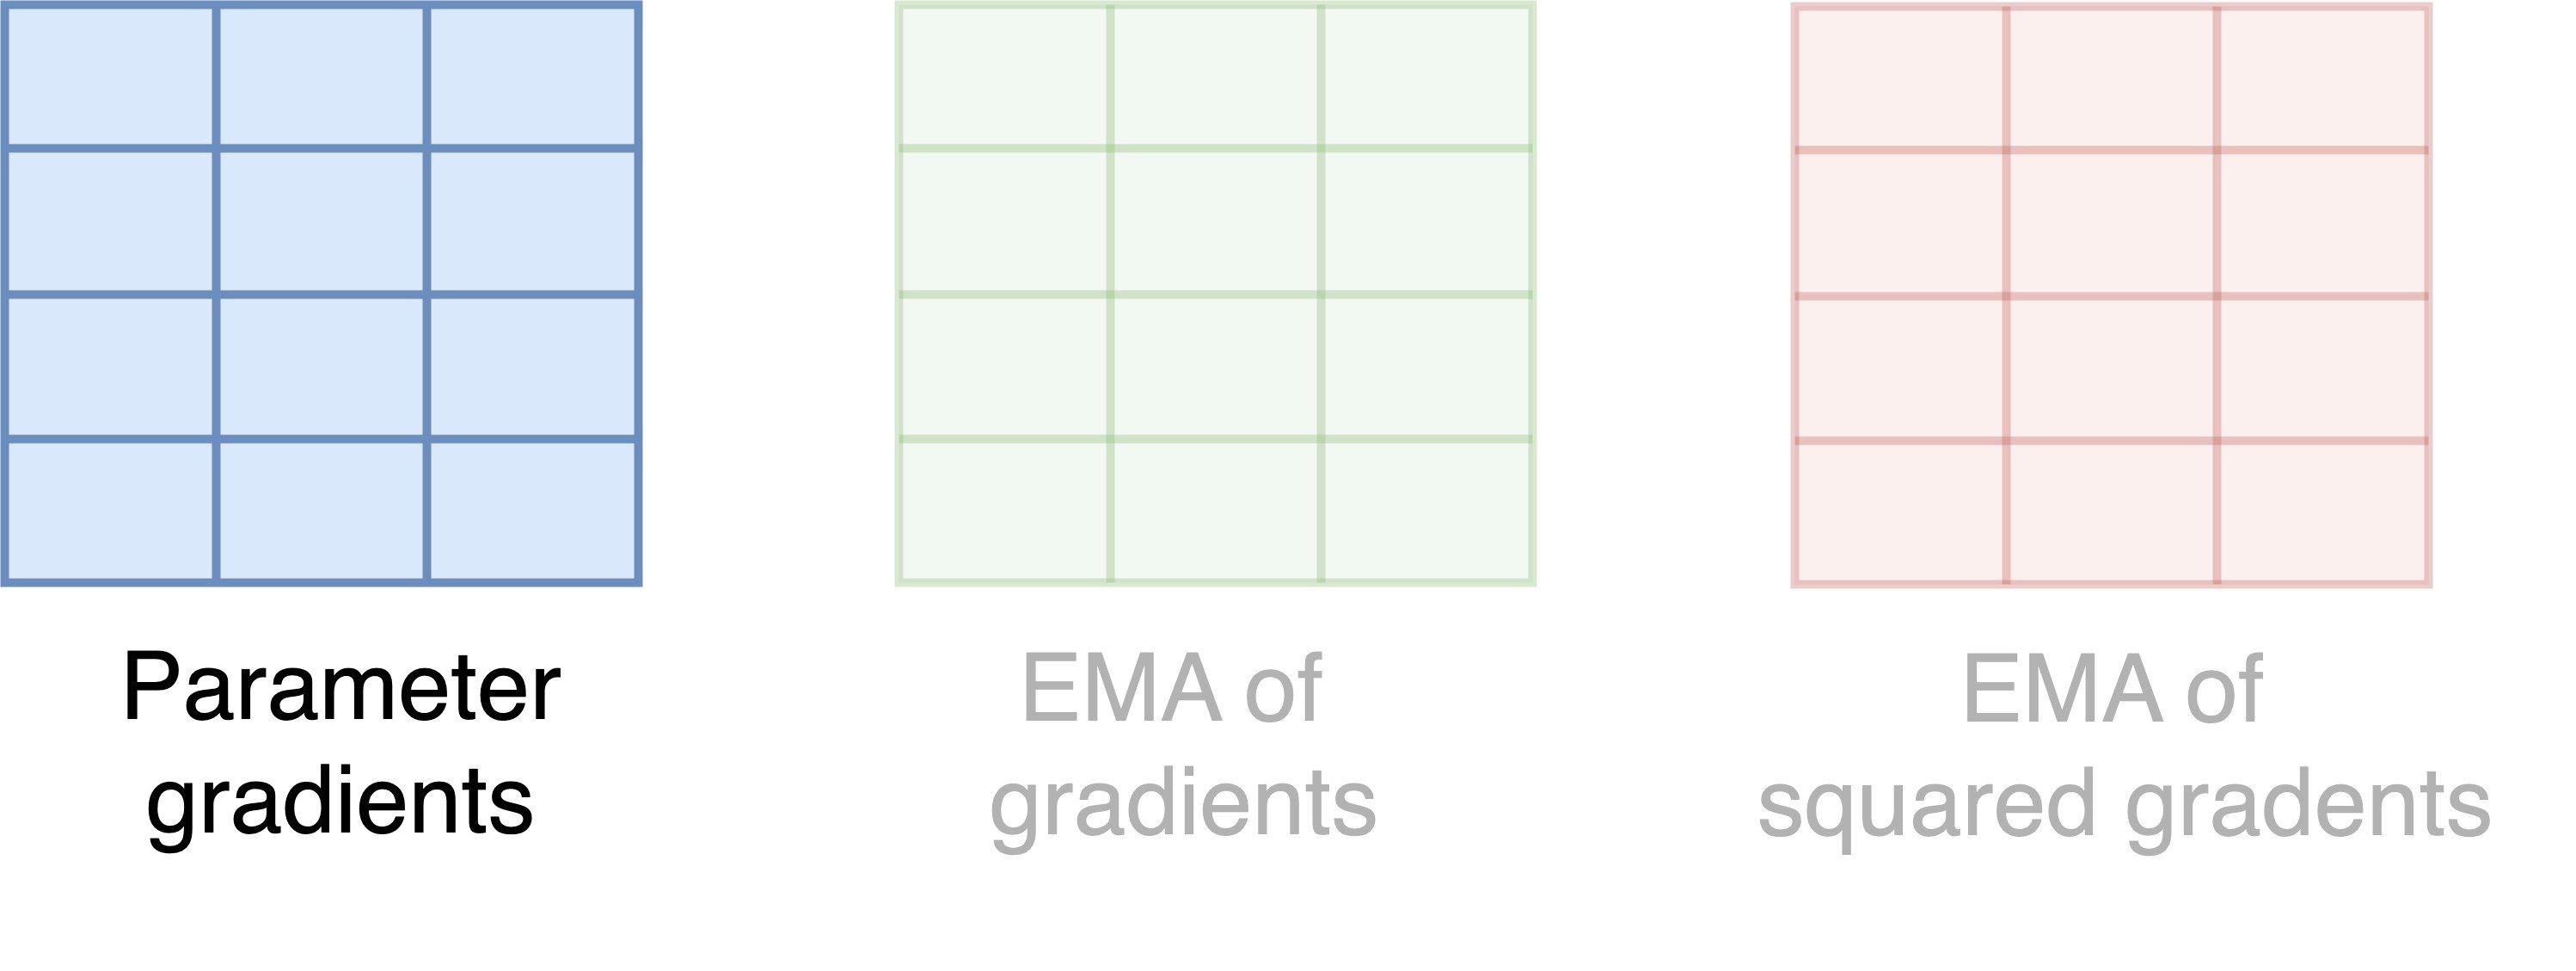
Diagramă cu gradienții parametrilor, EMA a gradienților și EMA a gradienților la pătrat.

Antrenament eficient al modelelor AI cu PyTorch

Cum economisește memorie Adam pe 8 biți?
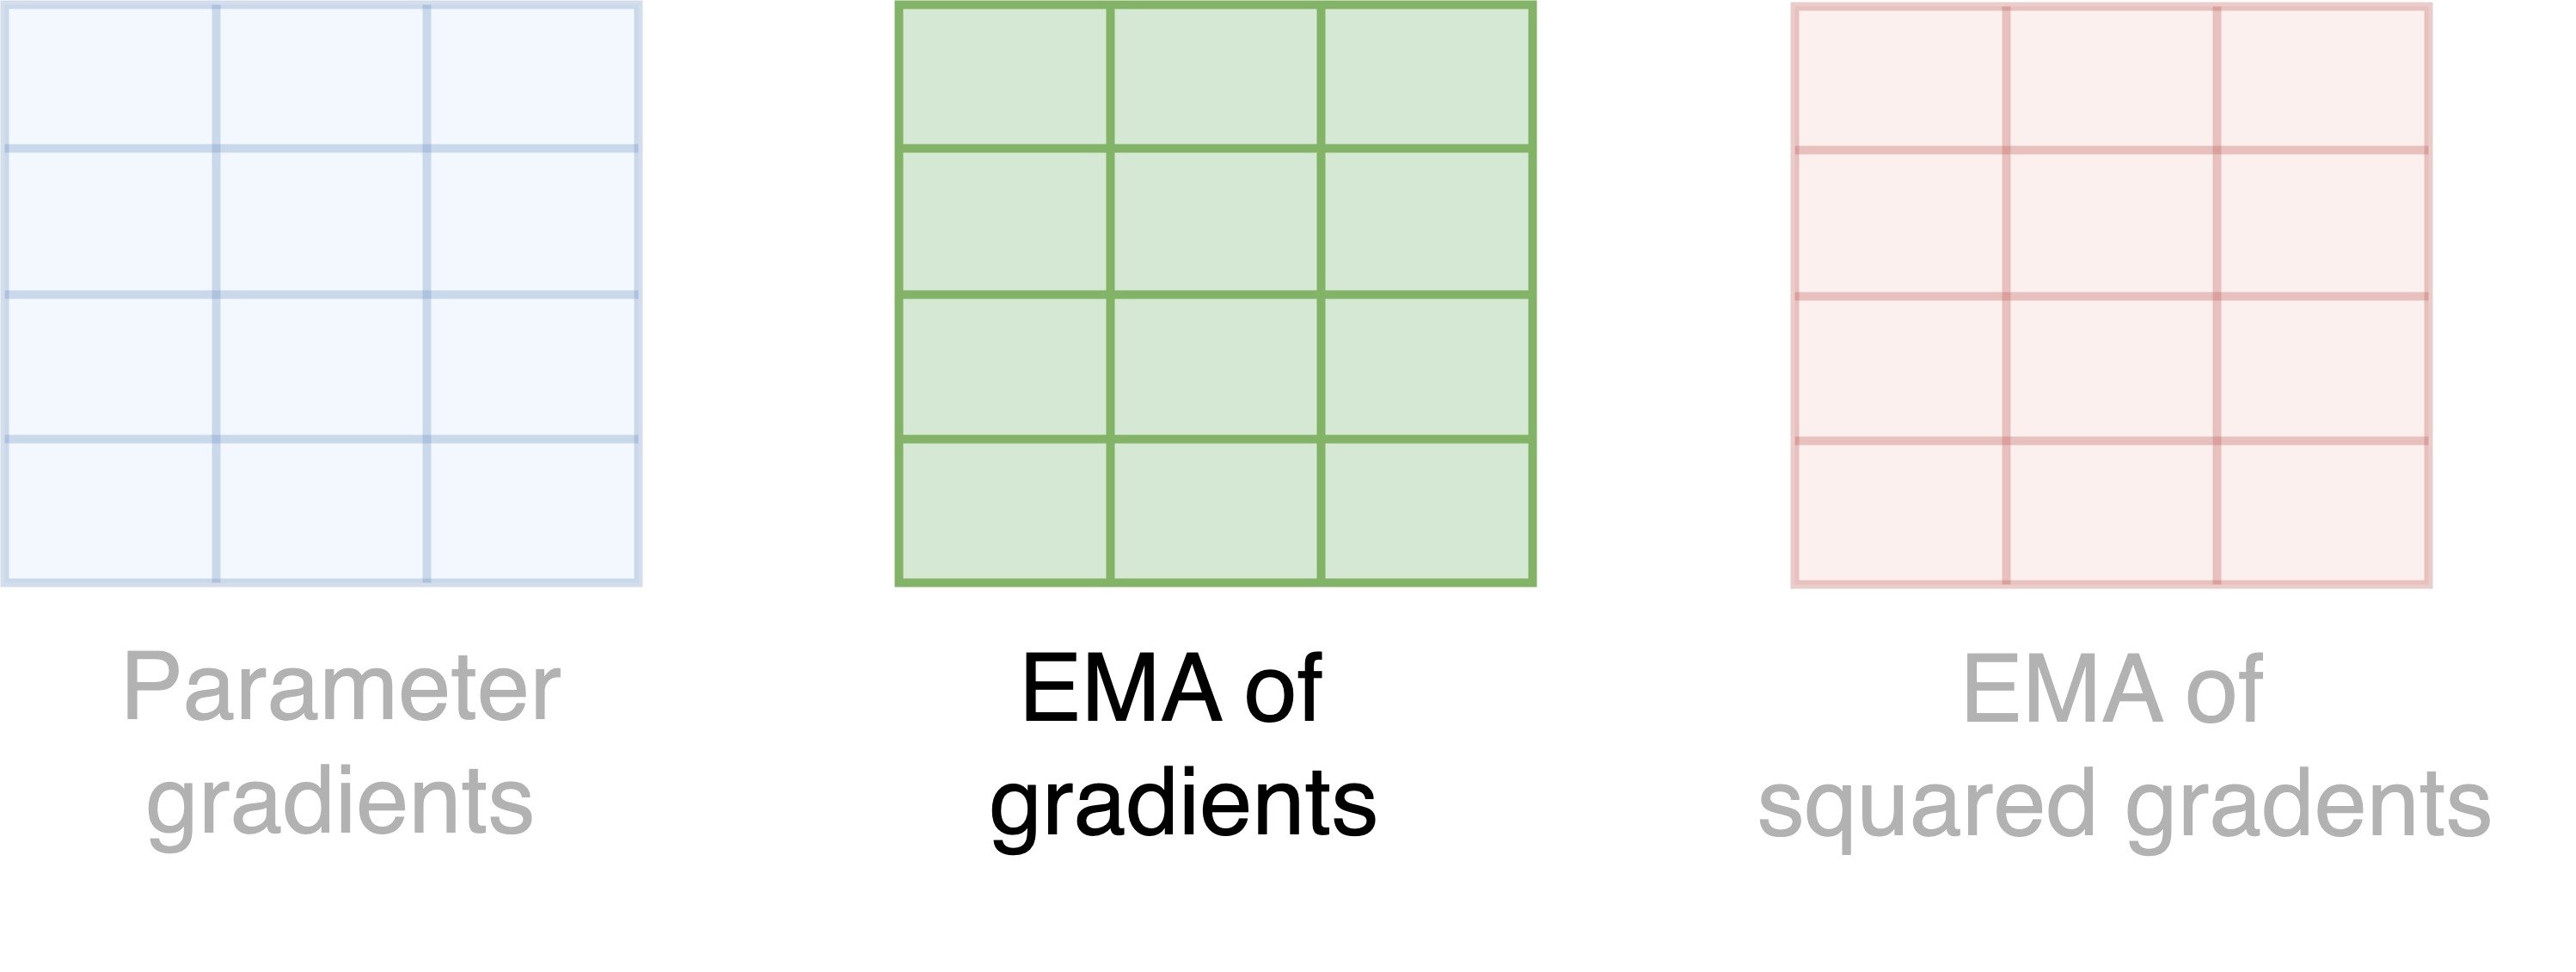
Diagramă cu gradienții parametrilor, EMA a gradienților și EMA a gradienților la pătrat.

Antrenament eficient al modelelor AI cu PyTorch

Cum economisește memorie Adam pe 8 biți?
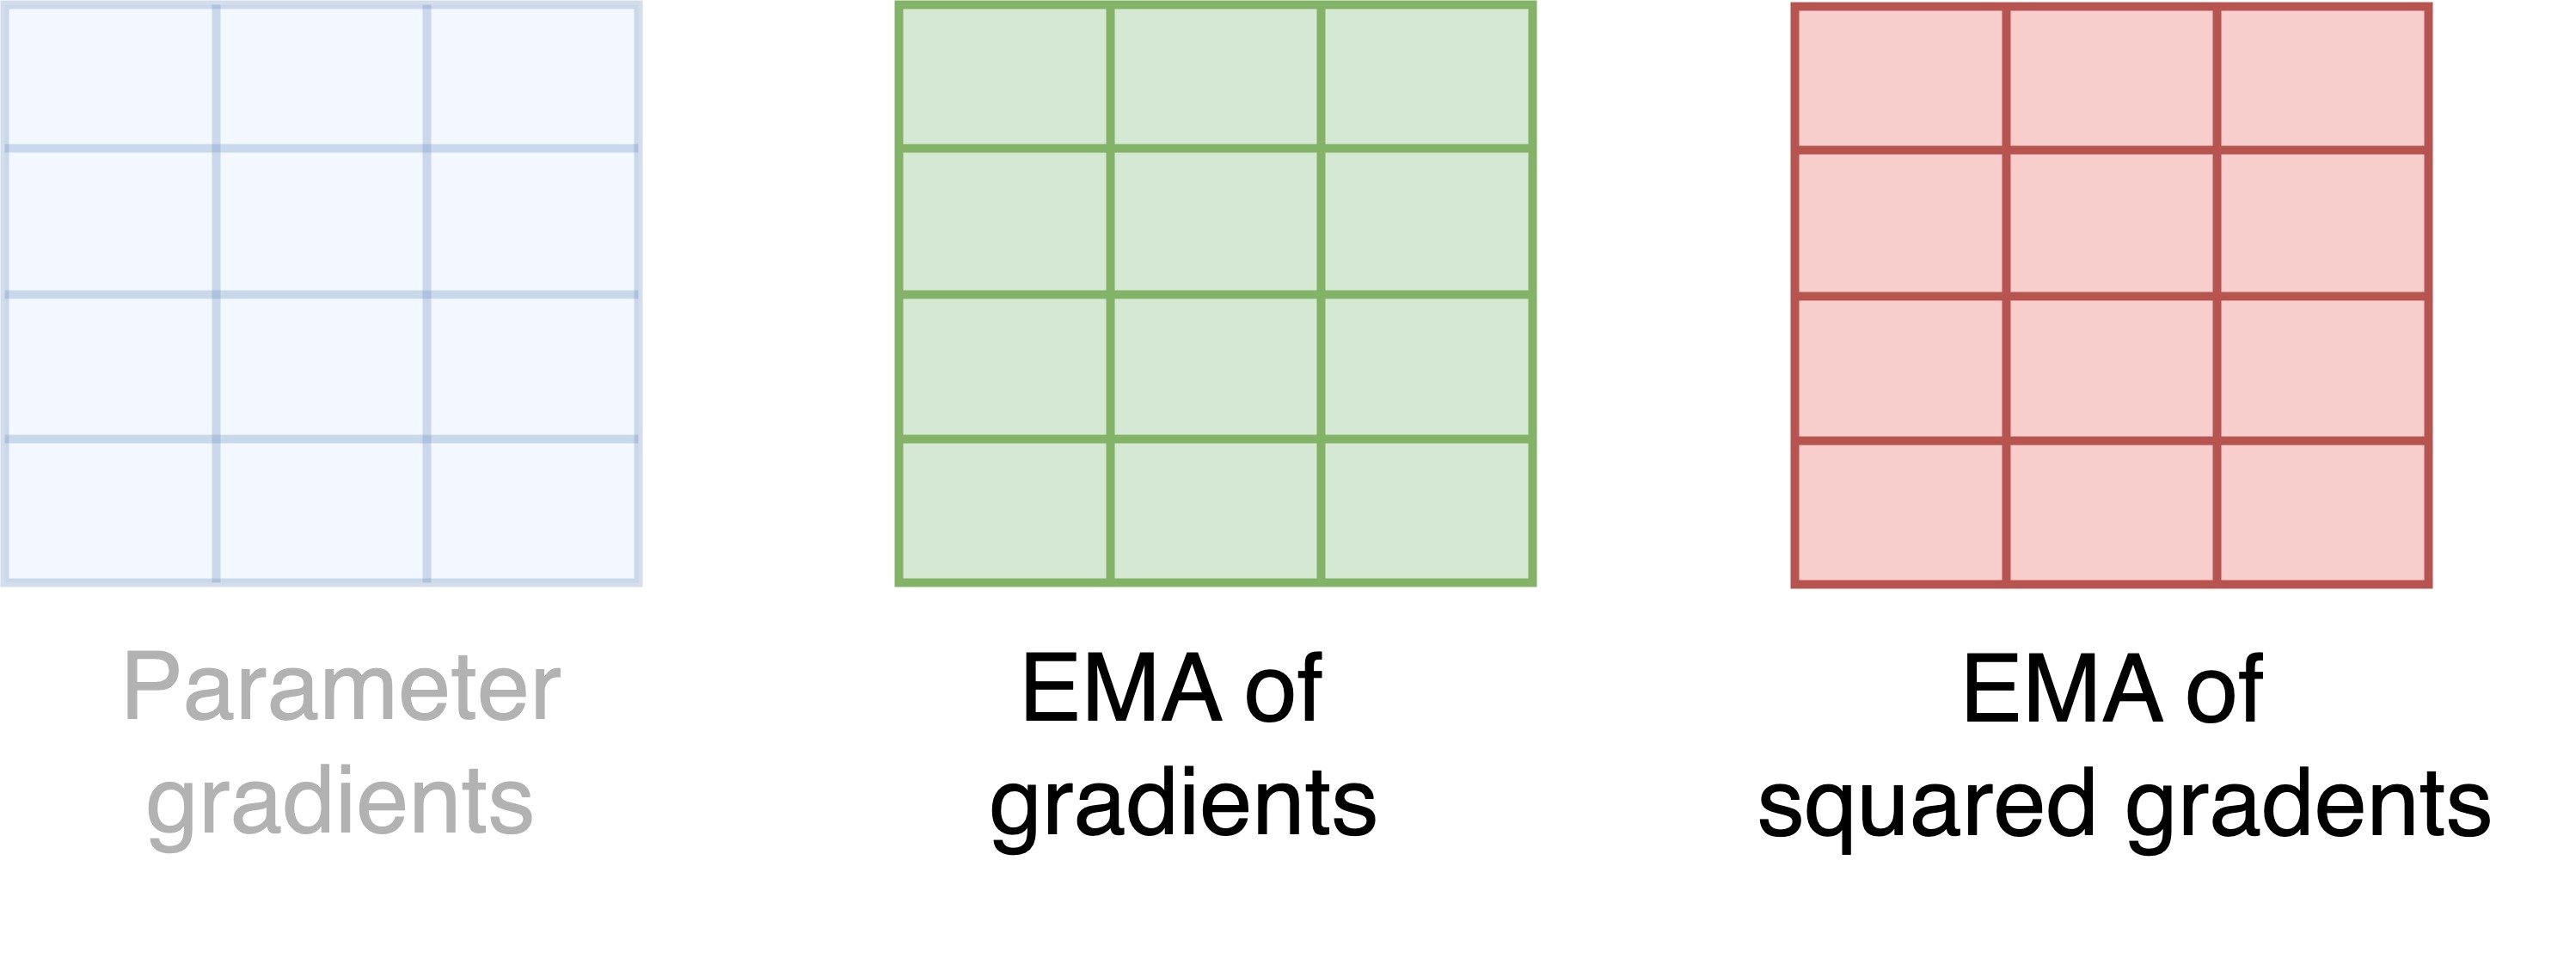
Diagramă cu gradienții parametrilor, EMA a gradienților și EMA a gradienților la pătrat.

  • Fiecare pătrat este un parametru; fiecare culoare reprezintă o stare
  • Memorie per parametru = 2 octeți = 1 octet per stare × 2 stări
  • Memorie totală = Memorie per parametru (2 octeți) × Număr de parametri
Antrenament eficient al modelelor AI cu PyTorch

Estimarea utilizării memoriei pentru Adam pe 8 biți

model = AutoModelForSequenceClassification.from_pretrained(
    "distilbert-base-cased", return_dict=True)
num_parameters = sum(p.numel() for p in model.parameters())
print(f"Number of model parameters: {num_parameters:,}")
Number of model parameters: 65,783,042
estimated_memory = num_parameters * 2 / (1024 ** 2)
print(f"Estimated memory usage of 8-bit Adam: {estimated_memory:.0f} MB")
Estimated memory usage of 8-bit Adam: 125 MB
Antrenament eficient al modelelor AI cu PyTorch

Configurarea optimizatorului Adam pe 8 biți

import bitsandbytes as bnb
from torch import nn
from transformers.trainer_pt_utils import get_parameter_names


args = TrainingArguments(output_dir="./results")
decay_parameters = get_parameter_names(model, [nn.LayerNorm])
decay_parameters = [name for name in decay_parameters if "bias" not in name]
  • Regularizarea ponderilor previne supraajustarea
  • decay_parameters: specifică parametrii la care se aplică regularizarea
  • get_parameter_names: returnează numele parametrilor; ignoră straturile nn.LayerNorm
  • Elimină parametrii bias din decay_parameters
  • Nu aplica regularizarea straturilor de normalizare și biasurilor
Antrenament eficient al modelelor AI cu PyTorch

Configurarea optimizatorului Adam pe 8 biți

optimizer_grouped_parameters = [{"params": [p for n, p in model.named_parameters() 
                                            if n in decay_parameters],
                                 "weight_decay": args.weight_decay},

{"params": [p for n, p in model.named_parameters() if n not in decay_parameters], "weight_decay": 0.0}]
adam_bnb_optim = bnb.optim.Adam8bit(optimizer_grouped_parameters,
betas=(args.adam_beta1, args.adam_beta2),
eps=args.adam_epsilon,
lr=args.learning_rate)
  • optimizer_grouped_parameters: un grup aplică regularizarea; celălalt nu
  • beta1, beta2: rate de descreștere ale momentelor 1 și 2; valori mari = antrenament stabil, dar lent
Antrenament eficient al modelelor AI cu PyTorch

Implementarea Adam pe 8 biți cu Trainer

trainer = Trainer(model=model,
                  args=training_args,
                  train_dataset=train_dataset,
                  eval_dataset=validation_dataset,
                  optimizers=(adam_bnb_optim, None),
                  compute_metrics=compute_metrics)

trainer.train()
{'epoch': 1.0, 'eval_loss': 0.63, 'eval_accuracy': 0.67, 'eval_f1': 0.62}
{'epoch': 2.0, 'eval_loss': 0.61, 'eval_accuracy': 0.71, 'eval_f1': 0.66}
Antrenament eficient al modelelor AI cu PyTorch

Implementarea Adam pe 8 biți cu Accelerator

model, adam_bnb_optim, train_dataloader, lr_scheduler = \
    accelerator.prepare(model, adam_bnb_optim, train_dataloader, lr_scheduler)


for batch in train_dataloader: inputs, targets = batch["input_ids"], batch["labels"] outputs = model(inputs, labels=targets) loss = outputs.loss accelerator.backward(loss) adam_bnb_optim.step() lr_scheduler.step() adam_bnb_optim.zero_grad() print(f"Loss = {loss}")
Loss = 0.75
Antrenament eficient al modelelor AI cu PyTorch

Calcularea utilizării memoriei pentru Adam pe 8 biți

total_size_megabytes, total_num_elements = \
    compute_optimizer_size(trainer.optimizer.state.values())
print(f"Number of 8-bit Adam parameters: {total_num_elements:,}")
print(f"8-bit Adam size: {total_size_megabytes:.0f} MB")
Number of 8-bit Adam parameters: 131,566,188
8-bit Adam size: 128 MB
  • Comparație cu AdamW: Adam pe 8 biți folosește 1/4 din memorie
Number of AdamW parameters: 131,566,188
AdamW size: 502 MB
Antrenament eficient al modelelor AI cu PyTorch

Să exersăm!

Antrenament eficient al modelelor AI cu PyTorch

Preparing Video For Download...