Предобработка изображений и аудио для обучения

Эффективное обучение моделей ИИ с PyTorch

Dennis Lee

Data Engineer, Amazon

Подготовка изображений и аудио

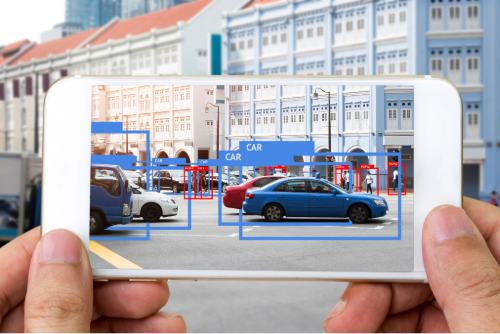
Приложения для изображений

  • Классификация изображений для распознавания объектов
  • Шардирование данных


Приложение для обнаружения объектов: на экране телефона выделены автомобили на улице. Телефон держат в руках на фоне реальной уличной сцены.

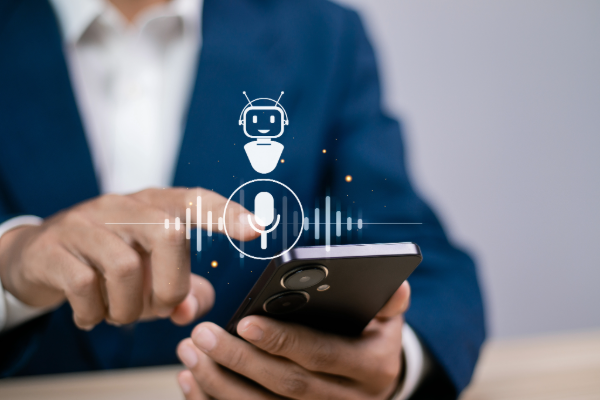
Приложения для аудио

  • Голосовое управление
  • Пример: «Убавь громкость»


Аудиовспомогательная технология для людей с нарушением зрения: управление телефоном с помощью голосовых команд.

Эффективное обучение моделей ИИ с PyTorch

Работа с учебным датасетом изображений

print(dataset)
Dataset({
    features: ['img', 'label'],
    num_rows: 1000
})
print(dataset[0]["img"])
<PIL.JpegImagePlugin.JpegImageFile image mode=RGB size=720x480>
Эффективное обучение моделей ИИ с PyTorch

Стандартизация формата изображений

  • Формат изображений: ширина, высота
  • Стандартизация значений пикселей: среднее, стандартное отклонение
  • AutoImageProcessor загружает все шаги предобработки
from transformers import AutoImageProcessor
model = "microsoft/swin-tiny-patch4-window7-224"

image_processor = AutoImageProcessor.from_pretrained(model)
Эффективное обучение моделей ИИ с PyTorch

Стандартизация формата изображений

dataset = dataset.map(
    lambda examples: {

"pixel_values": [
image_processor(image, return_tensors="pt").pixel_values for image in examples["img"] ]}, batched=True)
print(dataset)
Dataset({
    features: ['img', 'label', 'pixel_values'],
    num_rows: 1000
})
Эффективное обучение моделей ИИ с PyTorch

Работа с учебным аудиодатасетом

print(dataset)
DatasetDict({
    train: Dataset({

features: ['file', 'audio',
'label'], num_rows: 1000 }), ... })
Эффективное обучение моделей ИИ с PyTorch

Стандартизация формата аудио

  • Стандартизация числа сэмплов
  • Частота дискретизации: число сэмплов в секунду
  • Максимальная длительность: число секунд аудио
sampling_rate = 16000  # 16 kHz

max_duration = 1 # 1 second
max_length = sampling_rate * max_duration
print(f"max_length = {max_length:,} samples")
max_length = 16,000 samples
Эффективное обучение моделей ИИ с PyTorch

Стандартизация формата аудио

from transformers import AutoFeatureExtractor

model = "facebook/wav2vec2-base"
feature_extractor = AutoFeatureExtractor.from_pretrained(model)


def preprocess_function(split_data):
audio_arrays = [x["array"] for x in split_data["audio"]]
inputs = feature_extractor(audio_arrays,
sampling_rate=feature_extractor.sampling_rate, max_length=int(feature_extractor.sampling_rate * max_duration),
truncation=True) return inputs
Эффективное обучение моделей ИИ с PyTorch

Применение функции предобработки

  • Применить preprocess_function к dataset
  • remove_columns: удалить столбцы audio и file
  • batched: обрабатывать примеры из dataset пакетами
dataset = dataset["train"].map(preprocess_function,

remove_columns=["audio", "file"],
batched=True)
Эффективное обучение моделей ИИ с PyTorch

Применение функции предобработки

print(dataset)
DatasetDict({
    train: Dataset({
        features: ['label', 'input_values'],
        num_rows: 1000
    })
Эффективное обучение моделей ИИ с PyTorch

Подготовка данных для распределённого обучения

  • DataLoader: подготовка данных для загрузки и итерации при обучении
  • accelerator.prepare(): размещение данных на CPU или GPU в зависимости от доступности
  • Шардирование данных: каждый GPU обрабатывает подмножество обучающих данных, как ломти пиццы
  • accelerator.prepare() работает с DataLoader из PyTorch (torch.utils.data.DataLoader)
from accelerate import Accelerator
from torch.utils.data import DataLoader

dataloader = DataLoader(dataset, batch_size=32, shuffle=True)


accelerator = Accelerator() dataloader = accelerator.prepare(dataloader)
Эффективное обучение моделей ИИ с PyTorch

Давайте попрактикуемся!

Эффективное обучение моделей ИИ с PyTorch

Preparing Video For Download...