Смешанная точность с 8-битным Adam

Эффективное обучение моделей ИИ с PyTorch

Dennis Lee

Data Engineer, Amazon

Оптимизаторы для эффективного обучения
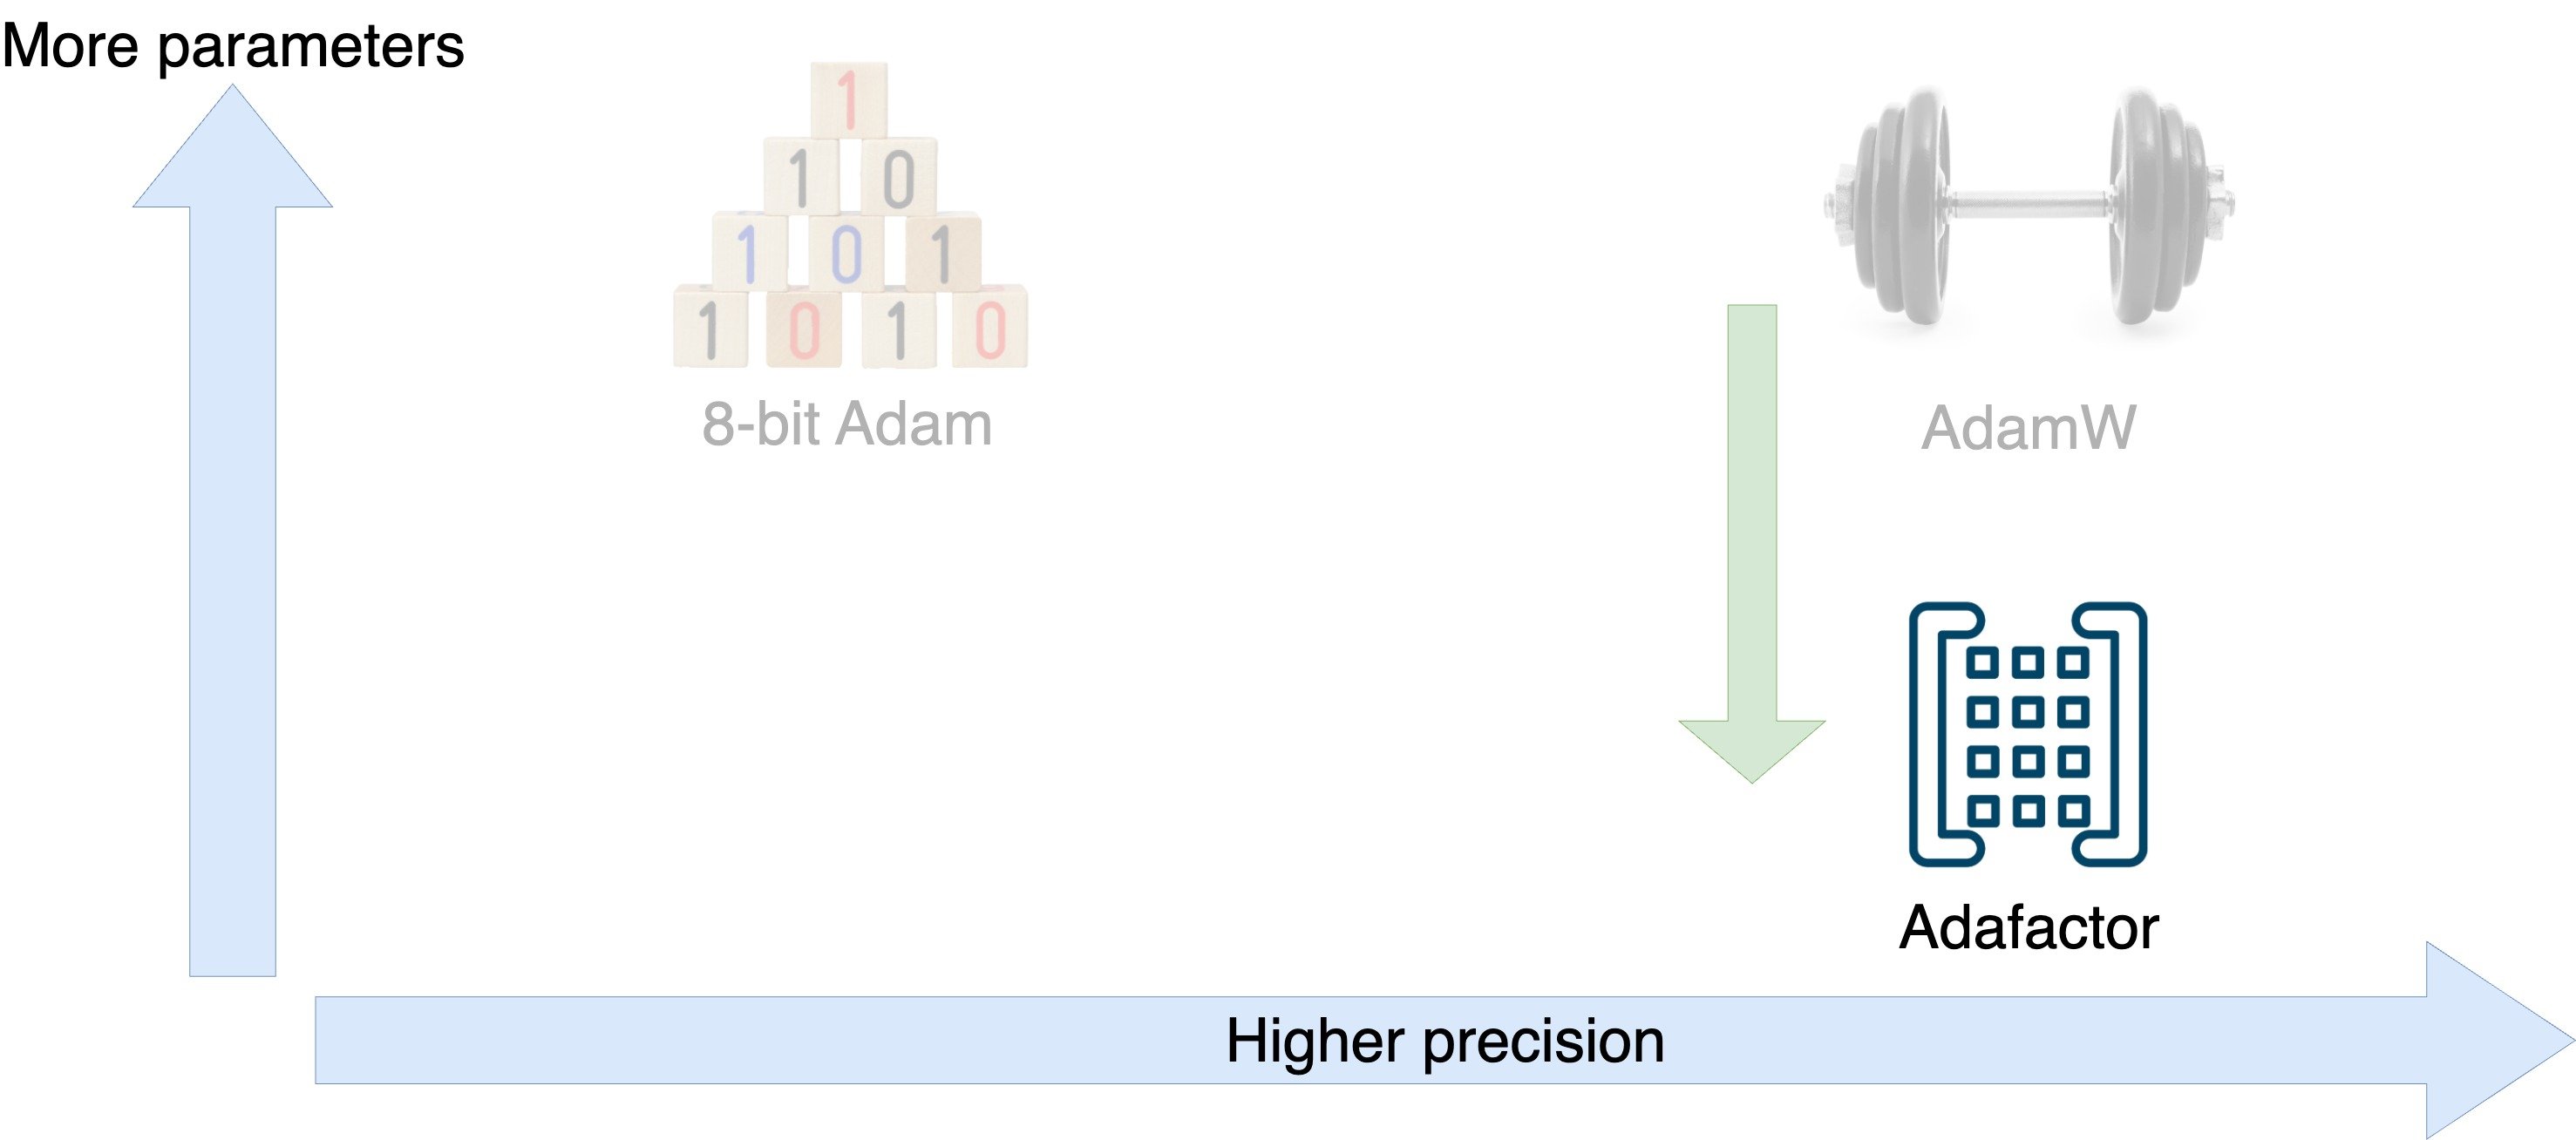
Диаграмма сравнения числа параметров и точности для AdamW, Adafactor и 8-битного Adam.

Эффективное обучение моделей ИИ с PyTorch

Оптимизаторы для эффективного обучения
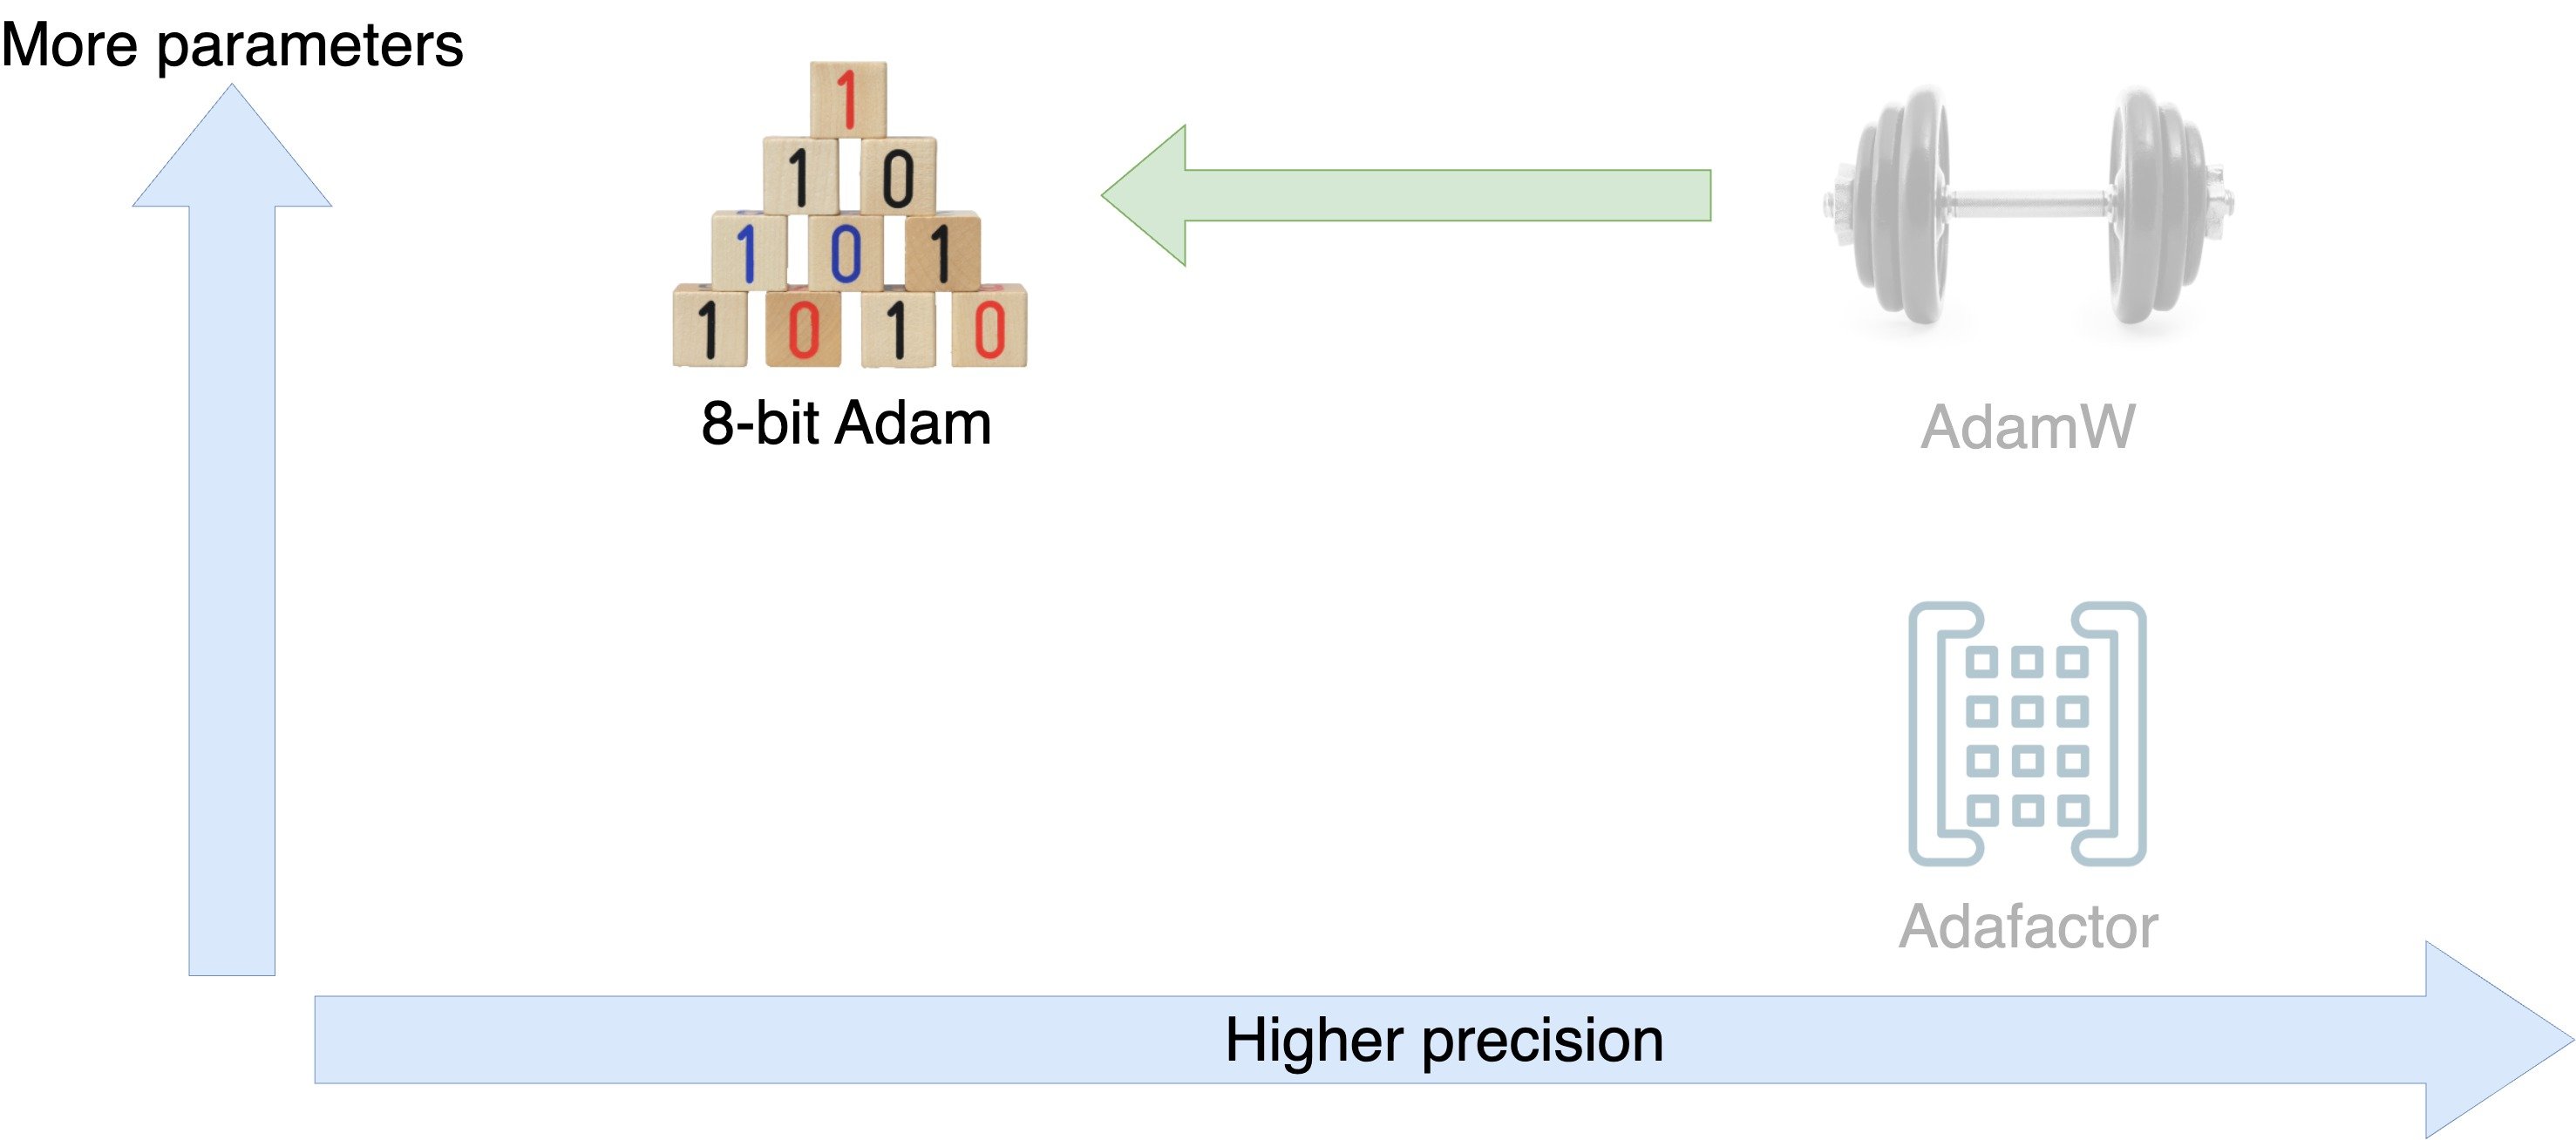
Диаграмма сравнения числа параметров и точности для AdamW, Adafactor и 8-битного Adam.

Эффективное обучение моделей ИИ с PyTorch

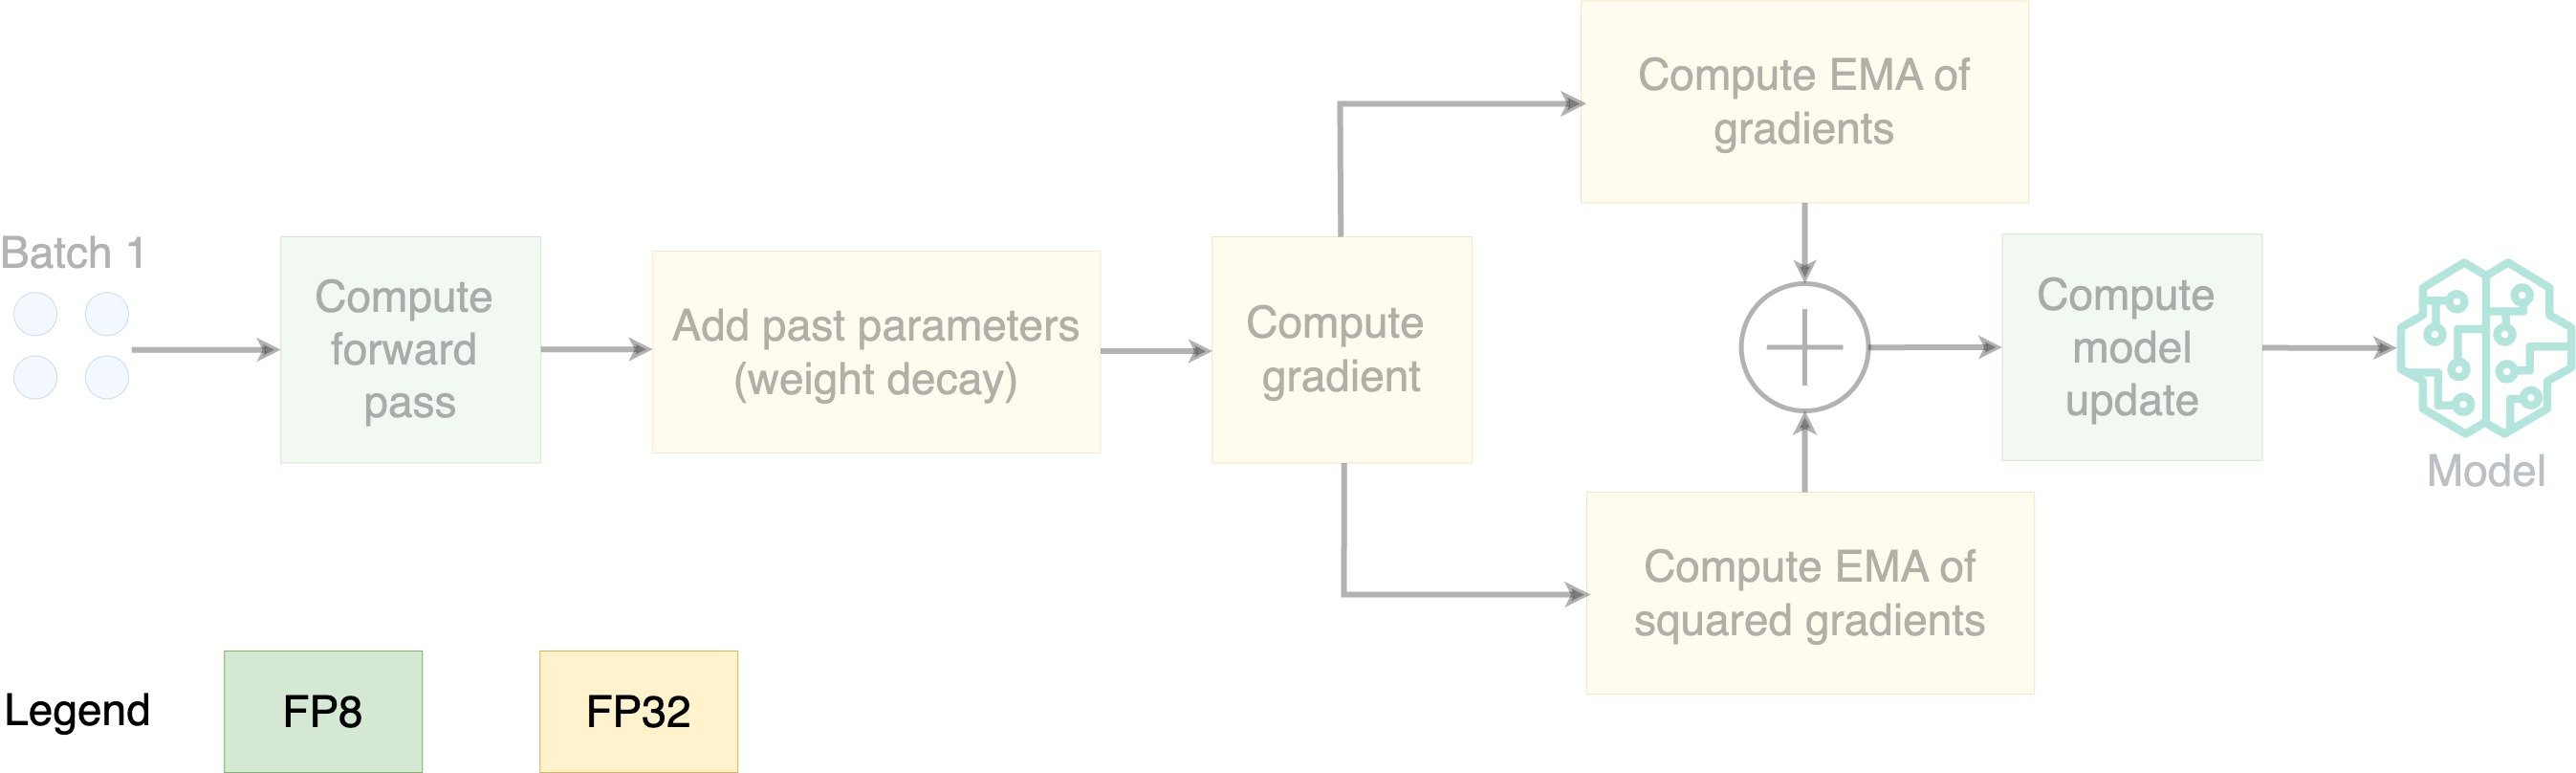
Как работает 8-битный Adam?

Диаграмма, показывающая шаги 8-битного Adam.

  • Параметры в FP8; оптимизация в FP32
Эффективное обучение моделей ИИ с PyTorch

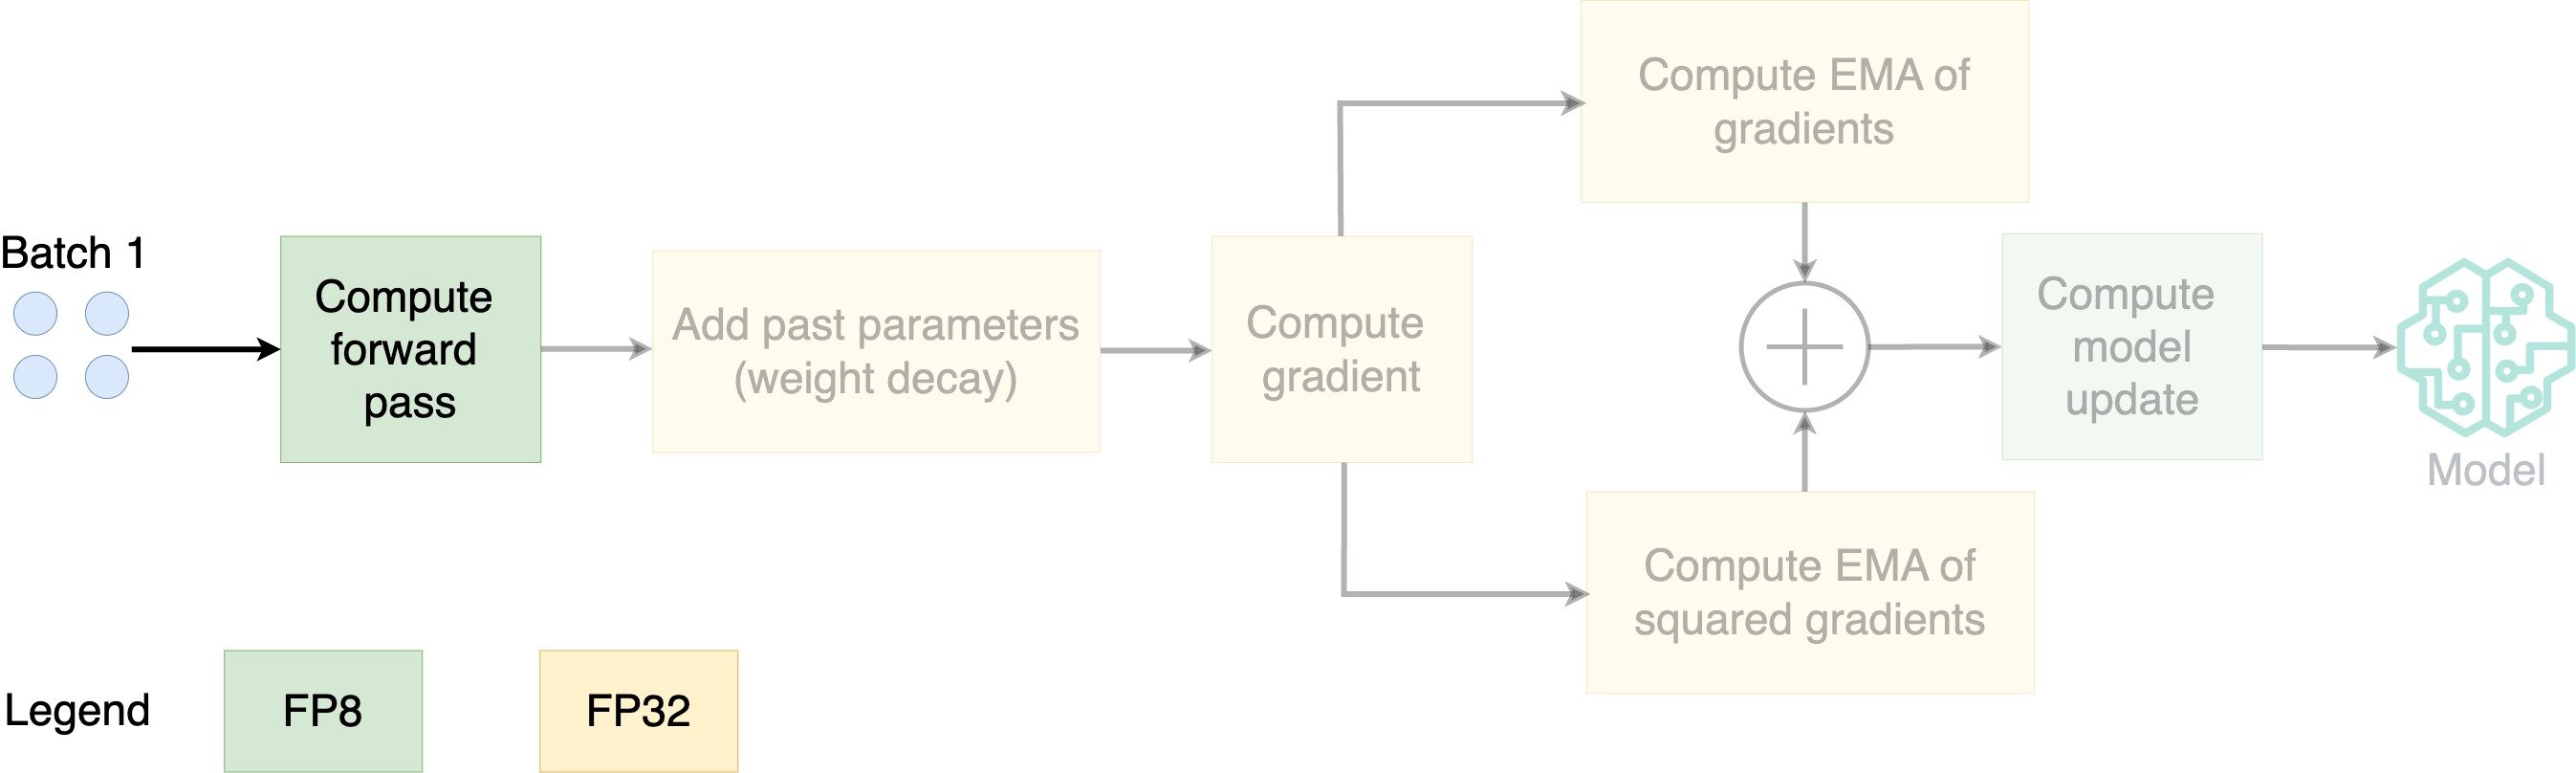
Как работает 8-битный Adam?

Диаграмма, показывающая шаги 8-битного Adam.

  • Параметры в FP8; оптимизация в FP32
Эффективное обучение моделей ИИ с PyTorch

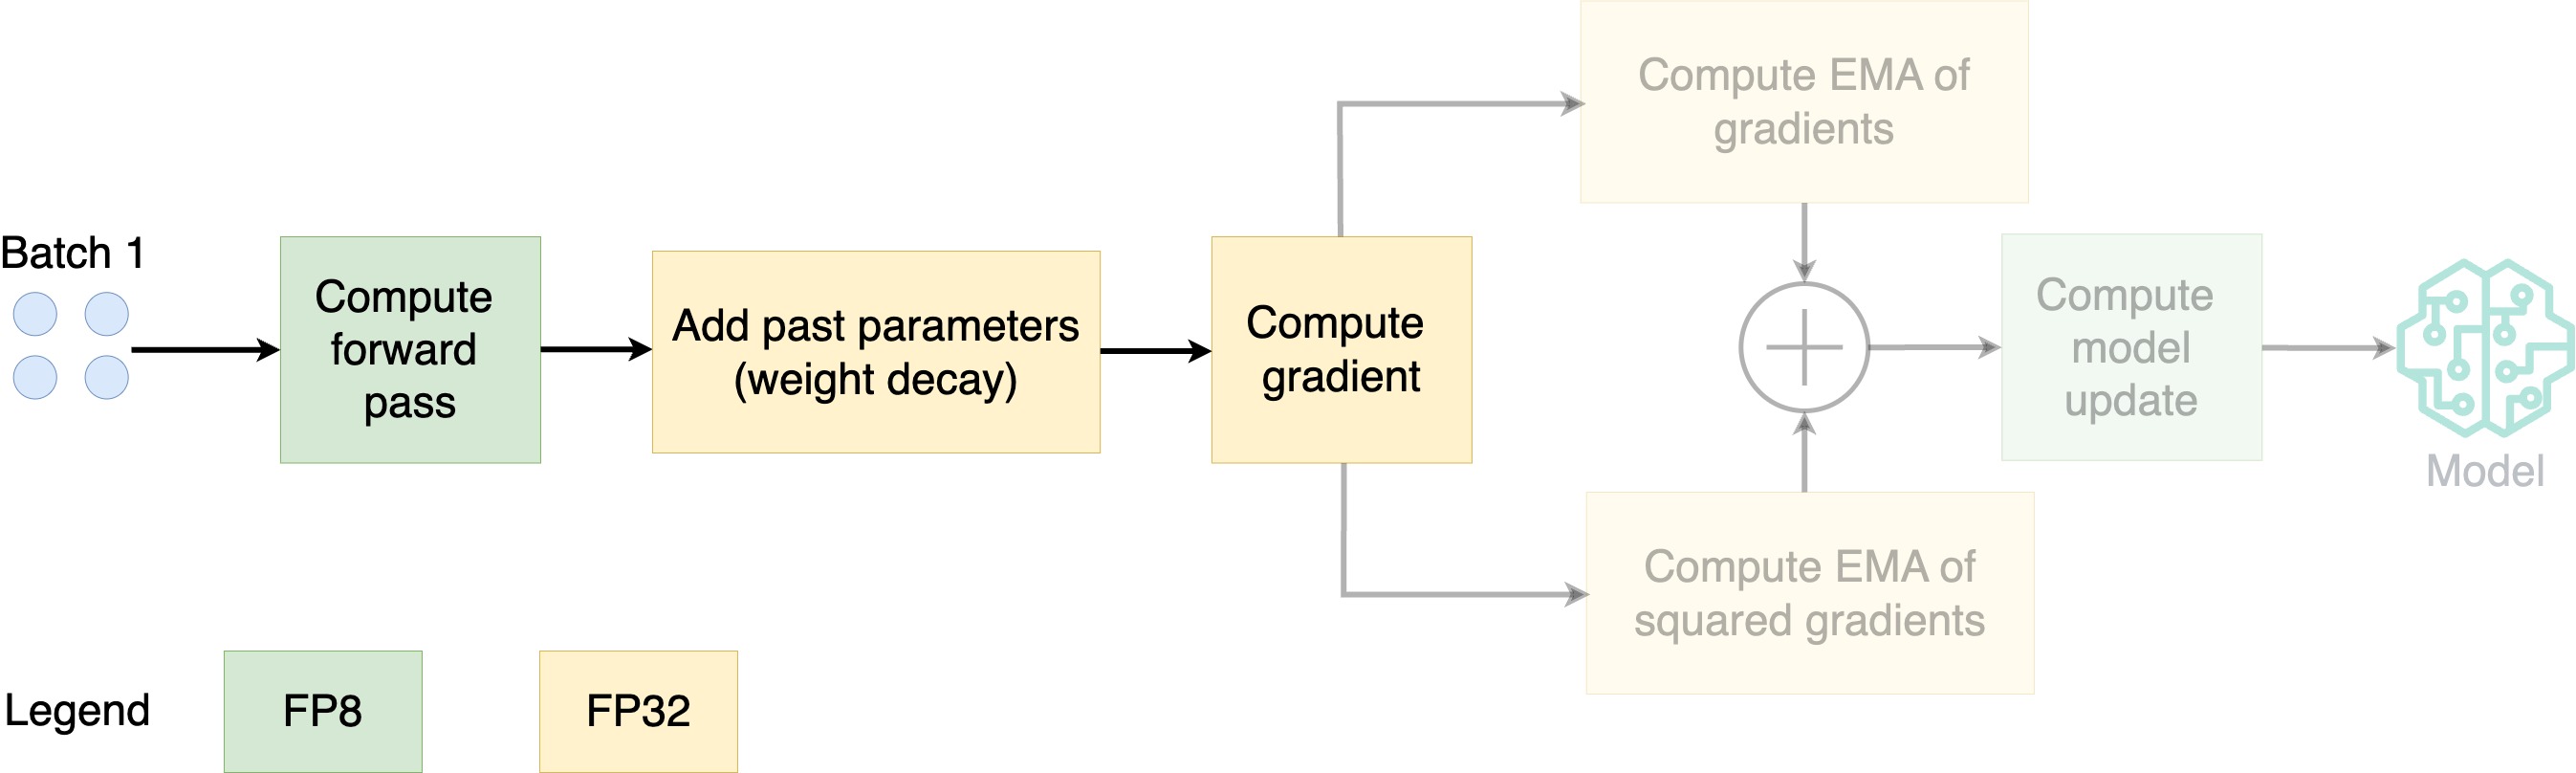
Как работает 8-битный Adam?

Диаграмма, показывающая шаги 8-битного Adam.

  • Параметры в FP8; оптимизация в FP32
Эффективное обучение моделей ИИ с PyTorch

Как работает 8-битный Adam?

Диаграмма, показывающая шаги 8-битного Adam.

  • Параметры в FP8; оптимизация в FP32
  • EMA: экспоненциальное скользящее среднее
  • Вычислить EMA градиентов и квадратов градиентов
Эффективное обучение моделей ИИ с PyTorch

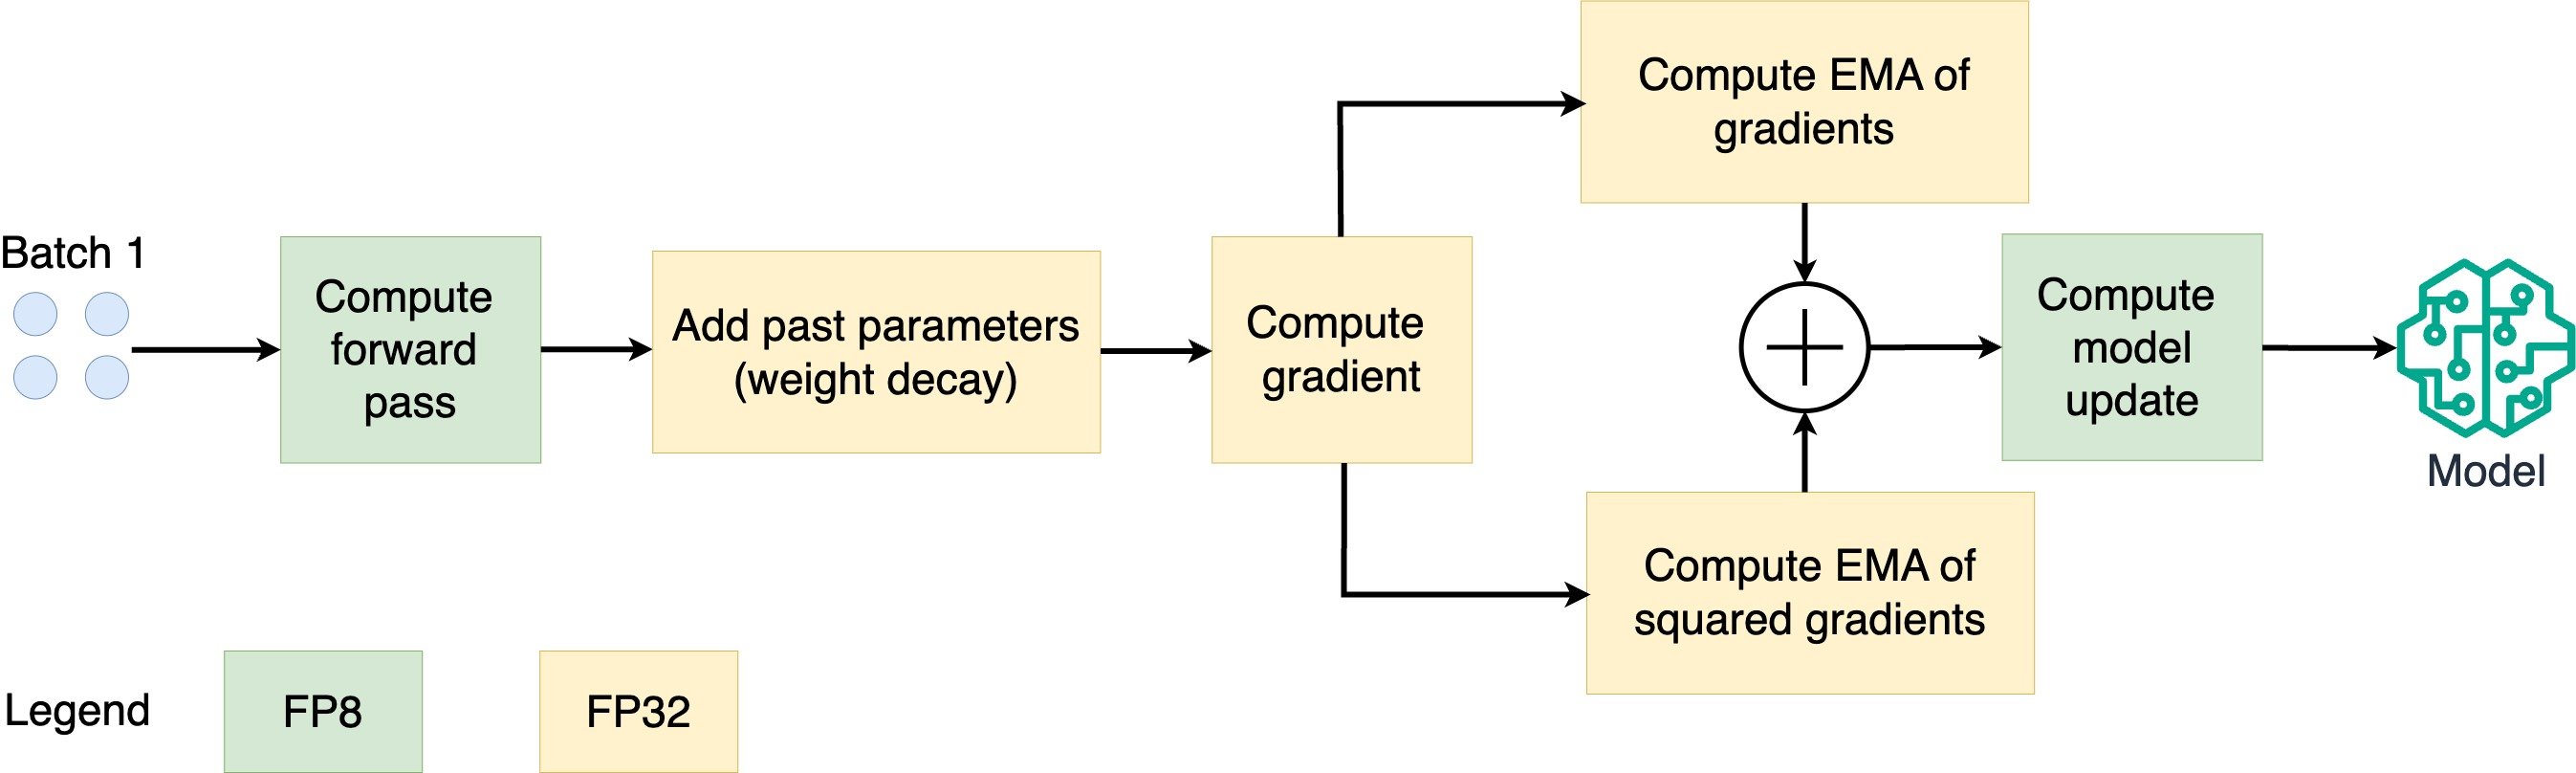
Как работает 8-битный Adam?

Диаграмма, показывающая шаги 8-битного Adam.

  • Параметры в FP8; оптимизация в FP32
  • EMA: экспоненциальное скользящее среднее
  • Вычислить EMA градиентов и квадратов градиентов
Эффективное обучение моделей ИИ с PyTorch

Как 8-битный Adam экономит память?

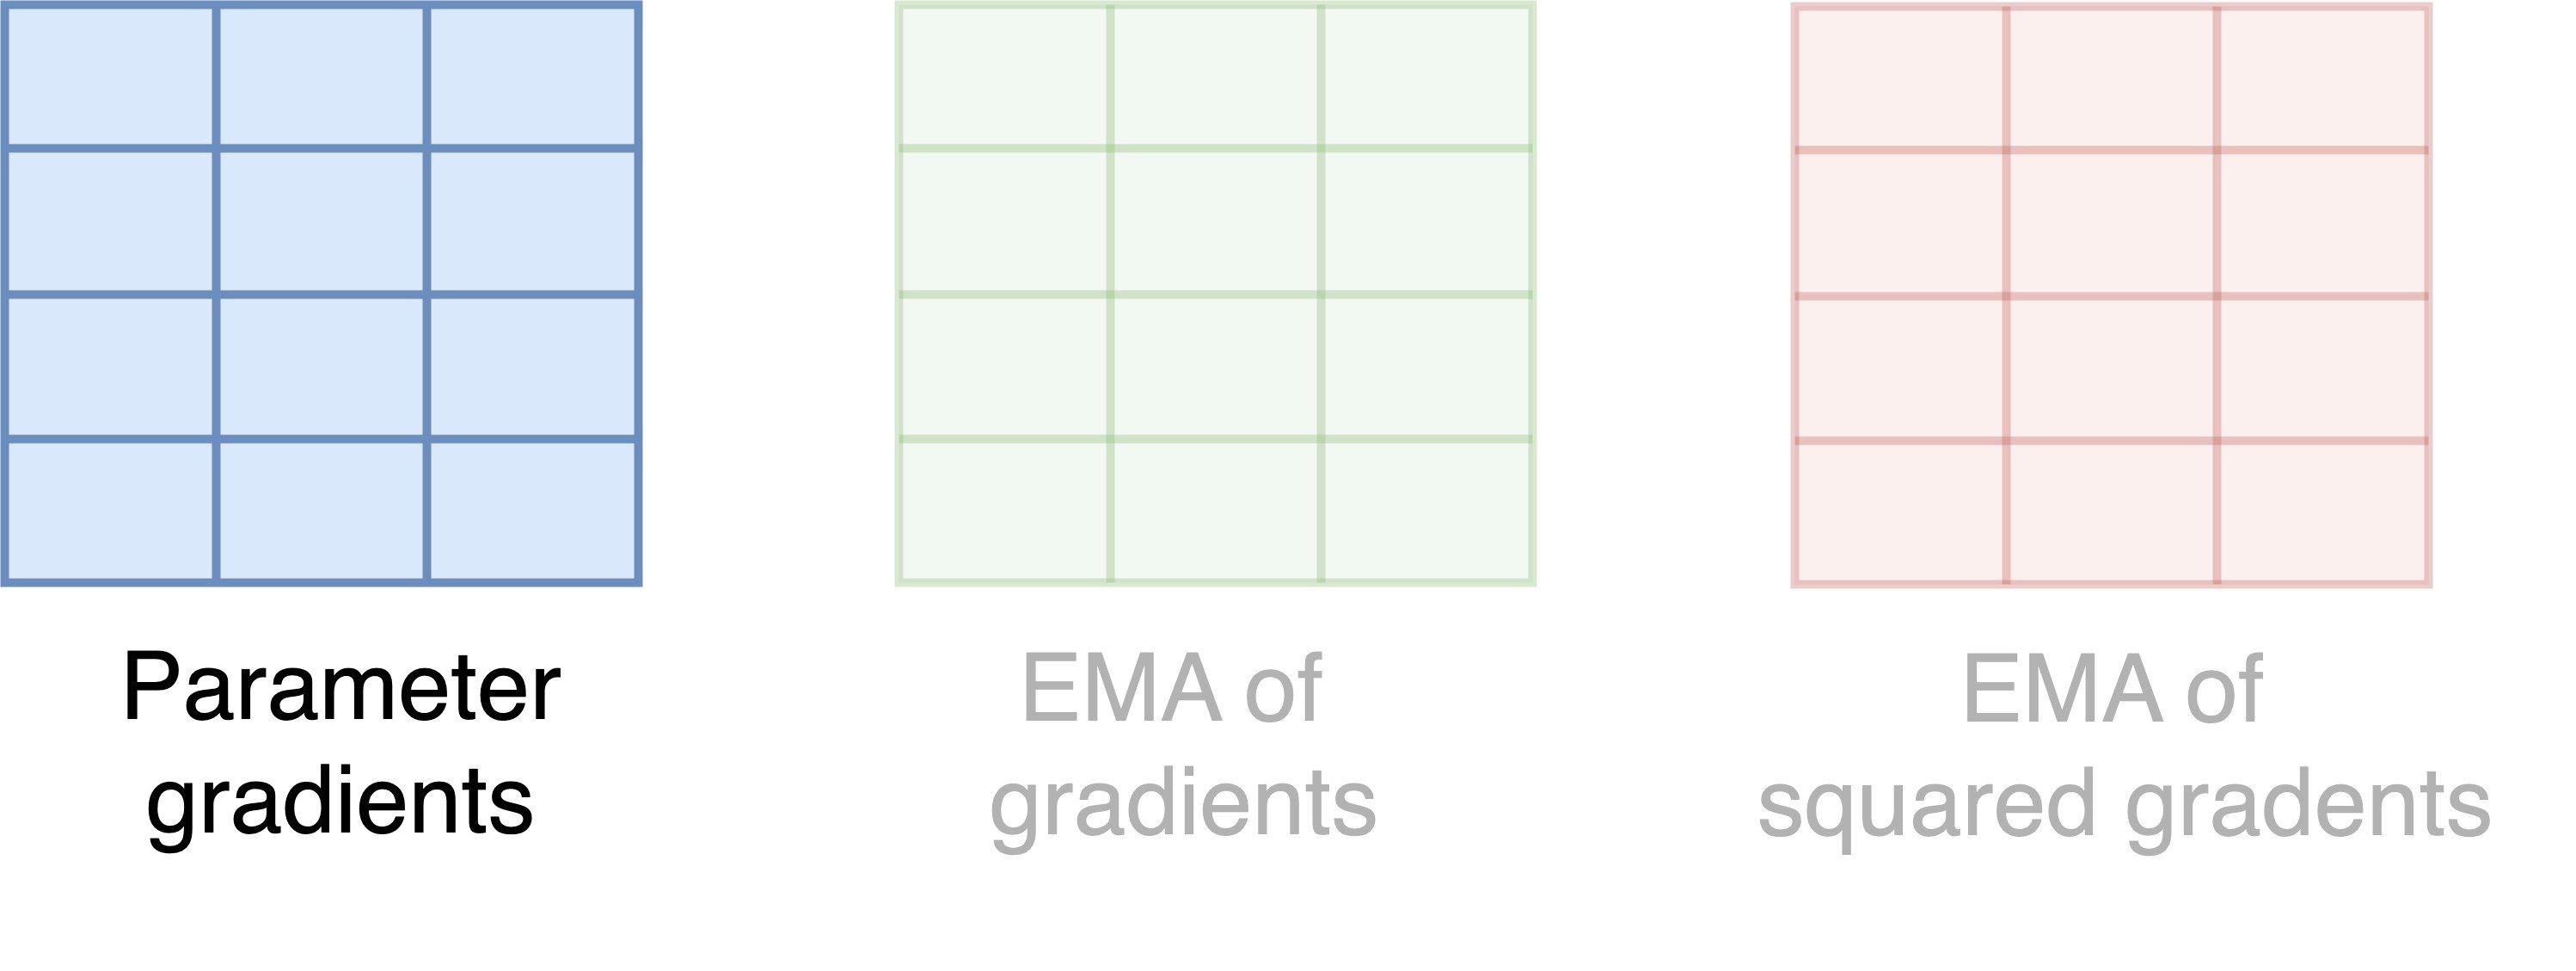
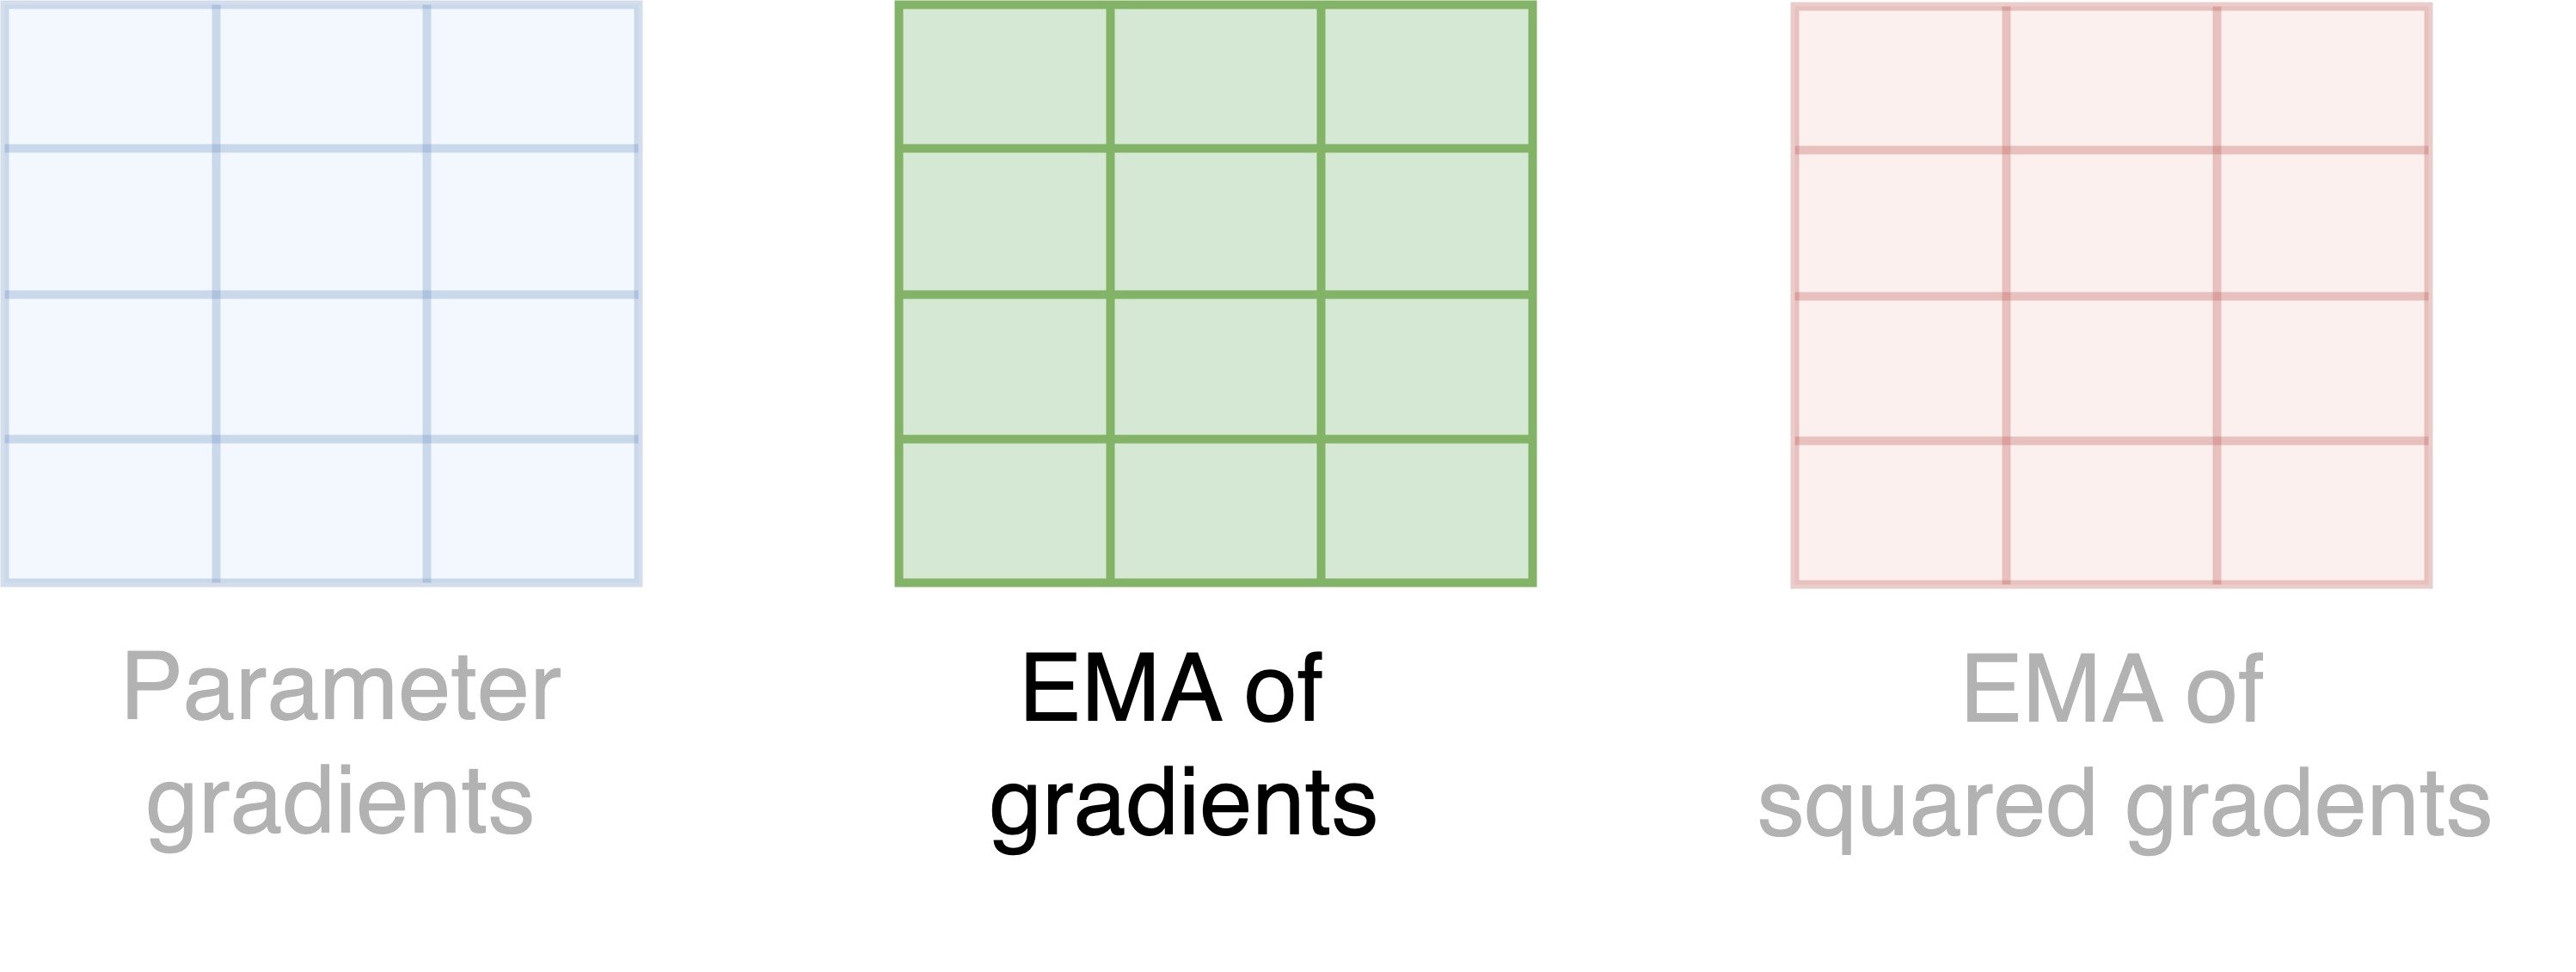
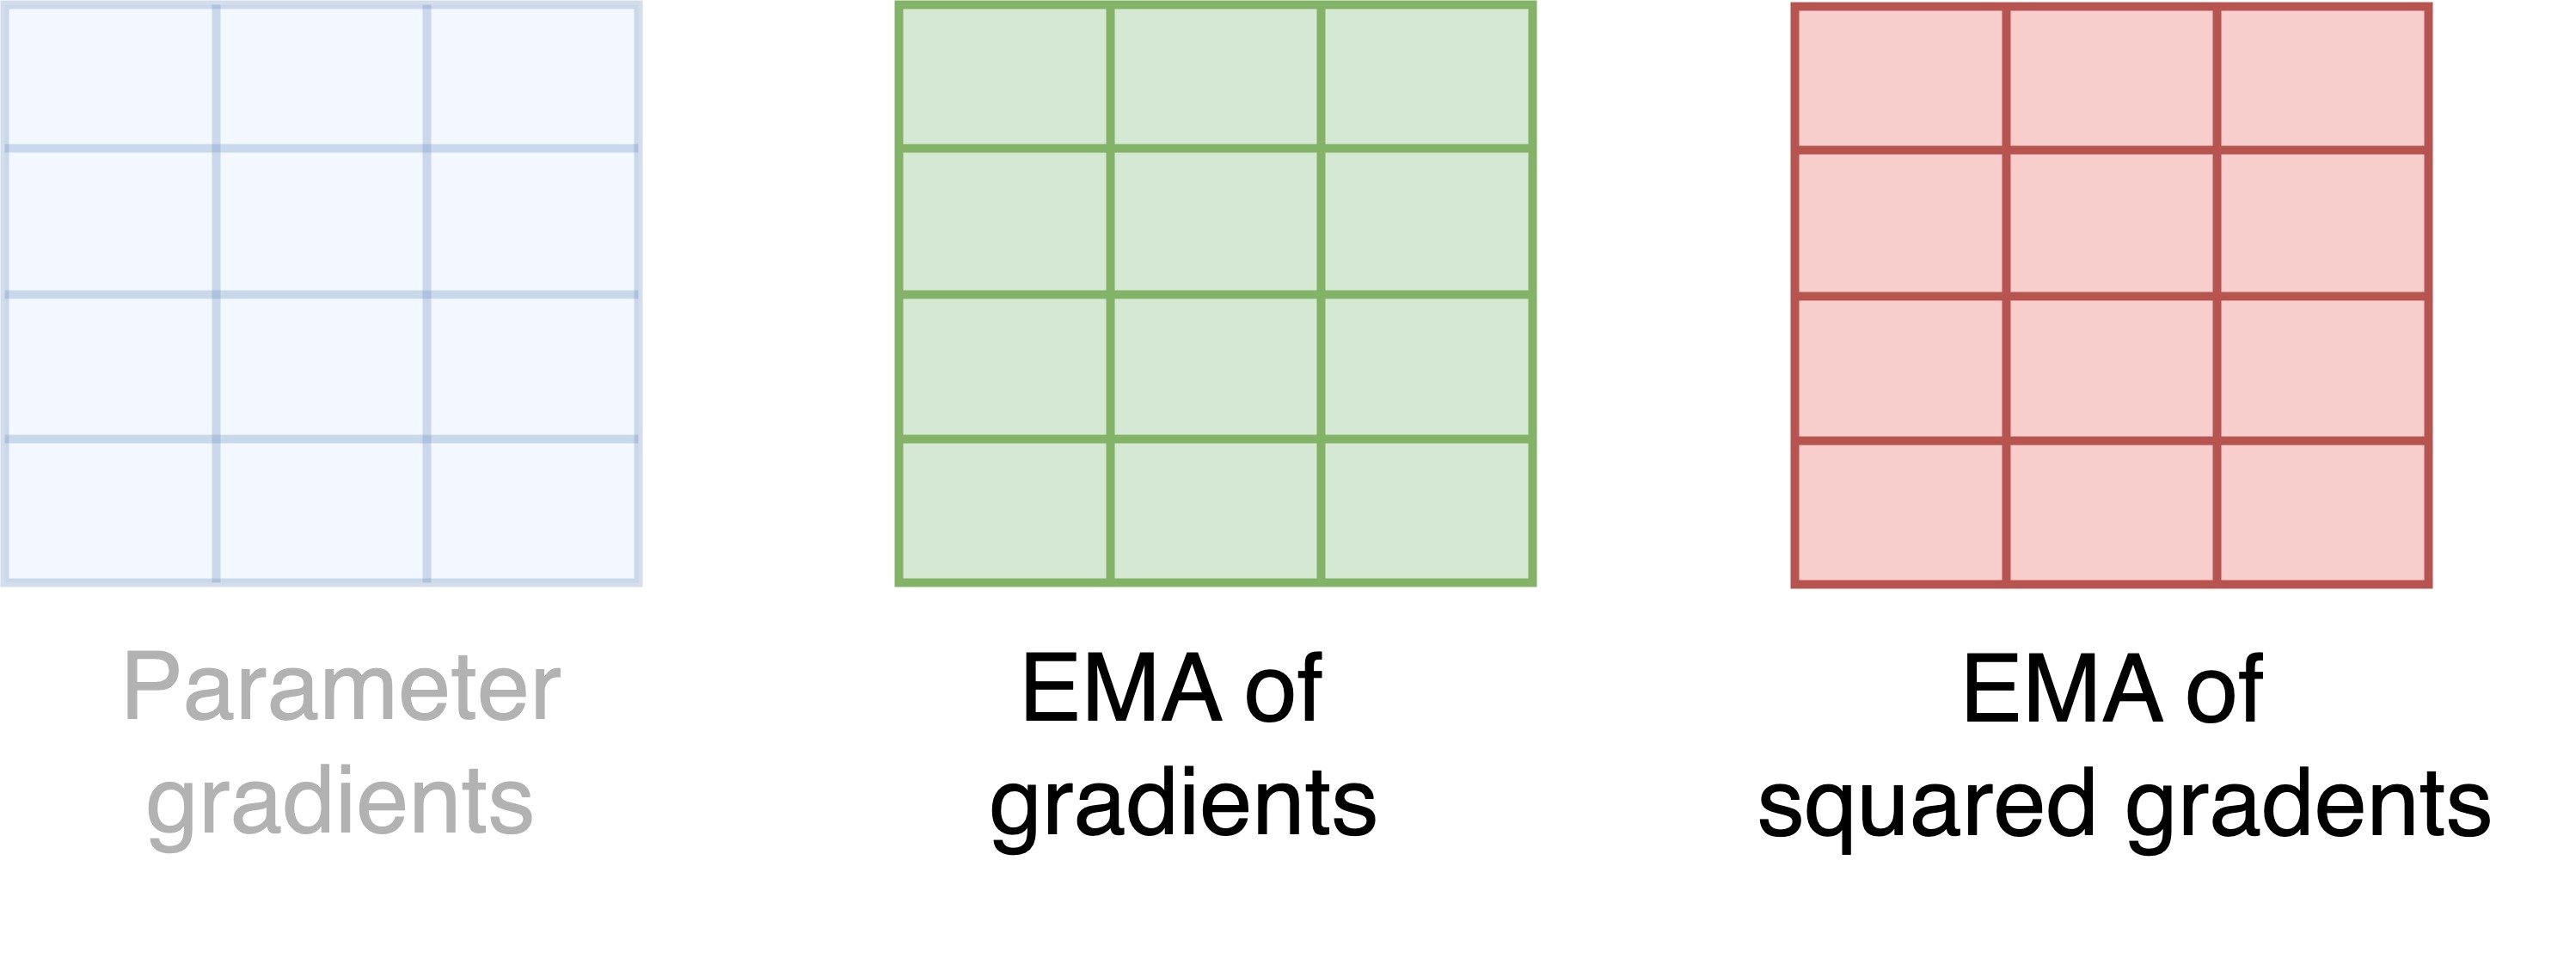
Диаграмма градиентов параметров, EMA градиентов и EMA квадратов градиентов.

Эффективное обучение моделей ИИ с PyTorch

Как 8-битный Adam экономит память?

Диаграмма градиентов параметров, EMA градиентов и EMA квадратов градиентов.

Эффективное обучение моделей ИИ с PyTorch

Как 8-битный Adam экономит память?

Диаграмма градиентов параметров, EMA градиентов и EMA квадратов градиентов.

  • Каждый квадрат — параметр, каждый цвет — состояние
  • Память на параметр = 2 байта = 1 байт на состояние × 2 состояния
  • Всего памяти = память на параметр (2 байта) × число параметров
Эффективное обучение моделей ИИ с PyTorch

Оценка потребления памяти 8-битным Adam

model = AutoModelForSequenceClassification.from_pretrained(
    "distilbert-base-cased", return_dict=True)
num_parameters = sum(p.numel() for p in model.parameters())
print(f"Number of model parameters: {num_parameters:,}")
Number of model parameters: 65,783,042
estimated_memory = num_parameters * 2 / (1024 ** 2)
print(f"Estimated memory usage of 8-bit Adam: {estimated_memory:.0f} MB")
Estimated memory usage of 8-bit Adam: 125 MB
Эффективное обучение моделей ИИ с PyTorch

Настройка оптимизатора 8-битный Adam

import bitsandbytes as bnb
from torch import nn
from transformers.trainer_pt_utils import get_parameter_names


args = TrainingArguments(output_dir="./results")
decay_parameters = get_parameter_names(model, [nn.LayerNorm])
decay_parameters = [name for name in decay_parameters if "bias" not in name]
  • Регуляризация весов предотвращает переобучение
  • decay_parameters: параметры, к которым применяется регуляризация весов
  • get_parameter_names: возвращает имена параметров; игнорирует слои nn.LayerNorm
  • Удалить параметры bias из decay_parameters
  • Не применять регуляризацию к слоям нормализации и смещениям
Эффективное обучение моделей ИИ с PyTorch

Настройка оптимизатора 8-битный Adam

optimizer_grouped_parameters = [{"params": [p for n, p in model.named_parameters() 
                                            if n in decay_parameters],
                                 "weight_decay": args.weight_decay},

{"params": [p for n, p in model.named_parameters() if n not in decay_parameters], "weight_decay": 0.0}]
adam_bnb_optim = bnb.optim.Adam8bit(optimizer_grouped_parameters,
betas=(args.adam_beta1, args.adam_beta2),
eps=args.adam_epsilon,
lr=args.learning_rate)
  • optimizer_grouped_parameters: одна группа с регуляризацией, другая — без
  • beta1, beta2: скорость затухания 1-го и 2-го моментов; выше = стабильнее, медленнее
Эффективное обучение моделей ИИ с PyTorch

Реализация 8-битного Adam с Trainer

trainer = Trainer(model=model,
                  args=training_args,
                  train_dataset=train_dataset,
                  eval_dataset=validation_dataset,
                  optimizers=(adam_bnb_optim, None),
                  compute_metrics=compute_metrics)

trainer.train()
{'epoch': 1.0, 'eval_loss': 0.63, 'eval_accuracy': 0.67, 'eval_f1': 0.62}
{'epoch': 2.0, 'eval_loss': 0.61, 'eval_accuracy': 0.71, 'eval_f1': 0.66}
Эффективное обучение моделей ИИ с PyTorch

Реализация 8-битного Adam с Accelerator

model, adam_bnb_optim, train_dataloader, lr_scheduler = \
    accelerator.prepare(model, adam_bnb_optim, train_dataloader, lr_scheduler)


for batch in train_dataloader: inputs, targets = batch["input_ids"], batch["labels"] outputs = model(inputs, labels=targets) loss = outputs.loss accelerator.backward(loss) adam_bnb_optim.step() lr_scheduler.step() adam_bnb_optim.zero_grad() print(f"Loss = {loss}")
Loss = 0.75
Эффективное обучение моделей ИИ с PyTorch

Расчёт потребления памяти 8-битным Adam

total_size_megabytes, total_num_elements = \
    compute_optimizer_size(trainer.optimizer.state.values())
print(f"Number of 8-bit Adam parameters: {total_num_elements:,}")
print(f"8-bit Adam size: {total_size_megabytes:.0f} MB")
Number of 8-bit Adam parameters: 131,566,188
8-bit Adam size: 128 MB
  • Сравнение с AdamW: 8-битный Adam использует в 4 раза меньше памяти
Number of AdamW parameters: 131,566,188
AdamW size: 502 MB
Эффективное обучение моделей ИИ с PyTorch

Вперёд, практиковаться!

Эффективное обучение моделей ИИ с PyTorch

Preparing Video For Download...