Оцінювання моделей з Accelerator

Ефективне тренування моделей ШІ з PyTorch

Dennis Lee

Data Engineer, Amazon

Навіщо переводити модель у режим оцінювання?

  • Режим навчання
    • Dropout: занулення нейронів
    • Batch normalization

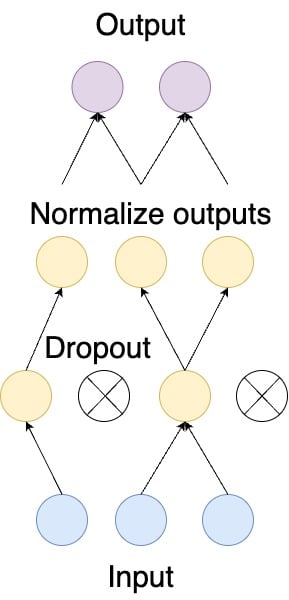
Dropout і batch normalization Схема нейромережі з вхідним, прихованими та вихідним шарами. Dropout застосовано до прихованих шарів для запобігання перенавчанню, а batch normalization нормалізує вихід кожного шару перед активацією.

Ефективне тренування моделей ШІ з PyTorch

Навіщо переводити модель у режим оцінювання?

  • Режим навчання
    • Dropout: занулення нейронів
    • Batch normalization
  • Режим оцінювання вимикає ці шари
  • model.eval() вмикає режим оцінювання

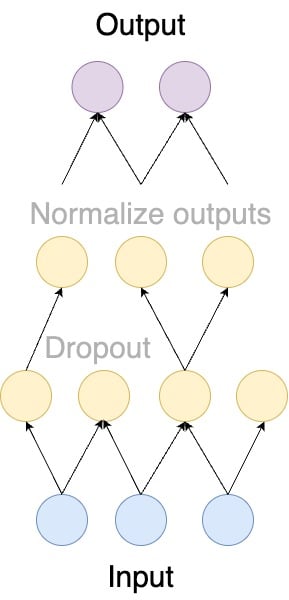
Dropout і batch normalization Схема нейромережі з вхідним, прихованими та вихідним шарами. Dropout застосовано до прихованих шарів для запобігання перенавчанню, а batch normalization нормалізує вихід кожного шару перед активацією.

Ефективне тренування моделей ШІ з PyTorch

Вимкнення градієнтів із torch.no_grad()

  • Для навчання потрібні градієнти
  • torch.no_grad() вимикає градієнти
  • Викликайте і model.eval, і torch.no_grad:
model.eval()
with torch.no_grad():
    outputs = model(**inputs)

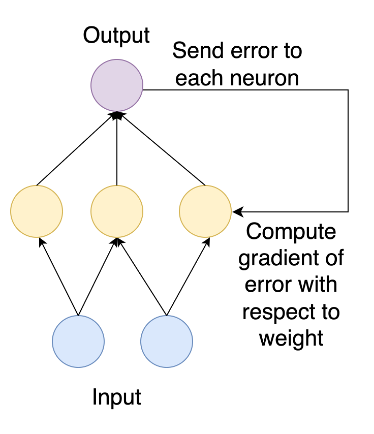
Обчислення градієнтів у зворотному поширенні Схема нейромережі, що ілюструє backpropagation: градієнти обчислюються на кожному шарі для корекції ваг. Показано, як помилки поширюються назад від вихідного шару через приховані шари, щоб оновити ваги методом градієнтного спуску.
Ефективне тренування моделей ШІ з PyTorch

Підготовка валідаційного датасету

  • Завантажте валідаційну частину датасету MRPC
validation_dataset = load_dataset("glue", "mrpc", split="validation")
  • Токенізуйте валідаційний датасет
def encode(examples):
    return tokenizer(examples["sentence1"], 
                      examples["sentence2"],
                      truncation=True,
                      padding="max_length")

validation_dataset = validation_dataset.map(encode, batched=True)
Ефективне тренування моделей ШІ з PyTorch

Життєвий цикл епохи: тренувальний і оціночний цикли

  • Для кожної епохи ітеруйтеся по train і validation датасетах
  • Спершу запустіть модель у режимі навчання
  • Потім у режимі оцінювання й залогуйте метрики після оцінки
for epoch in range(num_epochs):

model.train() for step, batch in enumerate(train_dataloader): # Perform training step
model.eval() for step, batch in enumerate(eval_dataloader): # Perform evaluation step
# Log evaluation metrics
Ефективне тренування моделей ШІ з PyTorch

Усередині циклу оцінювання

metric = evaluate.load("glue", "mrpc")
model.eval()
for step, batch in enumerate(eval_dataloader):

with torch.no_grad(): outputs = model(**batch) predictions = outputs.logits.argmax(dim=-1)
predictions, references = accelerator.gather_for_metrics((predictions, batch["labels"]))
metric.add_batch(predictions=predictions, references=references)
eval_metric = metric.compute() print(f"Eval metrics: \n{eval_metric}")
Метрики оцінювання: 
{'accuracy': 0.81, 'f1': 0.77}
Ефективне тренування моделей ШІ з PyTorch

Логування метрик після оцінювання

  • Засоби трекінгу: ноутбуки для логування метрик; напр. TensorBoard і MLflow
  • log_with: використати всі інструменти трекінгу експериментів
  • .init_trackers(): ініціалізувати трекери
  • .log(): логувати accuracy, f1, epoch
  • .end_training(): завершити трекінг
accelerator = Accelerator(project_dir=".",
                          log_with="all")

accelerator.init_trackers("my_project")
for epoch in range(num_epochs): # Training loop is here # Evaluation loop is here accelerator.log({
"accuracy": eval_metric["accuracy"], "f1": eval_metric["f1"],
}, step=epoch)
accelerator.end_training()
Ефективне тренування моделей ШІ з PyTorch

Перейдемо до практики!

Ефективне тренування моделей ШІ з PyTorch

Preparing Video For Download...