Попередня обробка зображень і аудіо для навчання

Ефективне тренування моделей ШІ з PyTorch

Dennis Lee

Data Engineer, Amazon

Підготовка зображень і аудіо

Застосування зображень

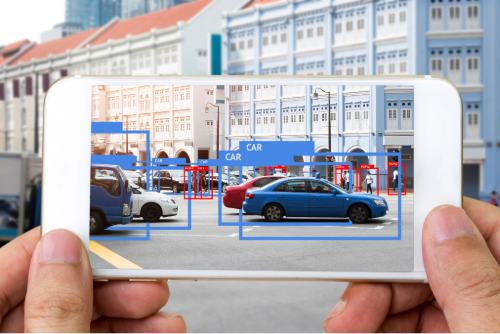
  • Класифікація зображень для виявлення об’єктів
  • Розподіл даних (sharding)


Зображення застосунку виявлення об’єктів із автомобілями на вулиці. Додаток працює на телефоні, який тримають перед сценою.

Застосування аудіо

  • Голосові команди
  • Приклад: "Зменшити гучність"


Зображення аудіотехнології асистивного доступу для людей із порушенням зору, щоб використовувати голосові команди на телефоні.

Ефективне тренування моделей ШІ з PyTorch

Робота з прикладним датасетом зображень

print(dataset)
Dataset({
    features: ['img', 'label'],
    num_rows: 1000
})
print(dataset[0]["img"])
<PIL.JpegImagePlugin.JpegImageFile image mode=RGB size=720x480>
Ефективне тренування моделей ШІ з PyTorch

Стандартизуйте формат зображення

  • Формат зображень: ширина, висота
  • Стандартизація пікселів: середнє, стандартне відхилення
  • AutoImageProcessor завантажує всі кроки препроцесингу
from transformers import AutoImageProcessor
model = "microsoft/swin-tiny-patch4-window7-224"

image_processor = AutoImageProcessor.from_pretrained(model)
Ефективне тренування моделей ШІ з PyTorch

Стандартизуйте формат зображення

dataset = dataset.map(
    lambda examples: {

"pixel_values": [
image_processor(image, return_tensors="pt").pixel_values for image in examples["img"] ]}, batched=True)
print(dataset)
Dataset({
    features: ['img', 'label', 'pixel_values'],
    num_rows: 1000
})
Ефективне тренування моделей ШІ з PyTorch

Робота з прикладним аудіодатасетом

print(dataset)
DatasetDict({
    train: Dataset({

features: ['file', 'audio',
'label'], num_rows: 1000 }), ... })
Ефективне тренування моделей ШІ з PyTorch

Стандартизуйте аудіоформат

  • Уніфікуйте кількість семплів
  • Частота дискретизації: семплів за секунду
  • Макс. тривалість: секунд аудіо
sampling_rate = 16000  # 16 kHz

max_duration = 1 # 1 second
max_length = sampling_rate * max_duration
print(f"max_length = {max_length:,} samples")
max_length = 16,000 samples
Ефективне тренування моделей ШІ з PyTorch

Стандартизуйте аудіоформат

from transformers import AutoFeatureExtractor

model = "facebook/wav2vec2-base"
feature_extractor = AutoFeatureExtractor.from_pretrained(model)


def preprocess_function(split_data):
audio_arrays = [x["array"] for x in split_data["audio"]]
inputs = feature_extractor(audio_arrays,
sampling_rate=feature_extractor.sampling_rate, max_length=int(feature_extractor.sampling_rate * max_duration),
truncation=True) return inputs
Ефективне тренування моделей ШІ з PyTorch

Застосуйте функцію попередньої обробки

  • Застосуйте preprocess_function до dataset
  • remove_columns: вилучити стовпці audio і file
  • batched: обробка прикладів dataset пакетами
dataset = dataset["train"].map(preprocess_function,

remove_columns=["audio", "file"],
batched=True)
Ефективне тренування моделей ШІ з PyTorch

Застосуйте функцію попередньої обробки

print(dataset)
DatasetDict({
    train: Dataset({
        features: ['label', 'input_values'],
        num_rows: 1000
    })
Ефективне тренування моделей ШІ з PyTorch

Підготовка даних для розподіленого навчання

  • DataLoader: підготовка даних для завантаження й ітерацій під час навчання
  • accelerator.prepare(): розміщує дані на CPU або GPU залежно від наявності
  • Розподіл даних (sharding): кожен GPU обробляє підмножину тренувальних даних
  • accelerator.prepare() працює з PyTorch DataLoader (torch.utils.data.DataLoader)
from accelerate import Accelerator
from torch.utils.data import DataLoader

dataloader = DataLoader(dataset, batch_size=32, shuffle=True)


accelerator = Accelerator() dataloader = accelerator.prepare(dataloader)
Ефективне тренування моделей ШІ з PyTorch

Перейдемо до практики!

Ефективне тренування моделей ШІ з PyTorch

Preparing Video For Download...