Тонке налаштування моделей з Trainer

Ефективне тренування моделей ШІ з PyTorch

Dennis Lee

Data Engineer, Amazon

Підготовка даних
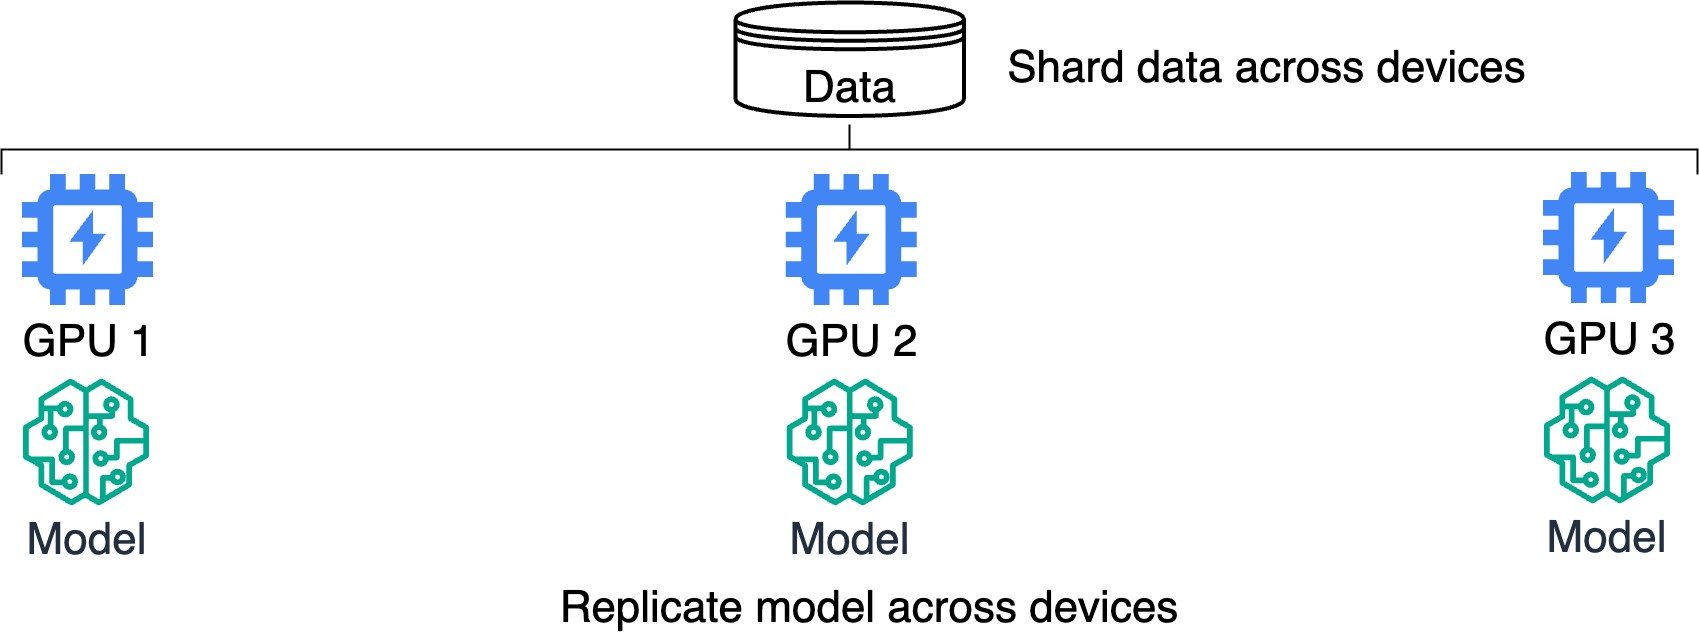
 

Схема розподіленого навчання з реплікацією моделі та шардингом даних.

Ефективне тренування моделей ШІ з PyTorch

Розподілене навчання


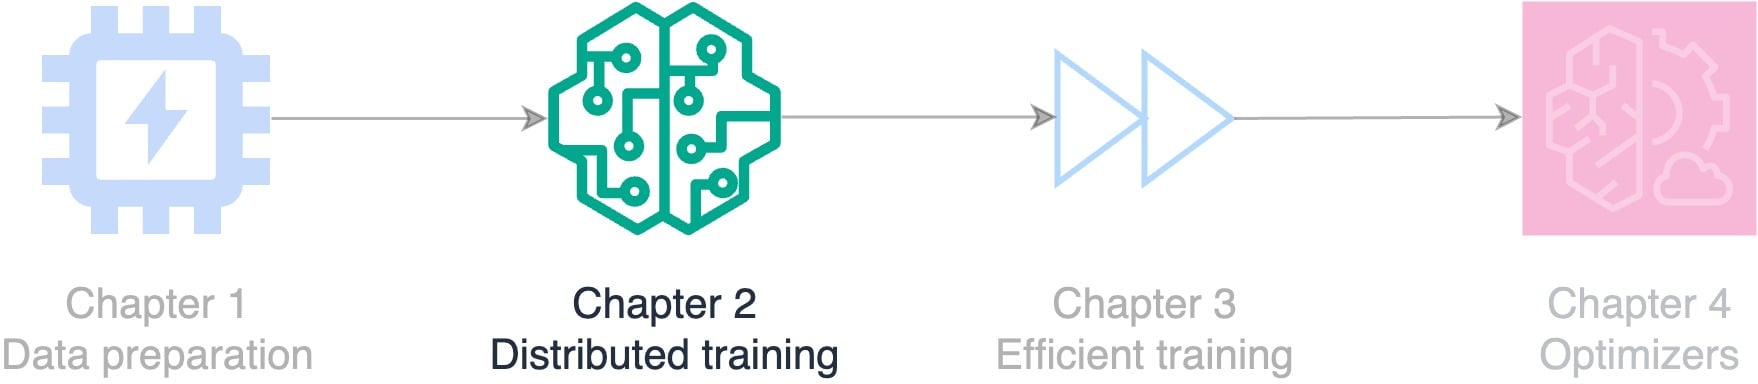
Блок-схема тем курсу: підготовка даних, розподілене навчання, ефективне навчання та оптимізатори.

Ефективне тренування моделей ШІ з PyTorch

Trainer і Accelerator

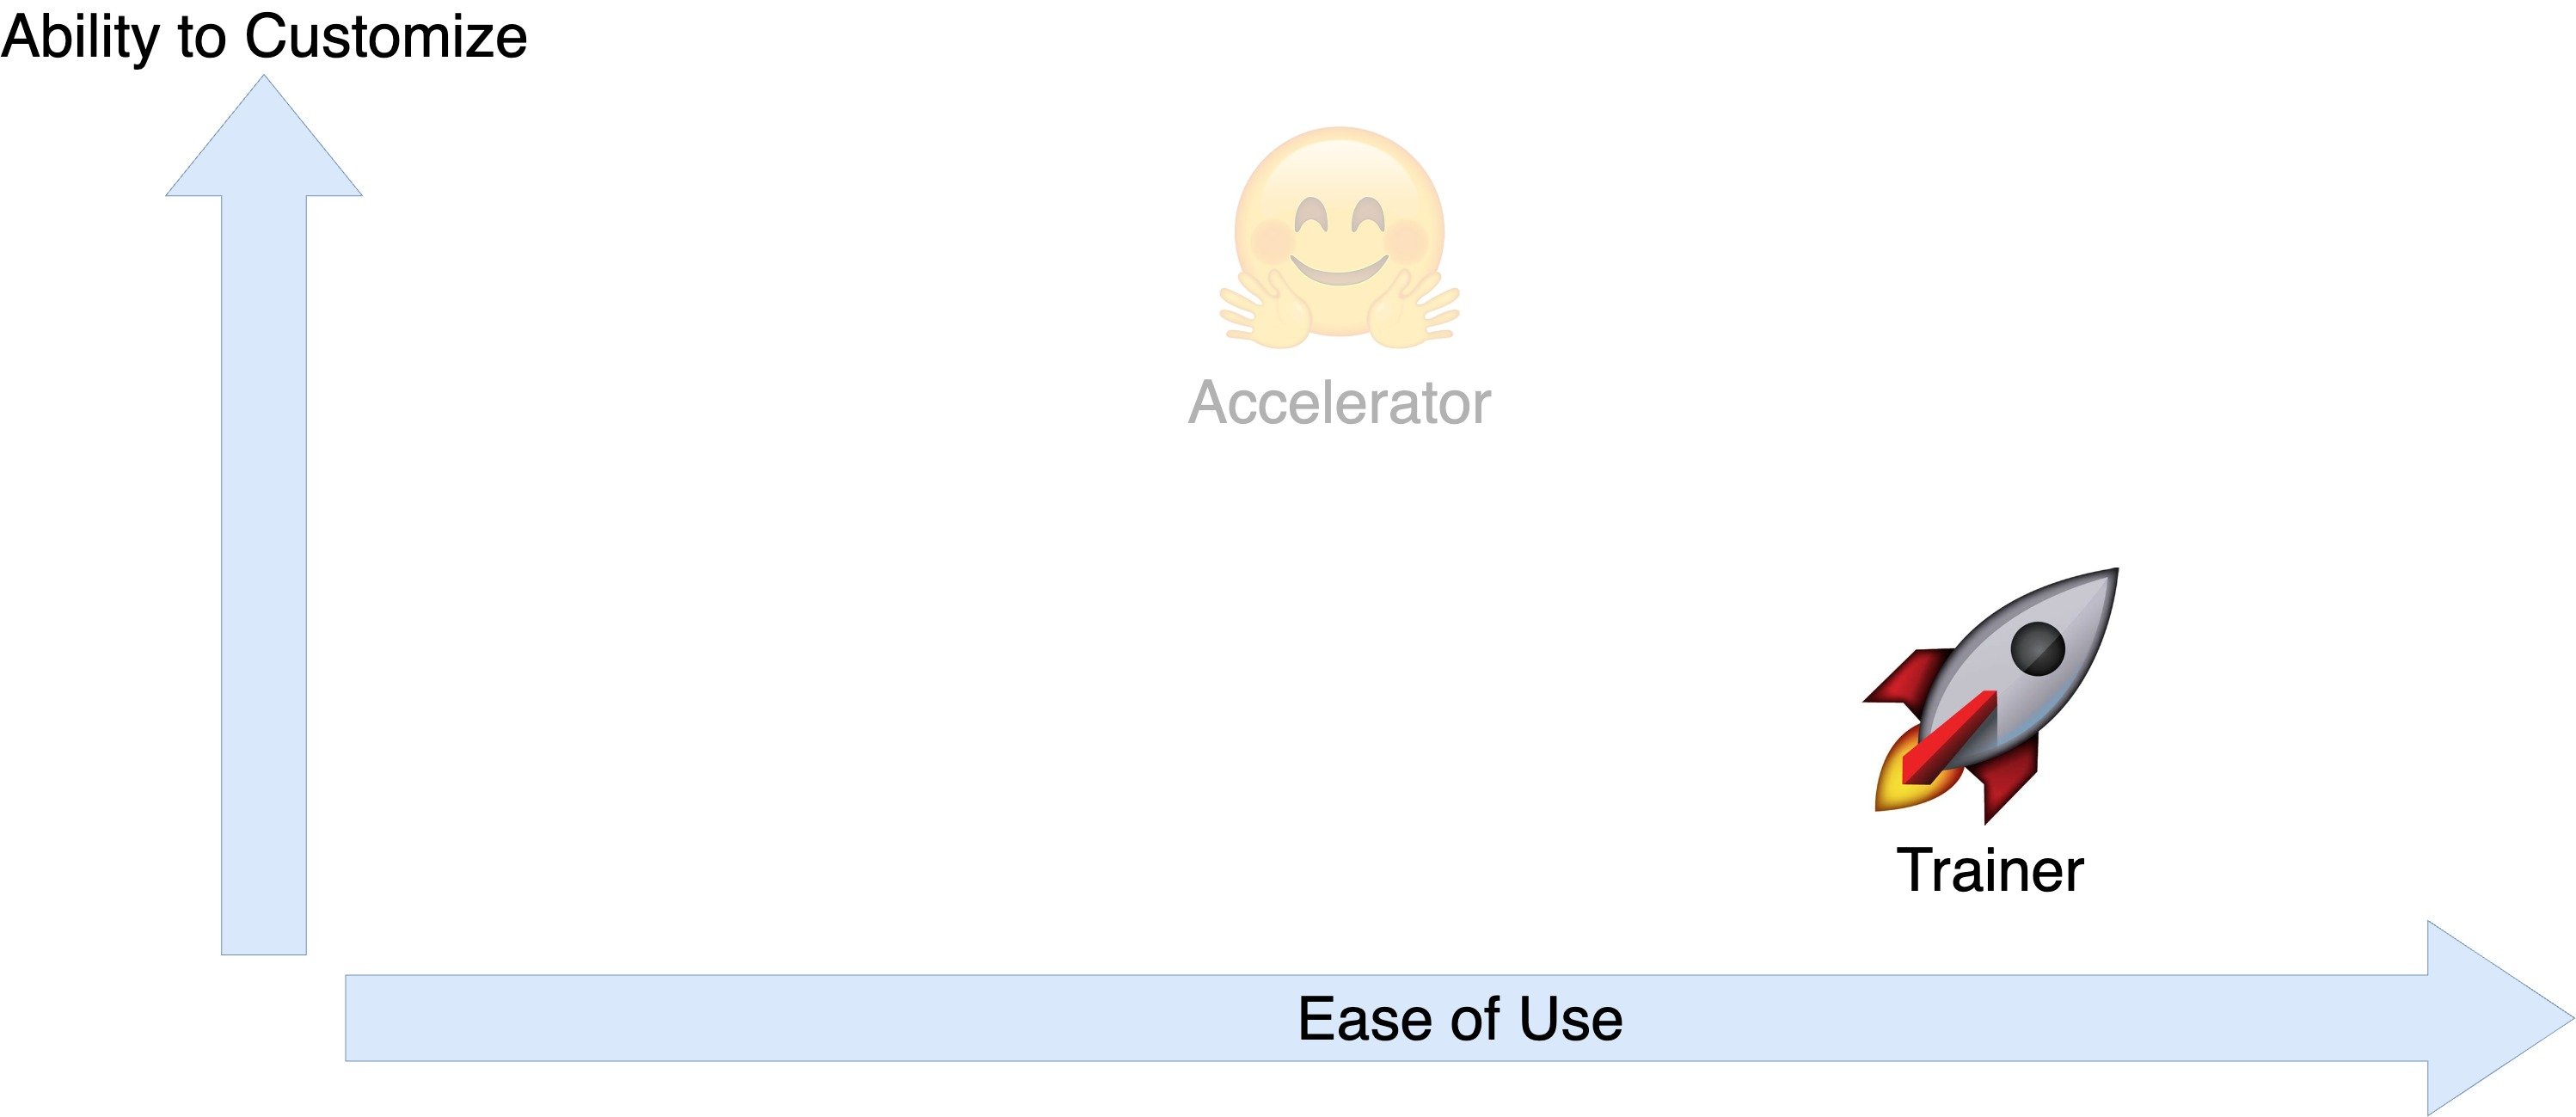
Діаграма порівняння простоти використання та можливостей налаштування для Accelerator і Trainer.

Ефективне тренування моделей ШІ з PyTorch

Trainer і Accelerator

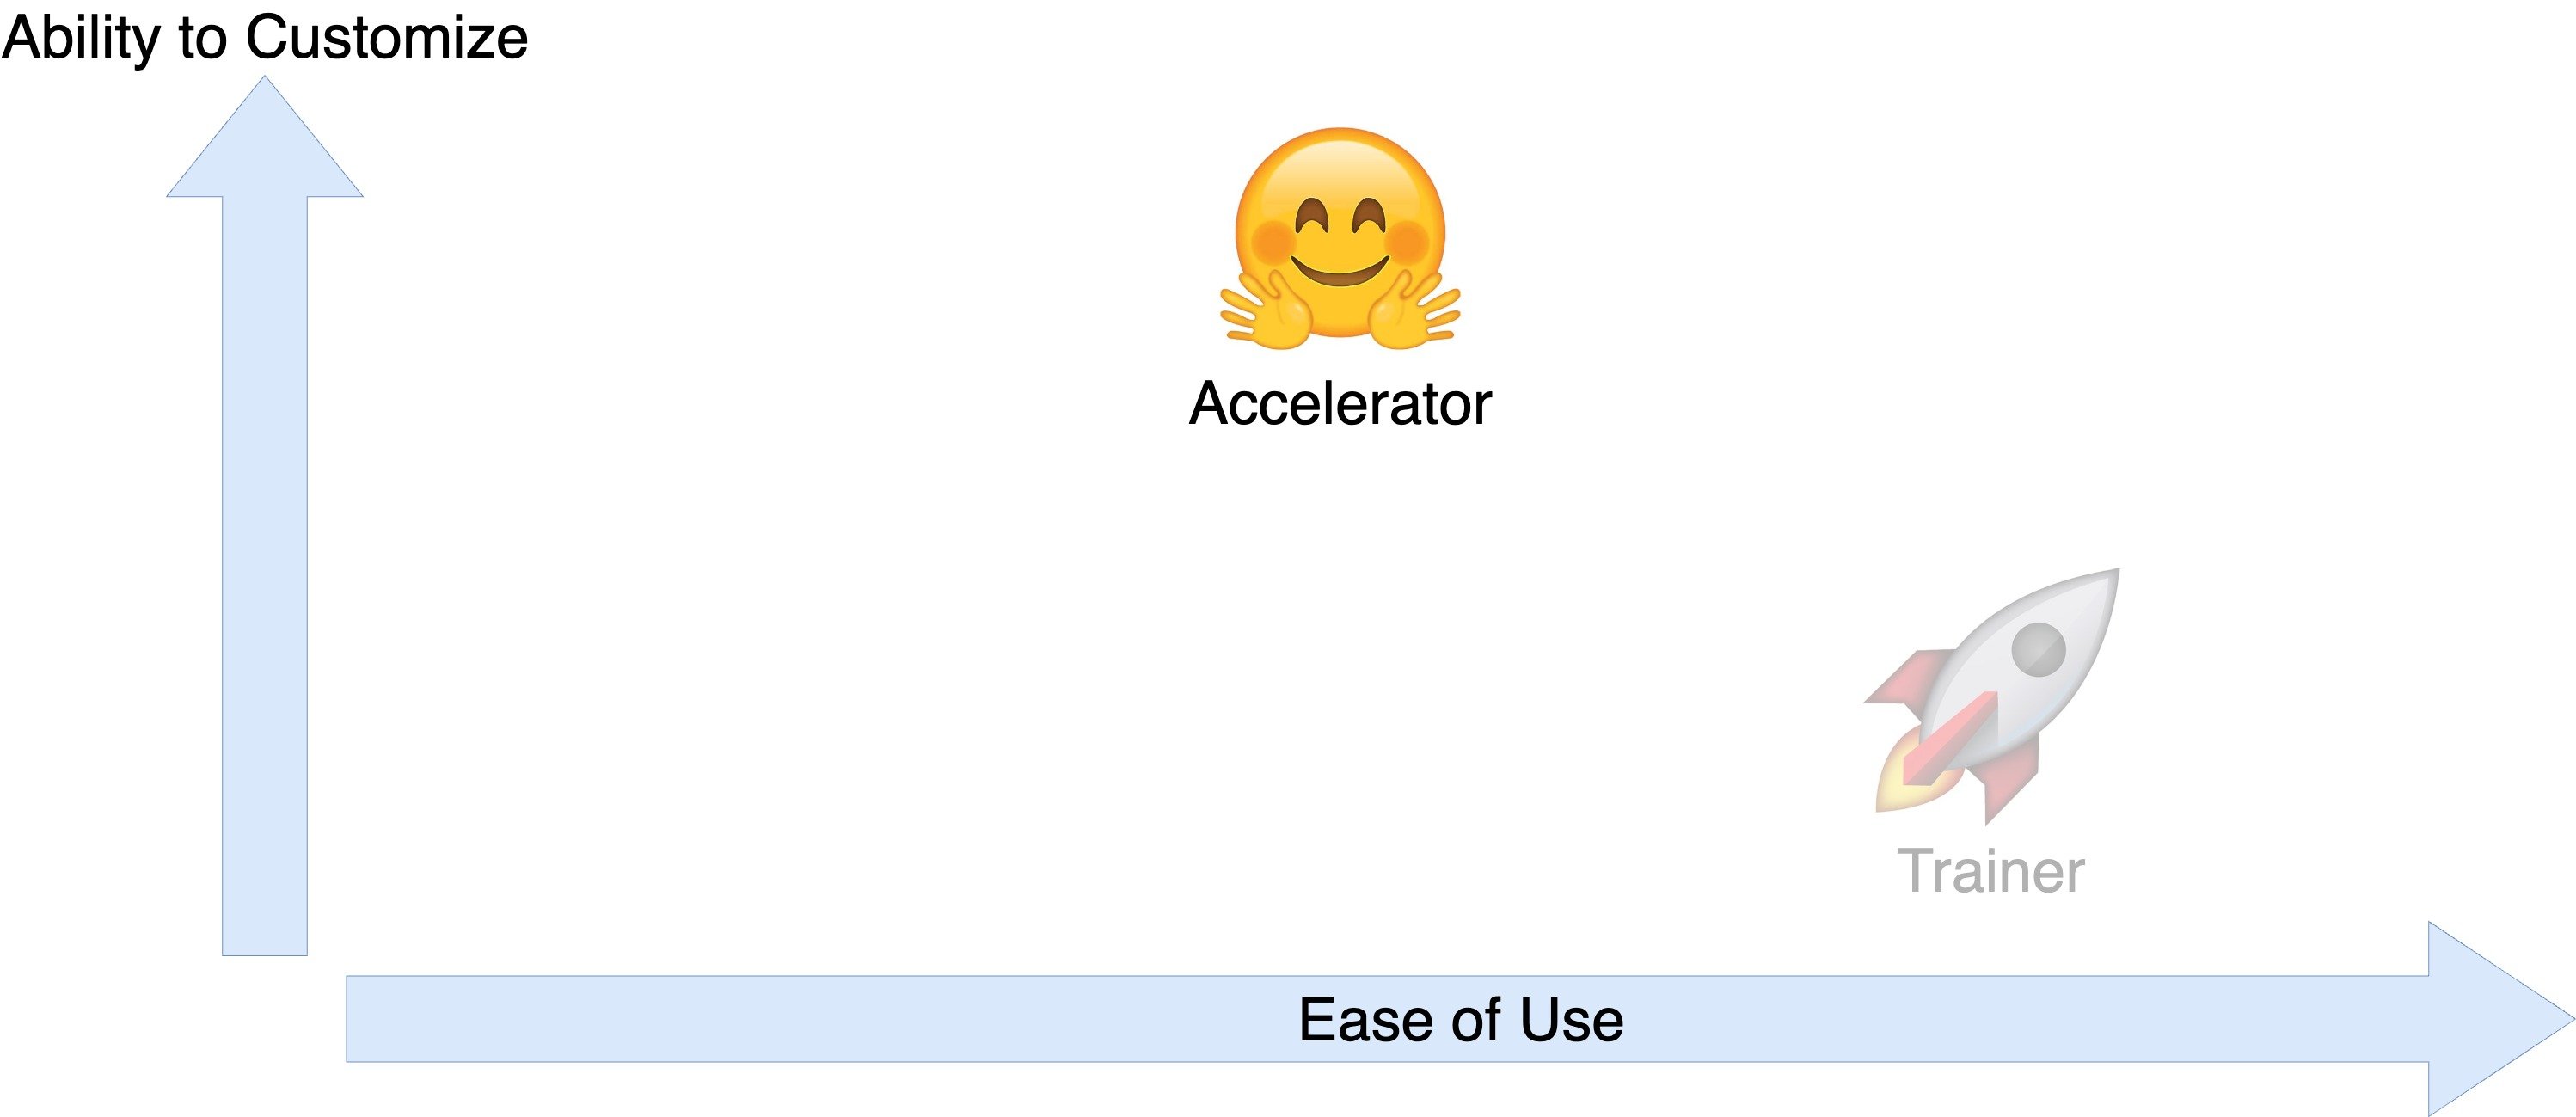
Діаграма порівняння простоти використання та можливостей налаштування для Accelerator і Trainer.

Ефективне тренування моделей ШІ з PyTorch

Прискорте навчання з Trainer

  • Бібліотека Trainer

    from transformers import Trainer
    
  • Запускає модель на кожному пристрої паралельно

  • Прискорює навчання, як конвеєри
  • Перевірка вхідних даних: набір даних, модель, метрики
  • Розробіть аналіз тональності для e-commerce

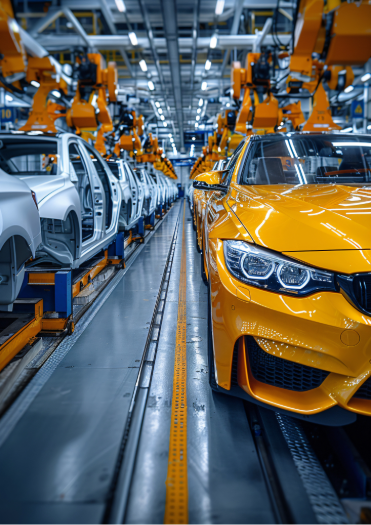
Зображення виробництва авто на конвеєрах, що ілюструє паралельну обробку.

Ефективне тренування моделей ШІ з PyTorch

Набір даних відгуків із тональністю

print(dataset)
DatasetDict({
    train: Dataset({
        features: ['Text', 'Label'],
        num_rows: 1000
    }), ...})
print(f'"{dataset["train"]["Text"][0]}": {dataset["train"]["Label"][0]}')
"I love this product!": positive
Ефективне тренування моделей ШІ з PyTorch

Перетворення міток на цілі числа

def map_labels(example):
    if example["Label"] == "negative":
        return {"labels": 0}

else: return {"labels": 1} dataset = dataset.map(map_labels)
print(f'First label: {dataset["train"]["labels"][0]}')
First label: 1
Ефективне тренування моделей ШІ з PyTorch

Визначення tokenizer і model

  • Завантажте попередньо натреновані model і tokenizer:
model = AutoModelForSequenceClassification.from_pretrained("distilbert-base-uncased", 
                                                           num_labels=2)

tokenizer = AutoTokenizer.from_pretrained("distilbert-base-uncased")
  • Застосуйте tokenizer до поля text:
def encode(examples):

return tokenizer(examples["Text"], padding="max_length", truncation=True, return_tensors="pt")
dataset = dataset.map(encode, batched=True)
print(f'The first tokenized review is {dataset["train"]["input_ids"][0]}.')
The first tokenized review is [101, 1045, 2293, 2023, 4031, 999, 102].
Ефективне тренування моделей ШІ з PyTorch

Визначення метрик оцінювання

import evaluate


def compute_metrics(eval_predictions):
load_accuracy = evaluate.load("accuracy") load_f1 = evaluate.load("f1")
logits, labels = eval_predictions
predictions = np.argmax(logits, axis=-1)
accuracy = load_accuracy.compute(predictions=predictions, references=labels)[ "accuracy" ]
f1 = load_f1.compute(predictions=predictions, references=labels)["f1"]
return {"accuracy": accuracy, "f1": f1}
Ефективне тренування моделей ШІ з PyTorch

Параметри навчання

  • output_dir: куди зберігати модель
  • Задайте гіперпараметри (напр., learning_rate і weight_decay)
  • save_strategy: зберігати після кожної епохи
  • evaluation_strategy: обчислювати метрики після кожної епохи
from transformers import (
    TrainingArguments)

training_args = TrainingArguments(
    output_dir="output_folder",

learning_rate=2e-5, per_device_train_batch_size=16, per_device_eval_batch_size=16, num_train_epochs=2, weight_decay=0.01,
save_strategy="epoch", evaluation_strategy="epoch", )
Ефективне тренування моделей ШІ з PyTorch

Налаштування Trainer

from transformers import Trainer

trainer = Trainer(model=model,

args=training_args,
train_dataset=dataset["train"], eval_dataset=dataset["validation"],
compute_metrics=compute_metrics)
trainer.train()
{'epoch': 1.0, 'eval_loss': 0.79, 'eval_accuracy': 0.00, 'eval_f1': 0.00}
{'epoch': 2.0, 'eval_loss': 0.65, 'eval_accuracy': 0.11, 'eval_f1': 0.15}
print(trainer.args.device)
cpu
Ефективне тренування моделей ШІ з PyTorch

Запуск аналізу тональності для e-commerce

sample_review = "This product is amazing!"

input_ids = tokenizer.encode(sample_review, return_tensors='pt') print(f"Tokenized review: {input_ids}")
Tokenized review: tensor([[ 101, 2023, 4031, 2003, 6429,  999,  102 ]])
Ефективне тренування моделей ШІ з PyTorch

Запуск аналізу тональності для e-commerce

output = model(input_ids)
print(f"Output logits: {output.logits}")
Output logits: tensor([[ -0.0538, 0.1300 ]])
predicted_label = torch.argmax(output.logits, dim=1).item()
print(f"Predicted label: {predicted_label}")
Predicted label: 1
sentiment = "Negative" if predicted_label == 0 else "Positive"
print(f'The sentiment of the product review is "{sentiment}."')
The sentiment of the product review is "Positive."
Ефективне тренування моделей ШІ з PyTorch

Checkpoint-и з Trainer

  • Продовжити з останнього checkpoint, як пауза у фільмі
trainer.train(resume_from_checkpoint=True)
{'epoch': 3.0, 'eval_loss': 0.29, 'eval_accuracy': 0.37, 'eval_f1': 0.51}
{'epoch': 4.0, 'eval_loss': 0.23, 'eval_accuracy': 0.46, 'eval_f1': 0.58}
  • Продовжити з конкретного checkpoint у вихідній директорії
trainer.train(resume_from_checkpoint="model/checkpoint-1000")
Ефективне тренування моделей ШІ з PyTorch

Passons à la pratique !

Ефективне тренування моделей ШІ з PyTorch

Preparing Video For Download...