Змішана точність з 8-бітним Adam

Ефективне тренування моделей ШІ з PyTorch

Dennis Lee

Data Engineer, Amazon

Оптимізатори для ефективного навчання
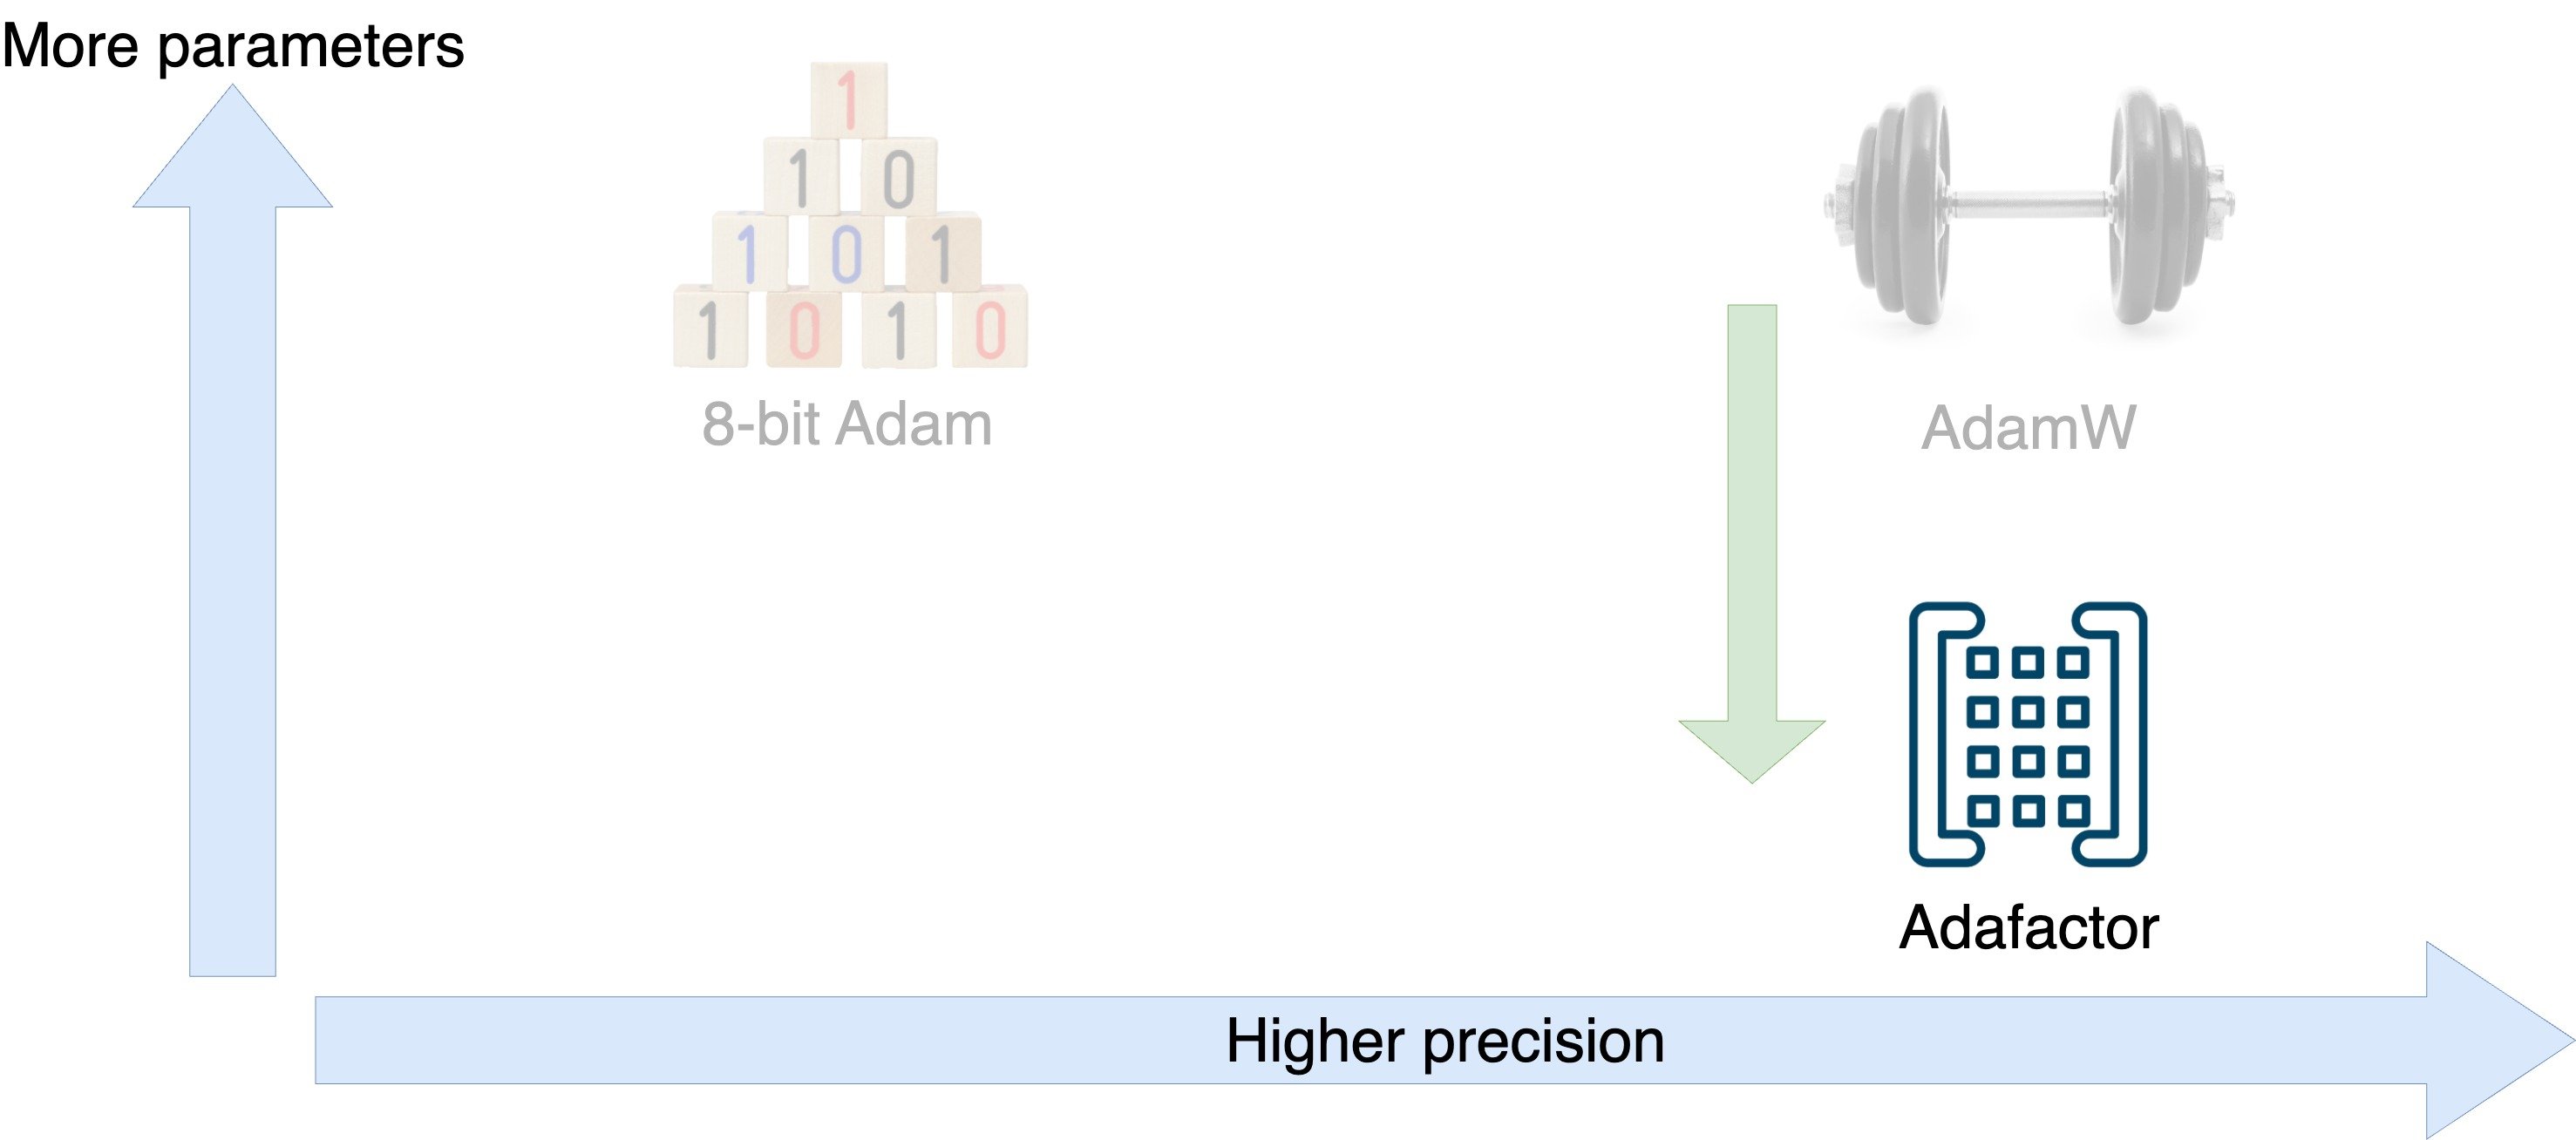
Схема, що показує компроміси між кількістю параметрів і точністю для AdamW, Adafactor та 8-бітного Adam.

Ефективне тренування моделей ШІ з PyTorch

Оптимізатори для ефективного навчання
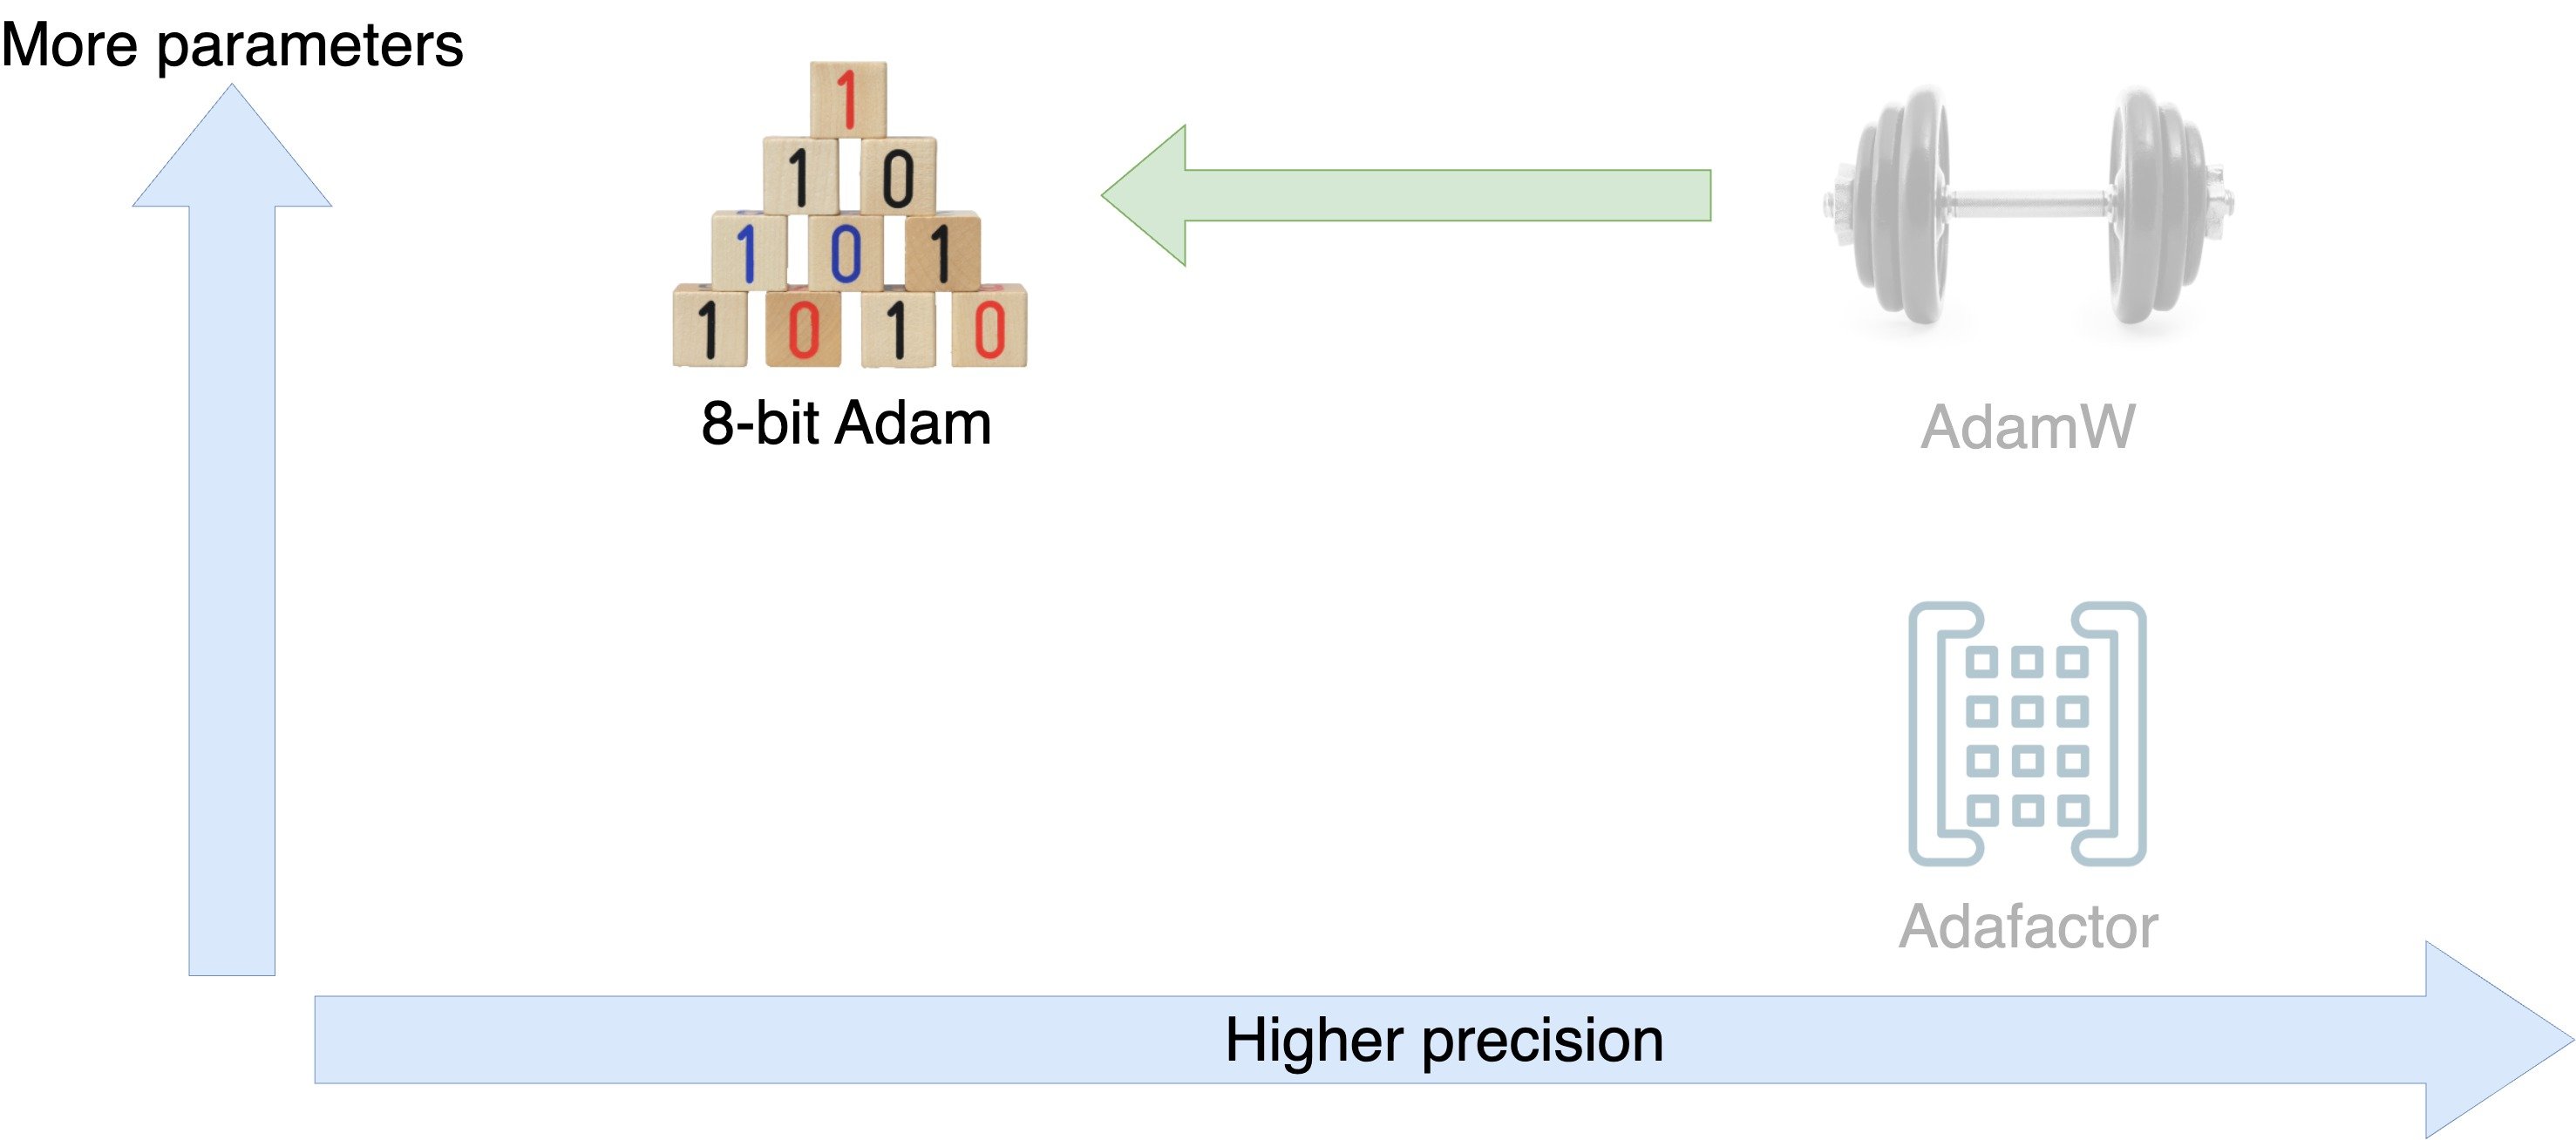
Схема, що показує компроміси між кількістю параметрів і точністю для AdamW, Adafactor та 8-бітного Adam.

Ефективне тренування моделей ШІ з PyTorch

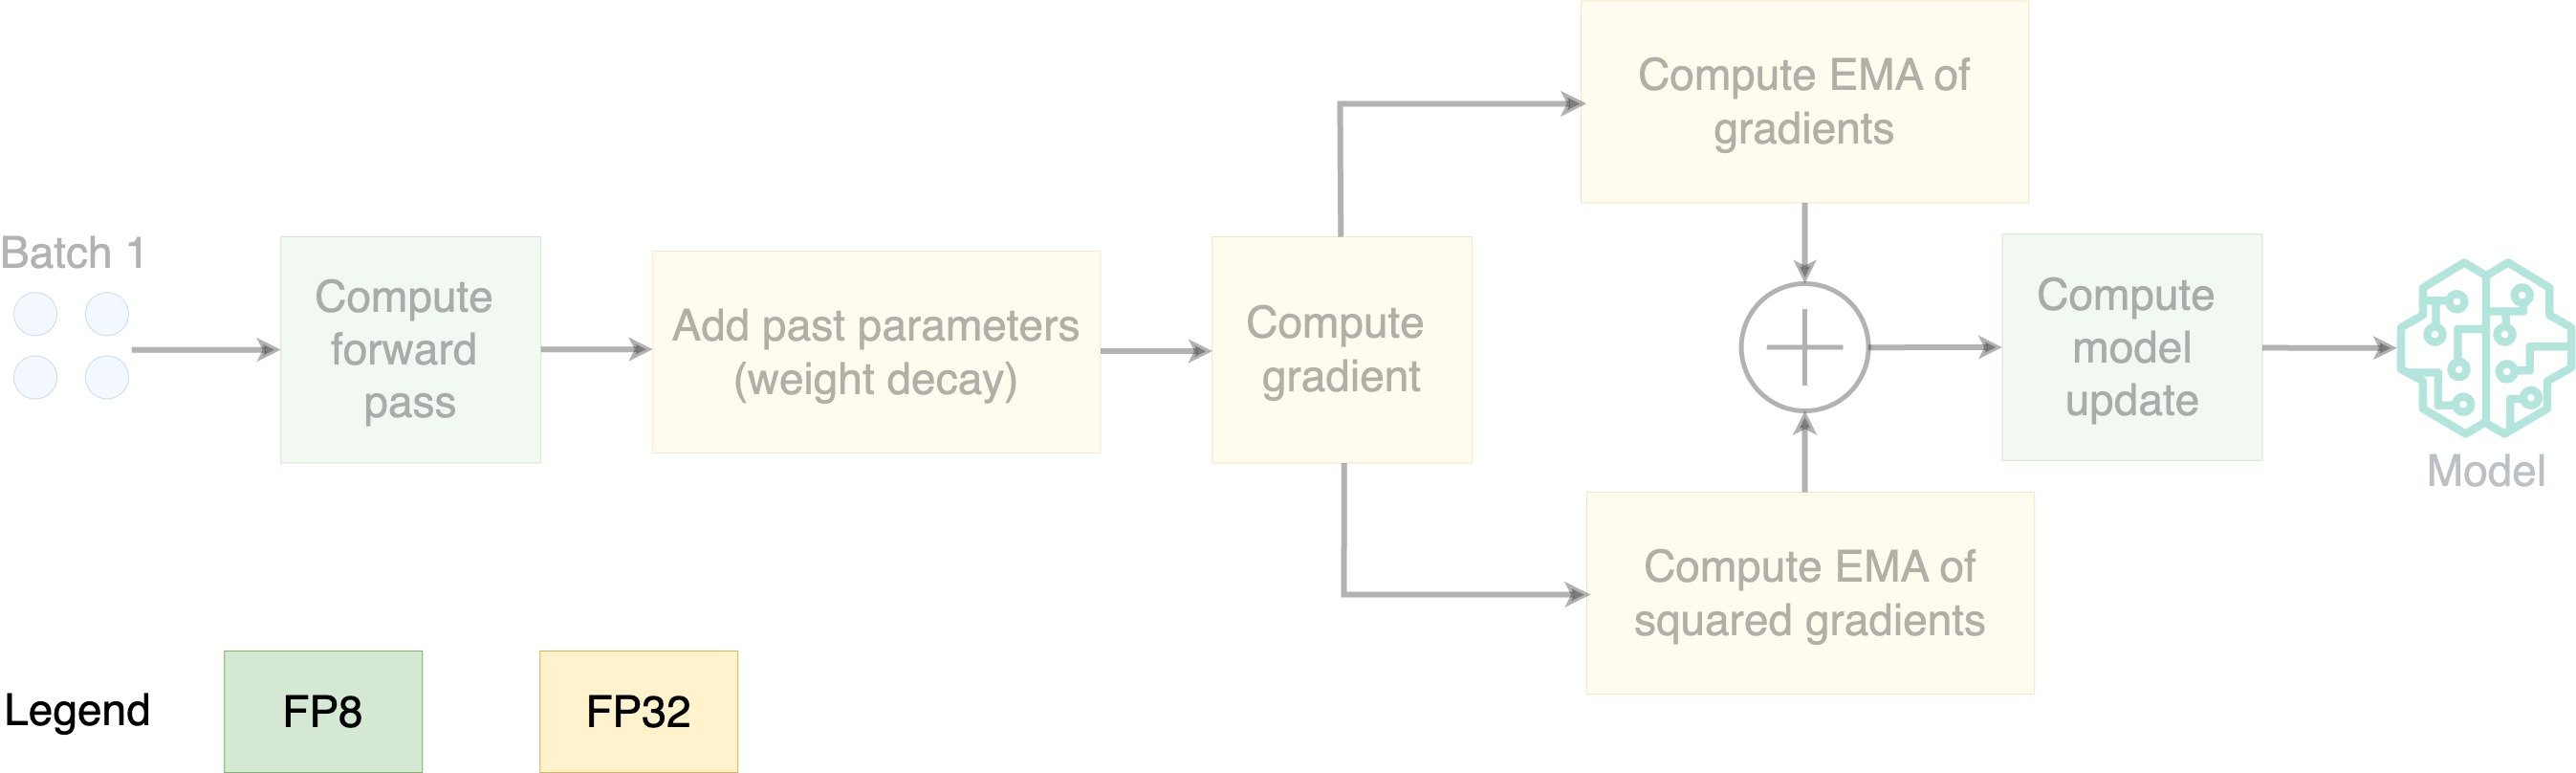
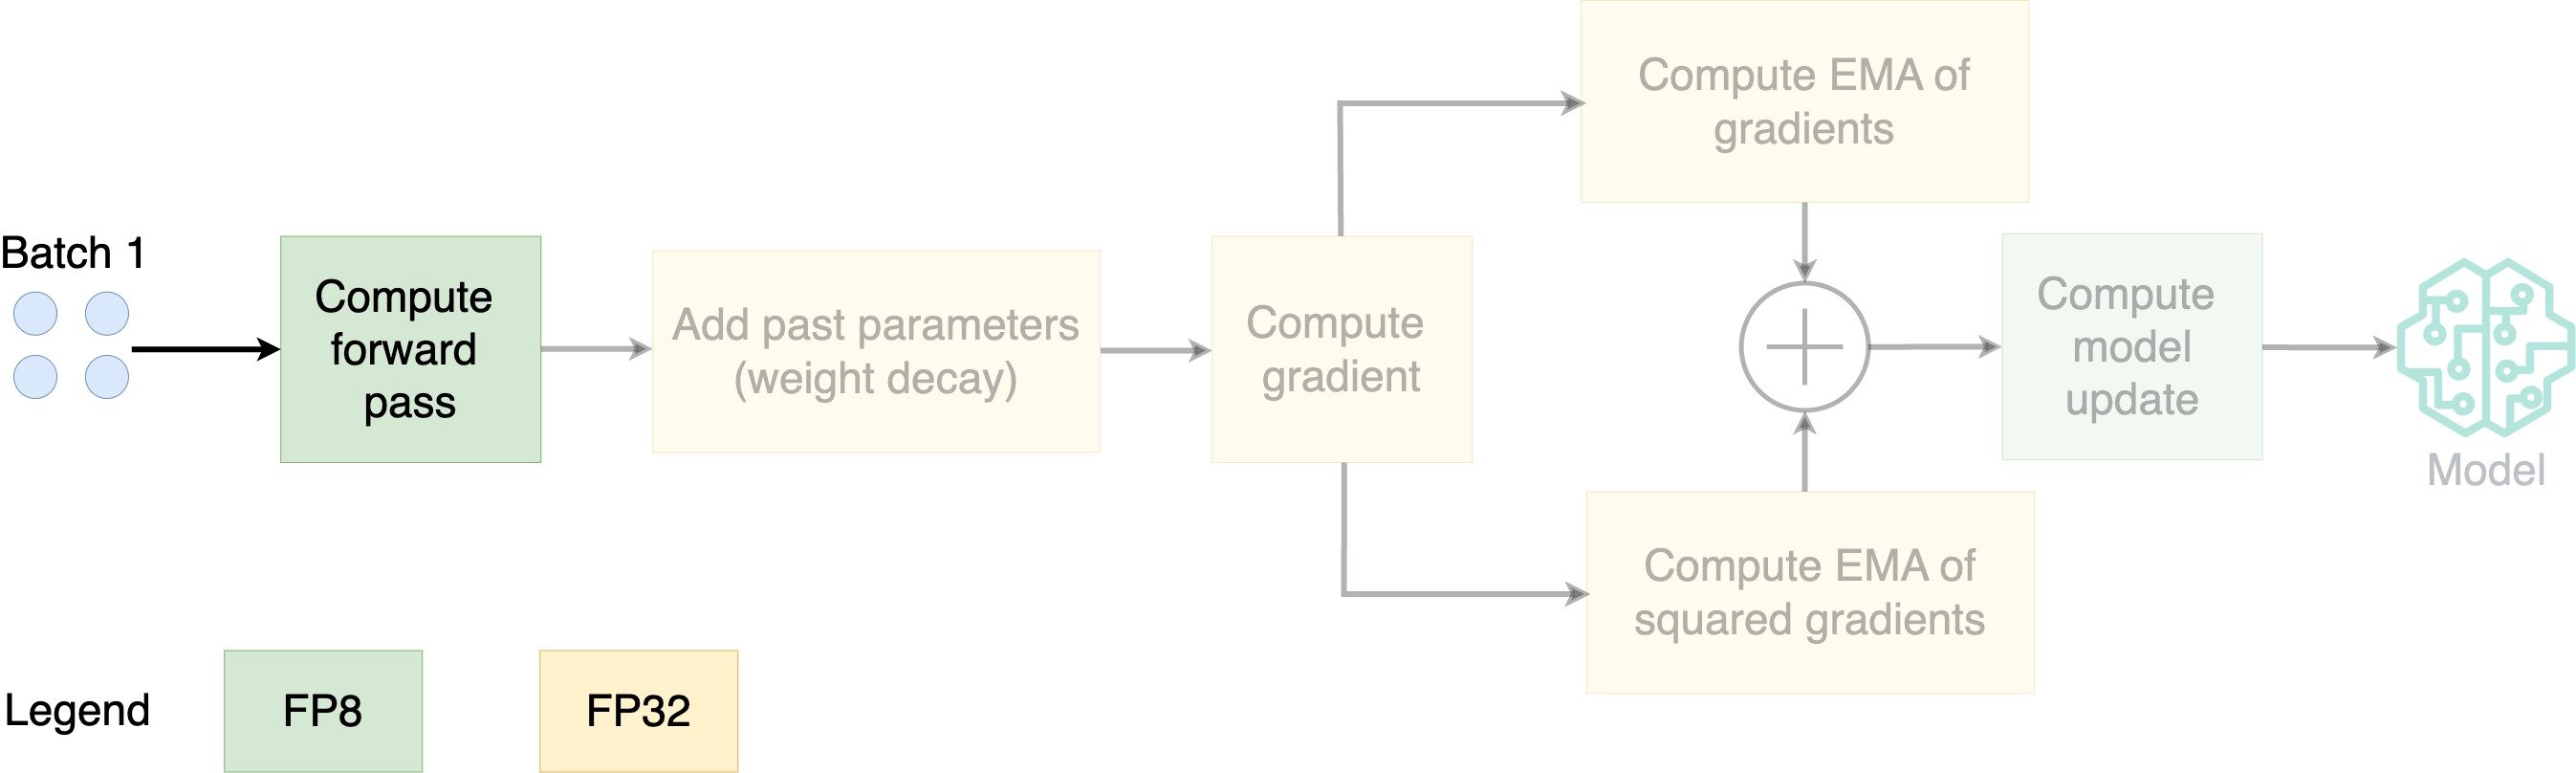
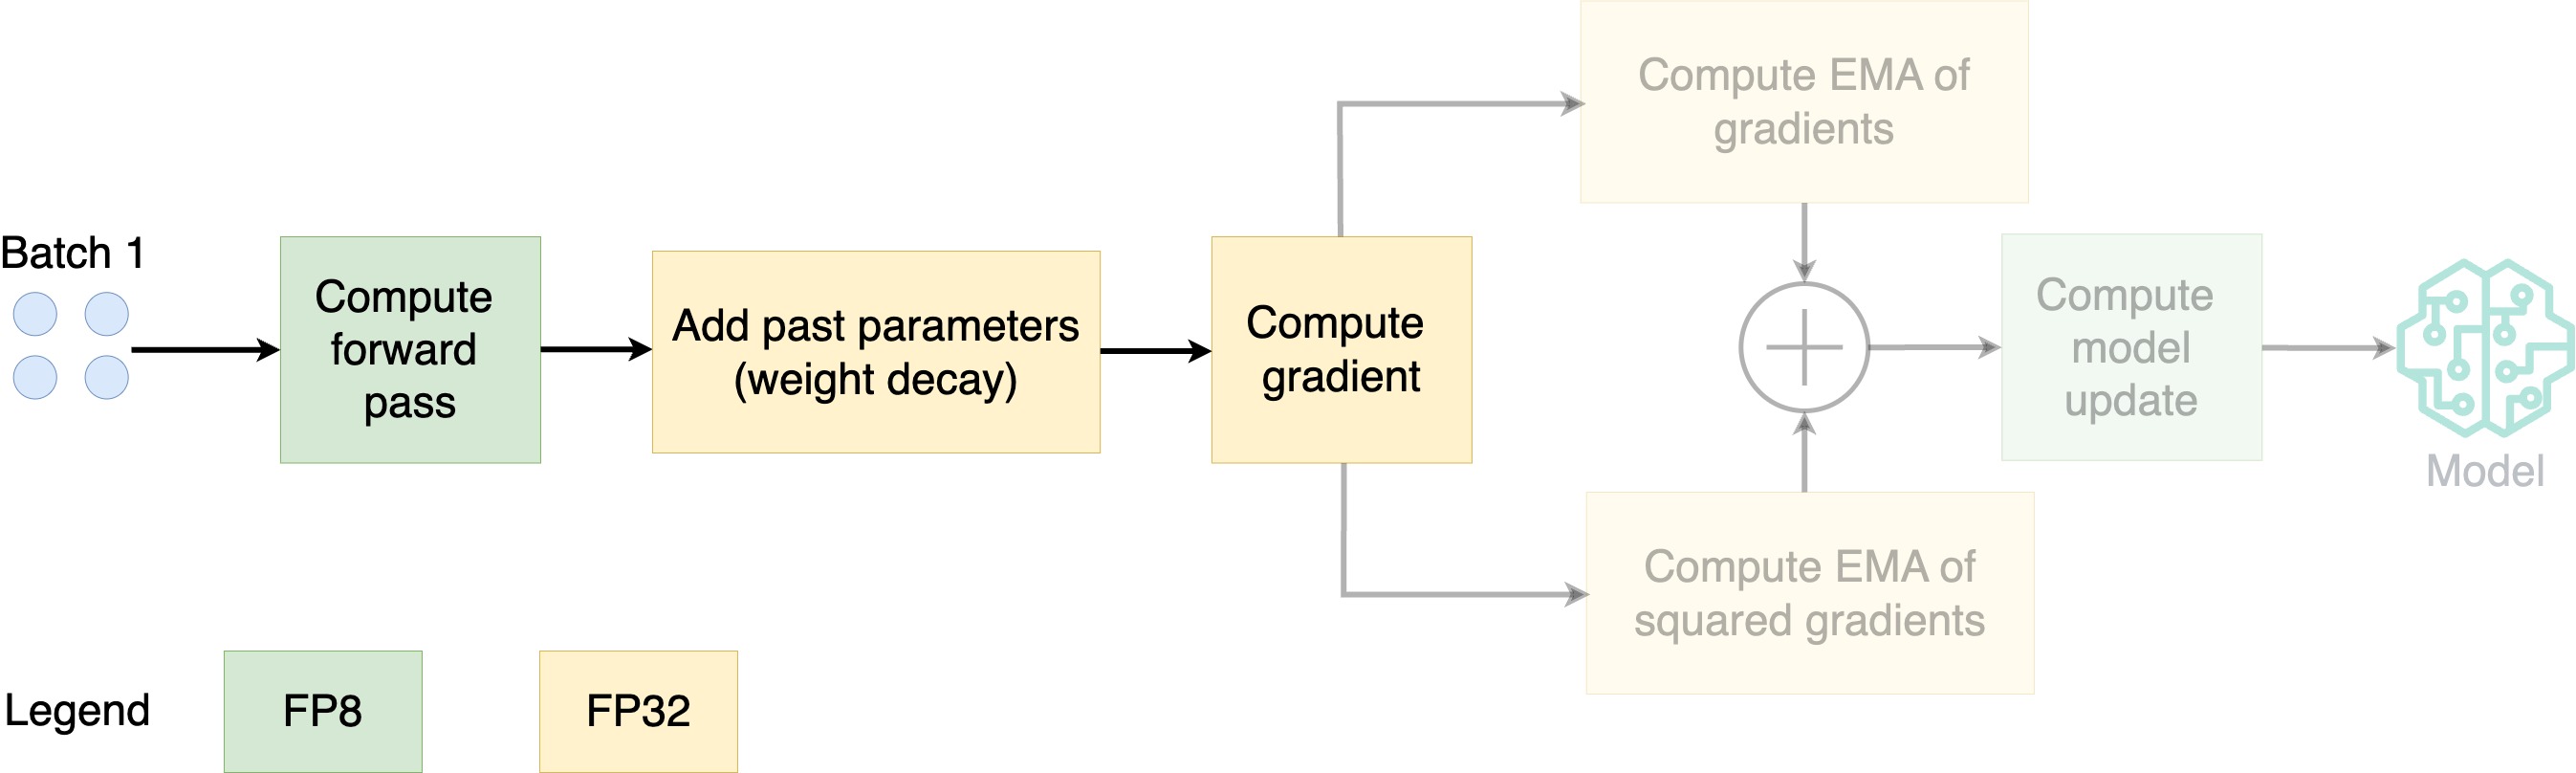
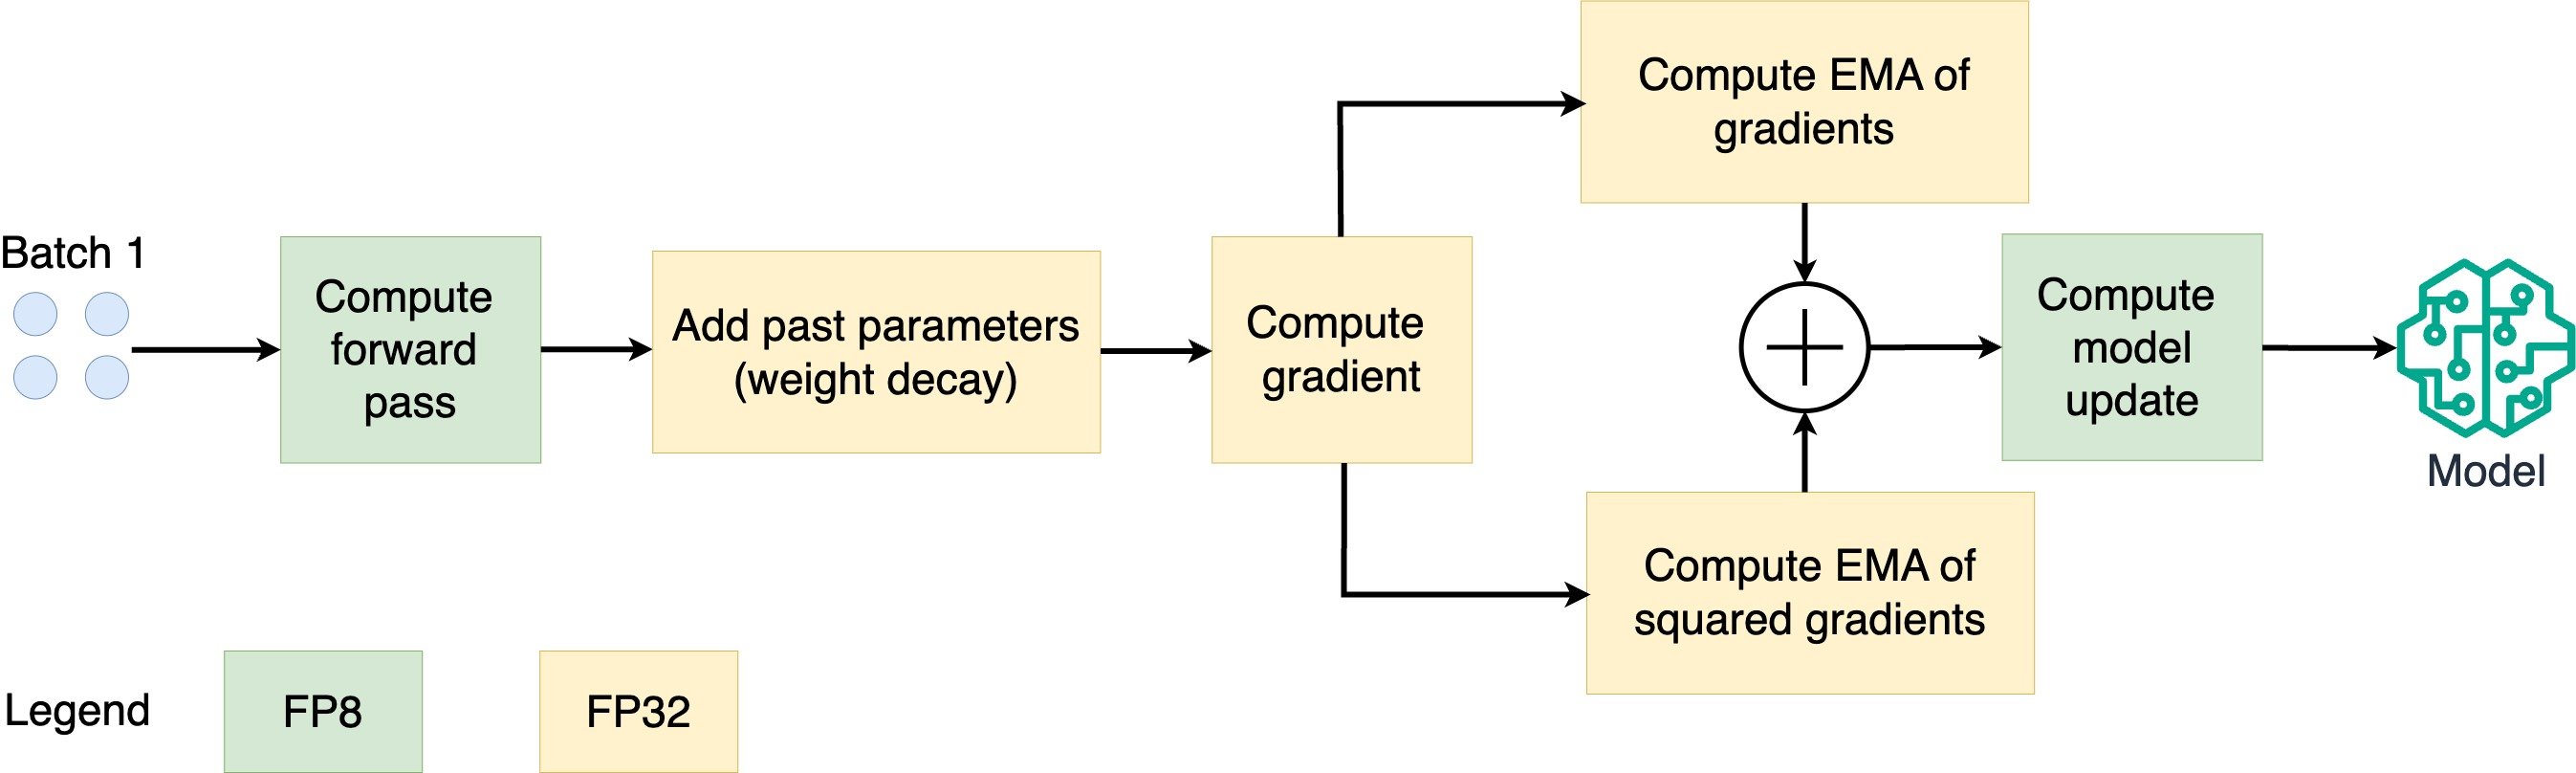
Як працює 8-бітний Adam?

Схема, що показує кроки 8-бітного Adam.

  • Зберігайте параметри у FP8; оптимізуйте у FP32
Ефективне тренування моделей ШІ з PyTorch

Як працює 8-бітний Adam?

Схема, що показує кроки 8-бітного Adam.

  • Зберігайте параметри у FP8; оптимізуйте у FP32
Ефективне тренування моделей ШІ з PyTorch

Як працює 8-бітний Adam?

Схема, що показує кроки 8-бітного Adam.

  • Зберігайте параметри у FP8; оптимізуйте у FP32
Ефективне тренування моделей ШІ з PyTorch

Як працює 8-бітний Adam?

Схема, що показує кроки 8-бітного Adam.

  • Зберігайте параметри у FP8; оптимізуйте у FP32
  • EMA: експоненційне ковзне середнє
  • Обчисліть EMA градієнтів і квадратичних градієнтів
Ефективне тренування моделей ШІ з PyTorch

Як працює 8-бітний Adam?

Схема, що показує кроки 8-бітного Adam.

  • Зберігайте параметри у FP8; оптимізуйте у FP32
  • EMA: експоненційне ковзне середнє
  • Обчисліть EMA градієнтів і квадратичних градієнтів
Ефективне тренування моделей ШІ з PyTorch

Як 8-бітний Adam економить пам’ять?

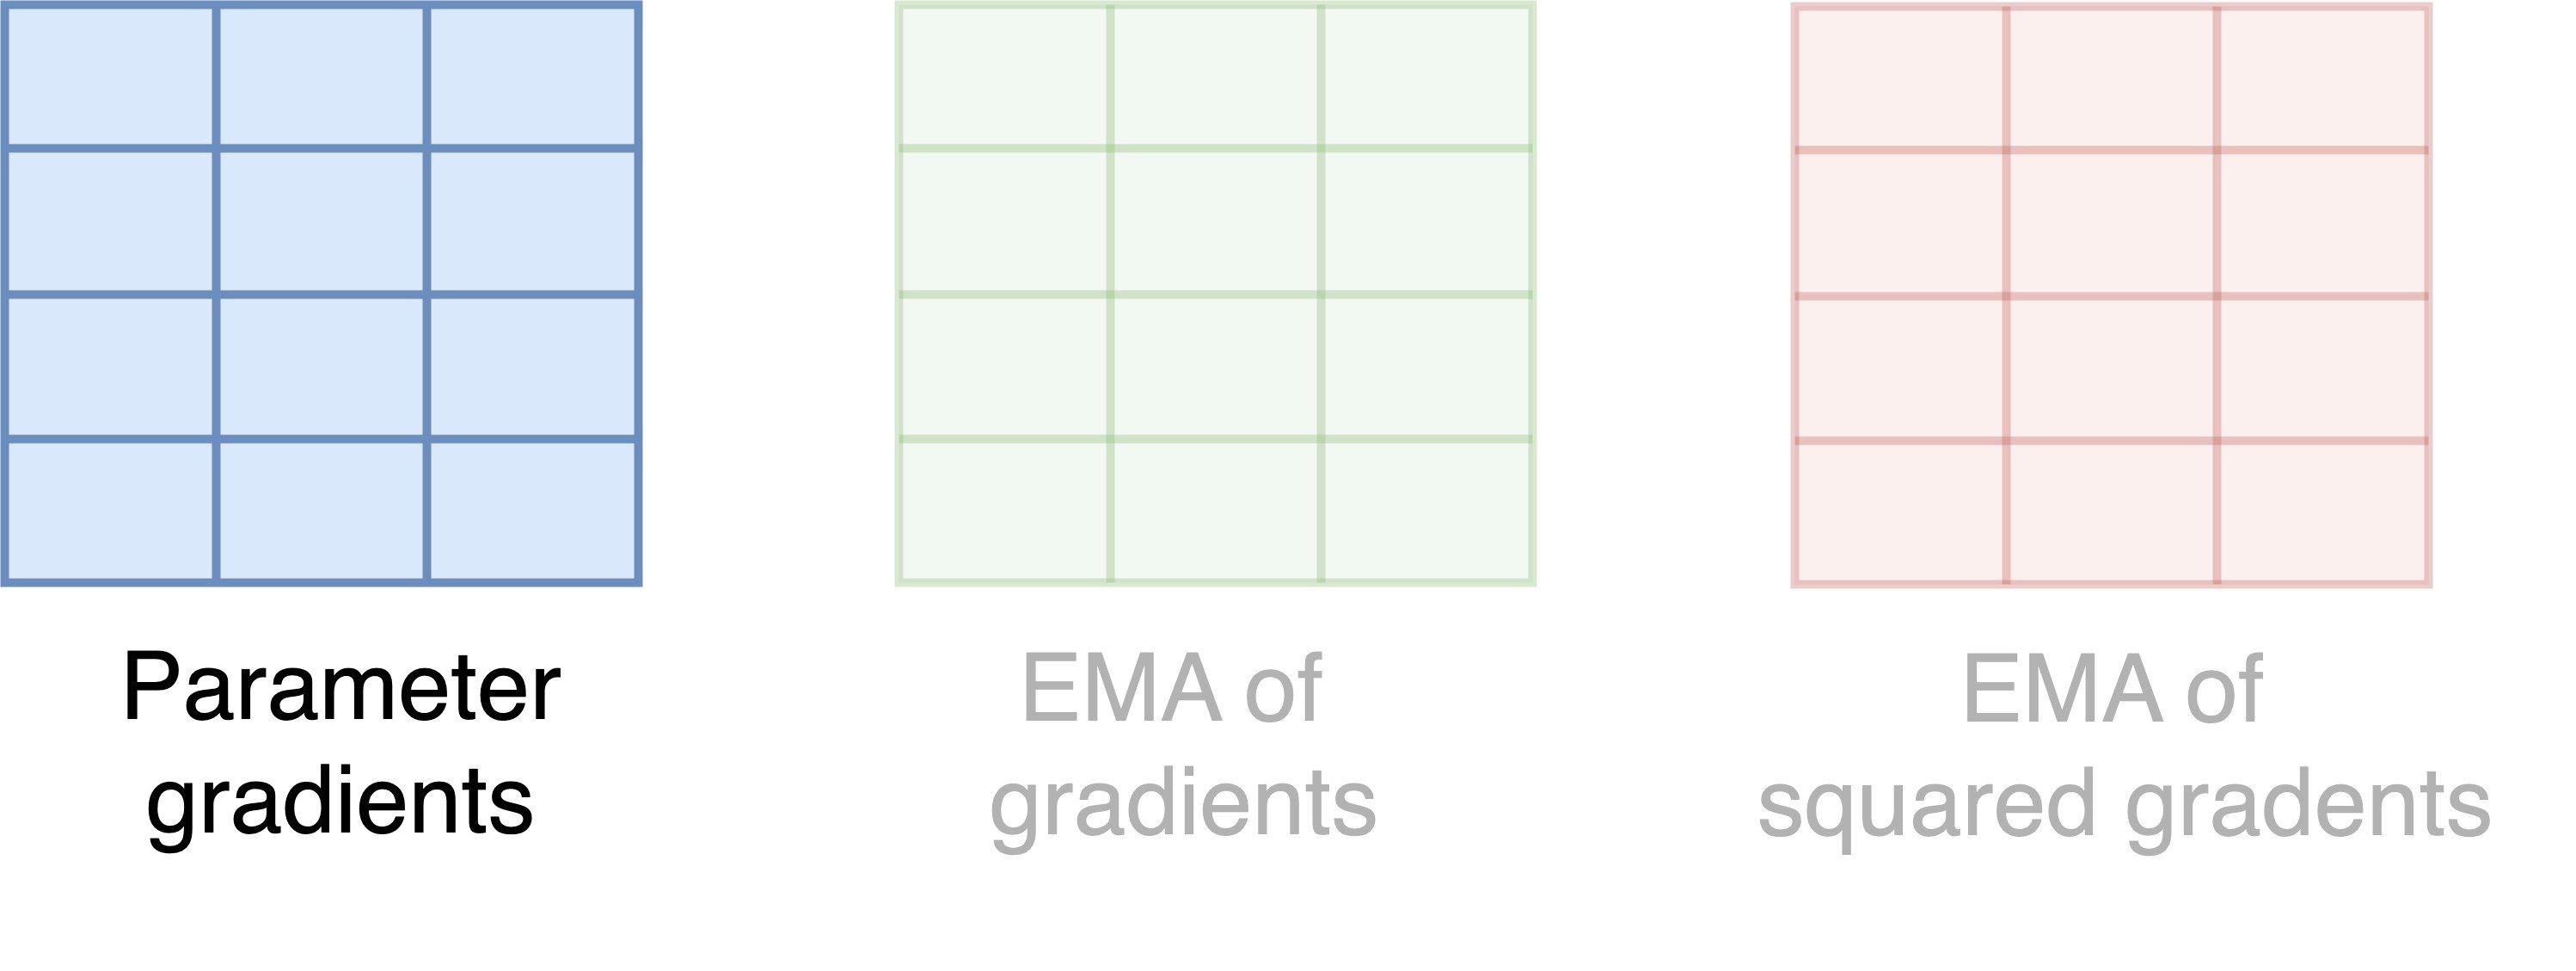
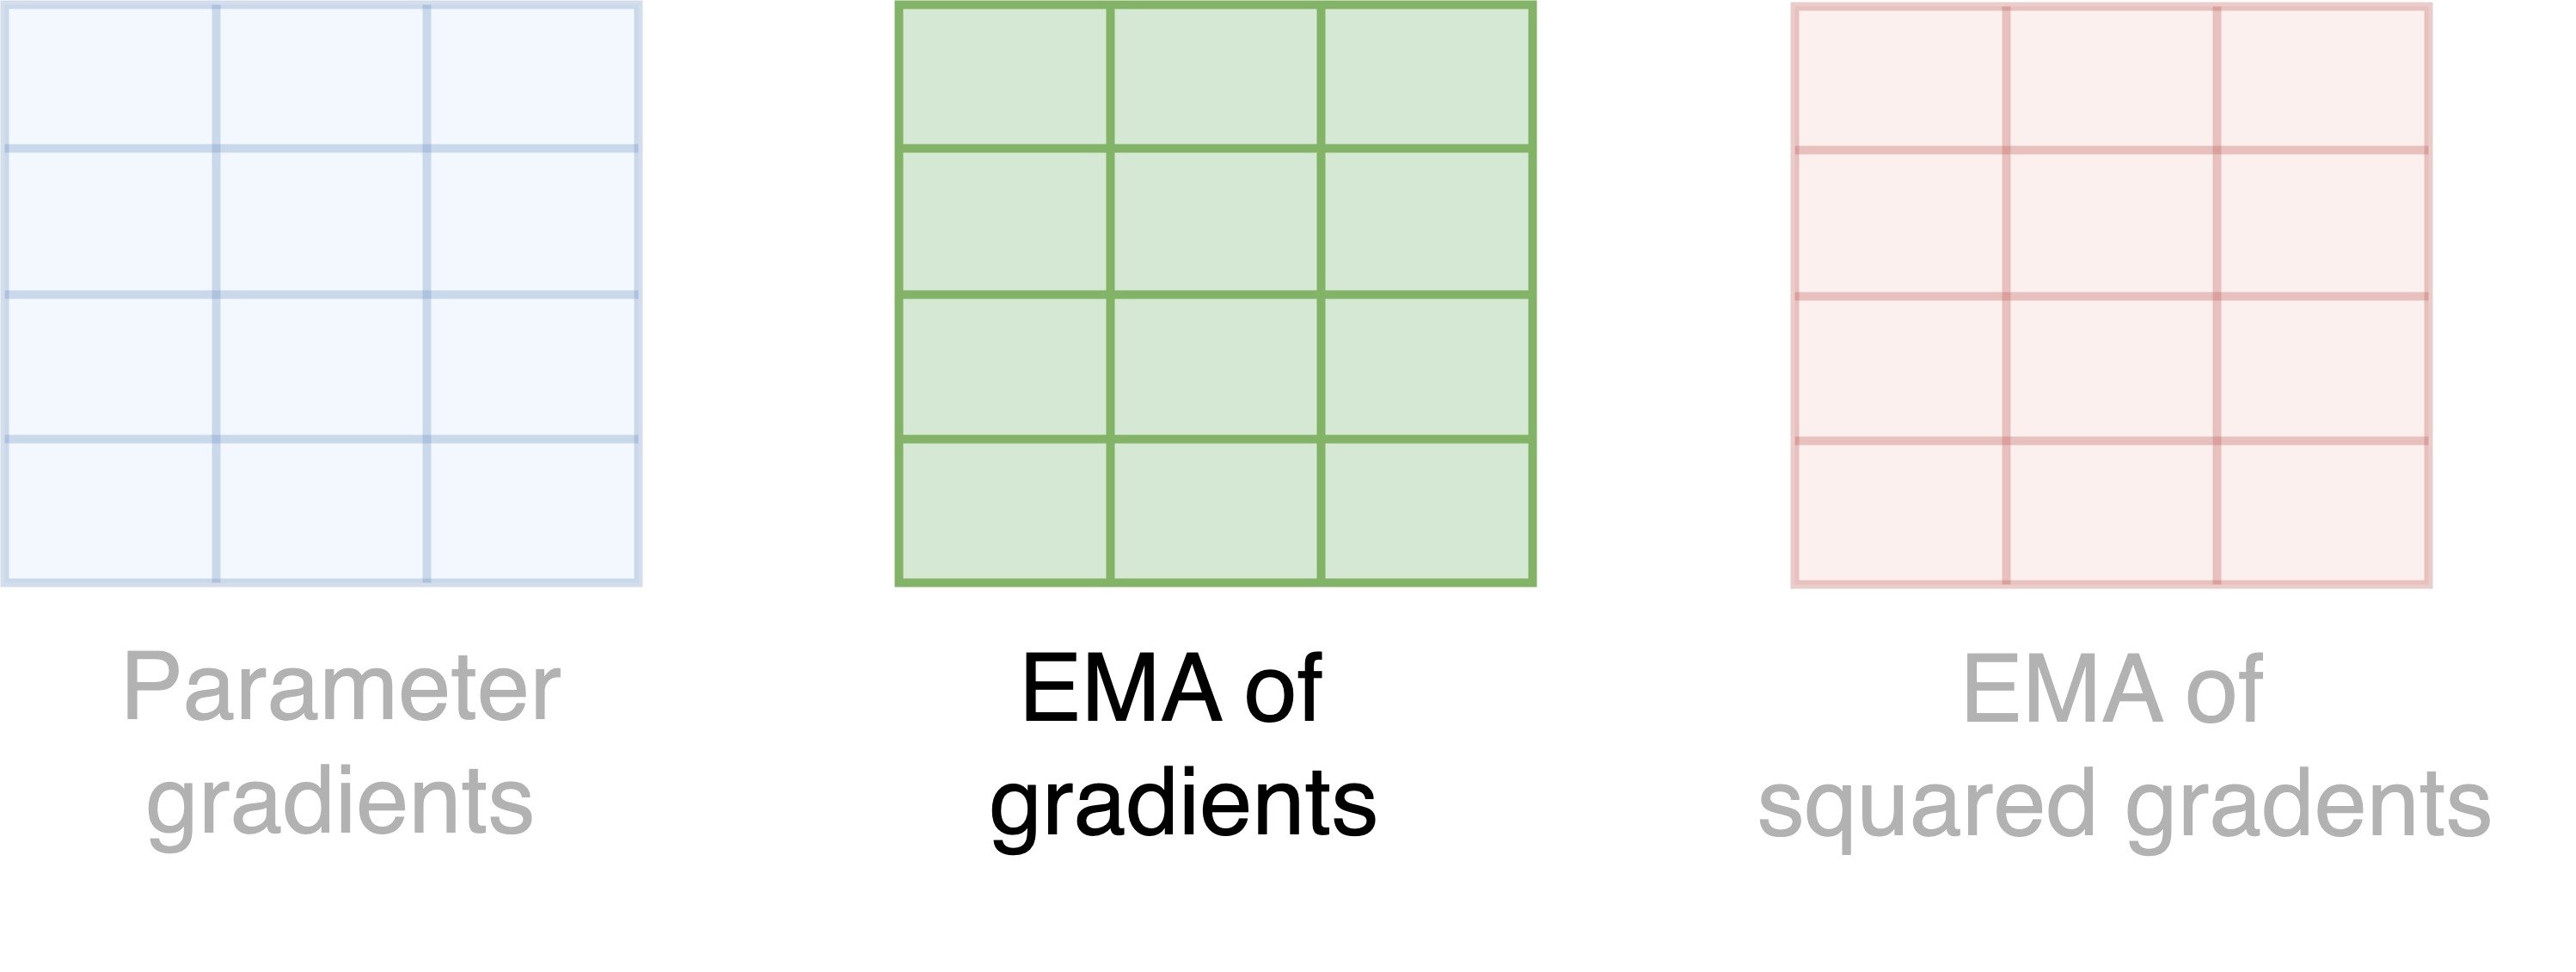
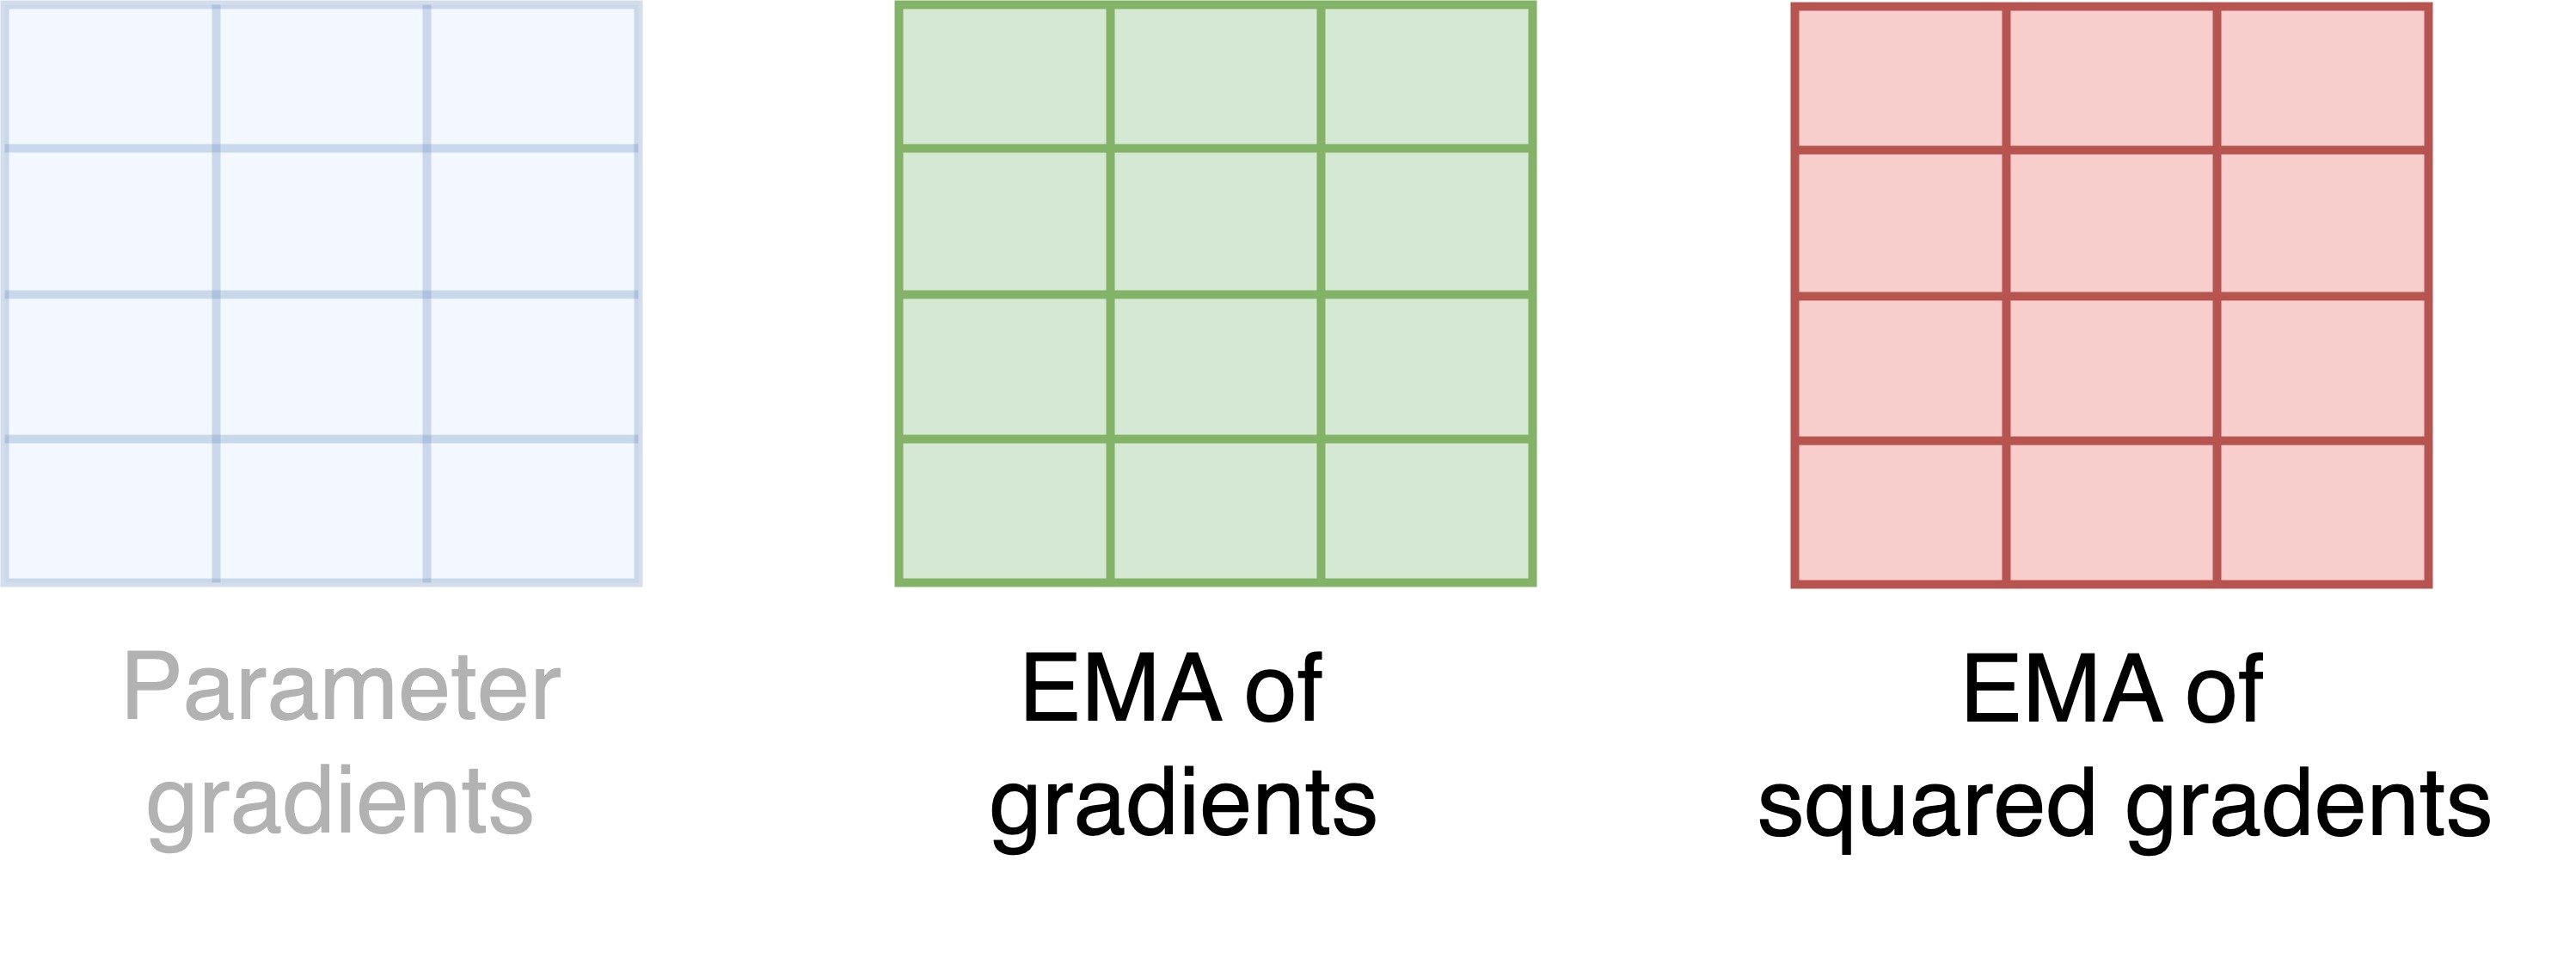
Схема, що зображує градієнти параметрів, EMA градієнтів і EMA квадратів градієнтів.

Ефективне тренування моделей ШІ з PyTorch

Як 8-бітний Adam економить пам’ять?

Схема, що зображує градієнти параметрів, EMA градієнтів і EMA квадратів градієнтів.

Ефективне тренування моделей ШІ з PyTorch

Як 8-бітний Adam економить пам’ять?

Схема, що зображує градієнти параметрів, EMA градієнтів і EMA квадратів градієнтів.

  • Кожен квадрат — це параметр, кожен колір — стан
  • Пам’ять на параметр = 2 байти = 1 байт на стан * 2 стани
  • Загальна пам’ять = Пам’ять на параметр (2 байти) * Кількість параметрів
Ефективне тренування моделей ШІ з PyTorch

Оцінка використання пам’яті 8-бітним Adam

model = AutoModelForSequenceClassification.from_pretrained(
    "distilbert-base-cased", return_dict=True)
num_parameters = sum(p.numel() for p in model.parameters())
print(f"Number of model parameters: {num_parameters:,}")
Number of model parameters: 65,783,042
estimated_memory = num_parameters * 2 / (1024 ** 2)
print(f"Estimated memory usage of 8-bit Adam: {estimated_memory:.0f} MB")
Estimated memory usage of 8-bit Adam: 125 MB
Ефективне тренування моделей ШІ з PyTorch

Налаштування оптимізатора 8-бітного Adam

import bitsandbytes as bnb
from torch import nn
from transformers.trainer_pt_utils import get_parameter_names


args = TrainingArguments(output_dir="./results")
decay_parameters = get_parameter_names(model, [nn.LayerNorm])
decay_parameters = [name for name in decay_parameters if "bias" not in name]
  • Weight decay запобігає перенавчанню
  • decay_parameters: параметри для застосування weight decay
  • get_parameter_names: повертає імена параметрів; ігнорує шари nn.LayerNorm
  • Приберіть параметри bias з decay_parameters
  • Не застосовуйте weight decay до нормалізаційних шарів і зсувів (bias)
Ефективне тренування моделей ШІ з PyTorch

Налаштування оптимізатора 8-бітного Adam

optimizer_grouped_parameters = [{"params": [p for n, p in model.named_parameters() 
                                            if n in decay_parameters],
                                 "weight_decay": args.weight_decay},

{"params": [p for n, p in model.named_parameters() if n not in decay_parameters], "weight_decay": 0.0}]
adam_bnb_optim = bnb.optim.Adam8bit(optimizer_grouped_parameters,
betas=(args.adam_beta1, args.adam_beta2),
eps=args.adam_epsilon,
lr=args.learning_rate)
  • optimizer_grouped_parameters: Одна група з weight decay; інша без нього
  • beta1, beta2: швидкості згасання 1-го й 2-го моментів; більше = стабільніше, повільніше навчання
Ефективне тренування моделей ШІ з PyTorch

Реалізація 8-бітного Adam у Trainer

trainer = Trainer(model=model,
                  args=training_args,
                  train_dataset=train_dataset,
                  eval_dataset=validation_dataset,
                  optimizers=(adam_bnb_optim, None),
                  compute_metrics=compute_metrics)

trainer.train()
{'epoch': 1.0, 'eval_loss': 0.63, 'eval_accuracy': 0.67, 'eval_f1': 0.62}
{'epoch': 2.0, 'eval_loss': 0.61, 'eval_accuracy': 0.71, 'eval_f1': 0.66}
Ефективне тренування моделей ШІ з PyTorch

Реалізація 8-бітного Adam з Accelerator

model, adam_bnb_optim, train_dataloader, lr_scheduler = \
    accelerator.prepare(model, adam_bnb_optim, train_dataloader, lr_scheduler)


for batch in train_dataloader: inputs, targets = batch["input_ids"], batch["labels"] outputs = model(inputs, labels=targets) loss = outputs.loss accelerator.backward(loss) adam_bnb_optim.step() lr_scheduler.step() adam_bnb_optim.zero_grad() print(f"Loss = {loss}")
Loss = 0.75
Ефективне тренування моделей ШІ з PyTorch

Розрахунок використання пам’яті 8-бітним Adam

total_size_megabytes, total_num_elements = \
    compute_optimizer_size(trainer.optimizer.state.values())
print(f"Number of 8-bit Adam parameters: {total_num_elements:,}")
print(f"8-bit Adam size: {total_size_megabytes:.0f} MB")
Number of 8-bit Adam parameters: 131,566,188
8-bit Adam size: 128 MB
  • Порівняно з AdamW: 8-бітний Adam використовує 1/4 пам’яті
Number of AdamW parameters: 131,566,188
AdamW size: 502 MB
Ефективне тренування моделей ШІ з PyTorch

¡Vamos a practicar!

Ефективне тренування моделей ШІ з PyTorch

Preparing Video For Download...