Накопичення градієнтів

Ефективне тренування моделей ШІ з PyTorch

Dennis Lee

Data Engineer, Amazon

Розподілене навчання
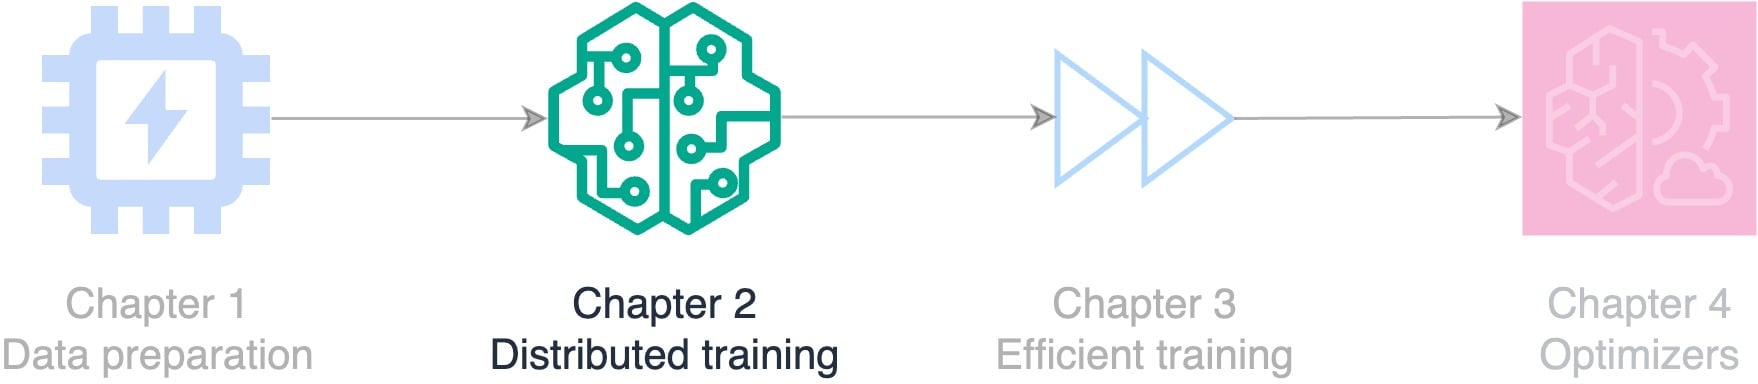


Блок-схема тем курсу: підготовка даних, розподілене навчання, ефективне навчання, оптимізатори.

Ефективне тренування моделей ШІ з PyTorch

Ефективне навчання


Блок-схема тем курсу: підготовка даних, розподілене навчання, ефективне навчання, оптимізатори.

Ефективне тренування моделей ШІ з PyTorch

Підвищення ефективності навчання


Піктограми ефективності пам’яті, комунікацій та обчислень.

Ефективне тренування моделей ШІ з PyTorch

Підвищення ефективності навчання


Піктограми ефективності пам’яті, комунікацій та обчислень.

Ефективне тренування моделей ШІ з PyTorch

Підвищення ефективності навчання


Піктограми ефективності пам’яті, комунікацій та обчислень.

Ефективне тренування моделей ШІ з PyTorch

Накопичення градієнтів підвищує ефективність пам’яті
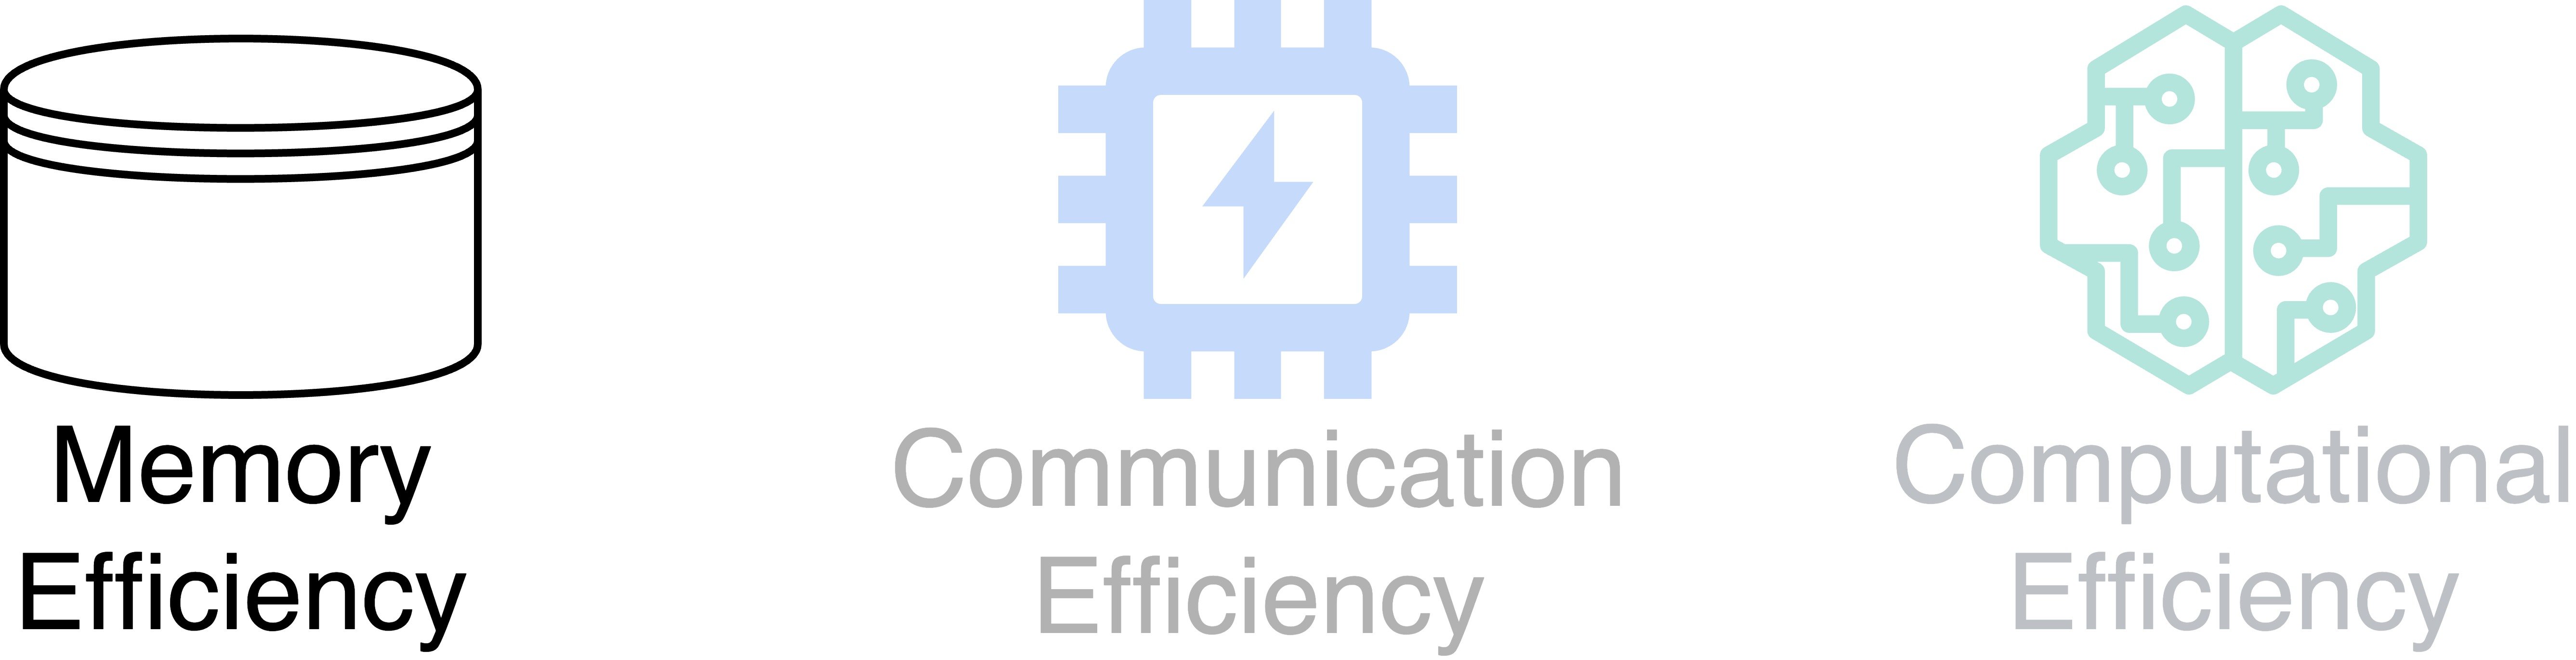


Піктограми ефективності пам’яті, комунікацій та обчислень.

Ефективне тренування моделей ШІ з PyTorch

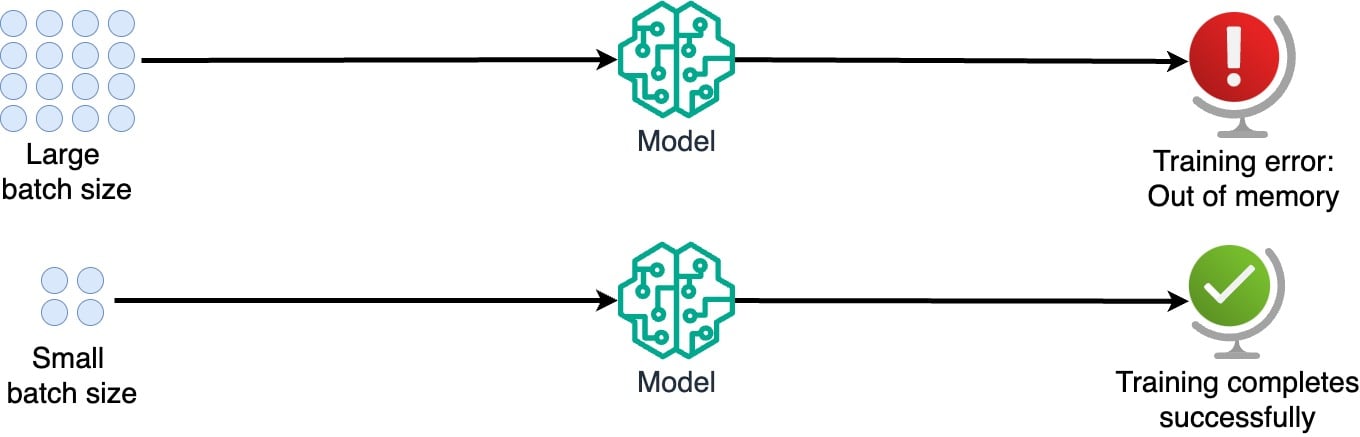
Проблема великих батчів

  • Великі батчі: надійні оцінки градієнта для швидшого навчання
  • Пам’ять GPU обмежує розмір батча


Діаграма: великі батчі викликають помилки нестачі пам’яті, малі — дозволяють успішно тренуватися.

Ефективне тренування моделей ШІ з PyTorch

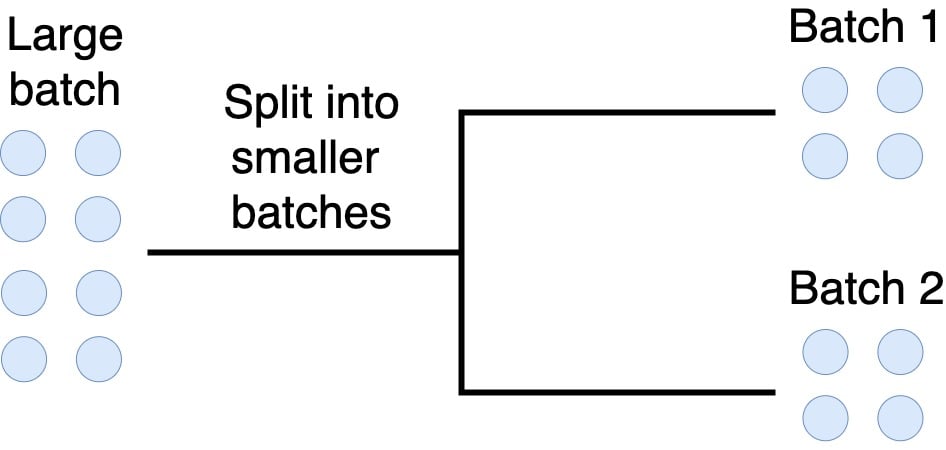
Як працює накопичення градієнтів?

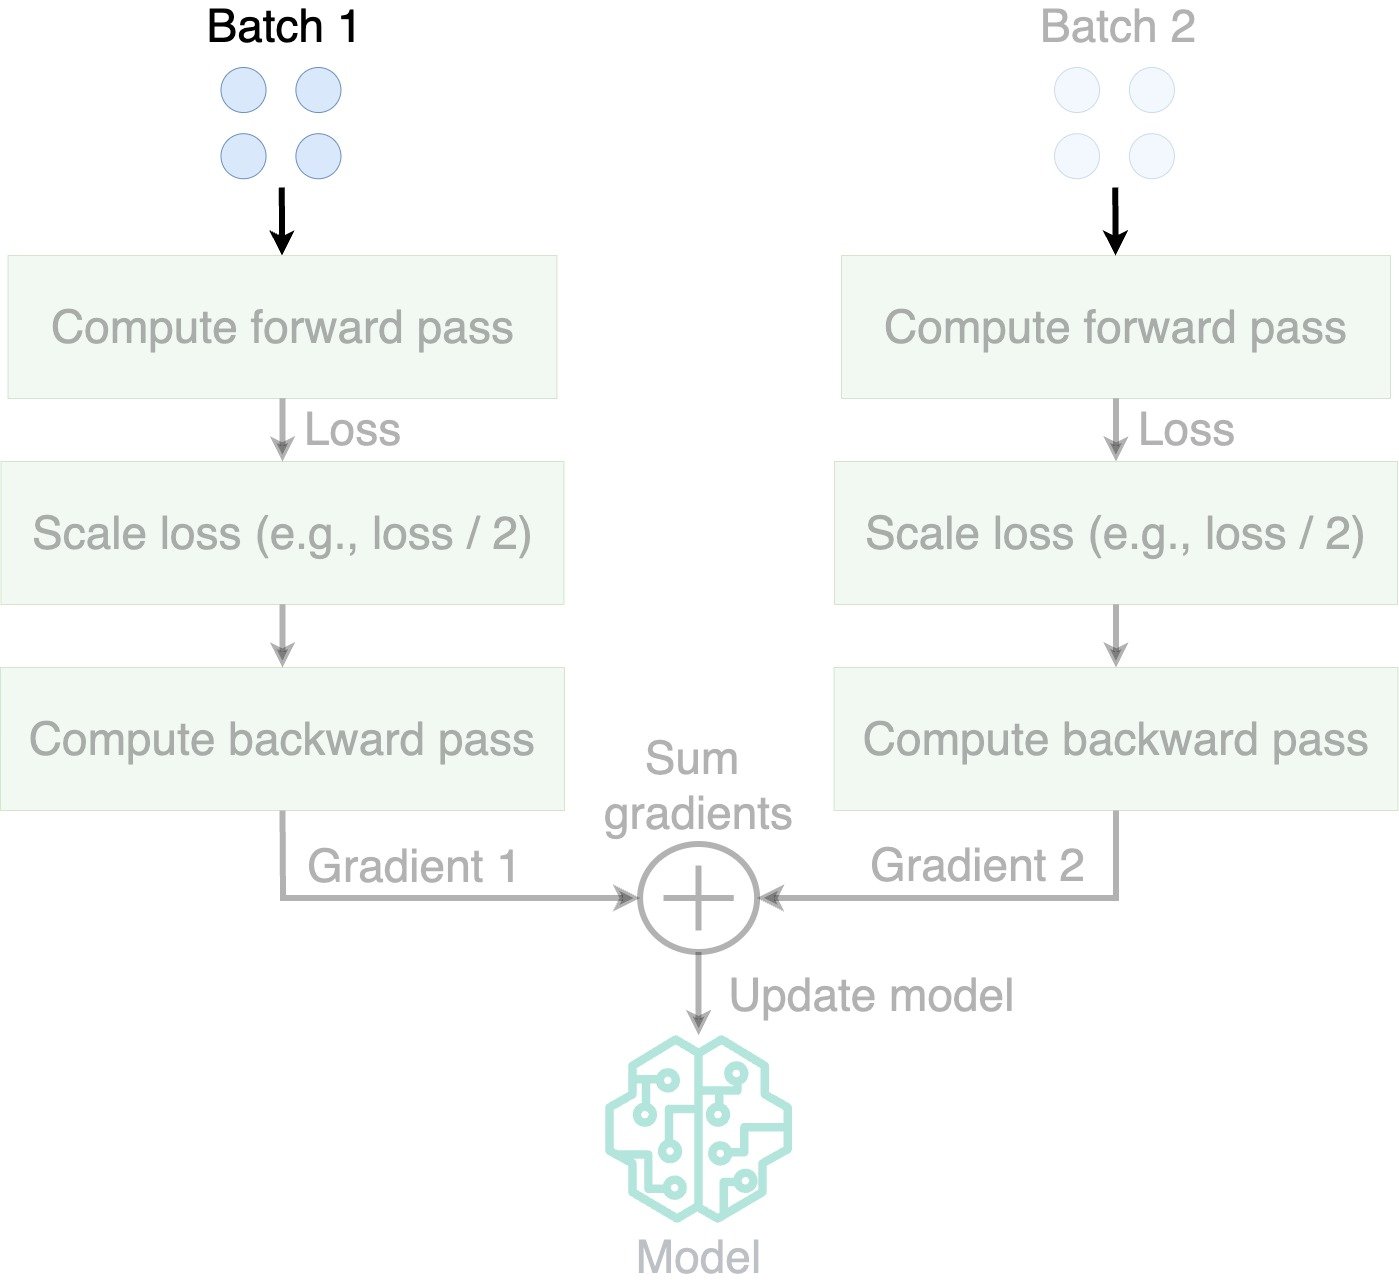
Діаграма: великий батч поділено на менші.

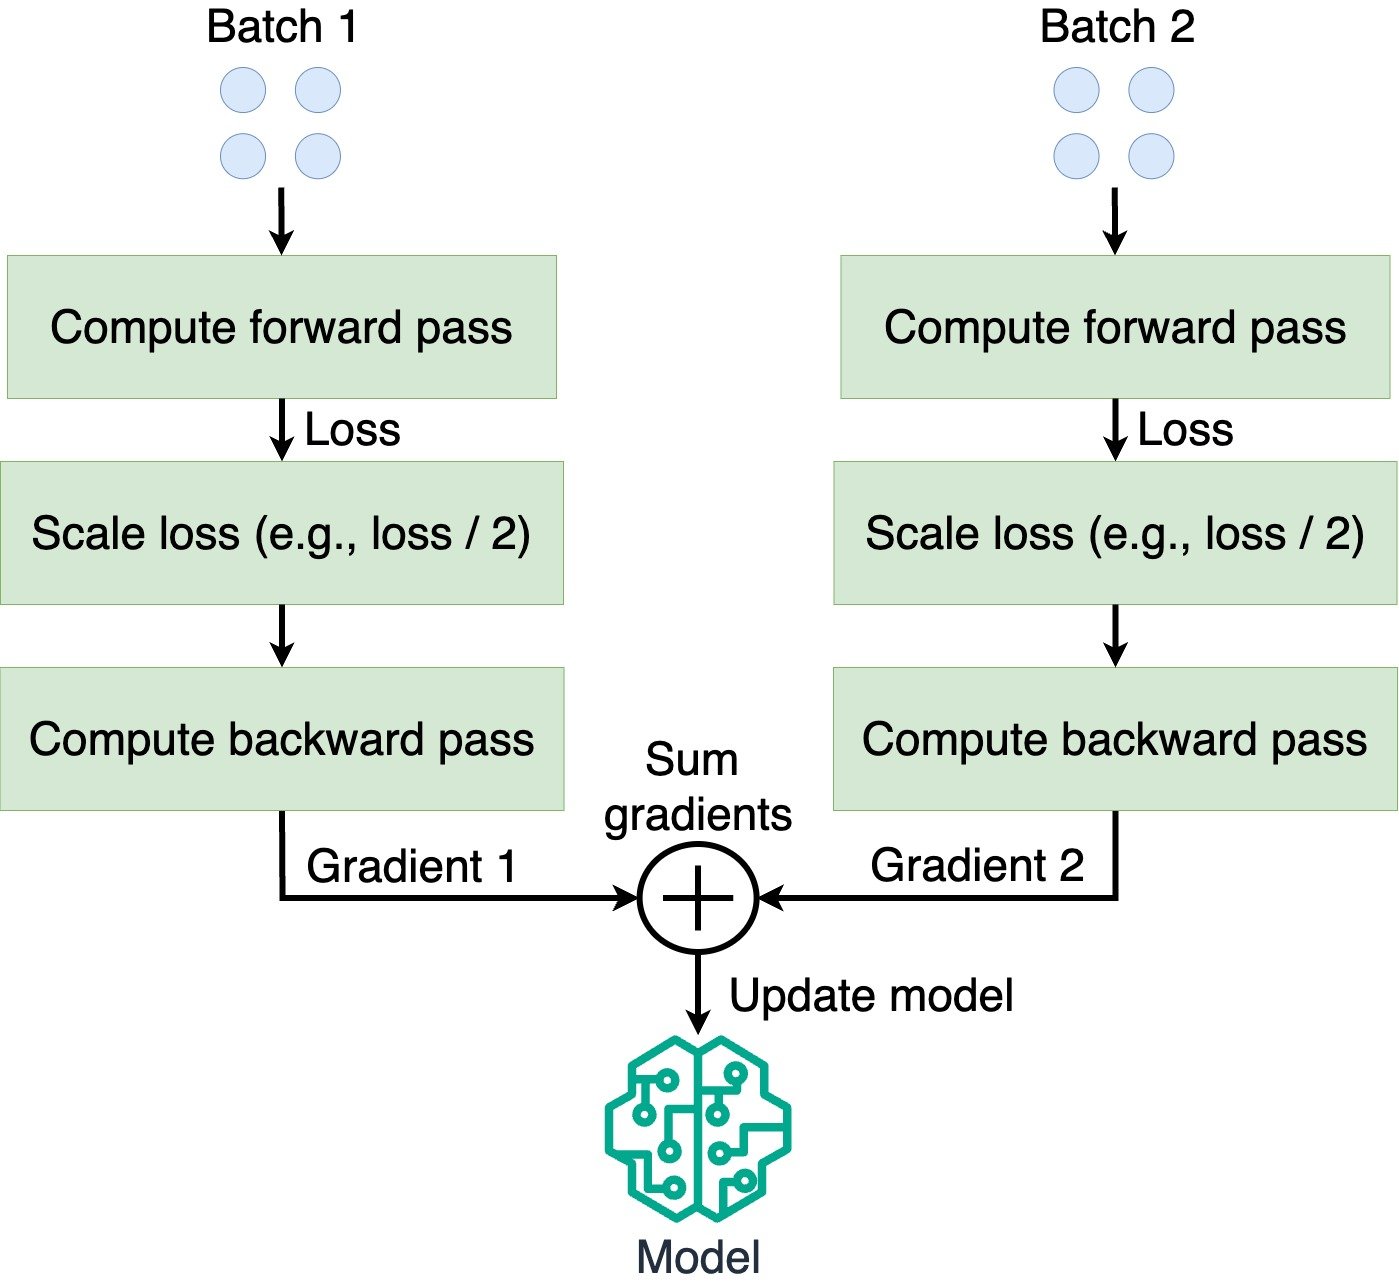
  • Накопичення градієнтів: підсумовуємо градієнти з менших батчів
  • Еквівалентно навчаємося на великому батчі
  • Оновлюємо параметри після сумування

Діаграма: накопичення градієнтів як сума градієнтів кількох батчів.

Ефективне тренування моделей ШІ з PyTorch

PyTorch, Accelerator і Trainer

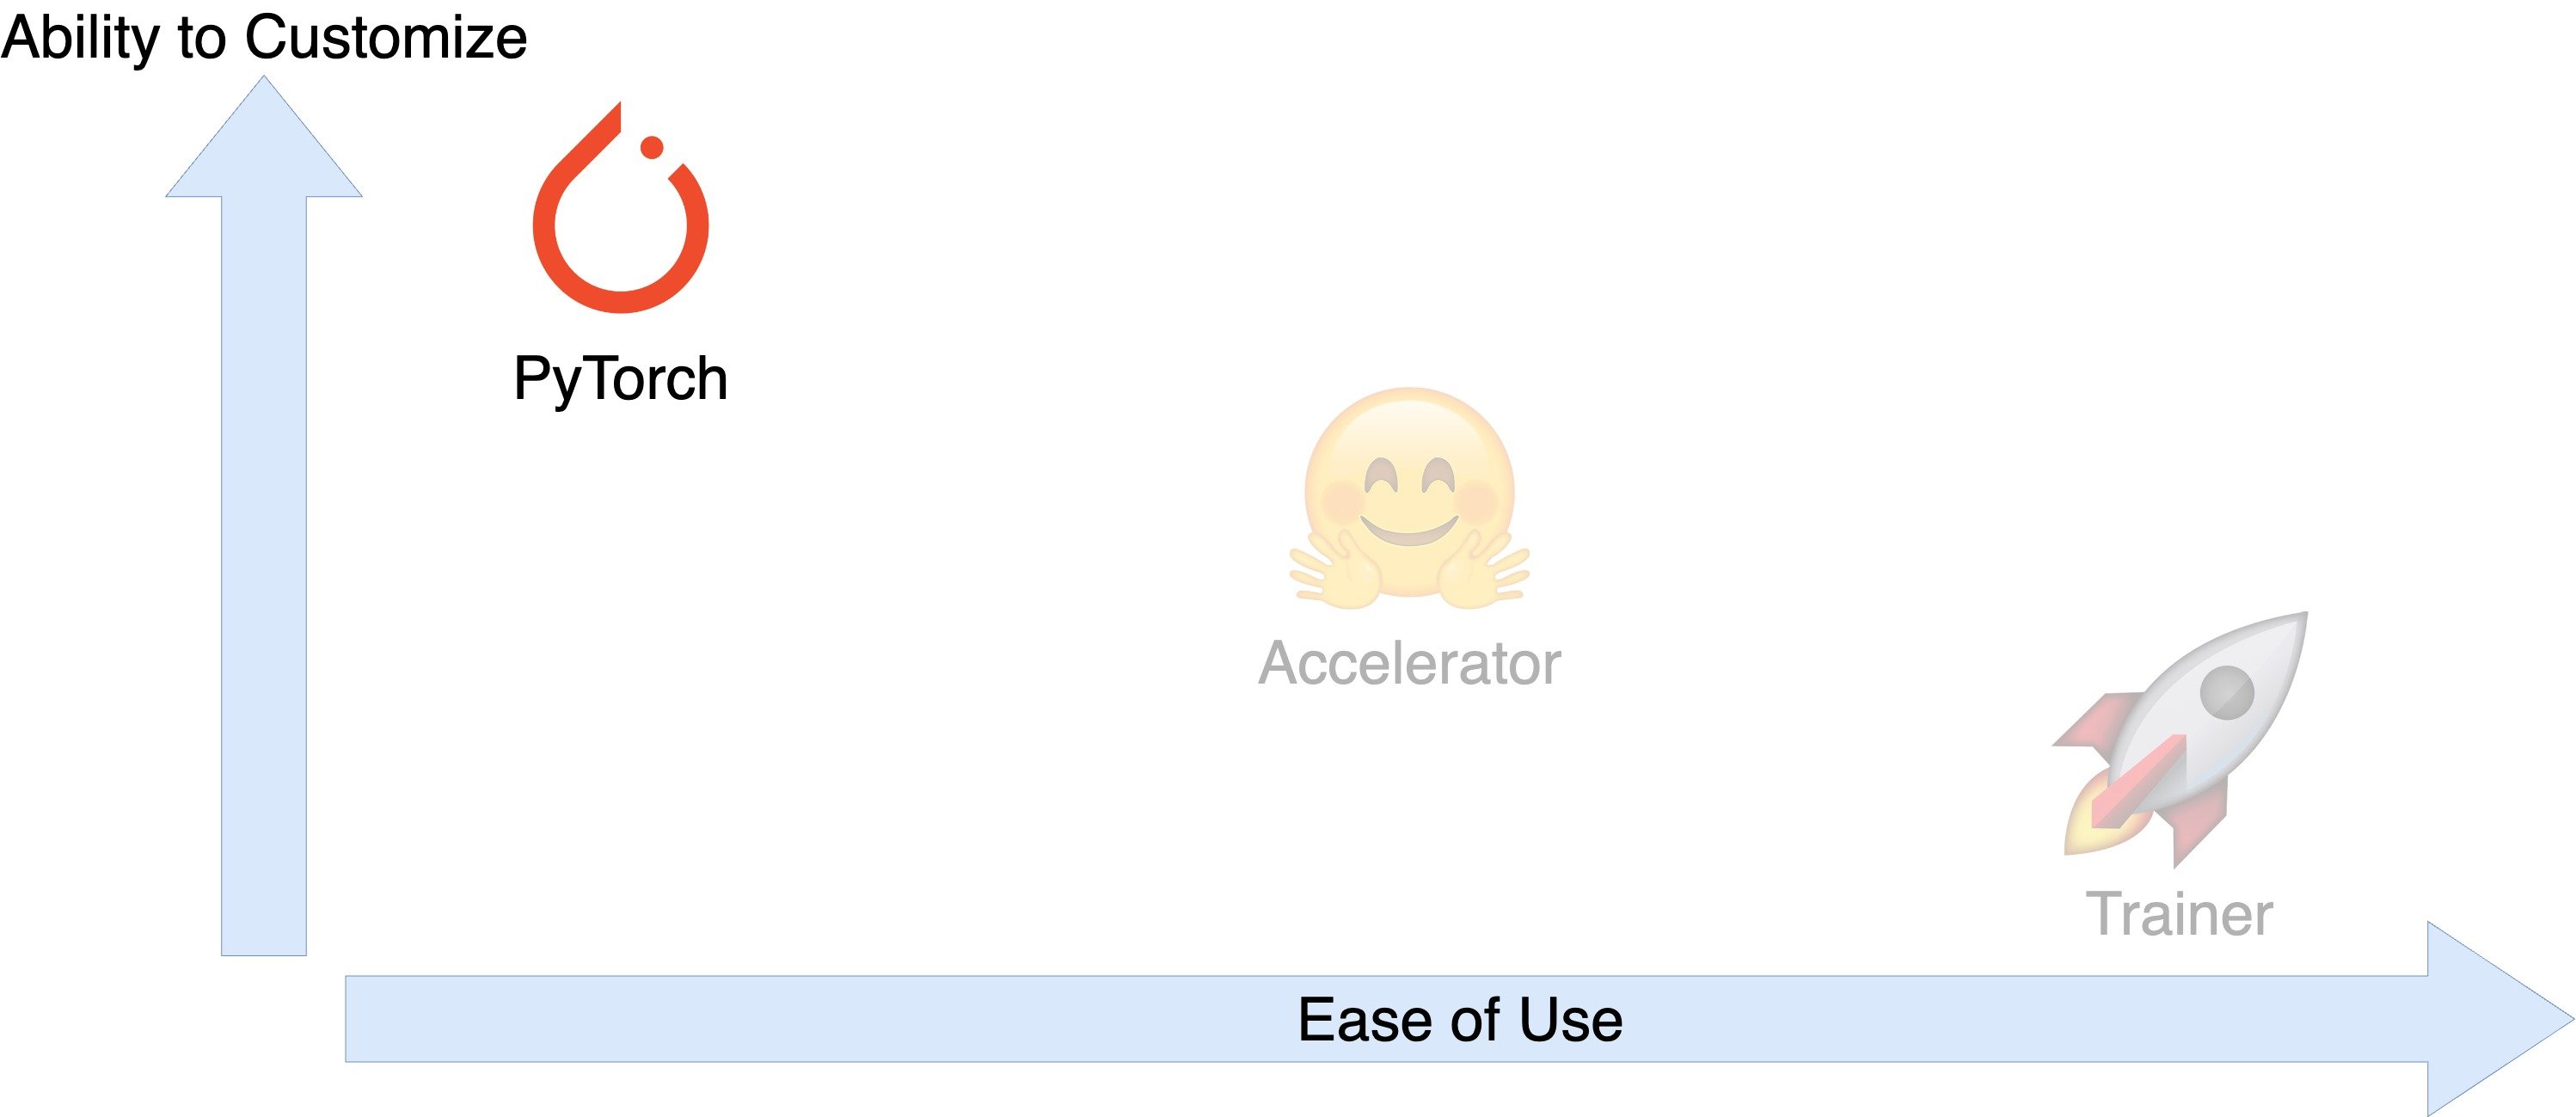
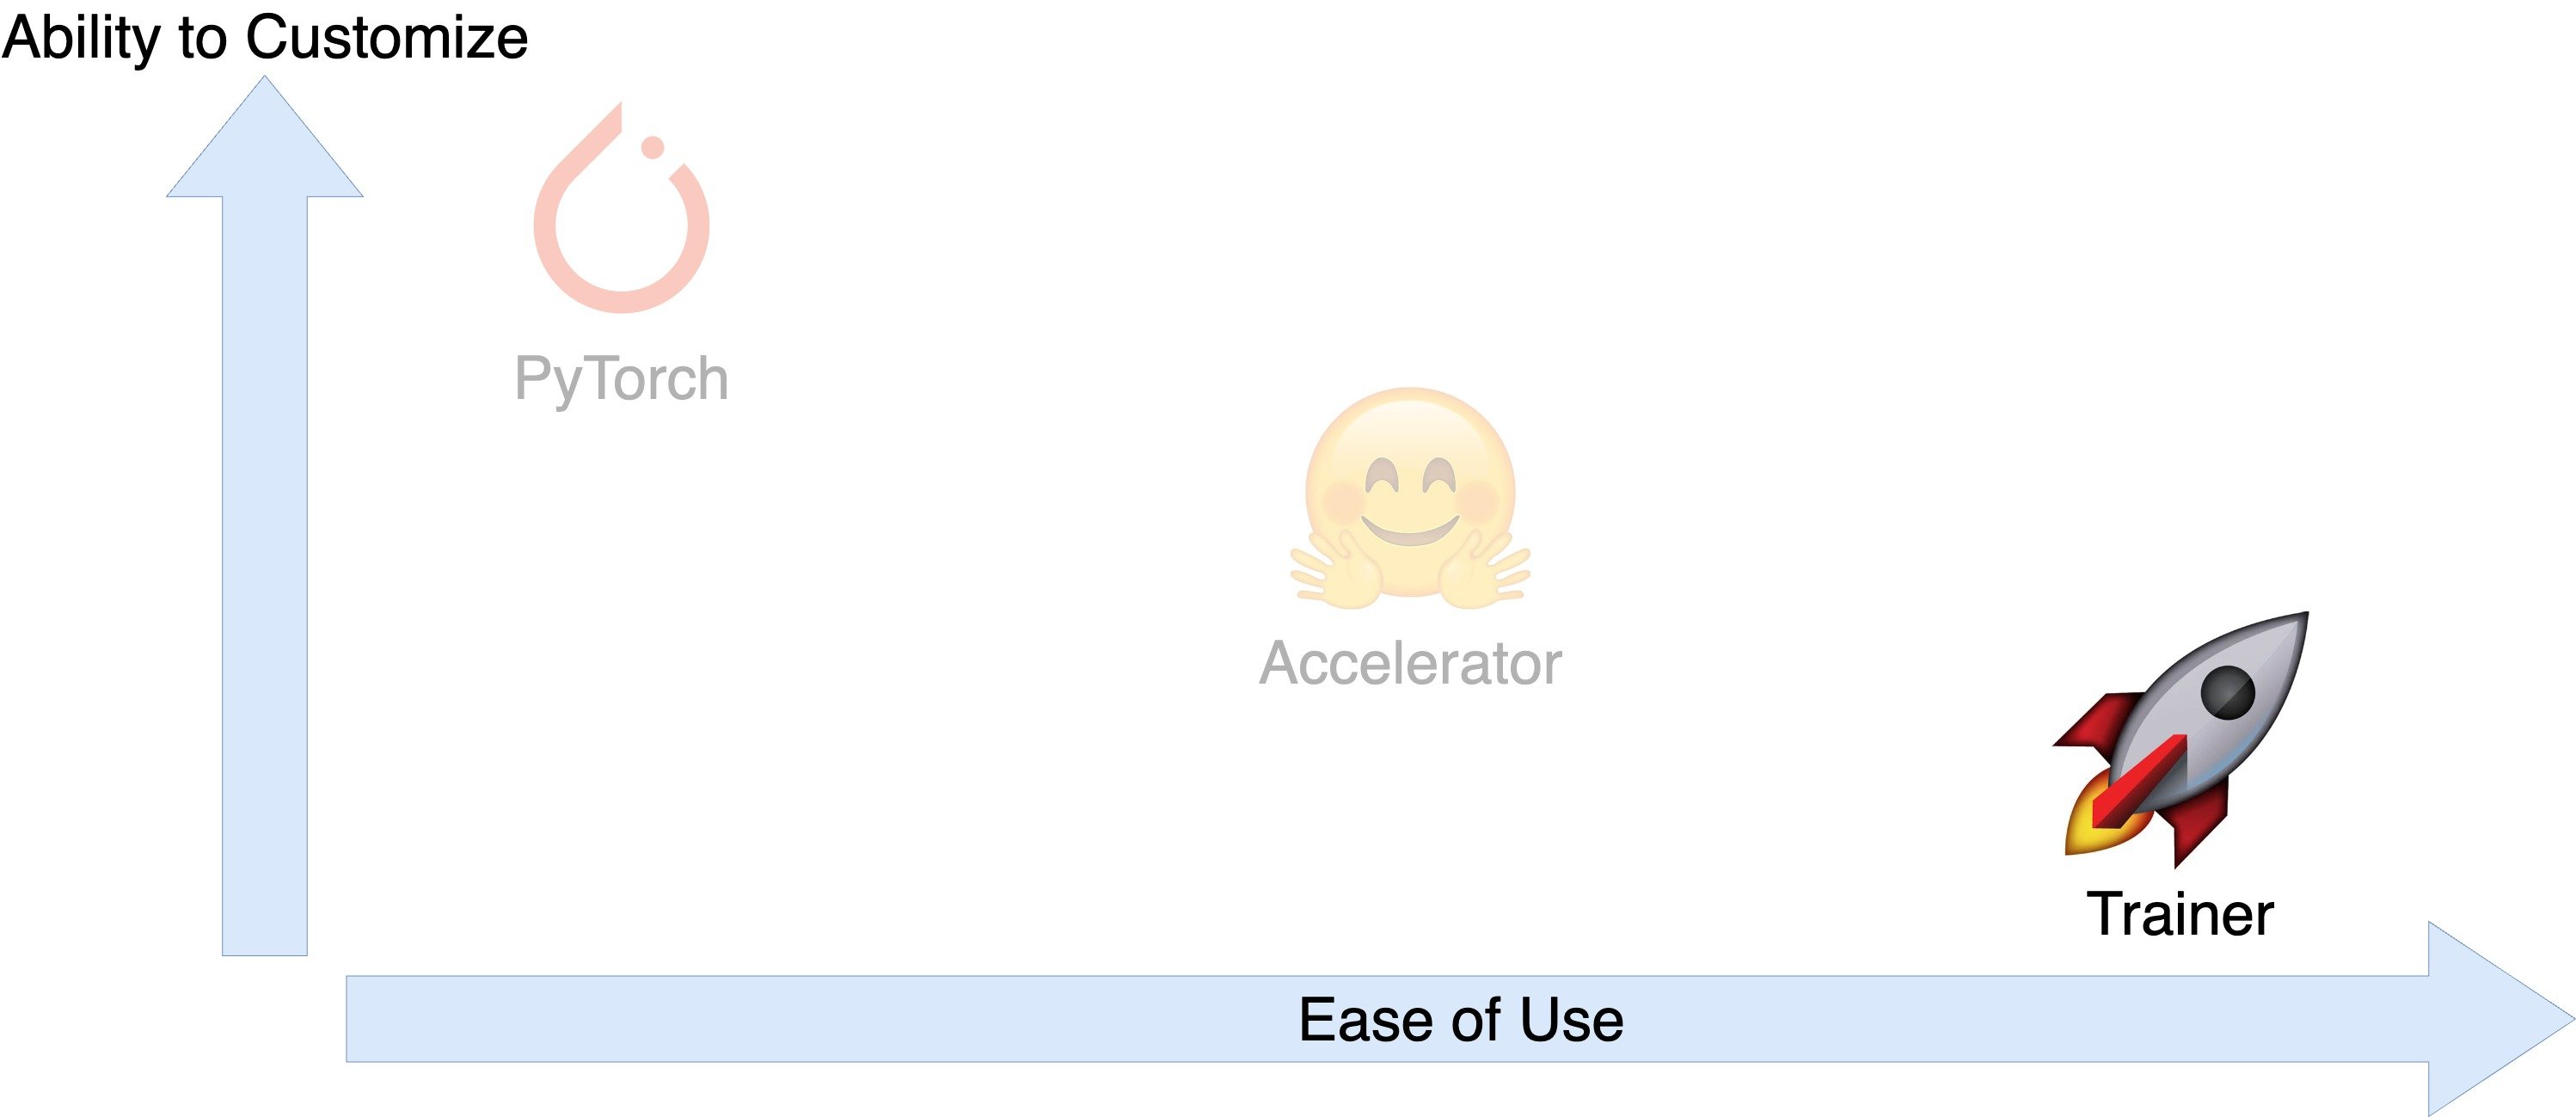
Графік порівняння простоти використання та можливості налаштування для PyTorch, Accelerator і Trainer.

Ефективне тренування моделей ШІ з PyTorch

PyTorch, Accelerator і Trainer

Графік порівняння простоти використання та можливості налаштування для PyTorch, Accelerator і Trainer.

Ефективне тренування моделей ШІ з PyTorch

PyTorch, Accelerator і Trainer

Графік порівняння простоти використання та можливості налаштування для PyTorch, Accelerator і Trainer.

Ефективне тренування моделей ШІ з PyTorch

Накопичення градієнтів у PyTorch
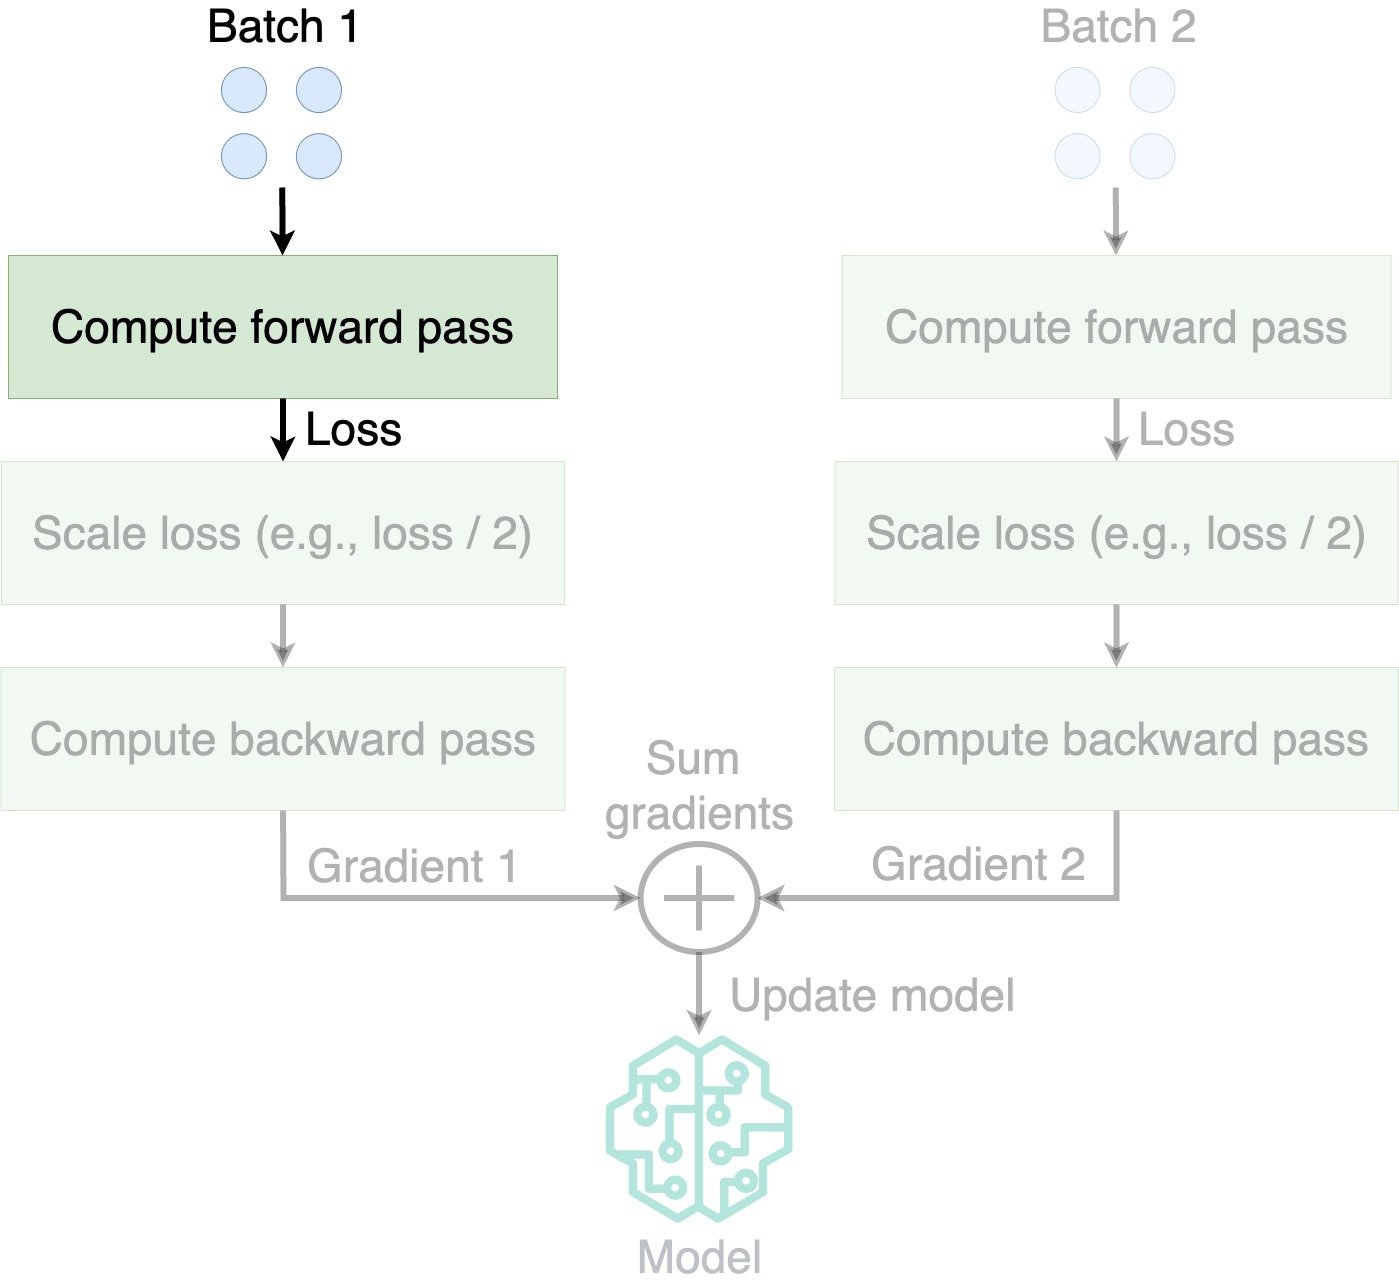
for index, batch in enumerate(dataloader):
    inputs, targets = (batch["input_ids"], 
                       batch["labels"])
    inputs, targets = (inputs.to(device), 
                       targets.to(device))


Діаграма: накопичення градієнтів як сума градієнтів кількох батчів.

Ефективне тренування моделей ШІ з PyTorch

Накопичення градієнтів у PyTorch
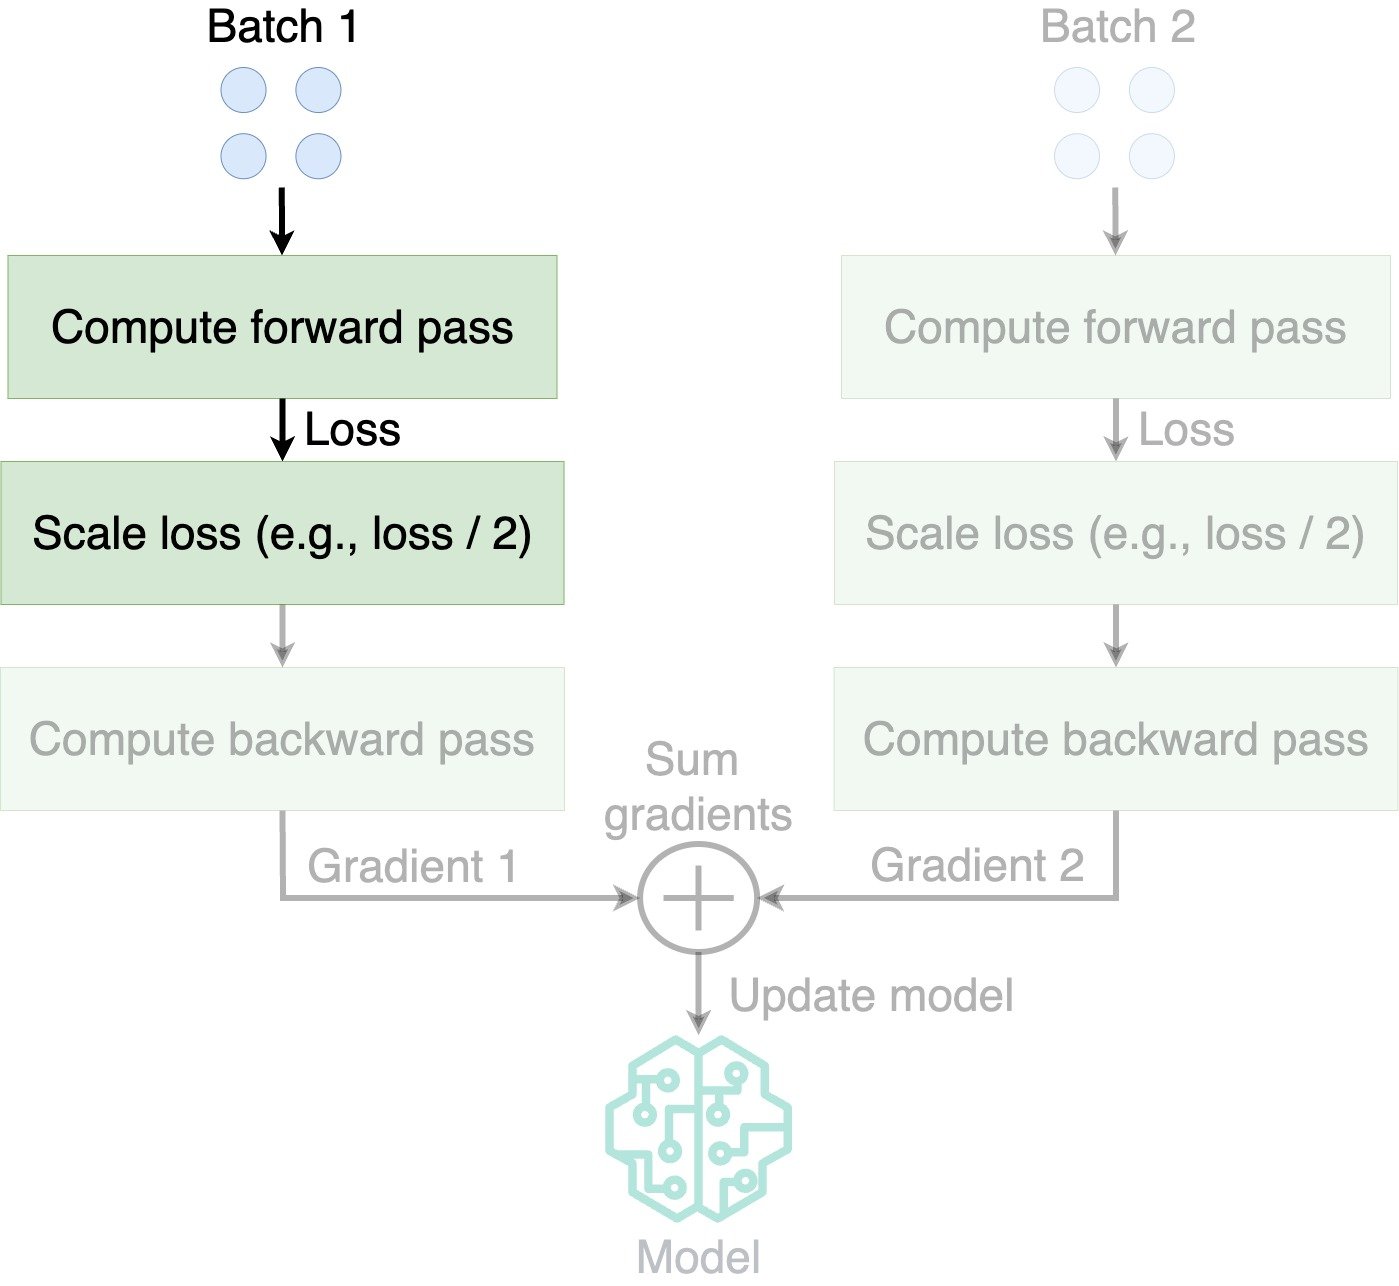
for index, batch in enumerate(dataloader):
    inputs, targets = (batch["input_ids"], 
                       batch["labels"])
    inputs, targets = (inputs.to(device), 
                       targets.to(device))
    outputs = model(inputs, labels=targets)
    loss = outputs.loss


Діаграма: накопичення градієнтів як сума градієнтів кількох батчів.

Ефективне тренування моделей ШІ з PyTorch

Накопичення градієнтів у PyTorch
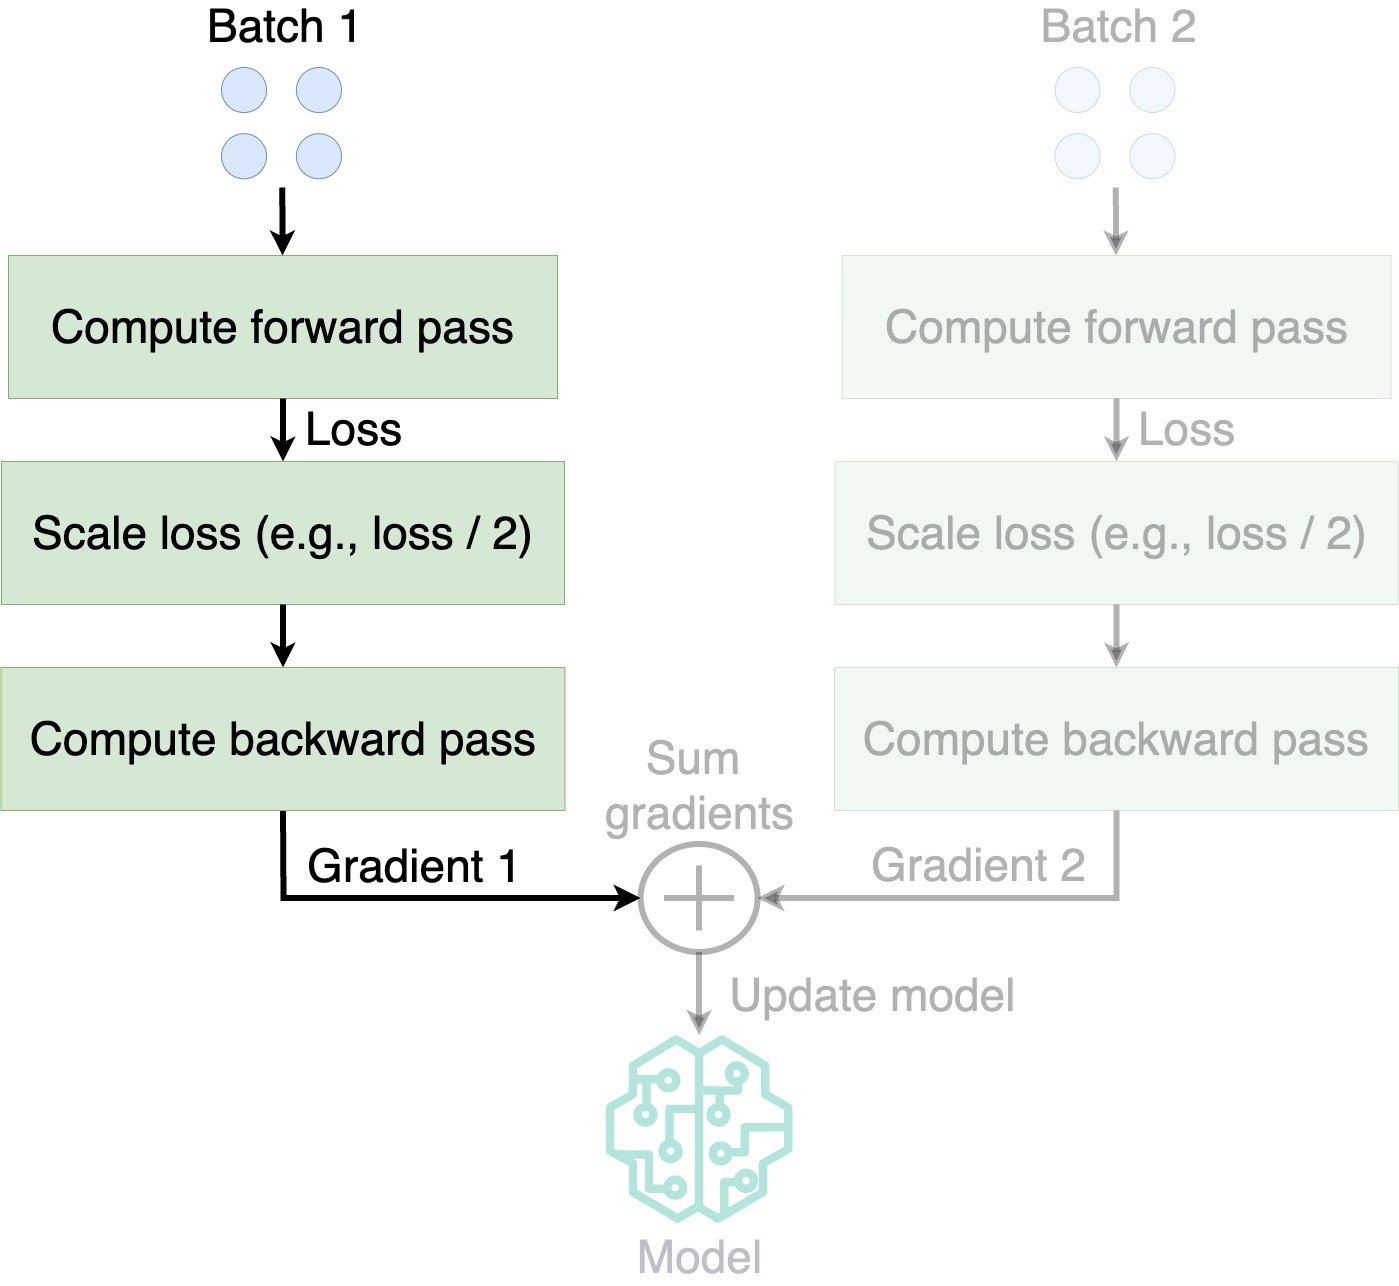
for index, batch in enumerate(dataloader):
    inputs, targets = (batch["input_ids"], 
                       batch["labels"])
    inputs, targets = (inputs.to(device), 
                       targets.to(device))
    outputs = model(inputs, labels=targets)
    loss = outputs.loss
    loss = loss / gradient_accumulation_steps


Діаграма: накопичення градієнтів як сума градієнтів кількох батчів.

Ефективне тренування моделей ШІ з PyTorch

Накопичення градієнтів у PyTorch
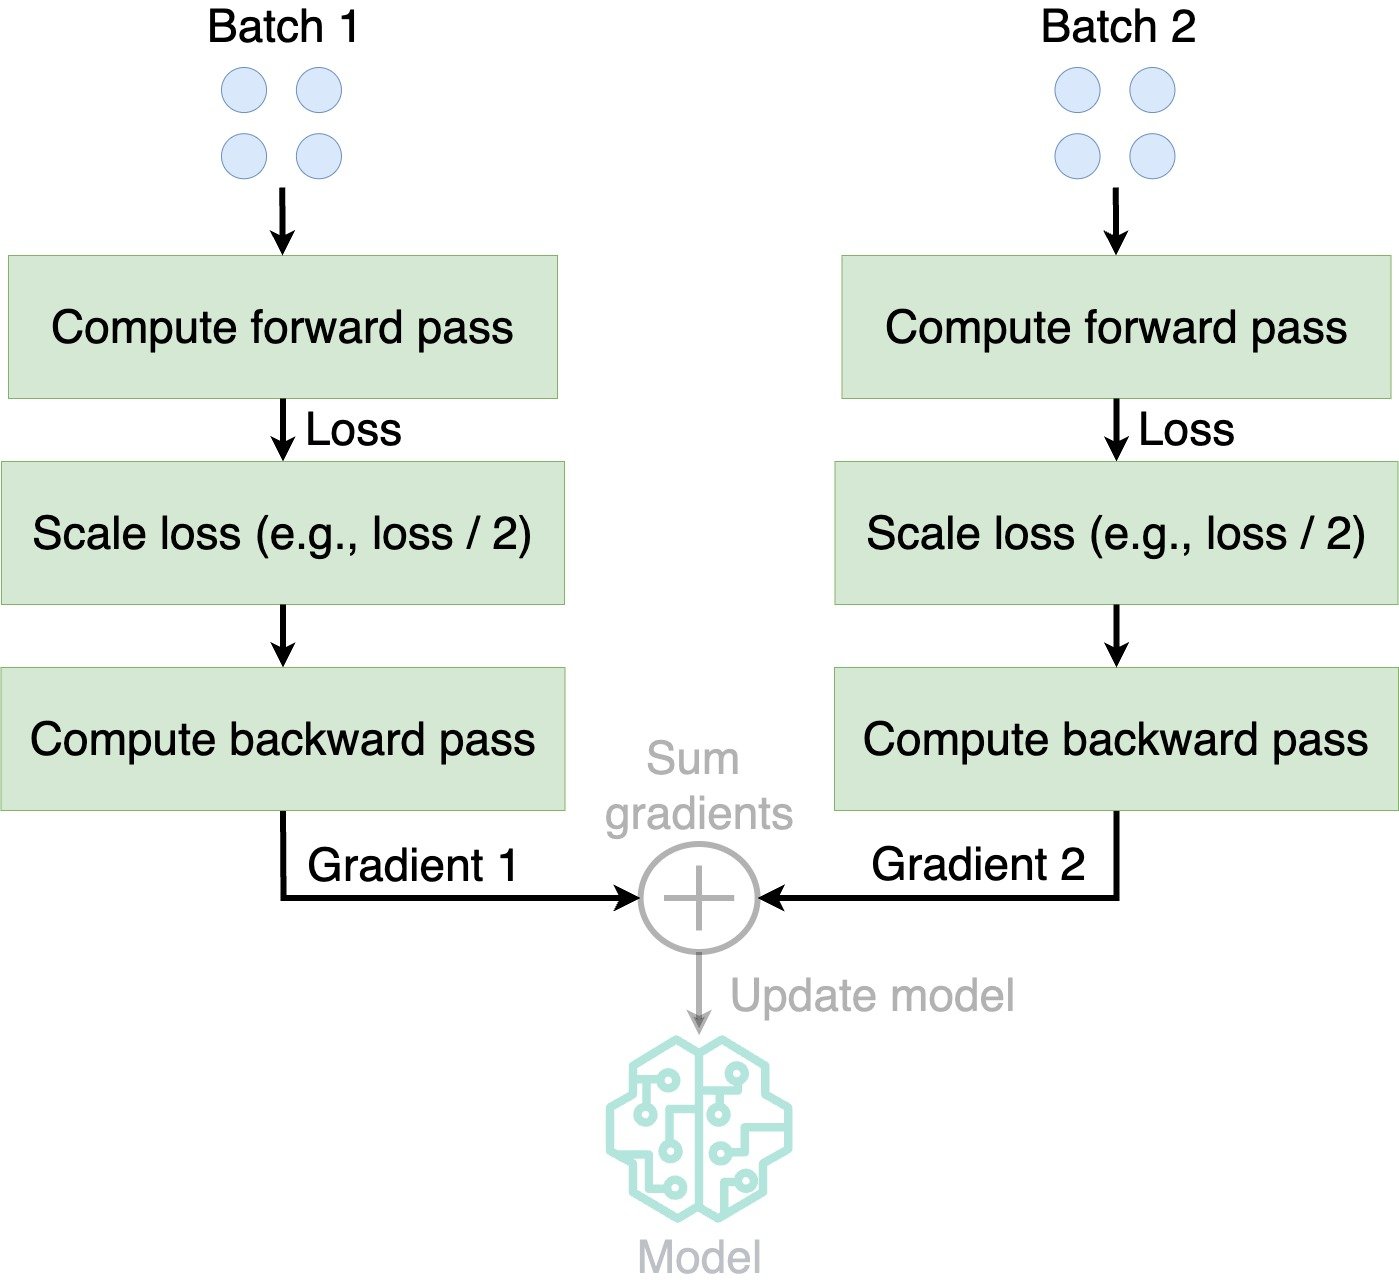
for index, batch in enumerate(dataloader):
    inputs, targets = (batch["input_ids"], 
                       batch["labels"])
    inputs, targets = (inputs.to(device), 
                       targets.to(device))
    outputs = model(inputs, labels=targets)
    loss = outputs.loss
    loss = loss / gradient_accumulation_steps
    loss.backward()


Діаграма: накопичення градієнтів як сума градієнтів кількох батчів.

Ефективне тренування моделей ШІ з PyTorch

Накопичення градієнтів у PyTorch

for index, batch in enumerate(dataloader):
    inputs, targets = (batch["input_ids"], 
                       batch["labels"])
    inputs, targets = (inputs.to(device), 
                       targets.to(device))
    outputs = model(inputs, labels=targets)
    loss = outputs.loss
    loss = loss / gradient_accumulation_steps
    loss.backward()
    if ((index + 1) 
        % gradient_accumulation_steps == 0):


Діаграма: накопичення градієнтів як сума градієнтів кількох батчів.

Ефективне тренування моделей ШІ з PyTorch

Накопичення градієнтів у PyTorch

for index, batch in enumerate(dataloader):
    inputs, targets = (batch["input_ids"], 
                       batch["labels"])
    inputs, targets = (inputs.to(device), 
                       targets.to(device))
    outputs = model(inputs, labels=targets)
    loss = outputs.loss
    loss = loss / gradient_accumulation_steps
    loss.backward()
    if ((index + 1) 
        % gradient_accumulation_steps == 0):
        optimizer.step()
        lr_scheduler.step()
        optimizer.zero_grad()

Діаграма: накопичення градієнтів як сума градієнтів кількох батчів.

Ефективне тренування моделей ШІ з PyTorch

Від PyTorch до Accelerator

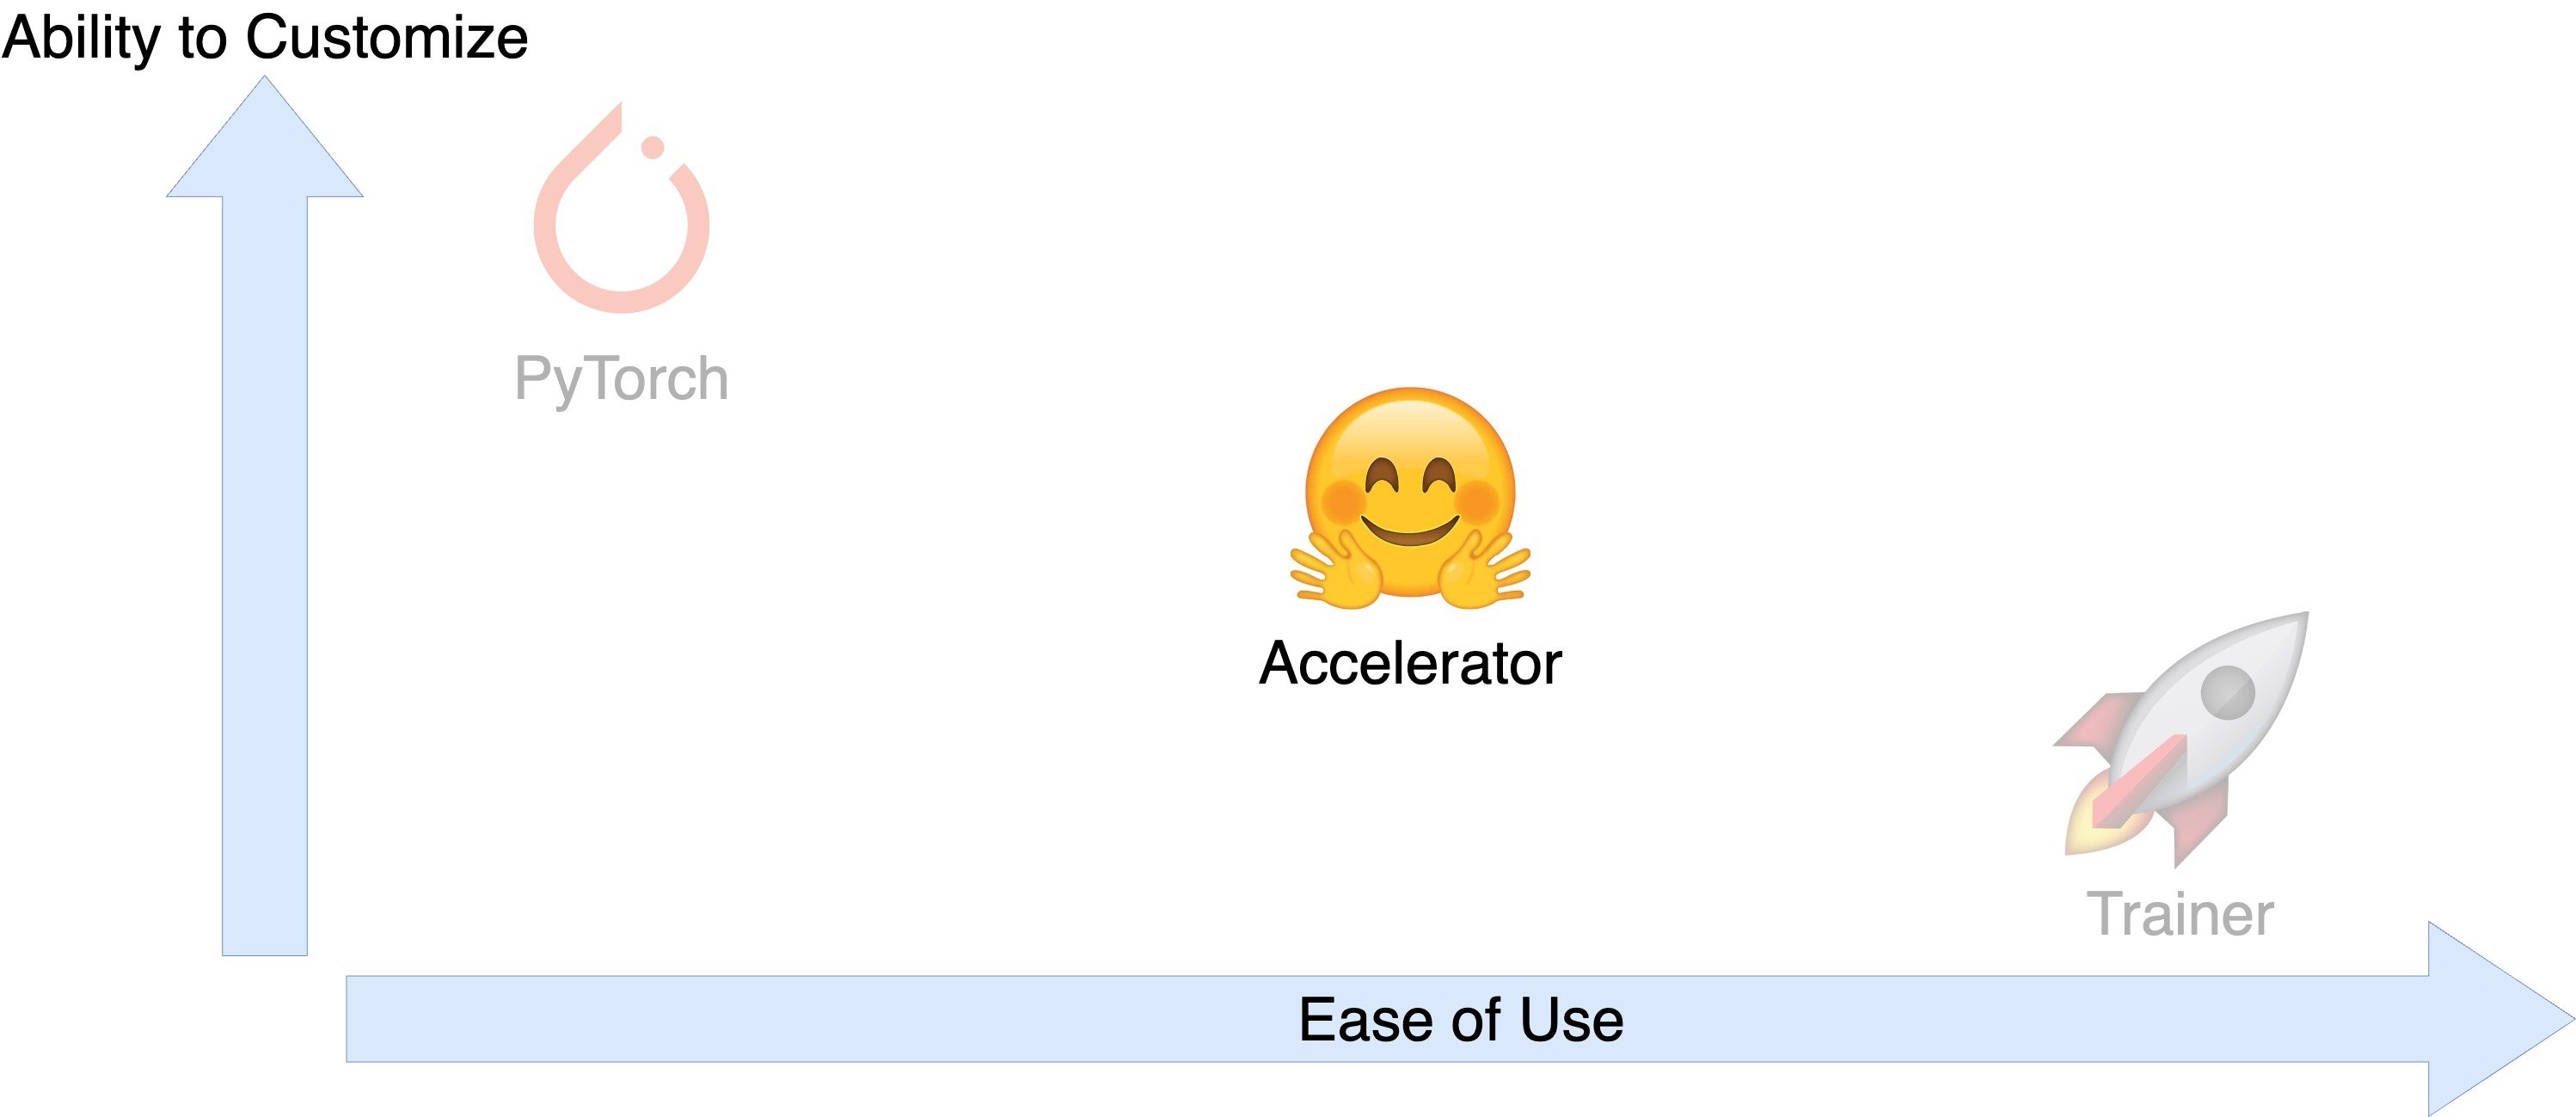
Графік порівняння простоти використання та можливості налаштування для PyTorch, Accelerator і Trainer.

Ефективне тренування моделей ШІ з PyTorch

Від PyTorch до Accelerator

Графік порівняння простоти використання та можливості налаштування для PyTorch, Accelerator і Trainer.

Ефективне тренування моделей ШІ з PyTorch

Накопичення градієнтів з Accelerator

accelerator = \
    Accelerator(gradient_accumulation_steps=2)

for index, batch in enumerate(dataloader): inputs, targets = (batch["input_ids"], batch["labels"])

Діаграма: накопичення градієнтів як сума градієнтів кількох батчів.

Ефективне тренування моделей ШІ з PyTorch

Накопичення градієнтів з Accelerator

accelerator = \
    Accelerator(gradient_accumulation_steps=2)

for index, batch in enumerate(dataloader):

        inputs, targets = (batch["input_ids"],
                           batch["labels"])
        outputs = model(inputs, 
                        labels=targets)
        loss = outputs.loss


Діаграма: накопичення градієнтів як сума градієнтів кількох батчів.

Ефективне тренування моделей ШІ з PyTorch

Накопичення градієнтів з Accelerator

accelerator = \
    Accelerator(gradient_accumulation_steps=2)

for index, batch in enumerate(dataloader):
    with accelerator.accumulate(model):
        inputs, targets = (batch["input_ids"],
                           batch["labels"])
        outputs = model(inputs, 
                        labels=targets)
        loss = outputs.loss


Діаграма: накопичення градієнтів як сума градієнтів кількох батчів.

Ефективне тренування моделей ШІ з PyTorch

Накопичення градієнтів з Accelerator

accelerator = \
    Accelerator(gradient_accumulation_steps=2)

for index, batch in enumerate(dataloader):
    with accelerator.accumulate(model):
        inputs, targets = (batch["input_ids"],
                           batch["labels"])
        outputs = model(inputs, 
                        labels=targets)
        loss = outputs.loss
        accelerator.backward(loss)


Діаграма: накопичення градієнтів як сума градієнтів кількох батчів.

Ефективне тренування моделей ШІ з PyTorch

Накопичення градієнтів з Accelerator

accelerator = \
    Accelerator(gradient_accumulation_steps=2)

for index, batch in enumerate(dataloader):
    with accelerator.accumulate(model):
        inputs, targets = (batch["input_ids"],
                           batch["labels"])
        outputs = model(inputs, 
                        labels=targets)
        loss = outputs.loss
        accelerator.backward(loss)


Діаграма: накопичення градієнтів як сума градієнтів кількох батчів.

Ефективне тренування моделей ШІ з PyTorch

Накопичення градієнтів з Accelerator

accelerator = \
    Accelerator(gradient_accumulation_steps=2)

for index, batch in enumerate(dataloader):
    with accelerator.accumulate(model):
        inputs, targets = (batch["input_ids"],
                           batch["labels"])
        outputs = model(inputs, 
                        labels=targets)
        loss = outputs.loss
        accelerator.backward(loss)
        optimizer.step()
        lr_scheduler.step()
        optimizer.zero_grad()

Діаграма: накопичення градієнтів як сума градієнтів кількох батчів.

Ефективне тренування моделей ШІ з PyTorch

Від Accelerator до Trainer

Графік порівняння простоти використання та можливості налаштування для PyTorch, Accelerator і Trainer.

Ефективне тренування моделей ШІ з PyTorch

Від Accelerator до Trainer

Графік порівняння простоти використання та можливості налаштування для PyTorch, Accelerator і Trainer.

Ефективне тренування моделей ШІ з PyTorch

Накопичення градієнтів у Trainer

training_args = TrainingArguments(output_dir="./results",
                                  evaluation_strategy="epoch",
                                  gradient_accumulation_steps=2)

trainer = Trainer(model=model, args=training_args, train_dataset=dataset["train"], eval_dataset=dataset["validation"], compute_metrics=compute_metrics)
trainer.train()
{'epoch': 1.0, 'eval_loss': 0.73, 'eval_accuracy': 0.03, 'eval_f1': 0.05}
{'epoch': 2.0, 'eval_loss': 0.68, 'eval_accuracy': 0.19, 'eval_f1': 0.25}
Ефективне тренування моделей ШІ з PyTorch

Перейдемо до практики!

Ефективне тренування моделей ШІ з PyTorch

Preparing Video For Download...