Чекпойнтинг градієнтів і локальний SGD

Ефективне тренування моделей ШІ з PyTorch

Dennis Lee

Data Engineer, Amazon

Покращення ефективності навчання
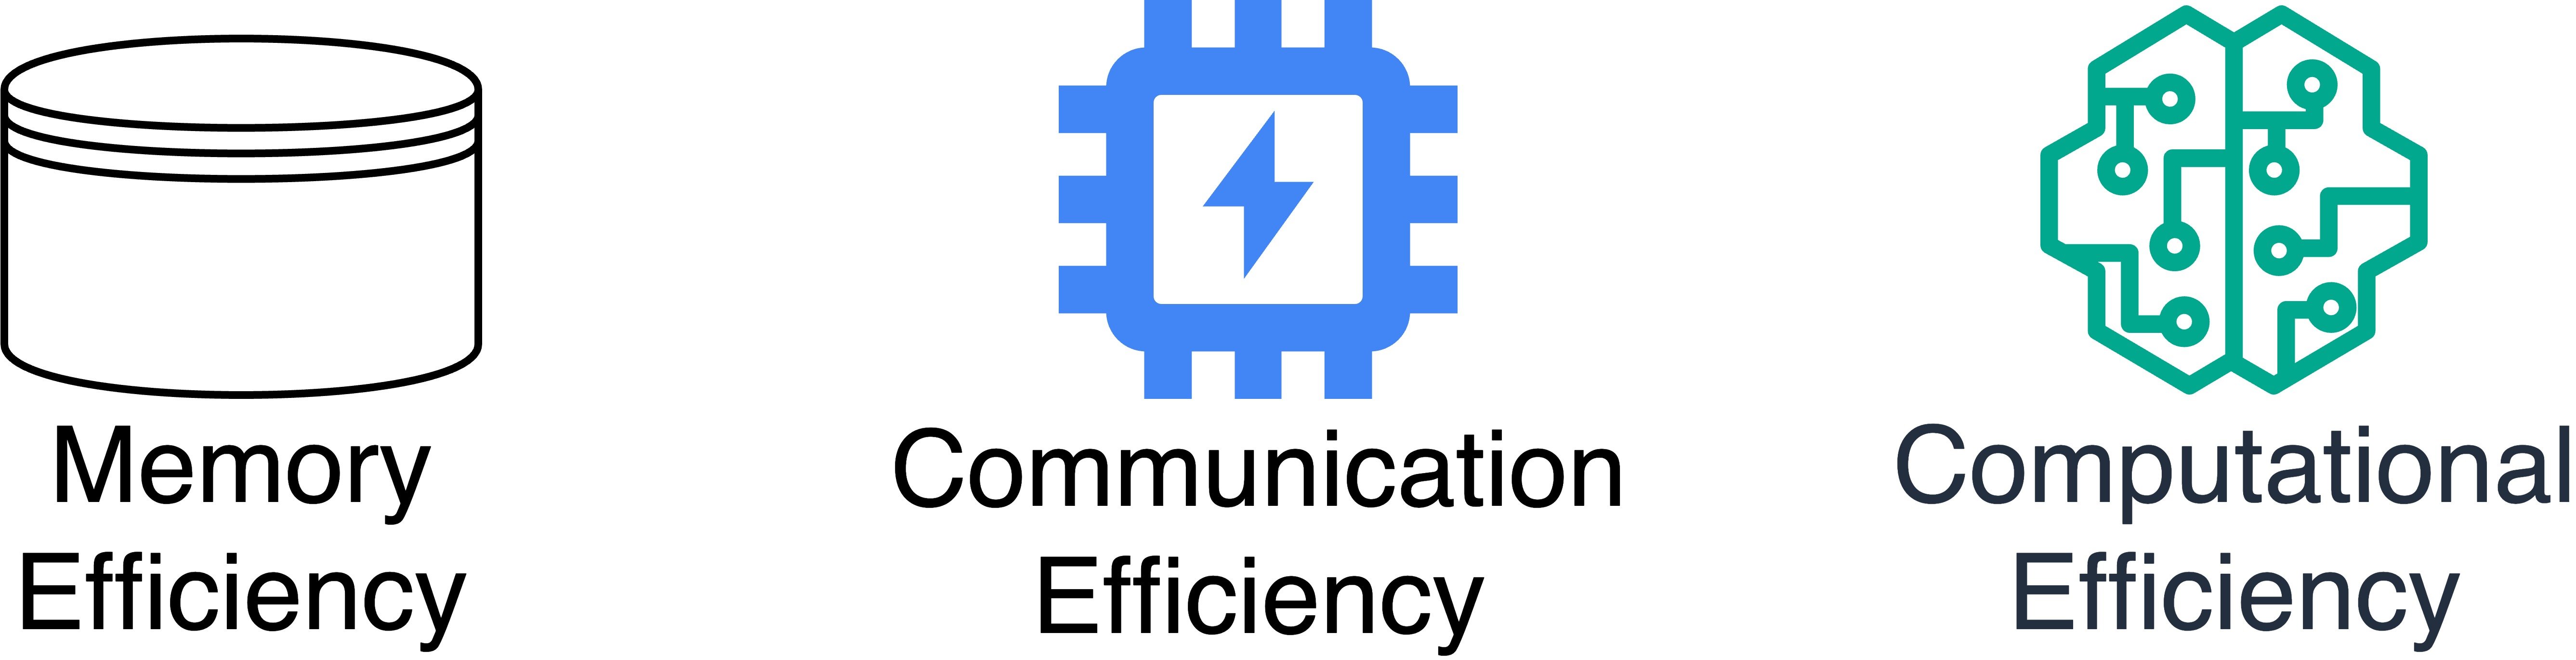


Піктограми, що позначають ефективність памʼяті, комунікацій та обчислень.

Ефективне тренування моделей ШІ з PyTorch

Чекпойнтинг градієнтів підвищує ефективність памʼяті


Піктограми, що позначають ефективність памʼяті, комунікацій та обчислень.

Ефективне тренування моделей ШІ з PyTorch

Локальний SGD вирішує ефективність комунікацій


Піктограми, що позначають ефективність памʼяті, комунікацій та обчислень.

Ефективне тренування моделей ШІ з PyTorch

Що таке чекпойнтинг градієнтів?

  • Чекпойнтинг градієнтів: зменшує памʼять, обираючи, які активації зберігати
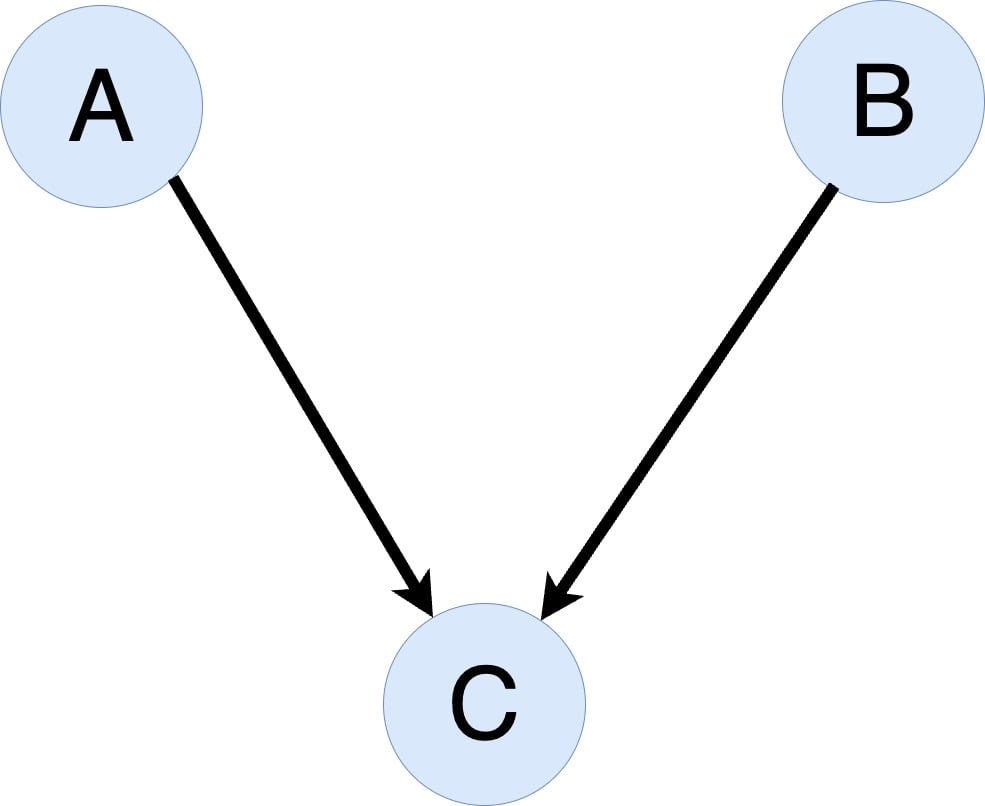
  • Приклад: обчислити A + B = C

Граф, що ілюструє чекпойнтинг градієнтів із вузлами та ребрами

Ефективне тренування моделей ШІ з PyTorch

Що таке чекпойнтинг градієнтів?

  • Чекпойнтинг градієнтів: зменшує памʼять, обираючи, які активації зберігати
  • Приклад: обчислити A + B = C
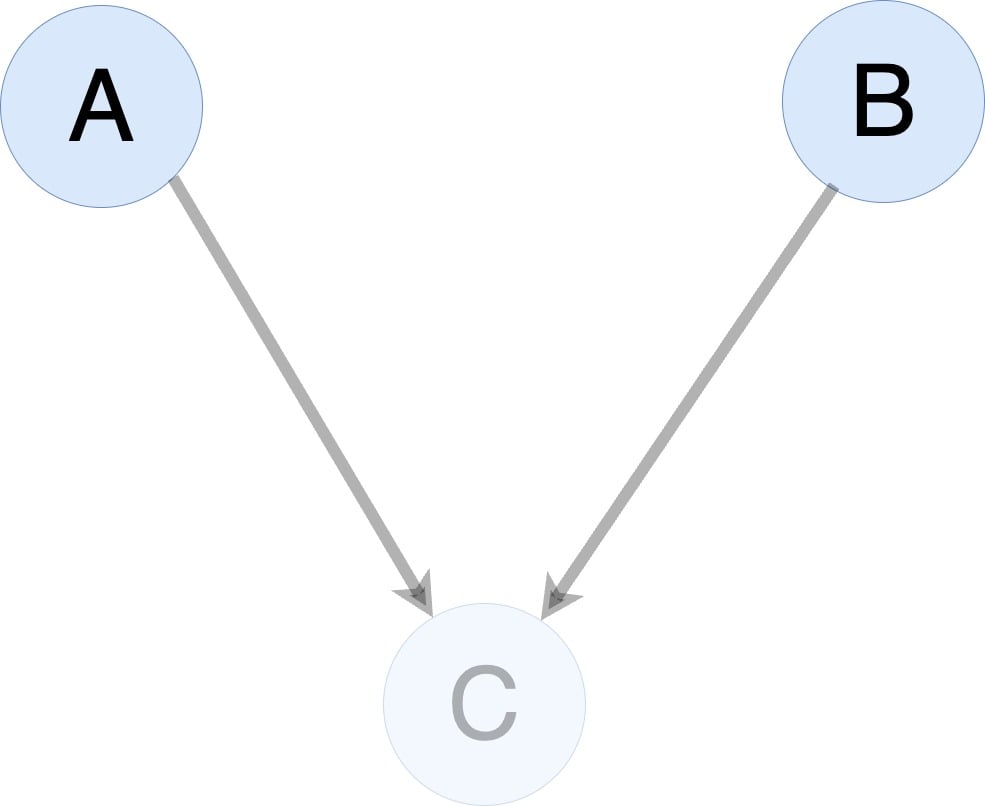
    • Спочатку обчислити A, B, потім C

Граф, що ілюструє чекпойнтинг градієнтів із вузлами та ребрами

Ефективне тренування моделей ШІ з PyTorch

Що таке чекпойнтинг градієнтів?

  • Чекпойнтинг градієнтів: зменшує памʼять, обираючи, які активації зберігати
  • Приклад: обчислити A + B = C
    • Спочатку обчислити A, B, потім C
    • A, B не потрібні для решти прямого проходу
  • Чи варто зберегти або видалити A і B?

Граф, що ілюструє чекпойнтинг градієнтів із вузлами та ребрами

Ефективне тренування моделей ШІ з PyTorch

Що таке чекпойнтинг градієнтів?

  • Чекпойнтинг градієнтів: зменшує памʼять, обираючи, які активації зберігати
  • Приклад: обчислити A + B = C
    • Спочатку обчислити A, B, потім C
    • A, B не потрібні для решти прямого проходу
  • Чи варто зберегти або видалити A і B?
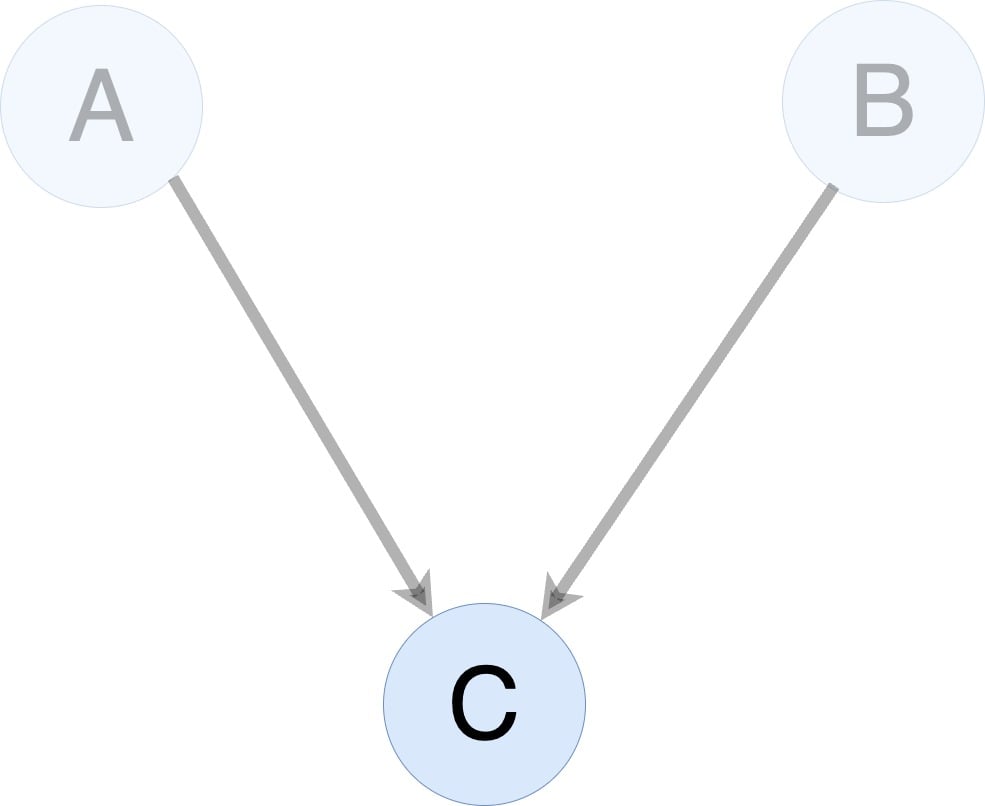
    • Без чекпойнтингу: зберігати A, B

Граф, що ілюструє чекпойнтинг градієнтів із вузлами та ребрами

Ефективне тренування моделей ШІ з PyTorch

Що таке чекпойнтинг градієнтів?

  • Чекпойнтинг градієнтів: зменшує памʼять, обираючи, які активації зберігати
  • Приклад: обчислити A + B = C
    • Спочатку обчислити A, B, потім C
    • A, B не потрібні для решти прямого проходу
  • Чи варто зберегти або видалити A і B?
    • Без чекпойнтингу: зберігати A, B
    • З чекпойнтингом: видалити A, B

Граф, що ілюструє чекпойнтинг градієнтів із вузлами та ребрами

Ефективне тренування моделей ШІ з PyTorch

Що таке чекпойнтинг градієнтів?

  • Чекпойнтинг градієнтів: зменшує памʼять, обираючи, які активації зберігати
  • Приклад: обчислити A + B = C
    • Спочатку обчислити A, B, потім C
    • A, B не потрібні для решти прямого проходу
  • Чи варто зберегти або видалити A і B?
    • Без чекпойнтингу: зберігати A, B
    • З чекпойнтингом: видалити A, B
    • Переобчислити A, B під час зворотного проходу

Граф, що ілюструє чекпойнтинг градієнтів із вузлами та ребрами

Ефективне тренування моделей ШІ з PyTorch

Що таке чекпойнтинг градієнтів?

  • Чекпойнтинг градієнтів: зменшує памʼять, обираючи, які активації зберігати
  • Приклад: обчислити A + B = C
    • Спочатку обчислити A, B, потім C
    • A, B не потрібні для решти прямого проходу
  • Чи варто зберегти або видалити A і B?
    • Без чекпойнтингу: зберігати A, B
    • З чекпойнтингом: видалити A, B
    • Переобчислити A, B під час зворотного проходу
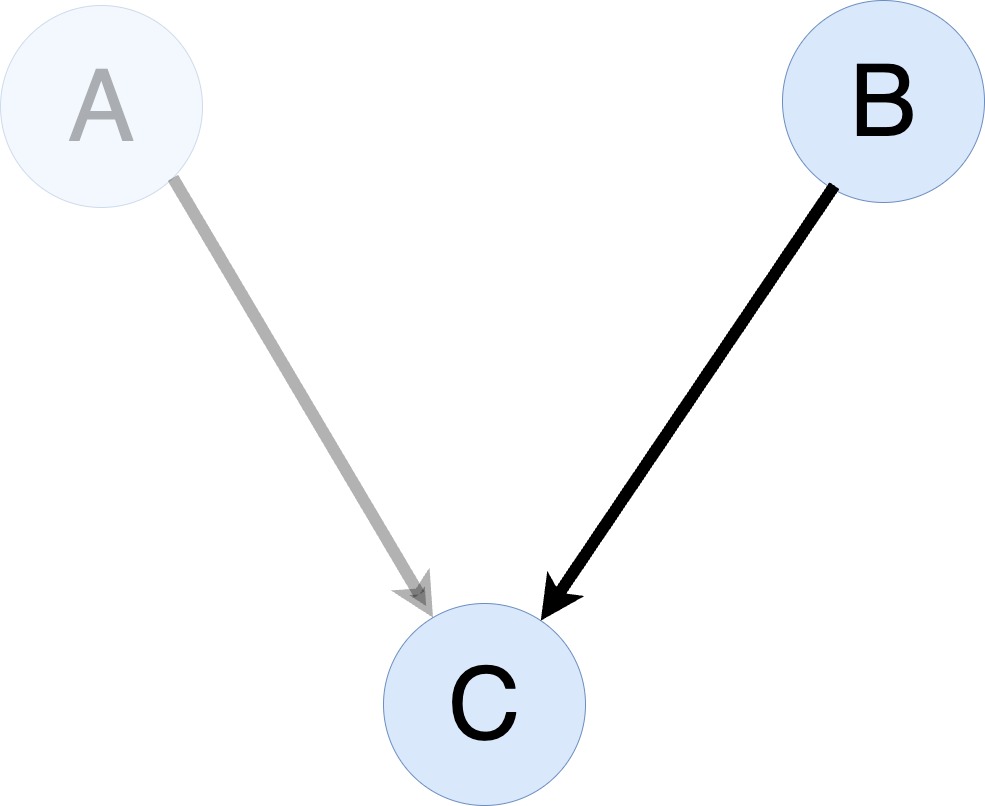
    • Якщо B дорого переобчислювати, зберегти його

Граф, що ілюструє чекпойнтинг градієнтів із вузлами та ребрами

Ефективне тренування моделей ШІ з PyTorch

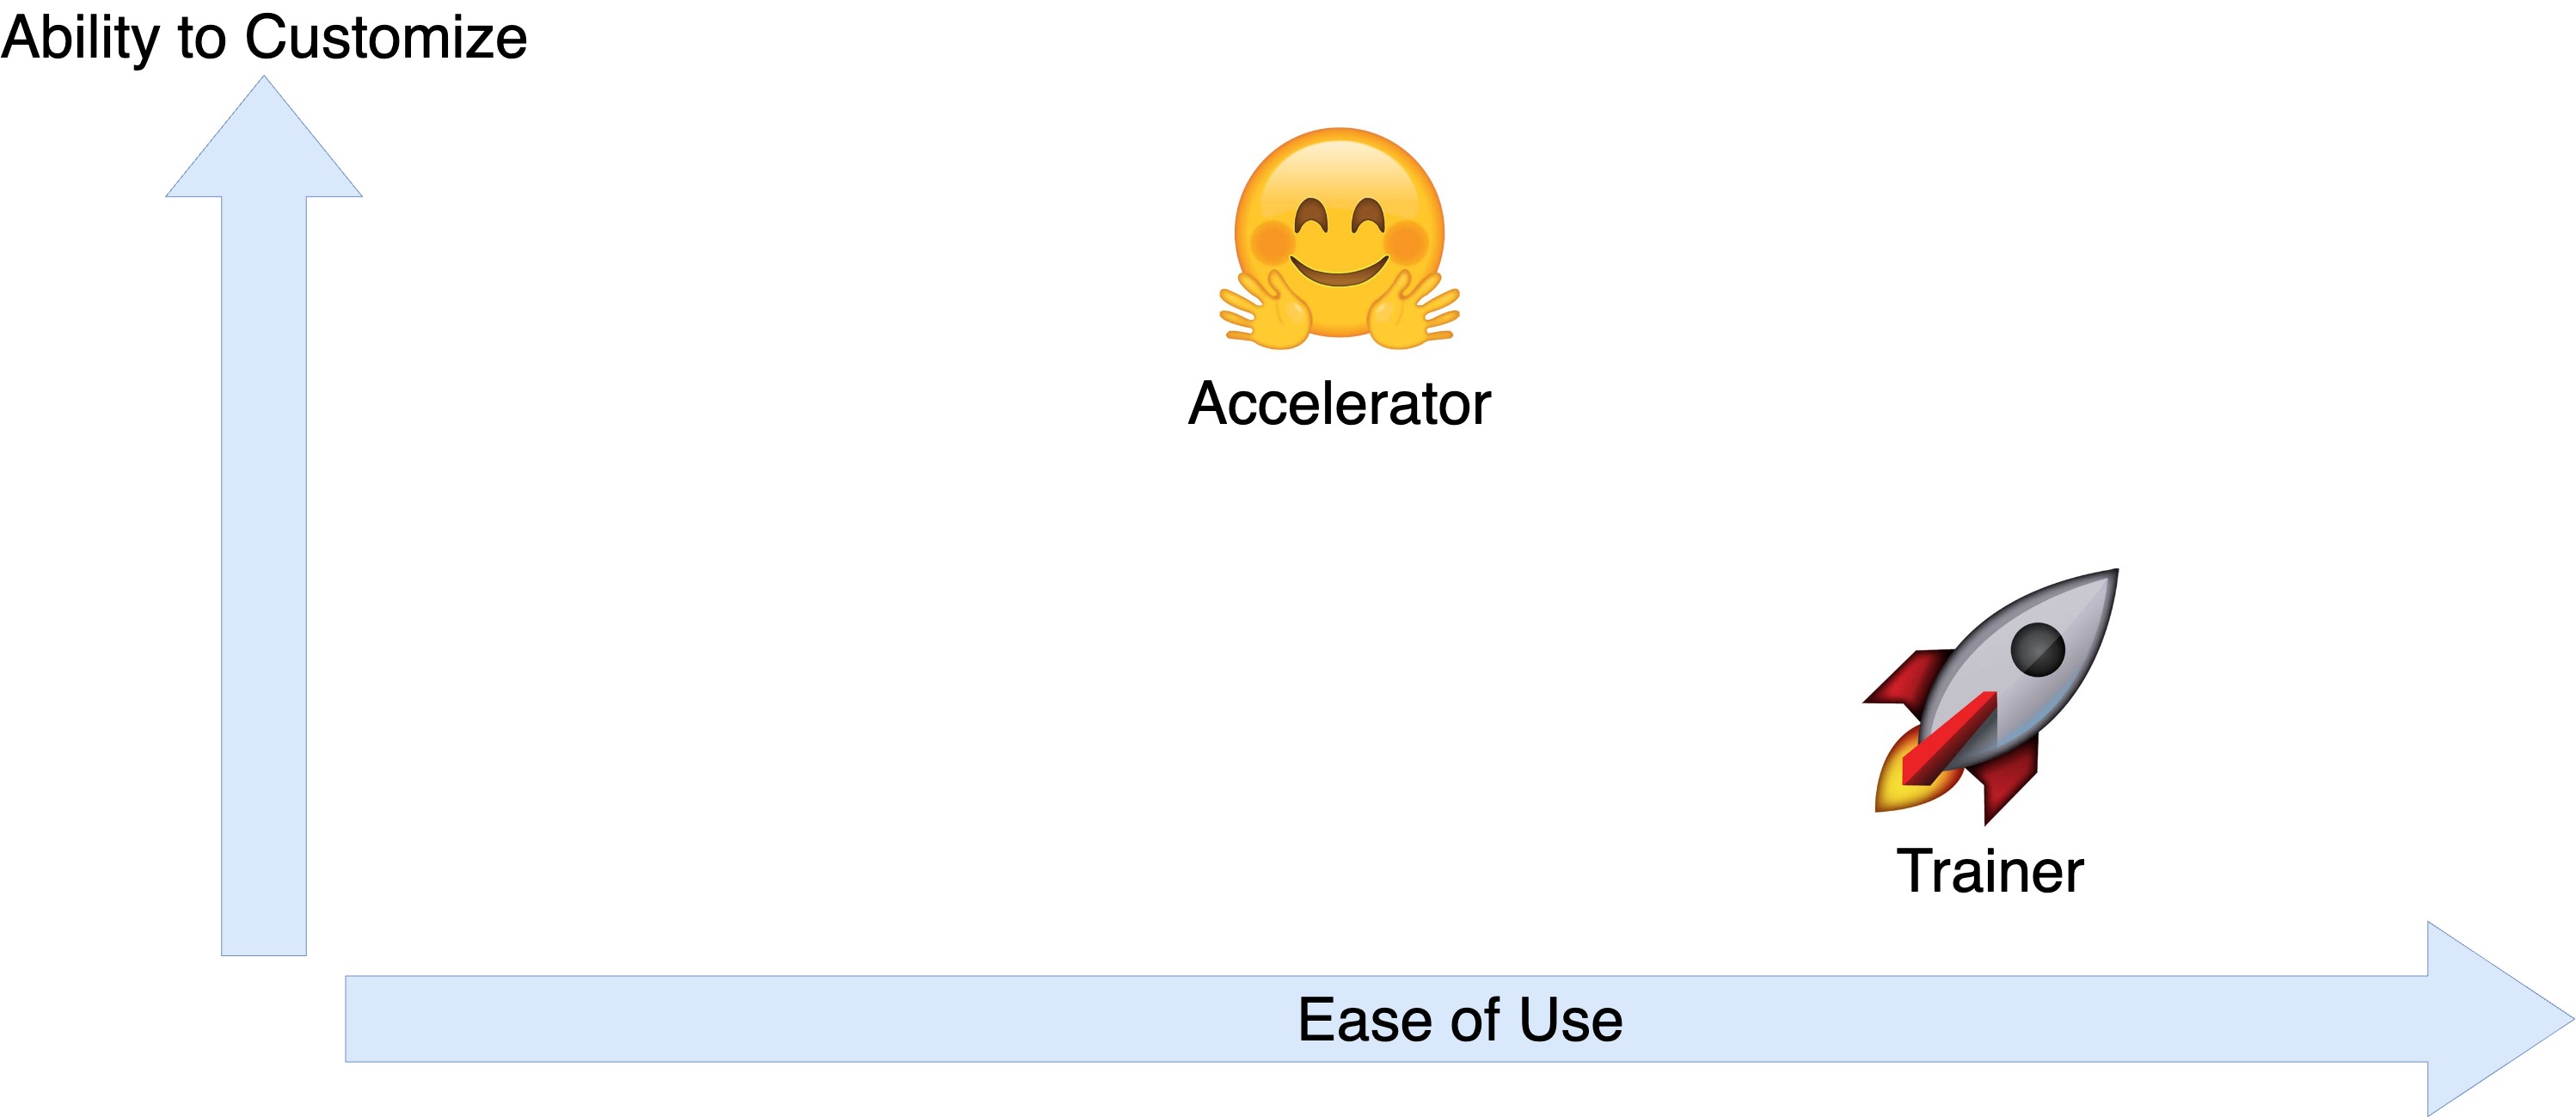
Trainer і Accelerator

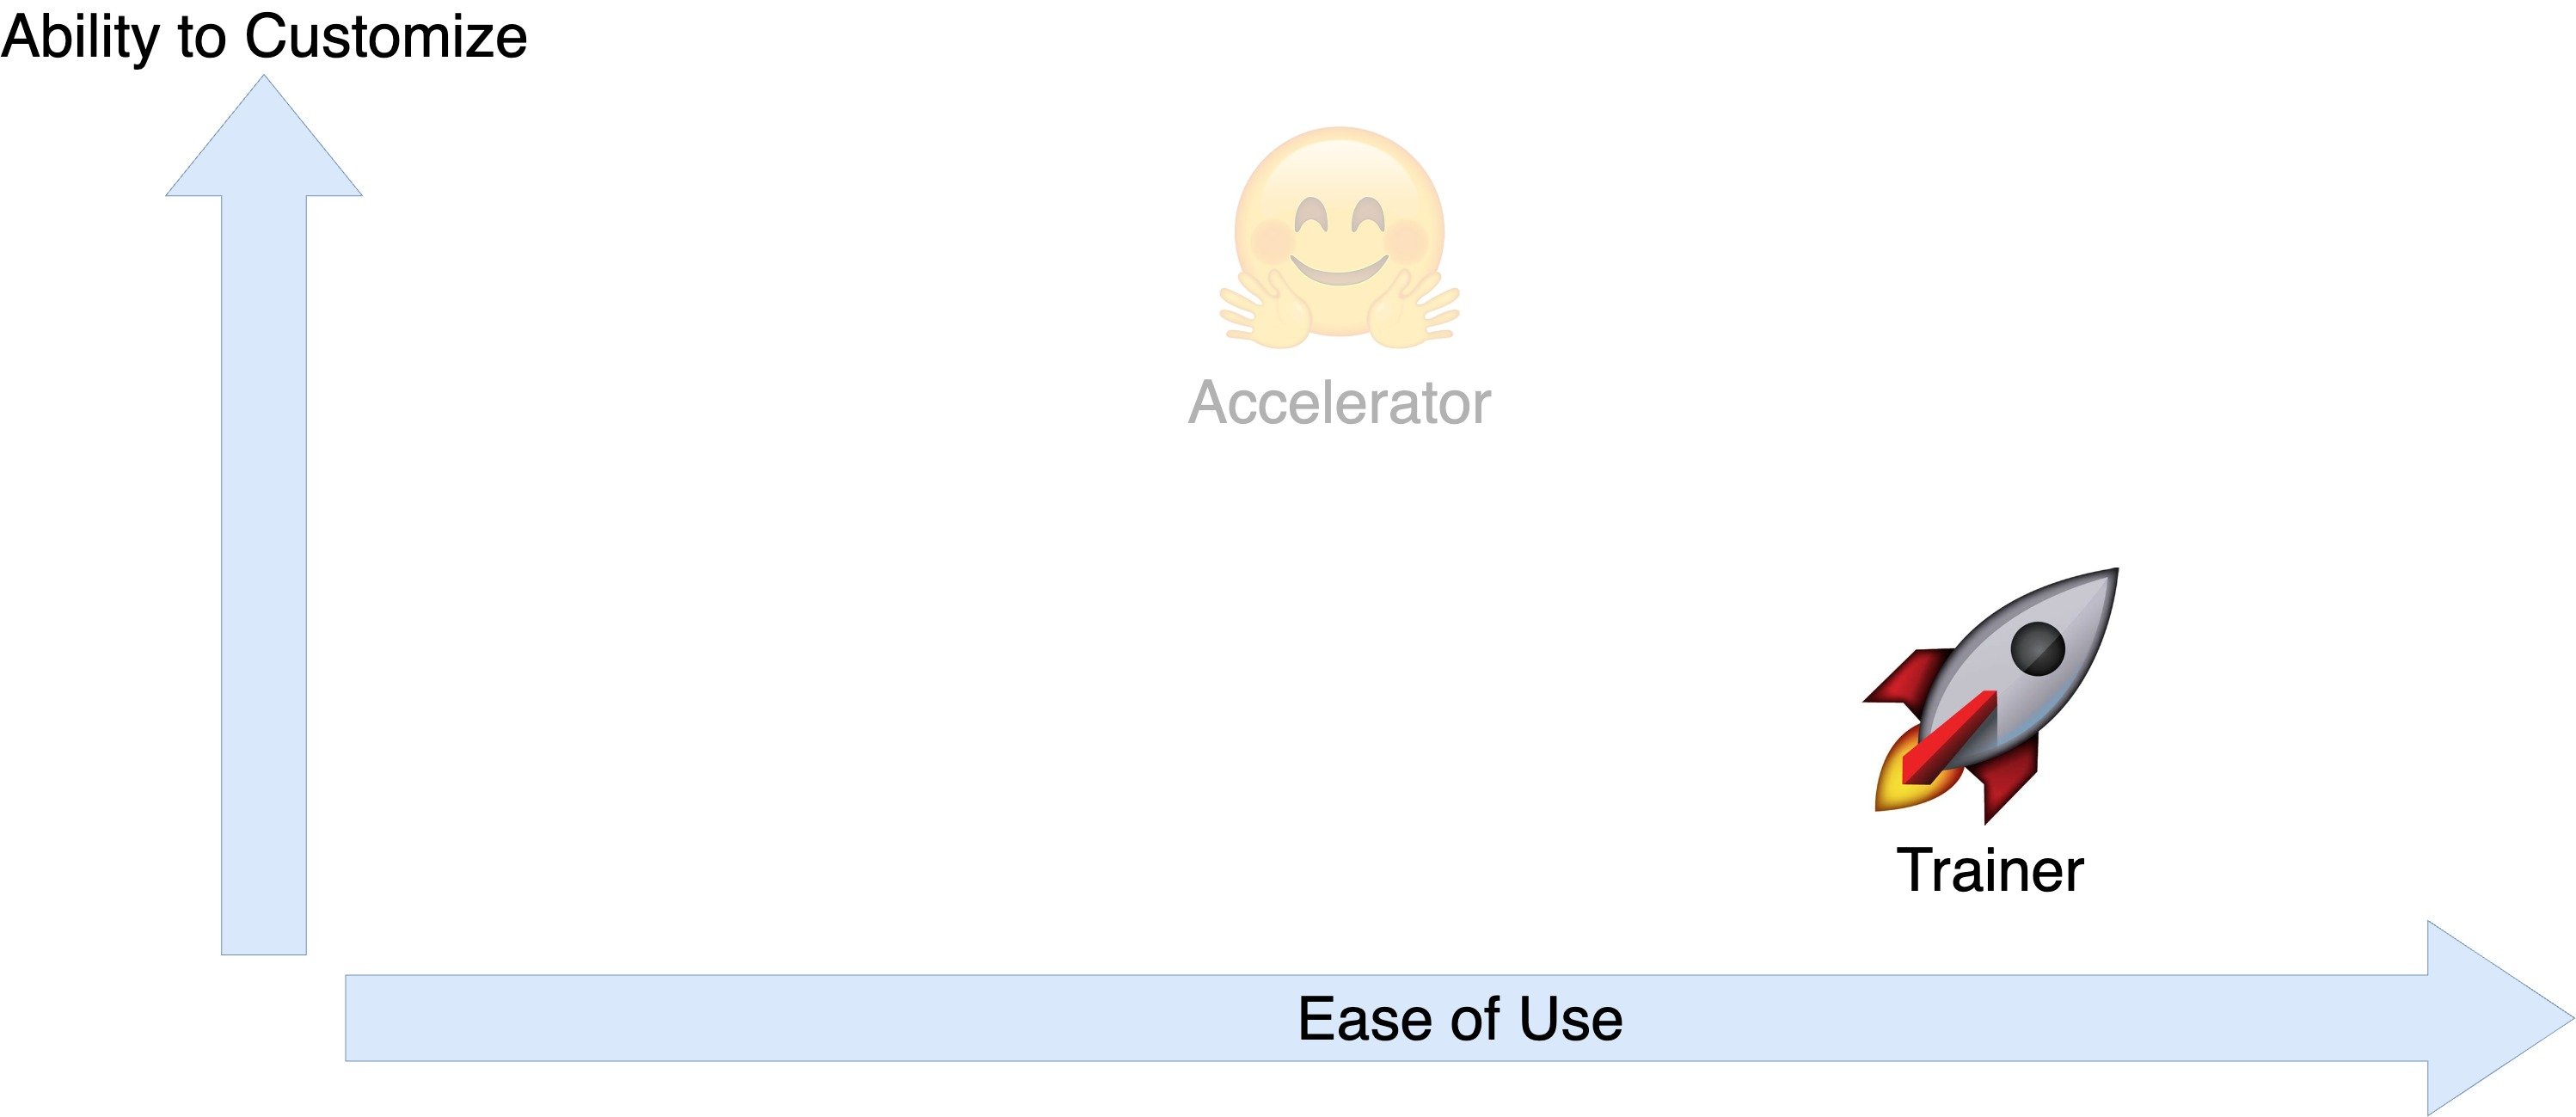
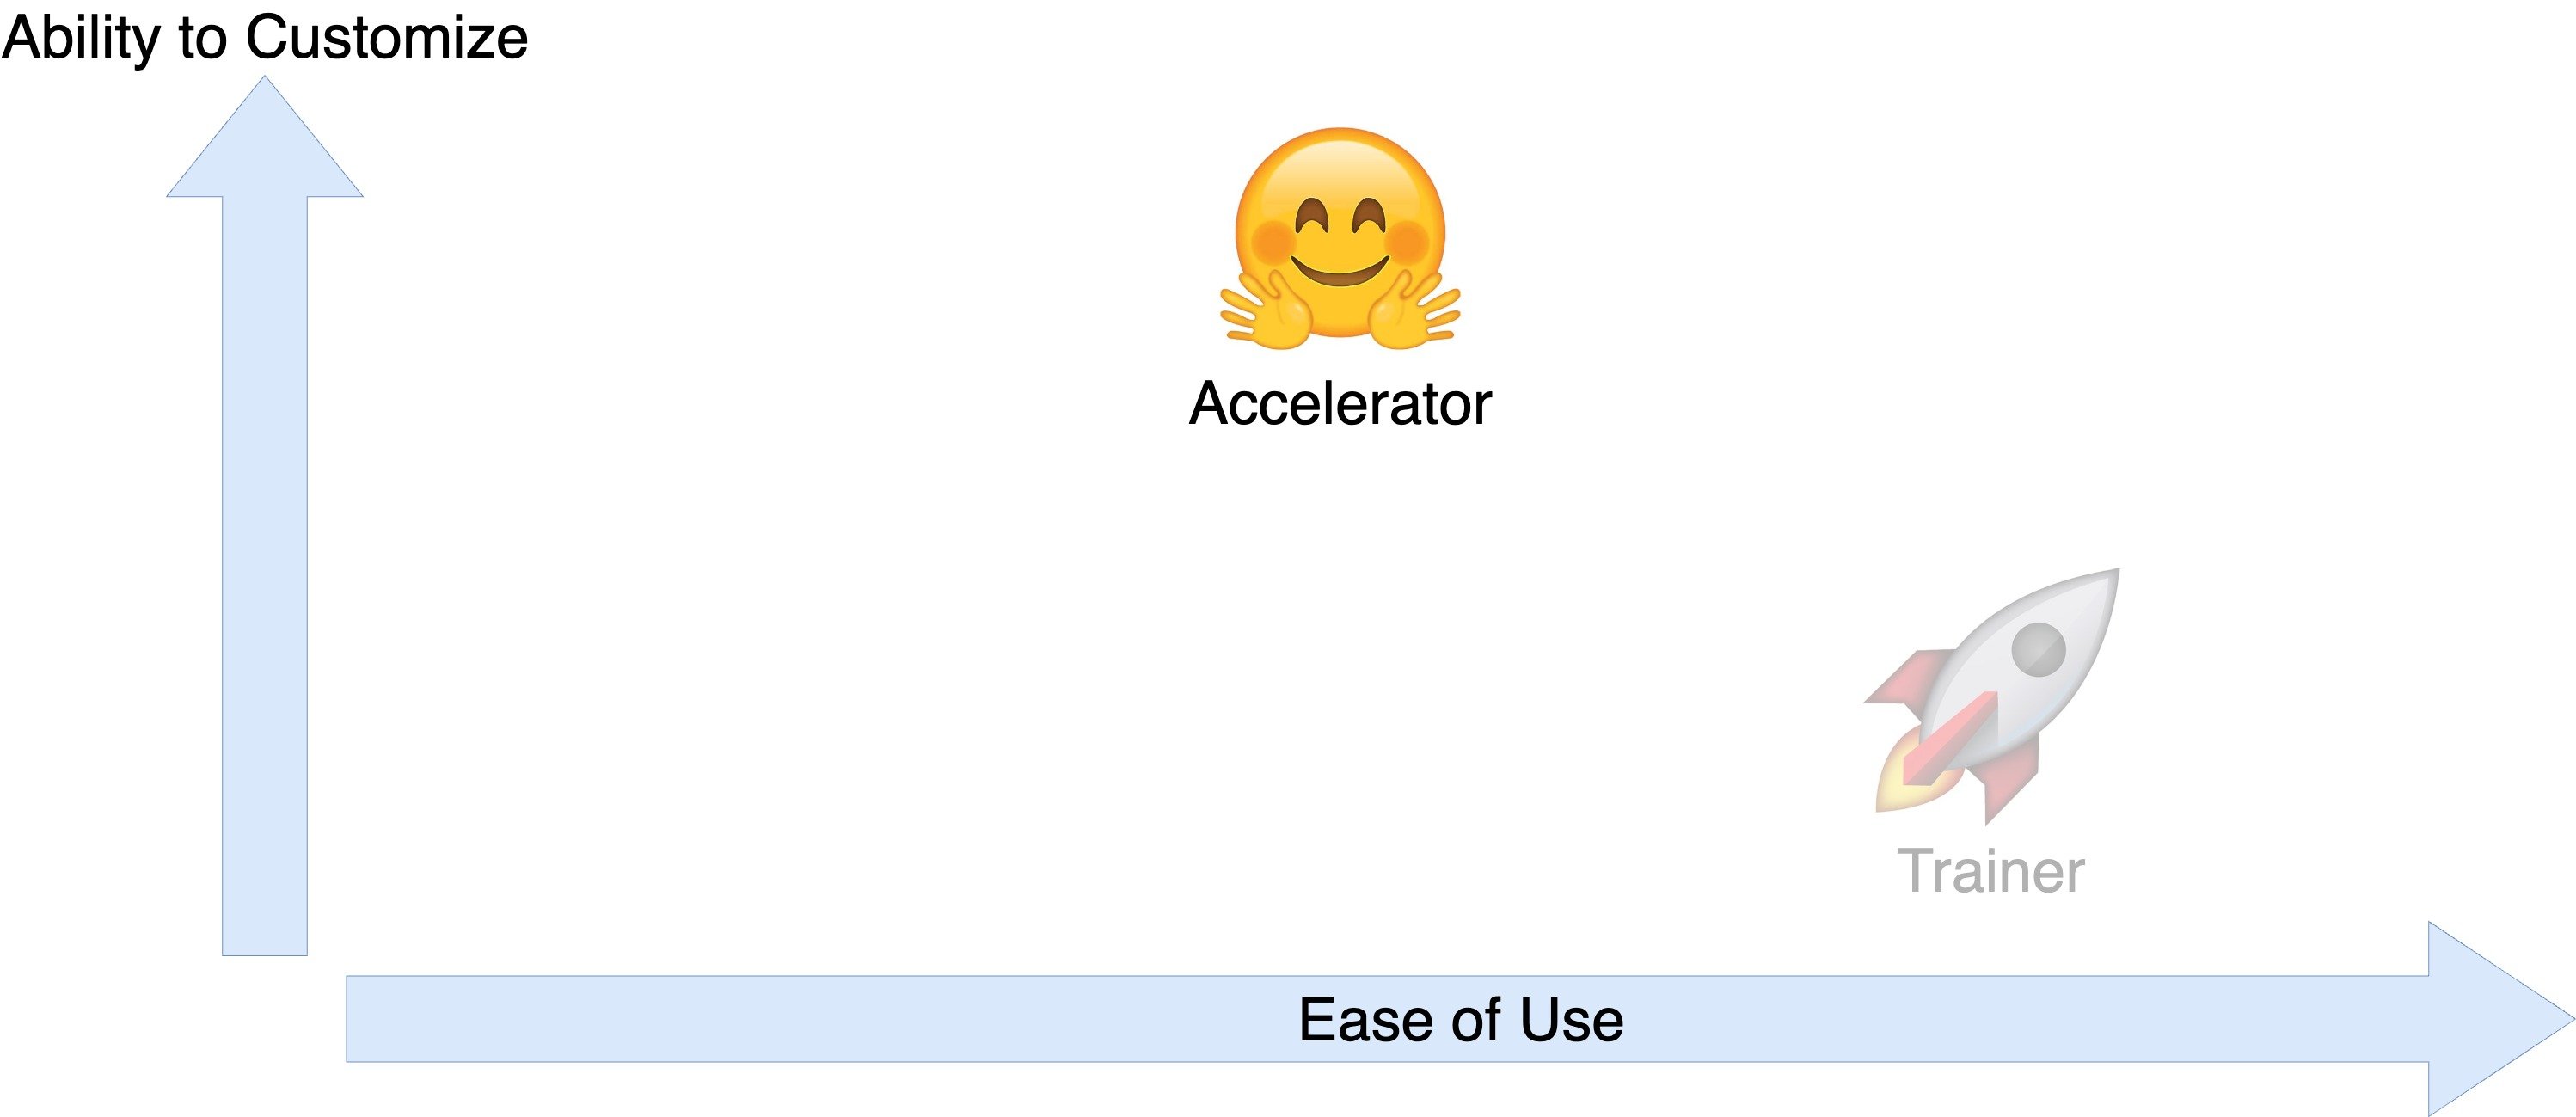
Діаграма порівнює простоту використання і можливість налаштування для Accelerator та Trainer.

Ефективне тренування моделей ШІ з PyTorch

Trainer і Accelerator

Діаграма порівнює простоту використання і можливість налаштування для Accelerator та Trainer.

Ефективне тренування моделей ШІ з PyTorch

Чекпойнтинг градієнтів із Trainer

training_args = TrainingArguments(output_dir="./results",
                                  evaluation_strategy="epoch",
                                  gradient_accumulation_steps=4)


Ефективне тренування моделей ШІ з PyTorch

Чекпойнтинг градієнтів із Trainer

training_args = TrainingArguments(output_dir="./results",
                                  evaluation_strategy="epoch",
                                  gradient_accumulation_steps=4,
                                  gradient_checkpointing=True)

trainer = Trainer(model=model, args=training_args, train_dataset=dataset["train"], eval_dataset=dataset["validation"], compute_metrics=compute_metrics)
trainer.train()
{'epoch': 1.0, 'eval_loss': 0.73, 'eval_accuracy': 0.03, 'eval_f1': 0.05}
Ефективне тренування моделей ШІ з PyTorch

Від Trainer до Accelerator

Діаграма порівнює простоту використання і можливість налаштування для Accelerator та Trainer.

Ефективне тренування моделей ШІ з PyTorch

Чекпойнтинг градієнтів із Accelerator

accelerator = Accelerator(gradient_accumulation_steps=2)


for index, batch in enumerate(dataloader):
    with accelerator.accumulate(model):
        inputs, targets = batch["input_ids"], batch["labels"]
        outputs = model(inputs, labels=targets)
        loss = outputs.loss
        accelerator.backward(loss)
        optimizer.step()
        lr_scheduler.step()
        optimizer.zero_grad()
Ефективне тренування моделей ШІ з PyTorch

Чекпойнтинг градієнтів із Accelerator

accelerator = Accelerator(gradient_accumulation_steps=2)
model.gradient_checkpointing_enable()

for index, batch in enumerate(dataloader):
    with accelerator.accumulate(model):
        inputs, targets = batch["input_ids"], batch["labels"]
        outputs = model(inputs, labels=targets)
        loss = outputs.loss
        accelerator.backward(loss)
        optimizer.step()
        lr_scheduler.step()
        optimizer.zero_grad()
Ефективне тренування моделей ШІ з PyTorch

Локальний SGD підвищує ефективність комунікацій


Піктограми, що позначають ефективність памʼяті, комунікацій та обчислень.

Ефективне тренування моделей ШІ з PyTorch

Що таке локальний SGD?

Діаграма, що показує синхронізацію градієнтів після певної кількості кроків у local SGD.

  • Кожен пристрій обчислює градієнти паралельно
Ефективне тренування моделей ШІ з PyTorch

Що таке локальний SGD?

Діаграма, що показує синхронізацію градієнтів після певної кількості кроків у local SGD.

  • Кожен пристрій обчислює градієнти паралельно
  • Синхронізація градієнтів: вузол-драйвер оновлює параметри моделі на кожному пристрої
  • Локальний SGD: зменшити частоту синхронізації градієнтів
Ефективне тренування моделей ШІ з PyTorch

Локальний SGD із Accelerator


for index, batch in enumerate(dataloader):
    with accelerator.accumulate(model):
        inputs, targets = batch["input_ids"], batch["labels"]
        outputs = model(inputs, labels=targets)
        loss = outputs.loss
        accelerator.backward(loss)
        optimizer.step()
        lr_scheduler.step()
        optimizer.zero_grad()

Ефективне тренування моделей ШІ з PyTorch

Локальний SGD із Accelerator

from accelerate.local_sgd import LocalSGD

with LocalSGD(accelerator=accelerator, model=model, local_sgd_steps=8, 
              enabled=True) as local_sgd:
    for index, batch in enumerate(dataloader):
        with accelerator.accumulate(model):
            inputs, targets = batch["input_ids"], batch["labels"]
            outputs = model(inputs, labels=targets)
            loss = outputs.loss
            accelerator.backward(loss)
            optimizer.step()
            lr_scheduler.step()
            optimizer.zero_grad()

Ефективне тренування моделей ШІ з PyTorch

Локальний SGD із Accelerator

from accelerate.local_sgd import LocalSGD

with LocalSGD(accelerator=accelerator, model=model, local_sgd_steps=8, 
              enabled=True) as local_sgd:
    for index, batch in enumerate(dataloader):
        with accelerator.accumulate(model):
            inputs, targets = batch["input_ids"], batch["labels"]
            outputs = model(inputs, labels=targets)
            loss = outputs.loss
            accelerator.backward(loss)
            optimizer.step()
            lr_scheduler.step()
            optimizer.zero_grad()
            local_sgd.step()
Ефективне тренування моделей ШІ з PyTorch

Перейдемо до практики!

Ефективне тренування моделей ШІ з PyTorch

Preparing Video For Download...