为训练预处理图像与音频
使用 PyTorch 高效训练 AI 模型

Dennis Lee
Data Engineer, Amazon
准备图像与音频
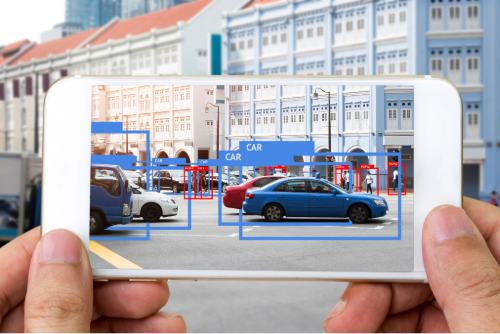
图像应用
- 图像分类识别物体
- 数据分片
音频应用
- 提供语音指令
- 例如:“调低音量”
操作示例图像数据集
print(dataset)
Dataset({
    features: ['img', 'label'],
    num_rows: 1000
})
print(dataset[0]["img"])
<PIL.JpegImagePlugin.JpegImageFile image mode=RGB size=720x480>
标准化图像格式
- 统一图像尺寸:宽、高
- 标准化像素值:均值、标准差
AutoImageProcessor加载全部预处理步骤
from transformers import AutoImageProcessor model = "microsoft/swin-tiny-patch4-window7-224"image_processor = AutoImageProcessor.from_pretrained(model)
标准化图像格式
dataset = dataset.map( lambda examples: {"pixel_values": [image_processor(image, return_tensors="pt").pixel_values for image in examples["img"] ]}, batched=True)print(dataset)
Dataset({
    features: ['img', 'label', 'pixel_values'],
    num_rows: 1000
})
操作示例音频数据集
print(dataset)
DatasetDict({ train: Dataset({features: ['file', 'audio','label'], num_rows: 1000 }), ... })
标准化音频格式
- 统一样本数
- 采样率:每秒采样数
- 最长时长:音频秒数
sampling_rate = 16000 # 16 kHzmax_duration = 1 # 1 secondmax_length = sampling_rate * max_durationprint(f"max_length = {max_length:,} samples")
max_length = 16,000 samples
标准化音频格式
from transformers import AutoFeatureExtractor model = "facebook/wav2vec2-base" feature_extractor = AutoFeatureExtractor.from_pretrained(model)def preprocess_function(split_data):audio_arrays = [x["array"] for x in split_data["audio"]]inputs = feature_extractor(audio_arrays,sampling_rate=feature_extractor.sampling_rate, max_length=int(feature_extractor.sampling_rate * max_duration),truncation=True) return inputs
应用预处理函数
- 将
preprocess_function映射到dataset remove_columns:移除audio与file列batched:批量处理dataset样本
dataset = dataset["train"].map(preprocess_function,remove_columns=["audio", "file"],batched=True)
应用预处理函数
print(dataset)
DatasetDict({
    train: Dataset({
        features: ['label', 'input_values'],
        num_rows: 1000
    })
为分布式训练准备数据
DataLoader:为训练时的数据加载与迭代做准备accelerator.prepare():根据可用性将数据放到 CPU 或 GPU- 数据分片:每个 GPU 处理一部分训练数据,像分披萨一样
accelerator.prepare()适用于 PyTorch DataLoader(torch.utils.data.DataLoader)
from accelerate import Accelerator from torch.utils.data import DataLoader dataloader = DataLoader(dataset, batch_size=32, shuffle=True)accelerator = Accelerator() dataloader = accelerator.prepare(dataloader)
Passons à la pratique !
使用 PyTorch 高效训练 AI 模型

