使用8位Adam的混合精度训练

使用 PyTorch 高效训练 AI 模型

Dennis Lee

Data Engineer, Amazon

提升训练效率的优化器
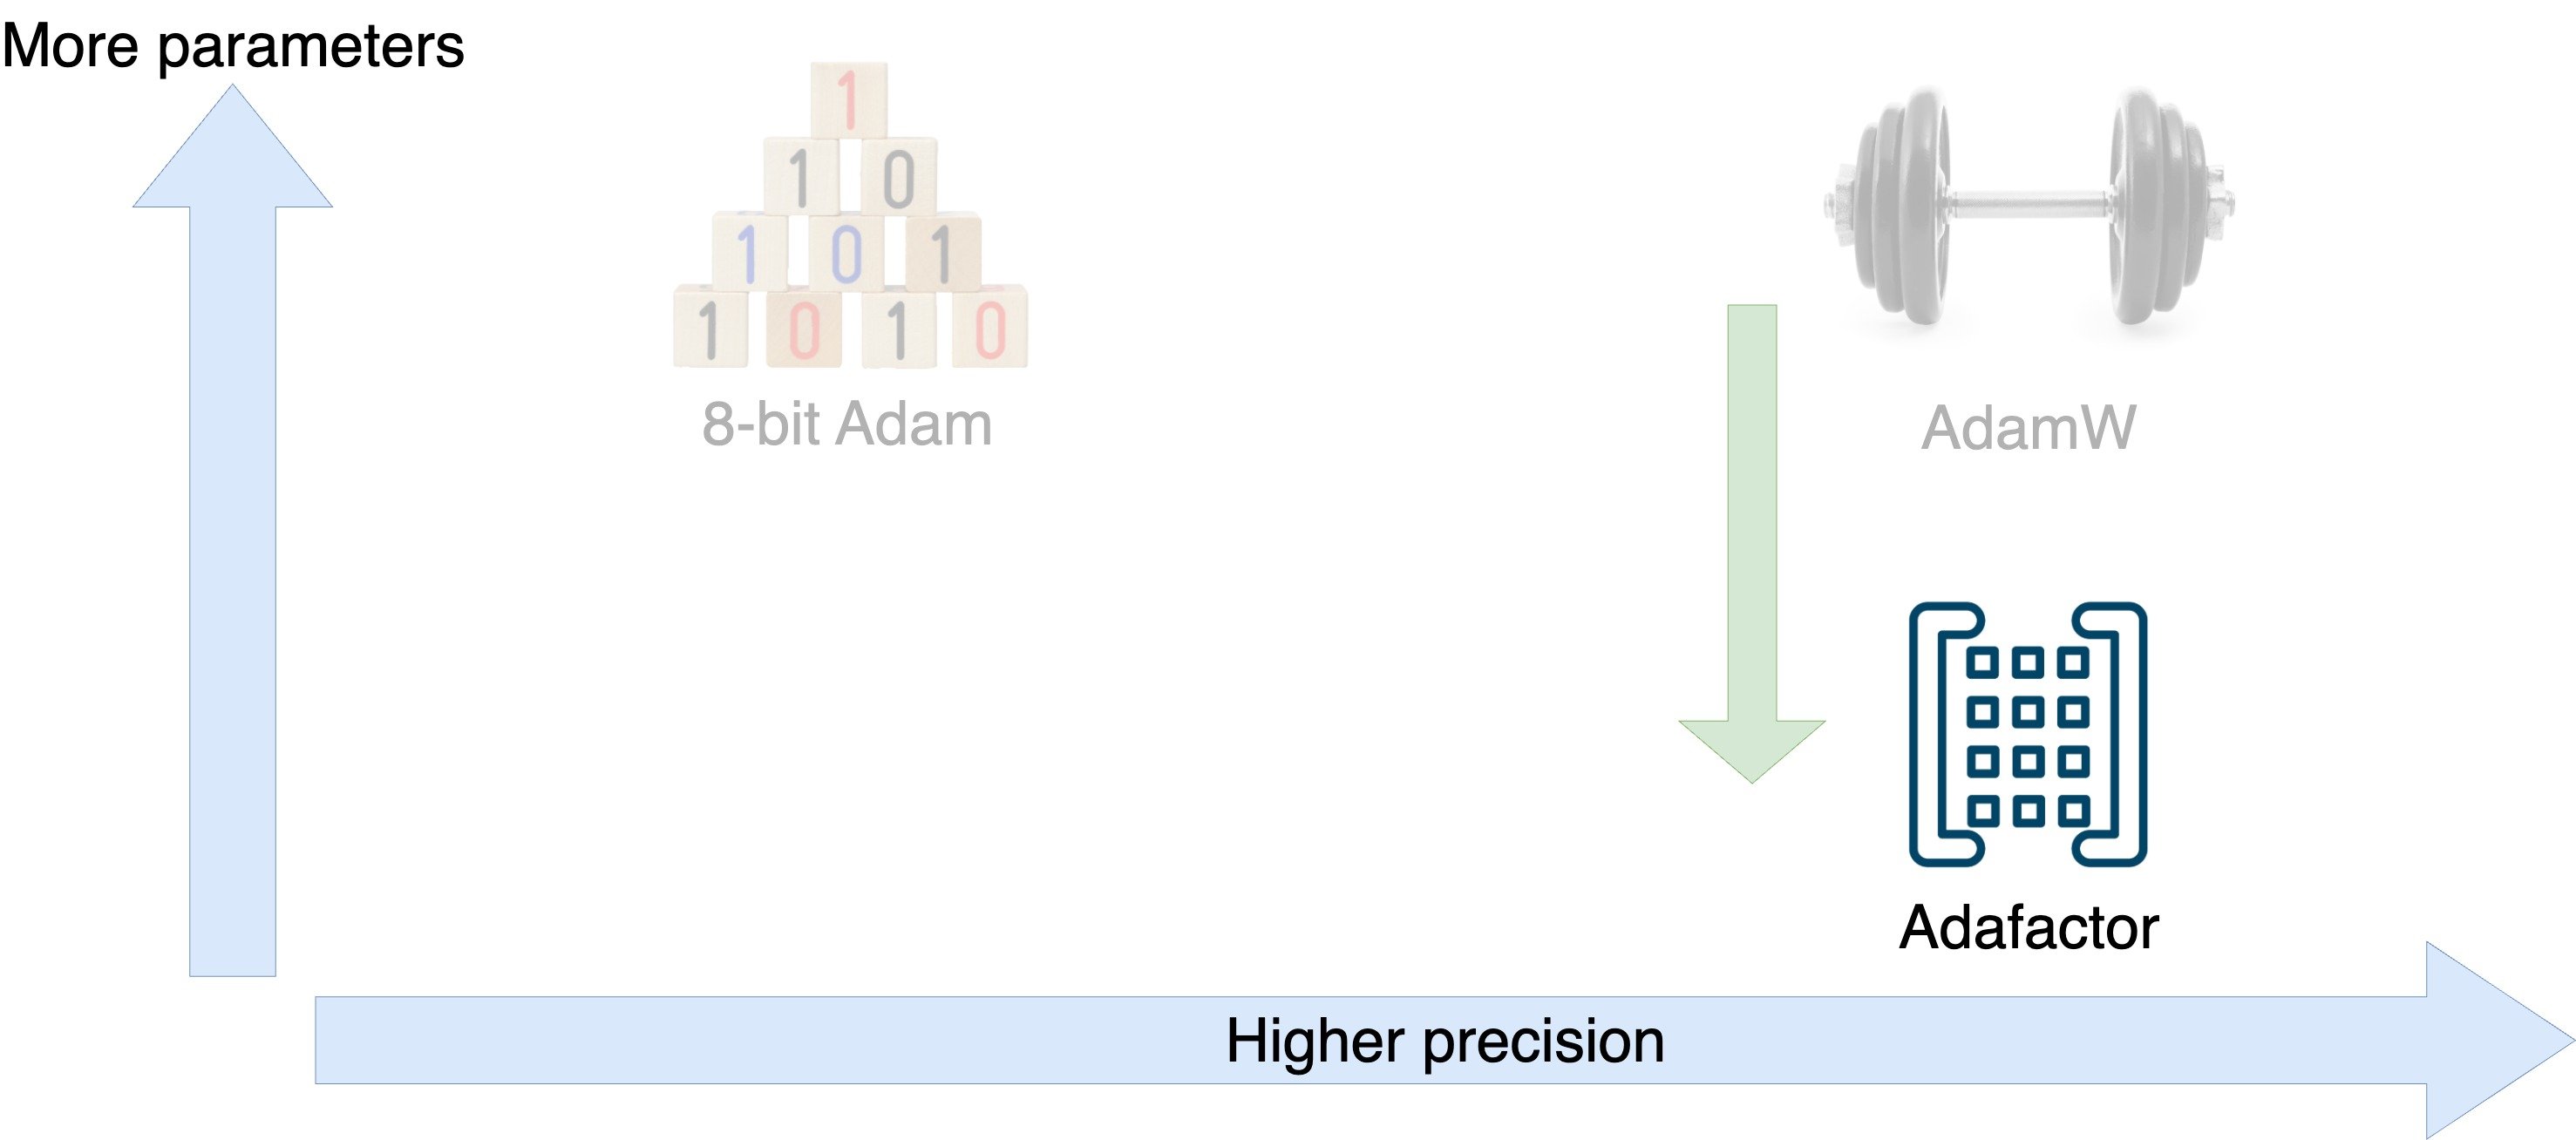
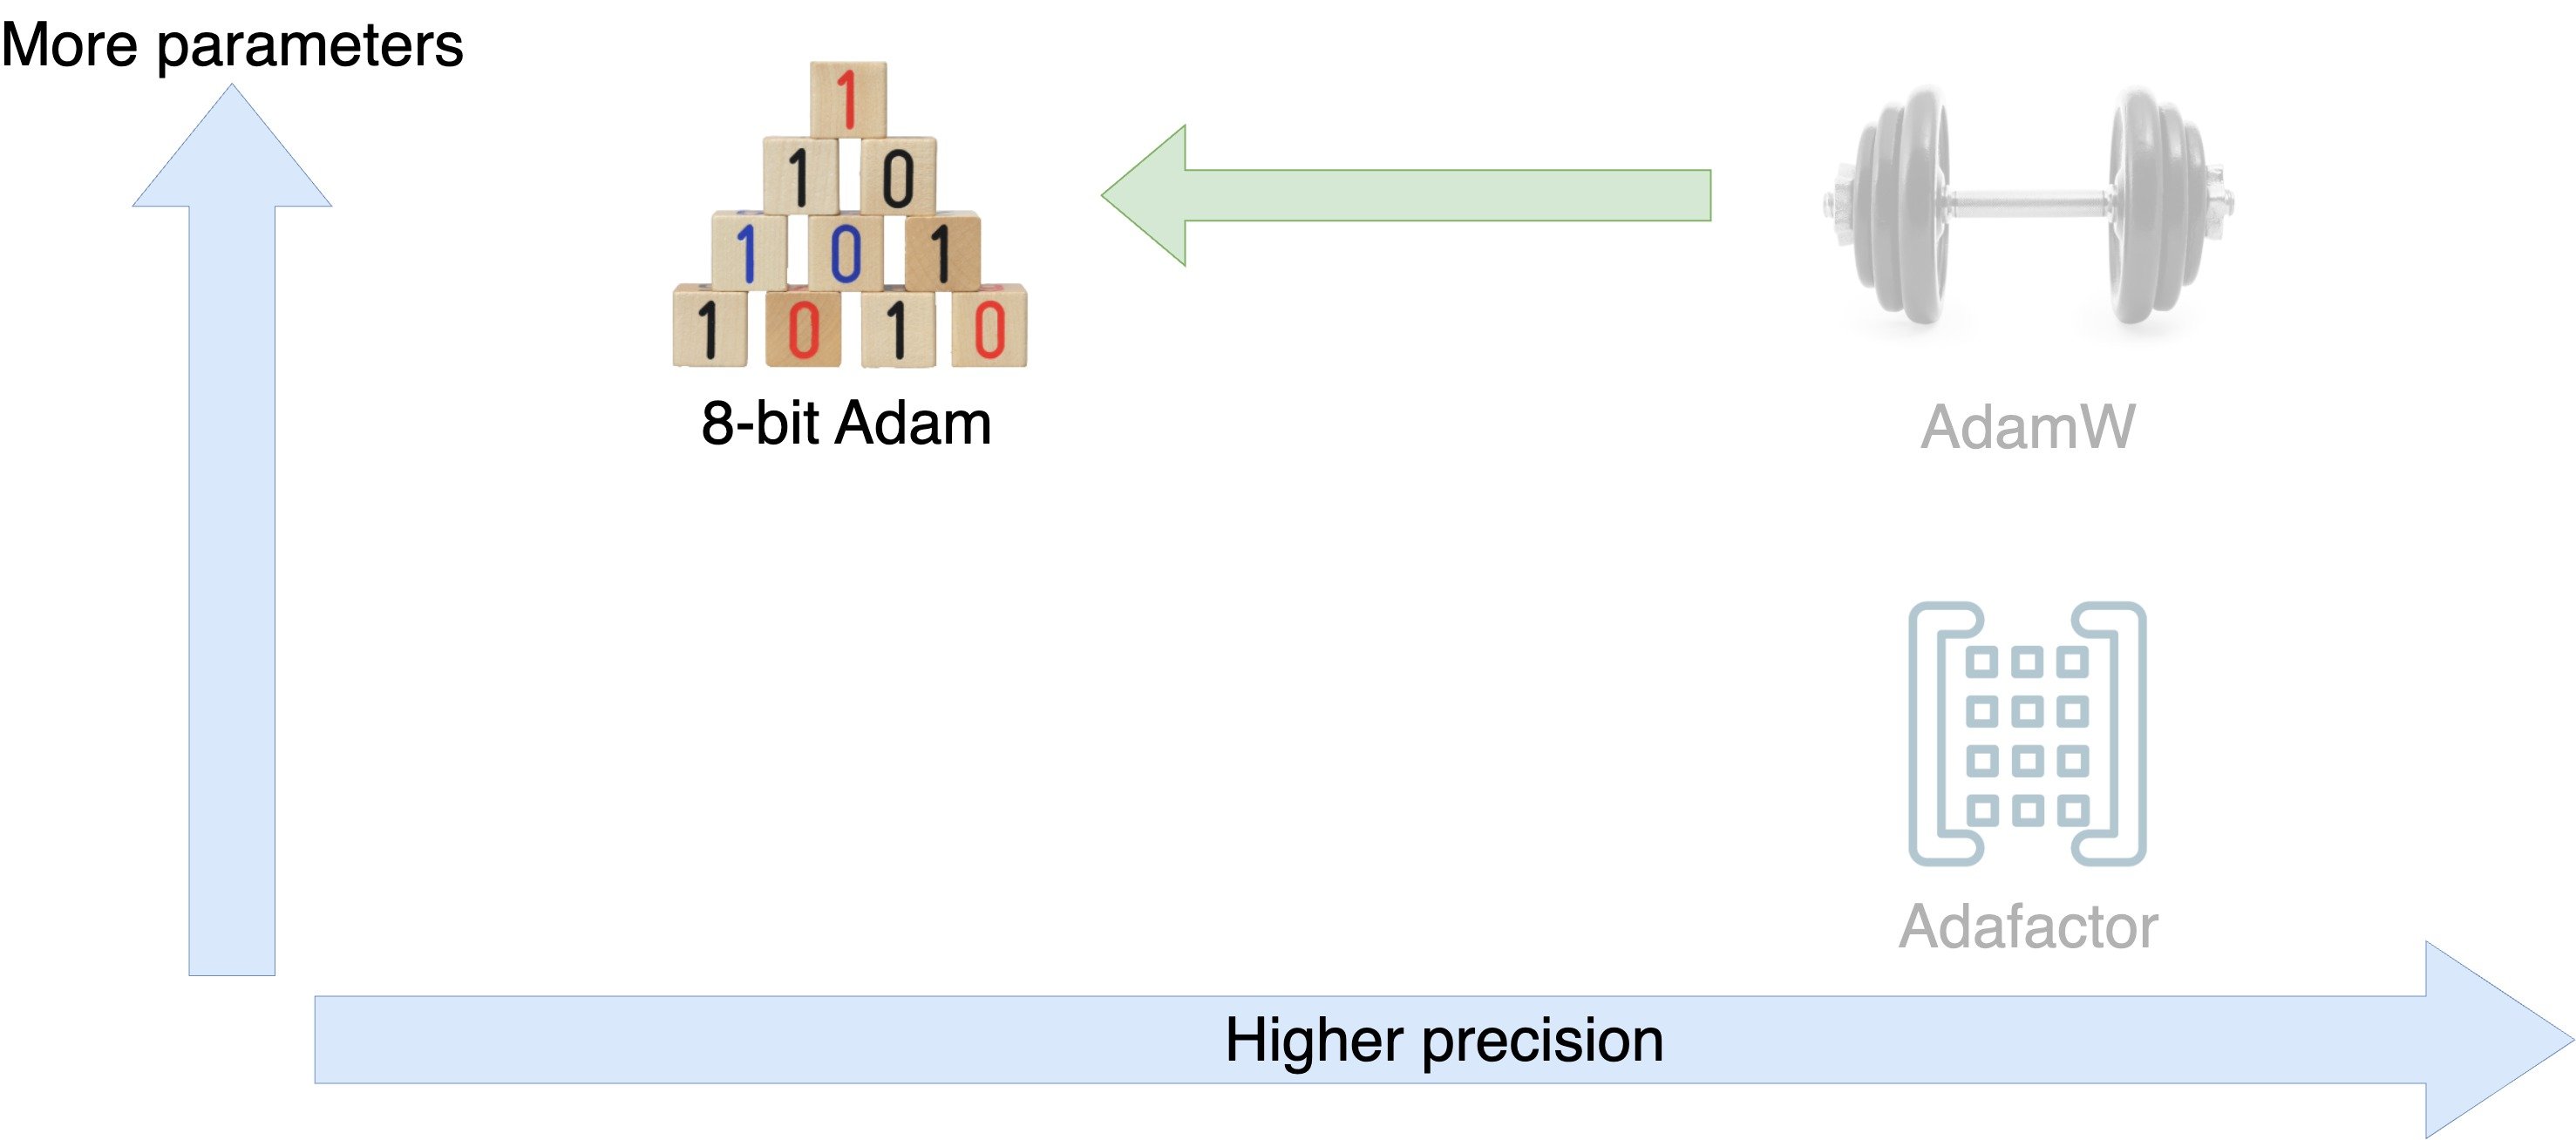
展示 AdamW、Adafactor 与 8位 Adam 在参数量与精度间权衡的示意图。

使用 PyTorch 高效训练 AI 模型

提升训练效率的优化器

展示 AdamW、Adafactor 与 8位 Adam 在参数量与精度间权衡的示意图。

使用 PyTorch 高效训练 AI 模型

8位 Adam 如何工作?

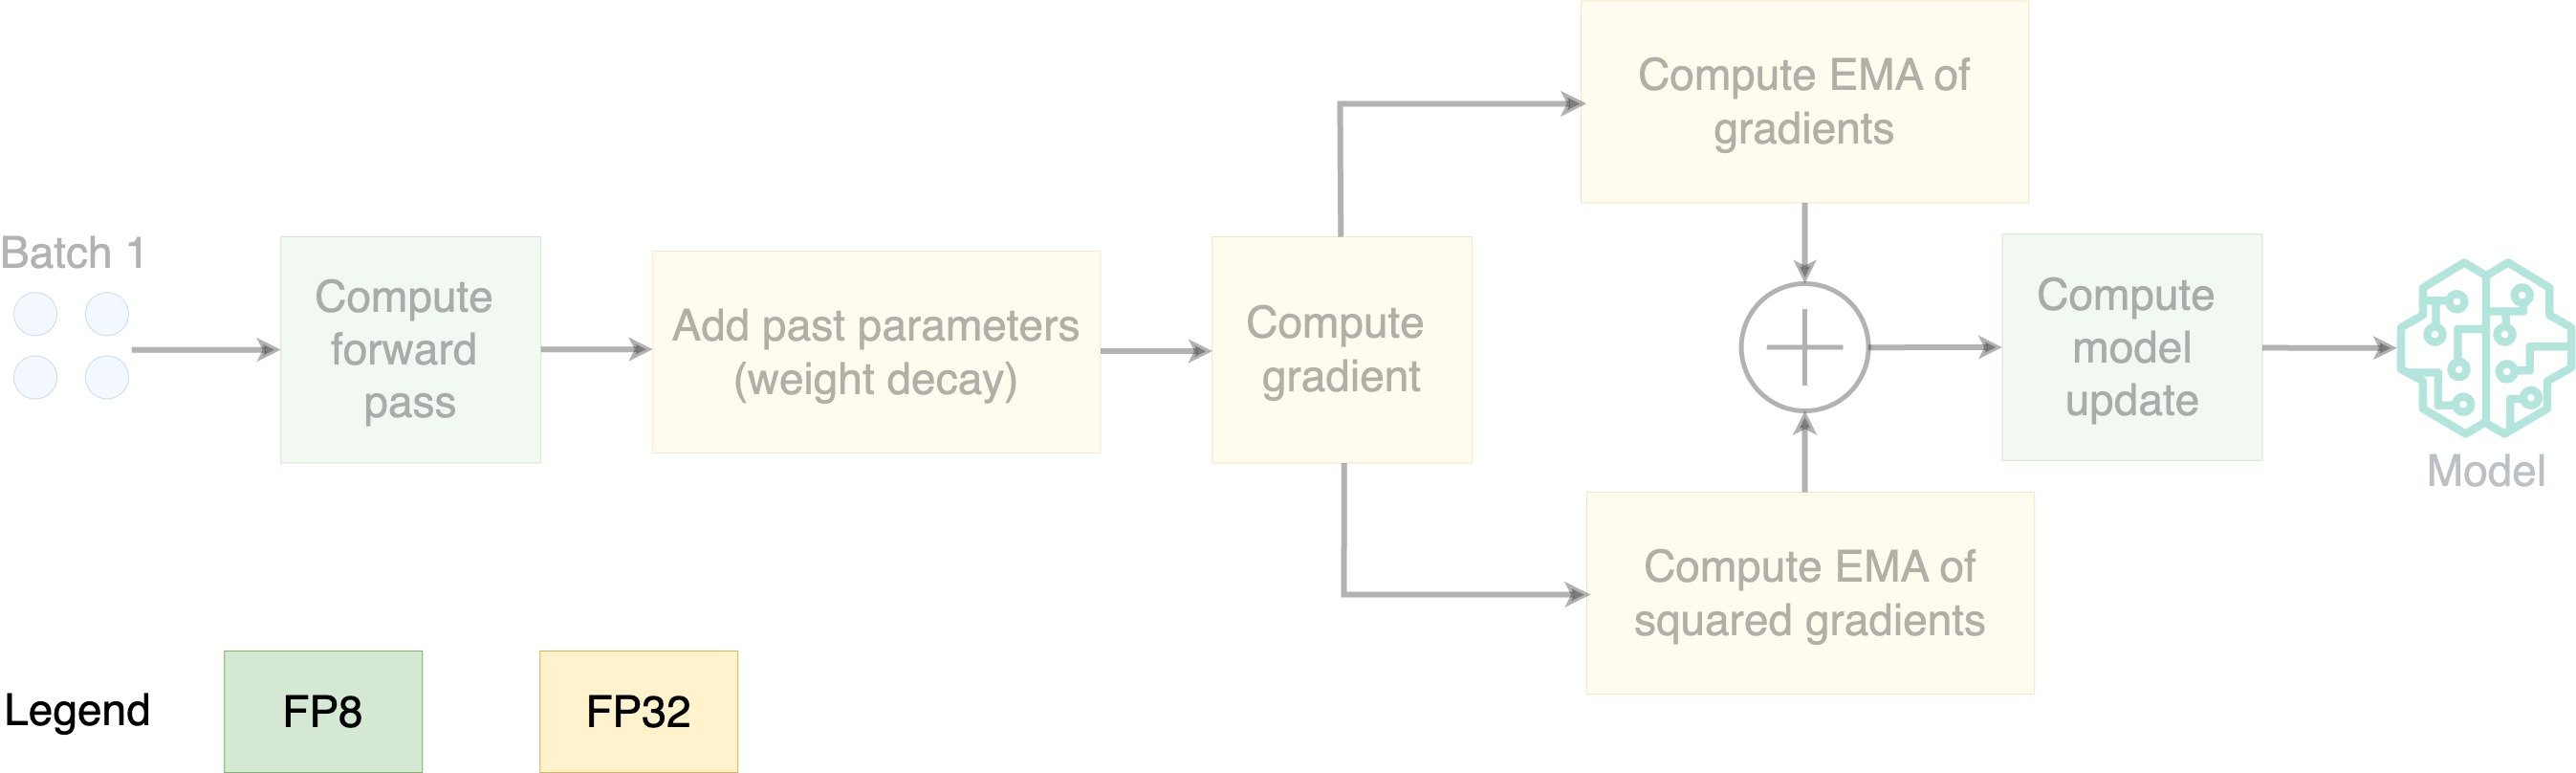
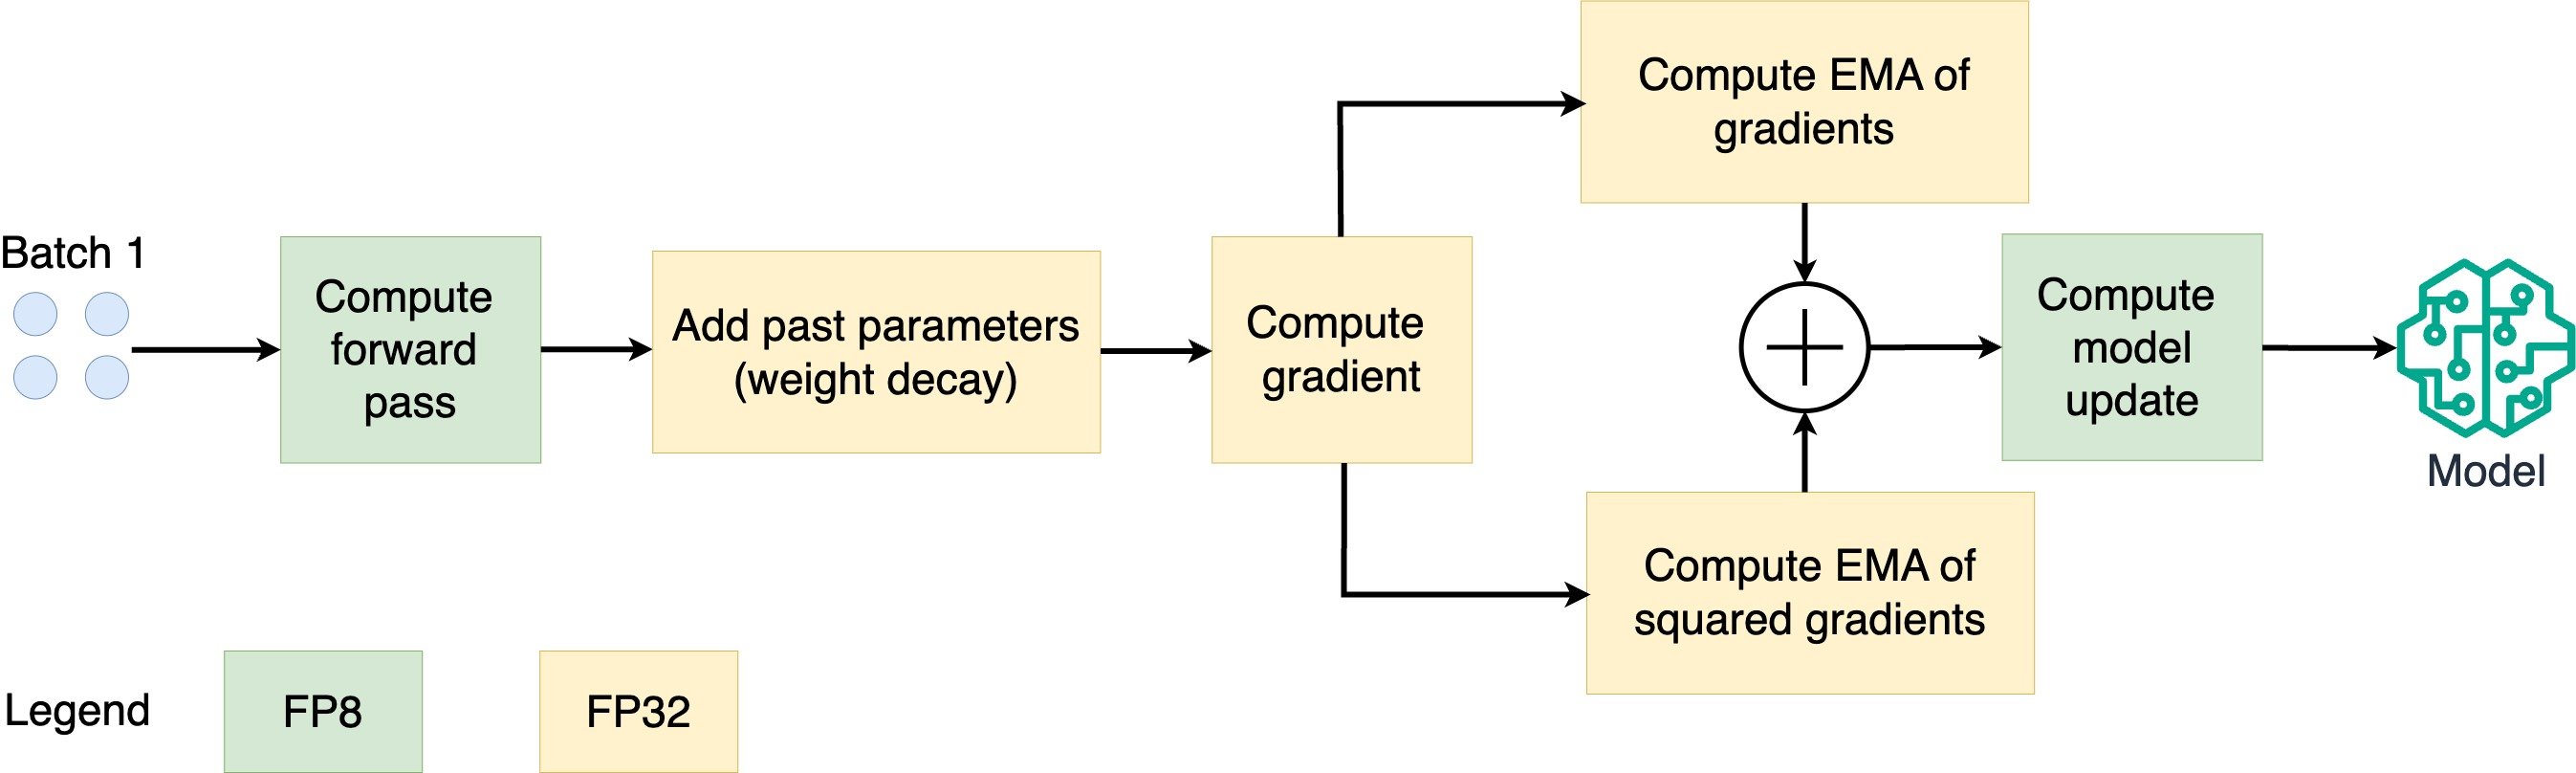
展示8位 Adam 步骤的示意图。

  • 参数用 FP8 存储;用 FP32 优化
使用 PyTorch 高效训练 AI 模型

8位 Adam 如何工作?

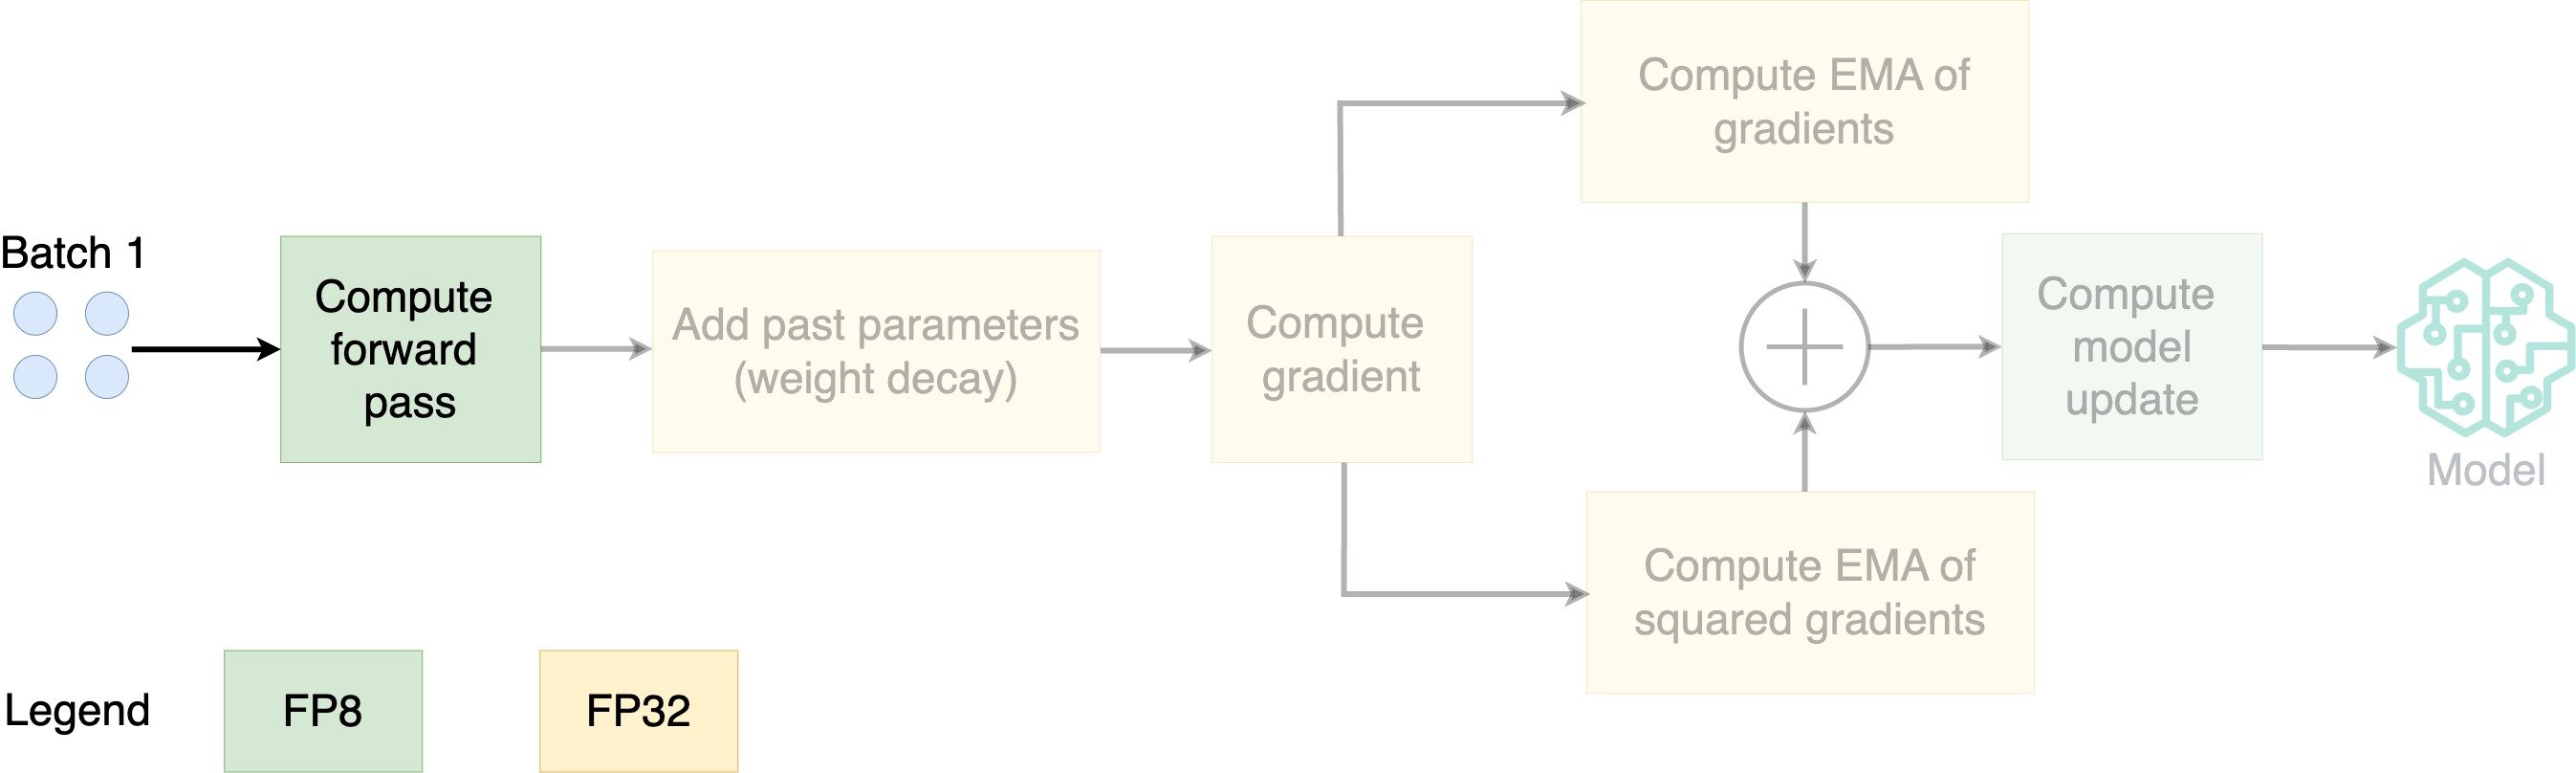
展示8位 Adam 步骤的示意图。

  • 参数用 FP8 存储;用 FP32 优化
使用 PyTorch 高效训练 AI 模型

8位 Adam 如何工作?

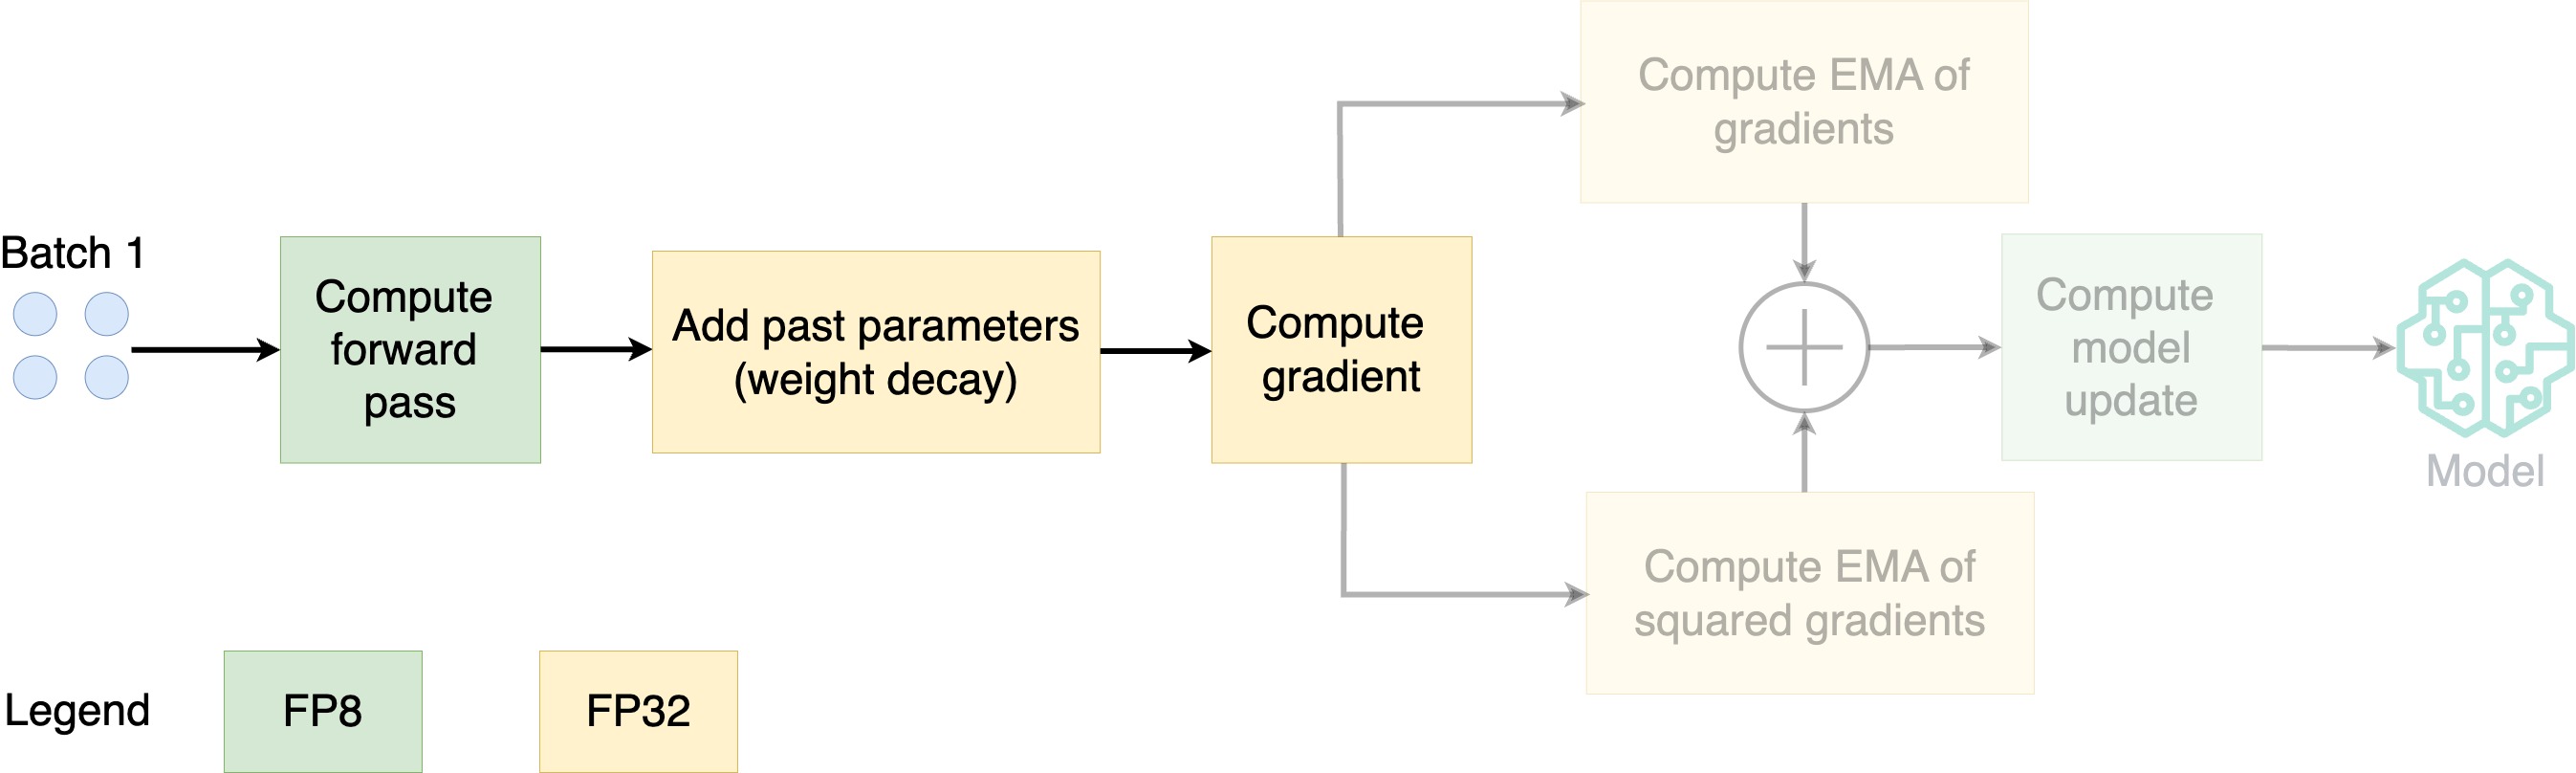
展示8位 Adam 步骤的示意图。

  • 参数用 FP8 存储;用 FP32 优化
使用 PyTorch 高效训练 AI 模型

8位 Adam 如何工作?

展示8位 Adam 步骤的示意图。

  • 参数用 FP8 存储;用 FP32 优化
  • EMA:指数移动平均
  • 计算梯度及其平方的 EMA
使用 PyTorch 高效训练 AI 模型

8位 Adam 如何工作?

展示8位 Adam 步骤的示意图。

  • 参数用 FP8 存储;用 FP32 优化
  • EMA:指数移动平均
  • 计算梯度及其平方的 EMA
使用 PyTorch 高效训练 AI 模型

8位 Adam 如何节省内存?

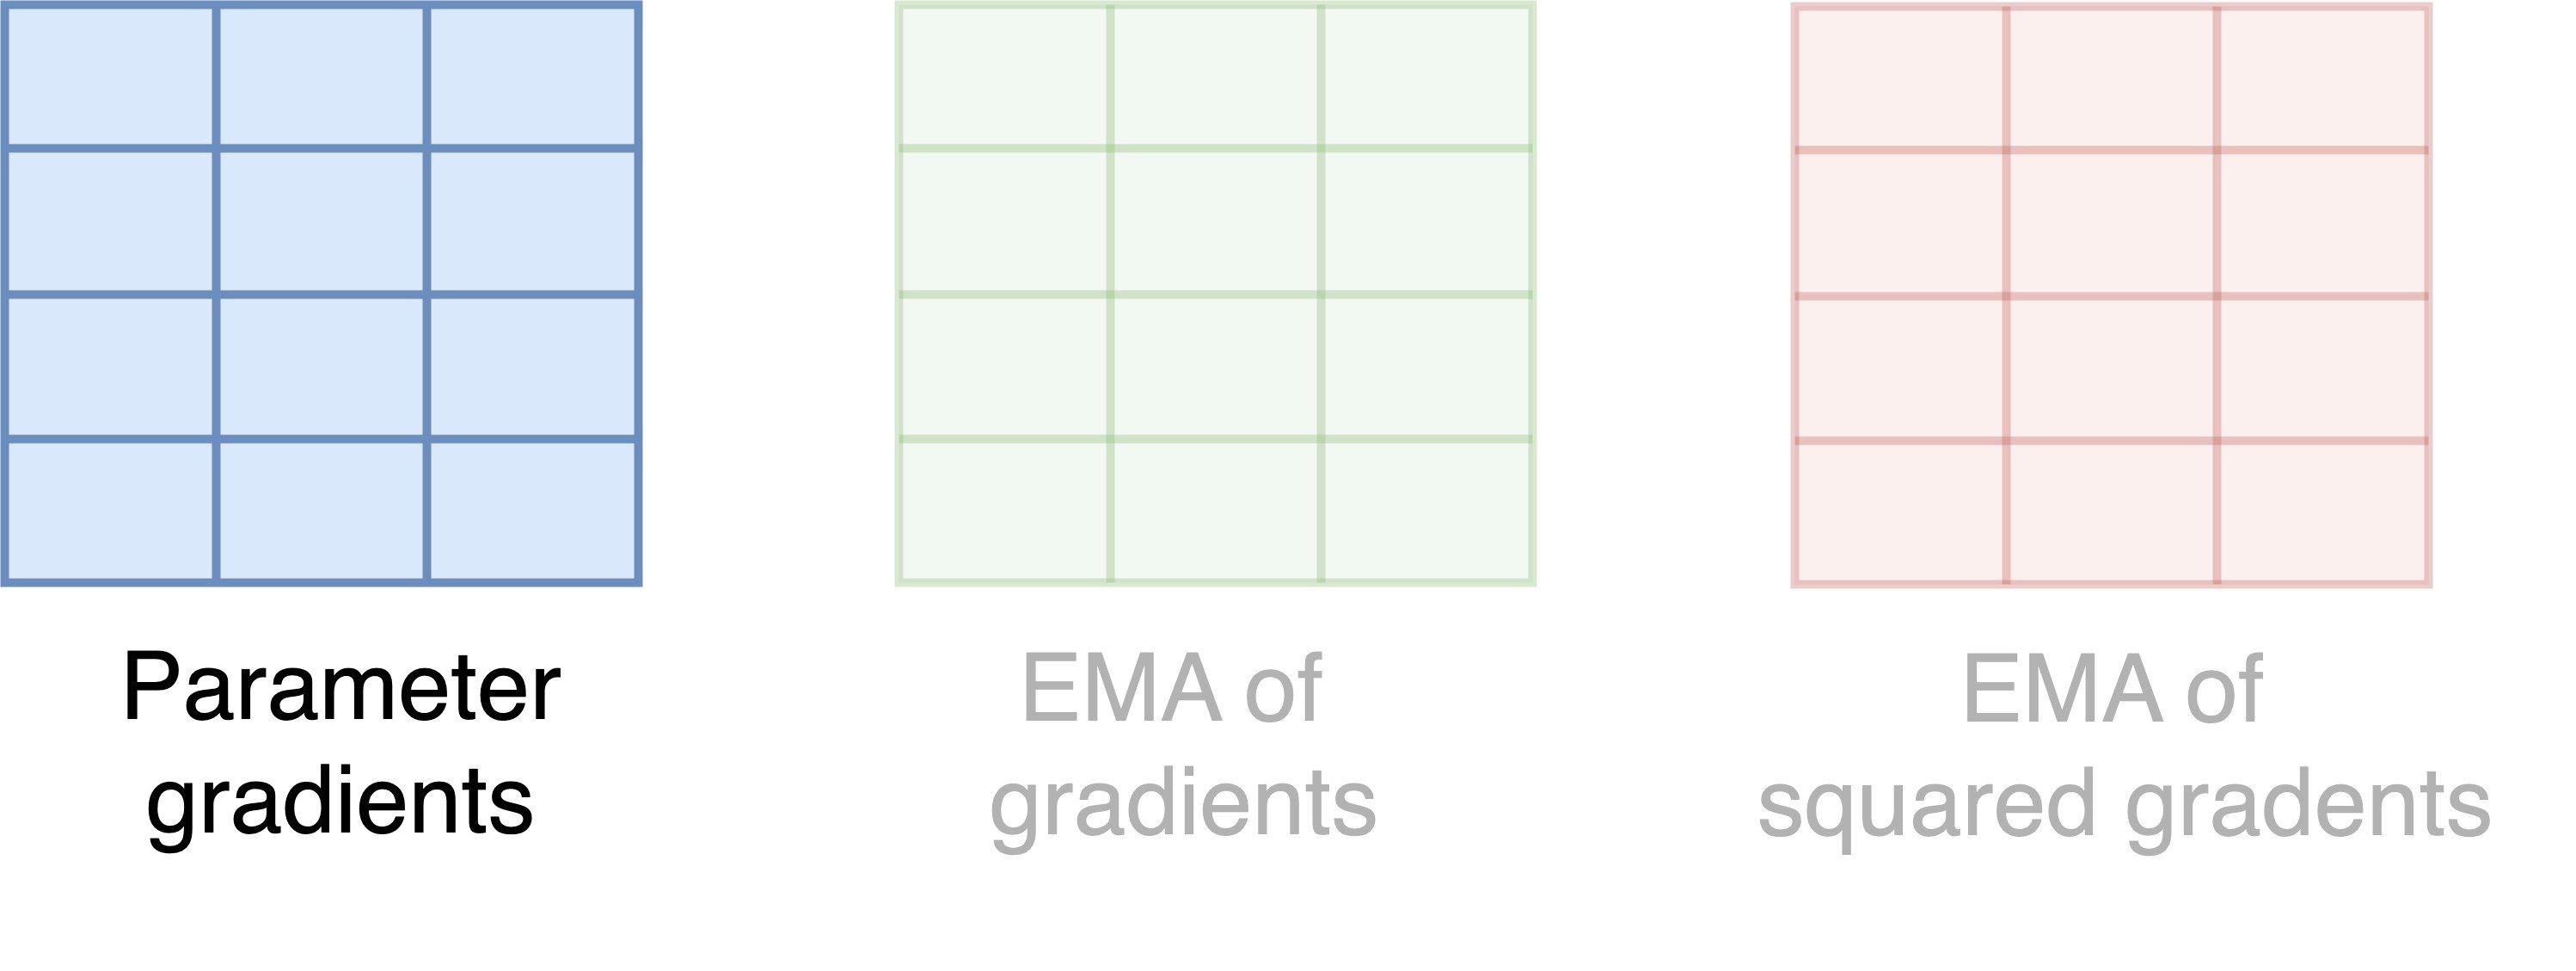
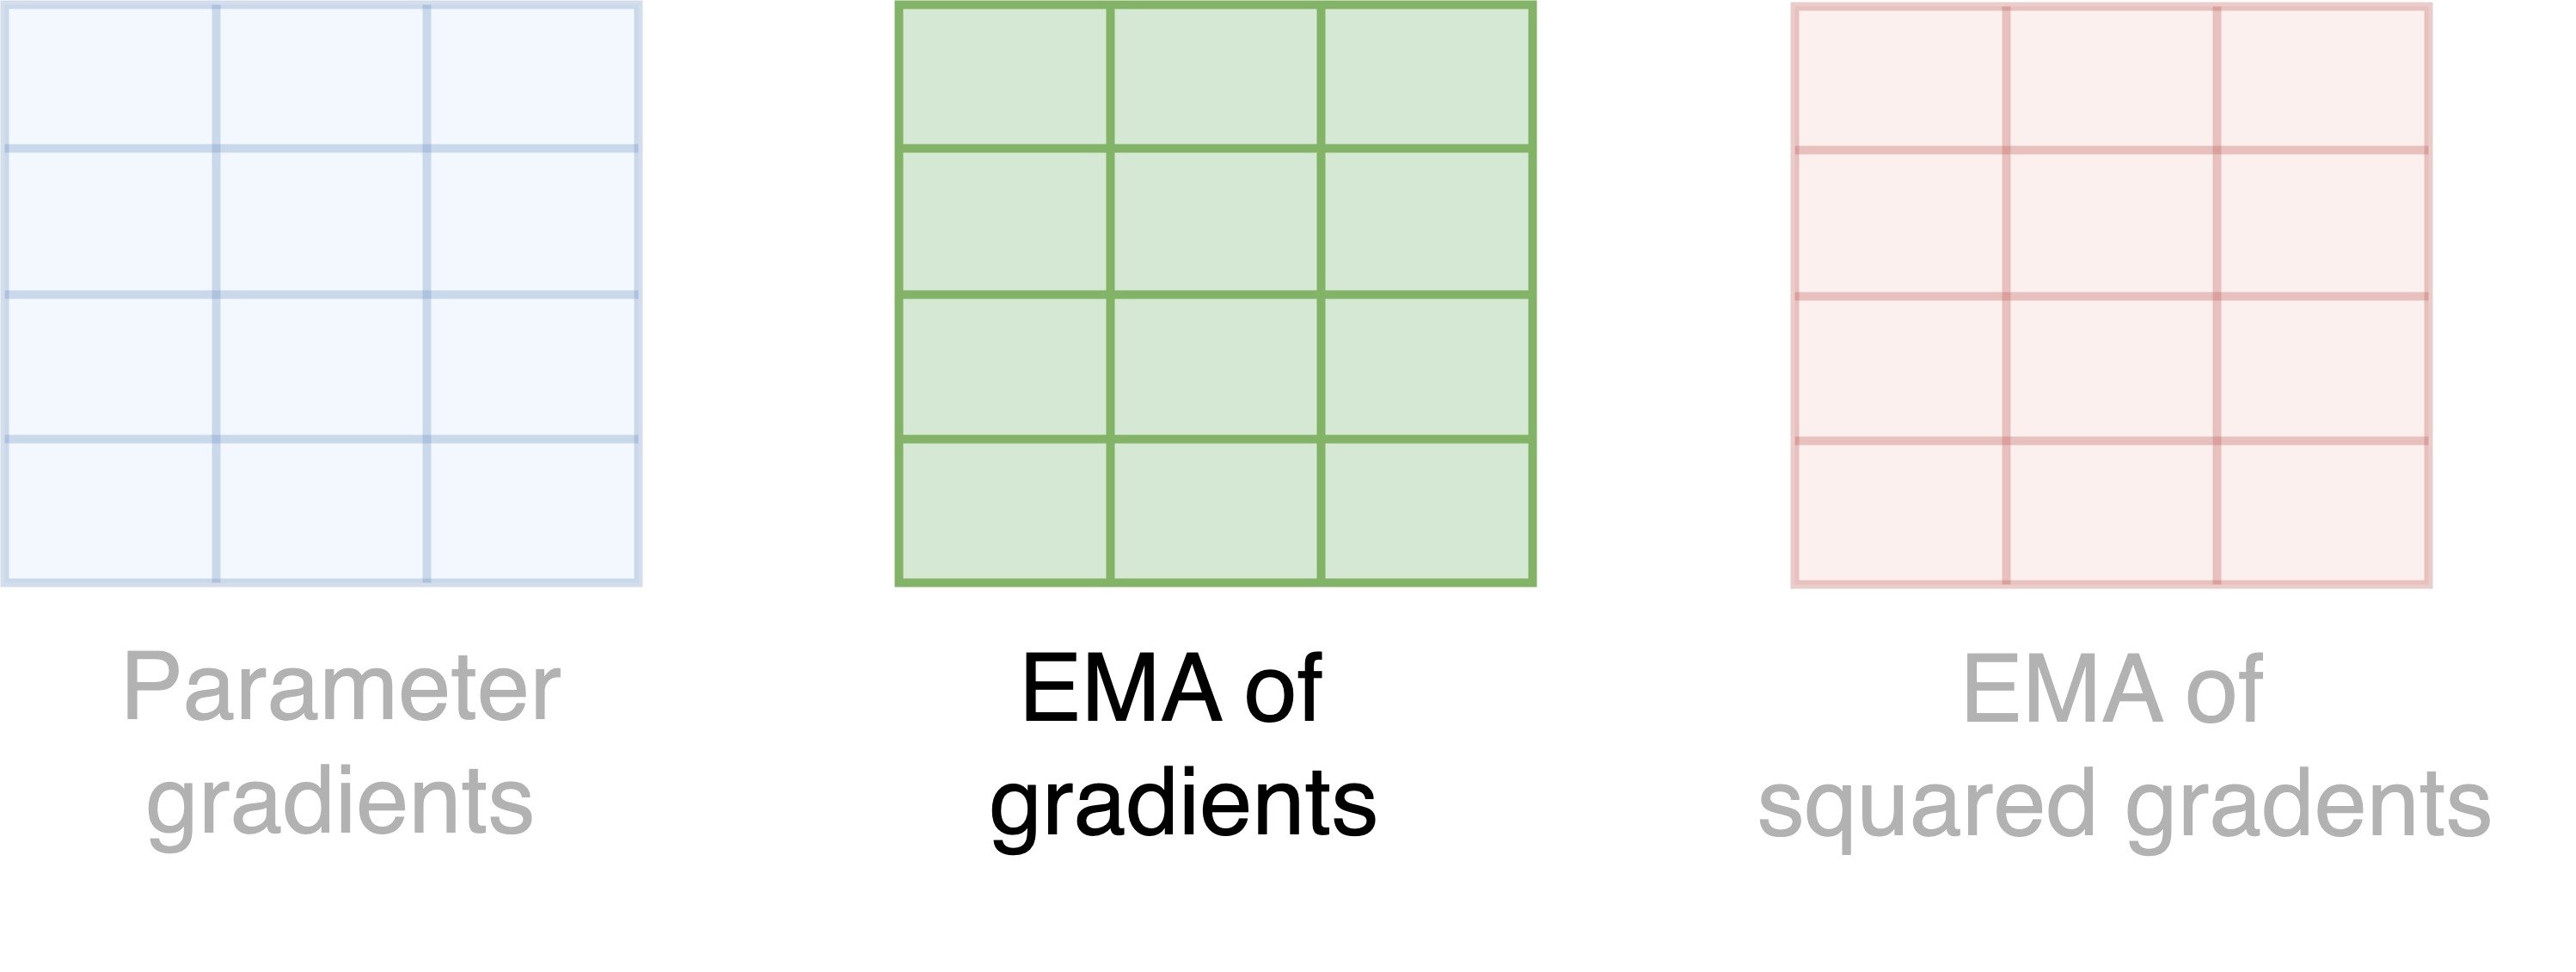
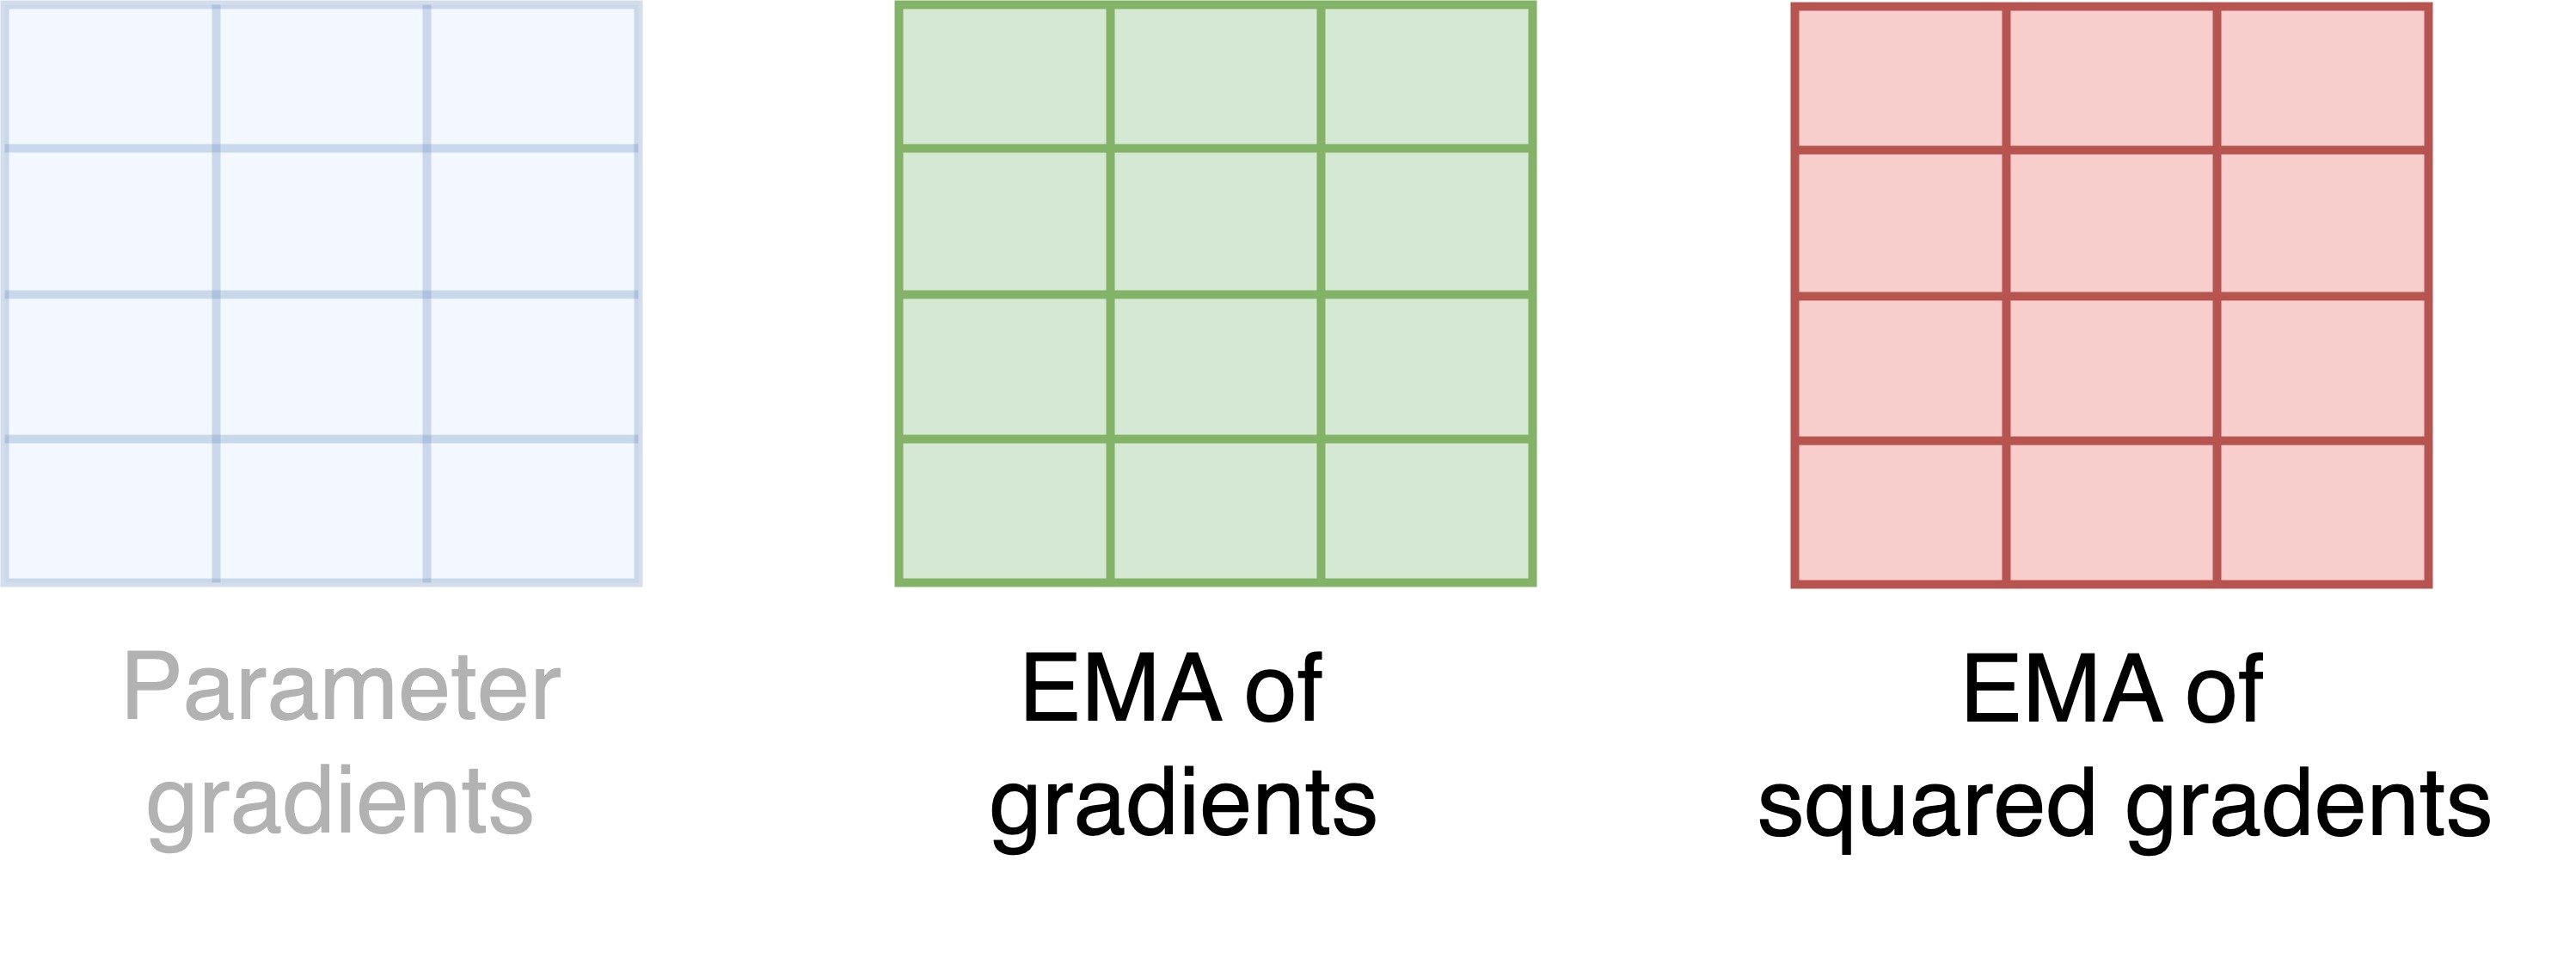
展示参数梯度、梯度的 EMA 和平方梯度的 EMA 的示意图。

使用 PyTorch 高效训练 AI 模型

8位 Adam 如何节省内存?

展示参数梯度、梯度的 EMA 和平方梯度的 EMA 的示意图。

使用 PyTorch 高效训练 AI 模型

8位 Adam 如何节省内存?

展示参数梯度、梯度的 EMA 和平方梯度的 EMA 的示意图。

  • 每个小方块代表一个参数,每种颜色代表一种状态
  • 每个参数的内存 = 2 字节 = 每状态 1 字节 × 2 个状态
  • 总内存 = 每参数内存(2 字节)× 参数数量
使用 PyTorch 高效训练 AI 模型

估算 8位 Adam 的内存占用

model = AutoModelForSequenceClassification.from_pretrained(
    "distilbert-base-cased", return_dict=True)
num_parameters = sum(p.numel() for p in model.parameters())
print(f"Number of model parameters: {num_parameters:,}")
Number of model parameters: 65,783,042
estimated_memory = num_parameters * 2 / (1024 ** 2)
print(f"Estimated memory usage of 8-bit Adam: {estimated_memory:.0f} MB")
Estimated memory usage of 8-bit Adam: 125 MB
使用 PyTorch 高效训练 AI 模型

设置 8位 Adam 优化器

import bitsandbytes as bnb
from torch import nn
from transformers.trainer_pt_utils import get_parameter_names


args = TrainingArguments(output_dir="./results")
decay_parameters = get_parameter_names(model, [nn.LayerNorm])
decay_parameters = [name for name in decay_parameters if "bias" not in name]
  • 权重衰减可防止过拟合
  • decay_parameters:指定应用权重衰减的参数
  • get_parameter_names:返回参数名;忽略 nn.LayerNorm
  • decay_parameters 中移除 bias 参数
  • 归一化层与偏置不应用权重衰减
使用 PyTorch 高效训练 AI 模型

设置 8位 Adam 优化器

optimizer_grouped_parameters = [{"params": [p for n, p in model.named_parameters() 
                                            if n in decay_parameters],
                                 "weight_decay": args.weight_decay},

{"params": [p for n, p in model.named_parameters() if n not in decay_parameters], "weight_decay": 0.0}]
adam_bnb_optim = bnb.optim.Adam8bit(optimizer_grouped_parameters,
betas=(args.adam_beta1, args.adam_beta2),
eps=args.adam_epsilon,
lr=args.learning_rate)
  • optimizer_grouped_parameters:一组应用权重衰减,另一组不应用
  • beta1beta2:一阶与二阶矩衰减率;越大越稳但训练更慢
使用 PyTorch 高效训练 AI 模型

用 Trainer 实现 8位 Adam

trainer = Trainer(model=model,
                  args=training_args,
                  train_dataset=train_dataset,
                  eval_dataset=validation_dataset,
                  optimizers=(adam_bnb_optim, None),
                  compute_metrics=compute_metrics)

trainer.train()
{'epoch': 1.0, 'eval_loss': 0.63, 'eval_accuracy': 0.67, 'eval_f1': 0.62}
{'epoch': 2.0, 'eval_loss': 0.61, 'eval_accuracy': 0.71, 'eval_f1': 0.66}
使用 PyTorch 高效训练 AI 模型

用 Accelerator 实现 8位 Adam

model, adam_bnb_optim, train_dataloader, lr_scheduler = \
    accelerator.prepare(model, adam_bnb_optim, train_dataloader, lr_scheduler)


for batch in train_dataloader: inputs, targets = batch["input_ids"], batch["labels"] outputs = model(inputs, labels=targets) loss = outputs.loss accelerator.backward(loss) adam_bnb_optim.step() lr_scheduler.step() adam_bnb_optim.zero_grad() print(f"Loss = {loss}")
Loss = 0.75
使用 PyTorch 高效训练 AI 模型

计算 8位 Adam 的内存占用

total_size_megabytes, total_num_elements = \
    compute_optimizer_size(trainer.optimizer.state.values())
print(f"Number of 8-bit Adam parameters: {total_num_elements:,}")
print(f"8-bit Adam size: {total_size_megabytes:.0f} MB")
Number of 8-bit Adam parameters: 131,566,188
8-bit Adam size: 128 MB
  • 与 AdamW 对比:8位 Adam 仅用四分之一内存
Number of AdamW parameters: 131,566,188
AdamW size: 502 MB
使用 PyTorch 高效训练 AI 模型

Passons à la pratique !

使用 PyTorch 高效训练 AI 模型

Preparing Video For Download...