梯度检查点与本地 SGD

使用 PyTorch 高效训练 AI 模型

Dennis Lee

Data Engineer, Amazon

提升训练效率


表示内存效率、通信效率和计算效率的图标。

使用 PyTorch 高效训练 AI 模型

梯度检查点提升内存效率


表示内存效率、通信效率和计算效率的图标。

使用 PyTorch 高效训练 AI 模型

本地 SGD 关注通信效率


表示内存效率、通信效率和计算效率的图标。

使用 PyTorch 高效训练 AI 模型

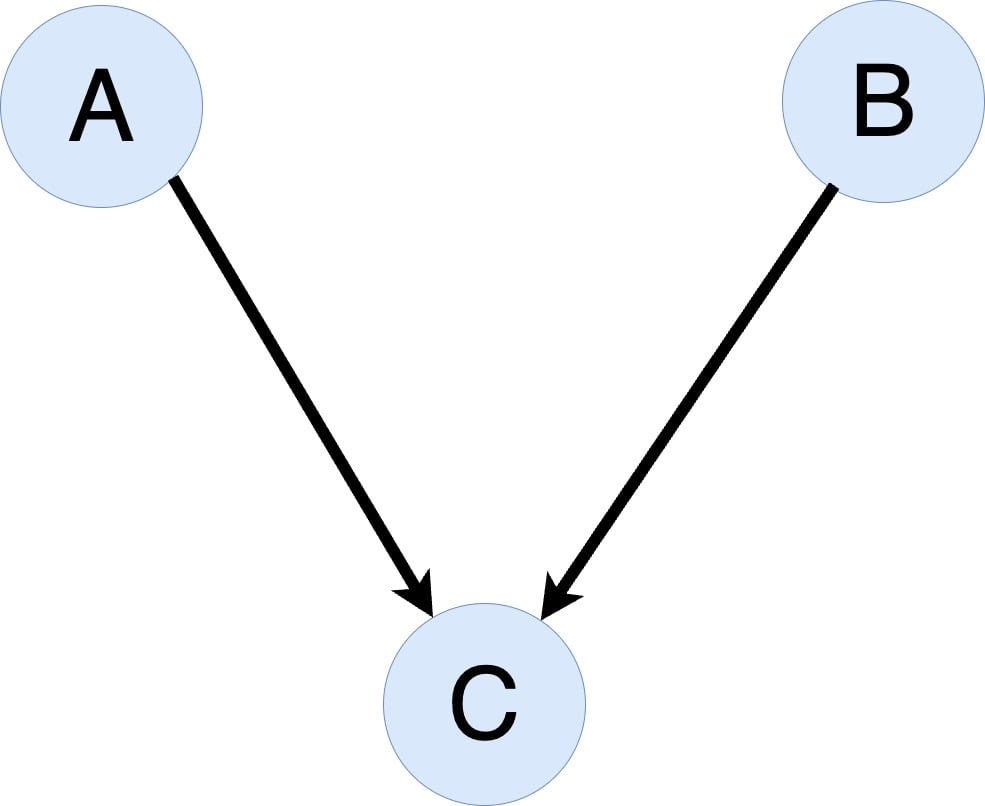
什么是梯度检查点?

  • 梯度检查点:通过选择性保留激活来降低内存
  • 例:计算 A + B = C

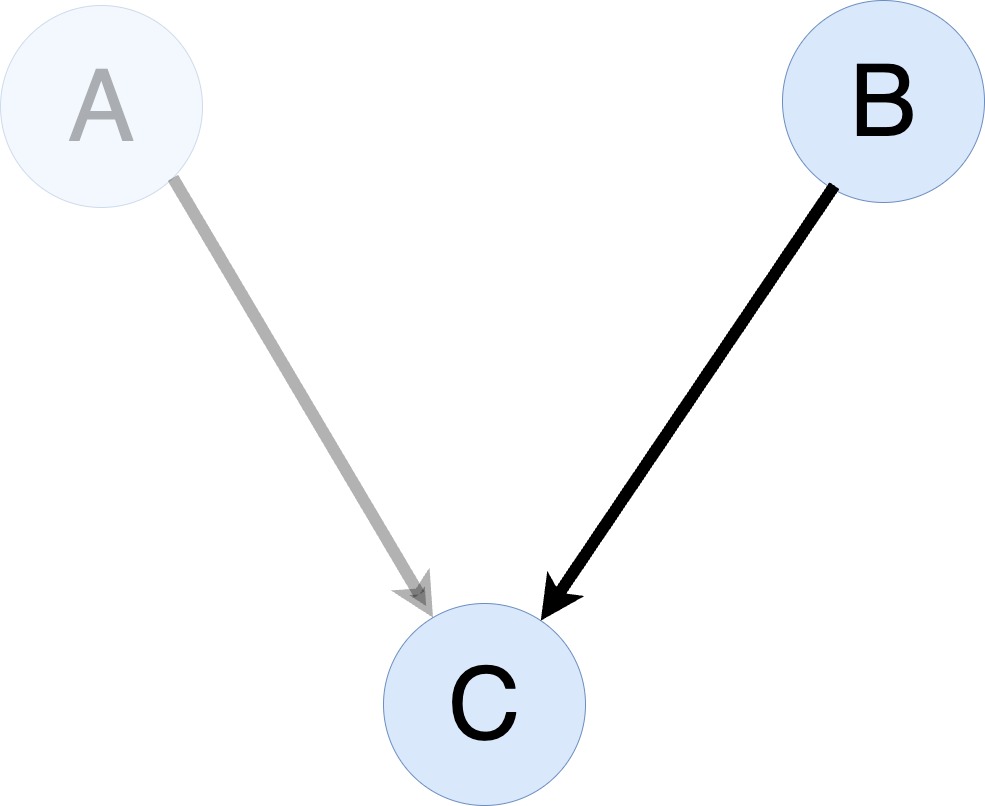
展示含节点与边的梯度检查点示意图

使用 PyTorch 高效训练 AI 模型

什么是梯度检查点?

  • 梯度检查点:通过选择性保留激活来降低内存
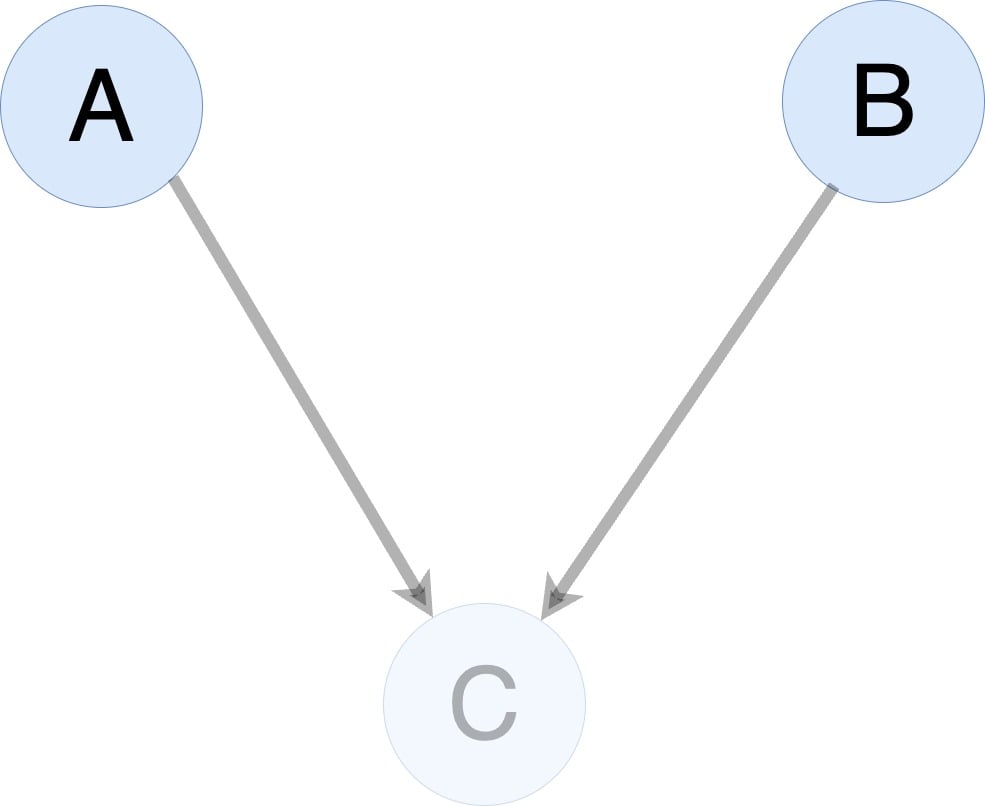
  • 例:计算 A + B = C
    • 先算 A、B,再算 C

展示含节点与边的梯度检查点示意图

使用 PyTorch 高效训练 AI 模型

什么是梯度检查点?

  • 梯度检查点:通过选择性保留激活来降低内存
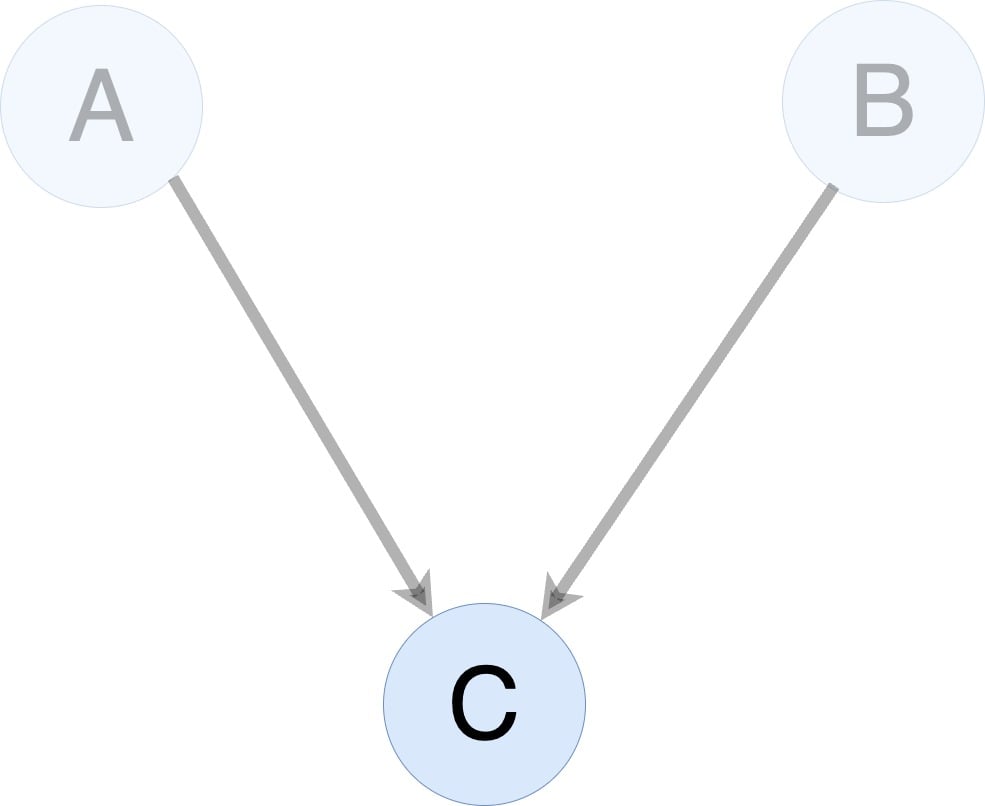
  • 例:计算 A + B = C
    • 先算 A、B,再算 C
    • 后续前向传播不再需要 A、B
  • 我们应保存还是丢弃 A、B?

展示含节点与边的梯度检查点示意图

使用 PyTorch 高效训练 AI 模型

什么是梯度检查点?

  • 梯度检查点:通过选择性保留激活来降低内存
  • 例:计算 A + B = C
    • 先算 A、B,再算 C
    • 后续前向传播不再需要 A、B
  • 我们应保存还是丢弃 A、B?
    • 不用梯度检查点:保存 A、B

展示含节点与边的梯度检查点示意图

使用 PyTorch 高效训练 AI 模型

什么是梯度检查点?

  • 梯度检查点:通过选择性保留激活来降低内存
  • 例:计算 A + B = C
    • 先算 A、B,再算 C
    • 后续前向传播不再需要 A、B
  • 我们应保存还是丢弃 A、B?
    • 不用梯度检查点:保存 A、B
    • 用梯度检查点:丢弃 A、B

展示含节点与边的梯度检查点示意图

使用 PyTorch 高效训练 AI 模型

什么是梯度检查点?

  • 梯度检查点:通过选择性保留激活来降低内存
  • 例:计算 A + B = C
    • 先算 A、B,再算 C
    • 后续前向传播不再需要 A、B
  • 我们应保存还是丢弃 A、B?
    • 不用梯度检查点:保存 A、B
    • 用梯度检查点:丢弃 A、B
    • 反向传播时再重算 A、B

展示含节点与边的梯度检查点示意图

使用 PyTorch 高效训练 AI 模型

什么是梯度检查点?

  • 梯度检查点:通过选择性保留激活来降低内存
  • 例:计算 A + B = C
    • 先算 A、B,再算 C
    • 后续前向传播不再需要 A、B
  • 我们应保存还是丢弃 A、B?
    • 不用梯度检查点:保存 A、B
    • 用梯度检查点:丢弃 A、B
    • 反向传播时再重算 A、B
    • 若 B 重算代价高,则保存 B

展示含节点与边的梯度检查点示意图

使用 PyTorch 高效训练 AI 模型

Trainer 与 Accelerator

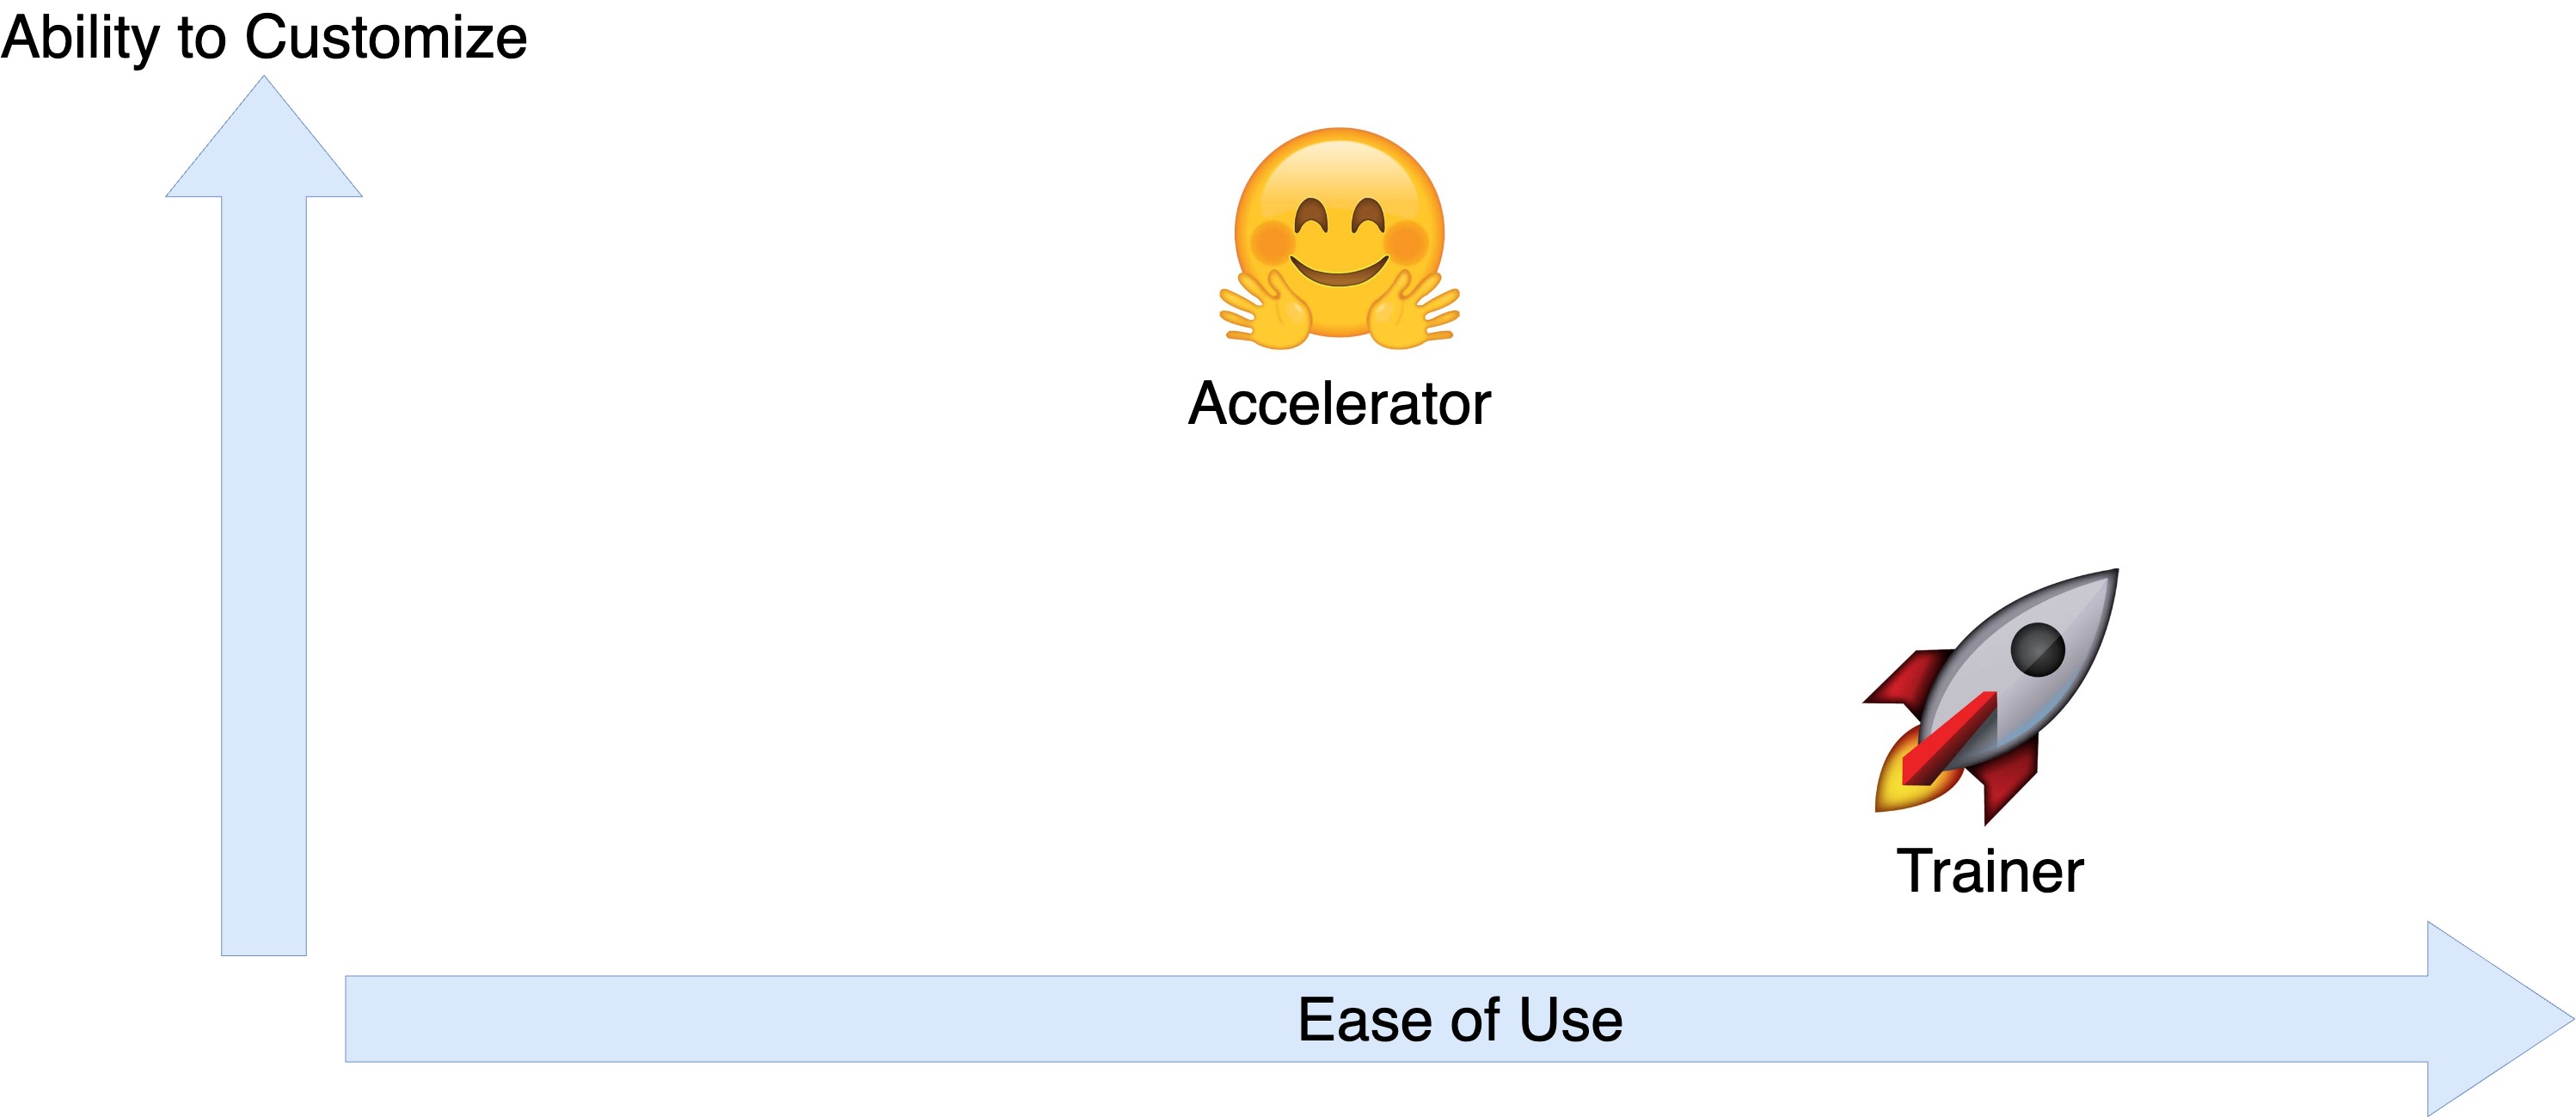
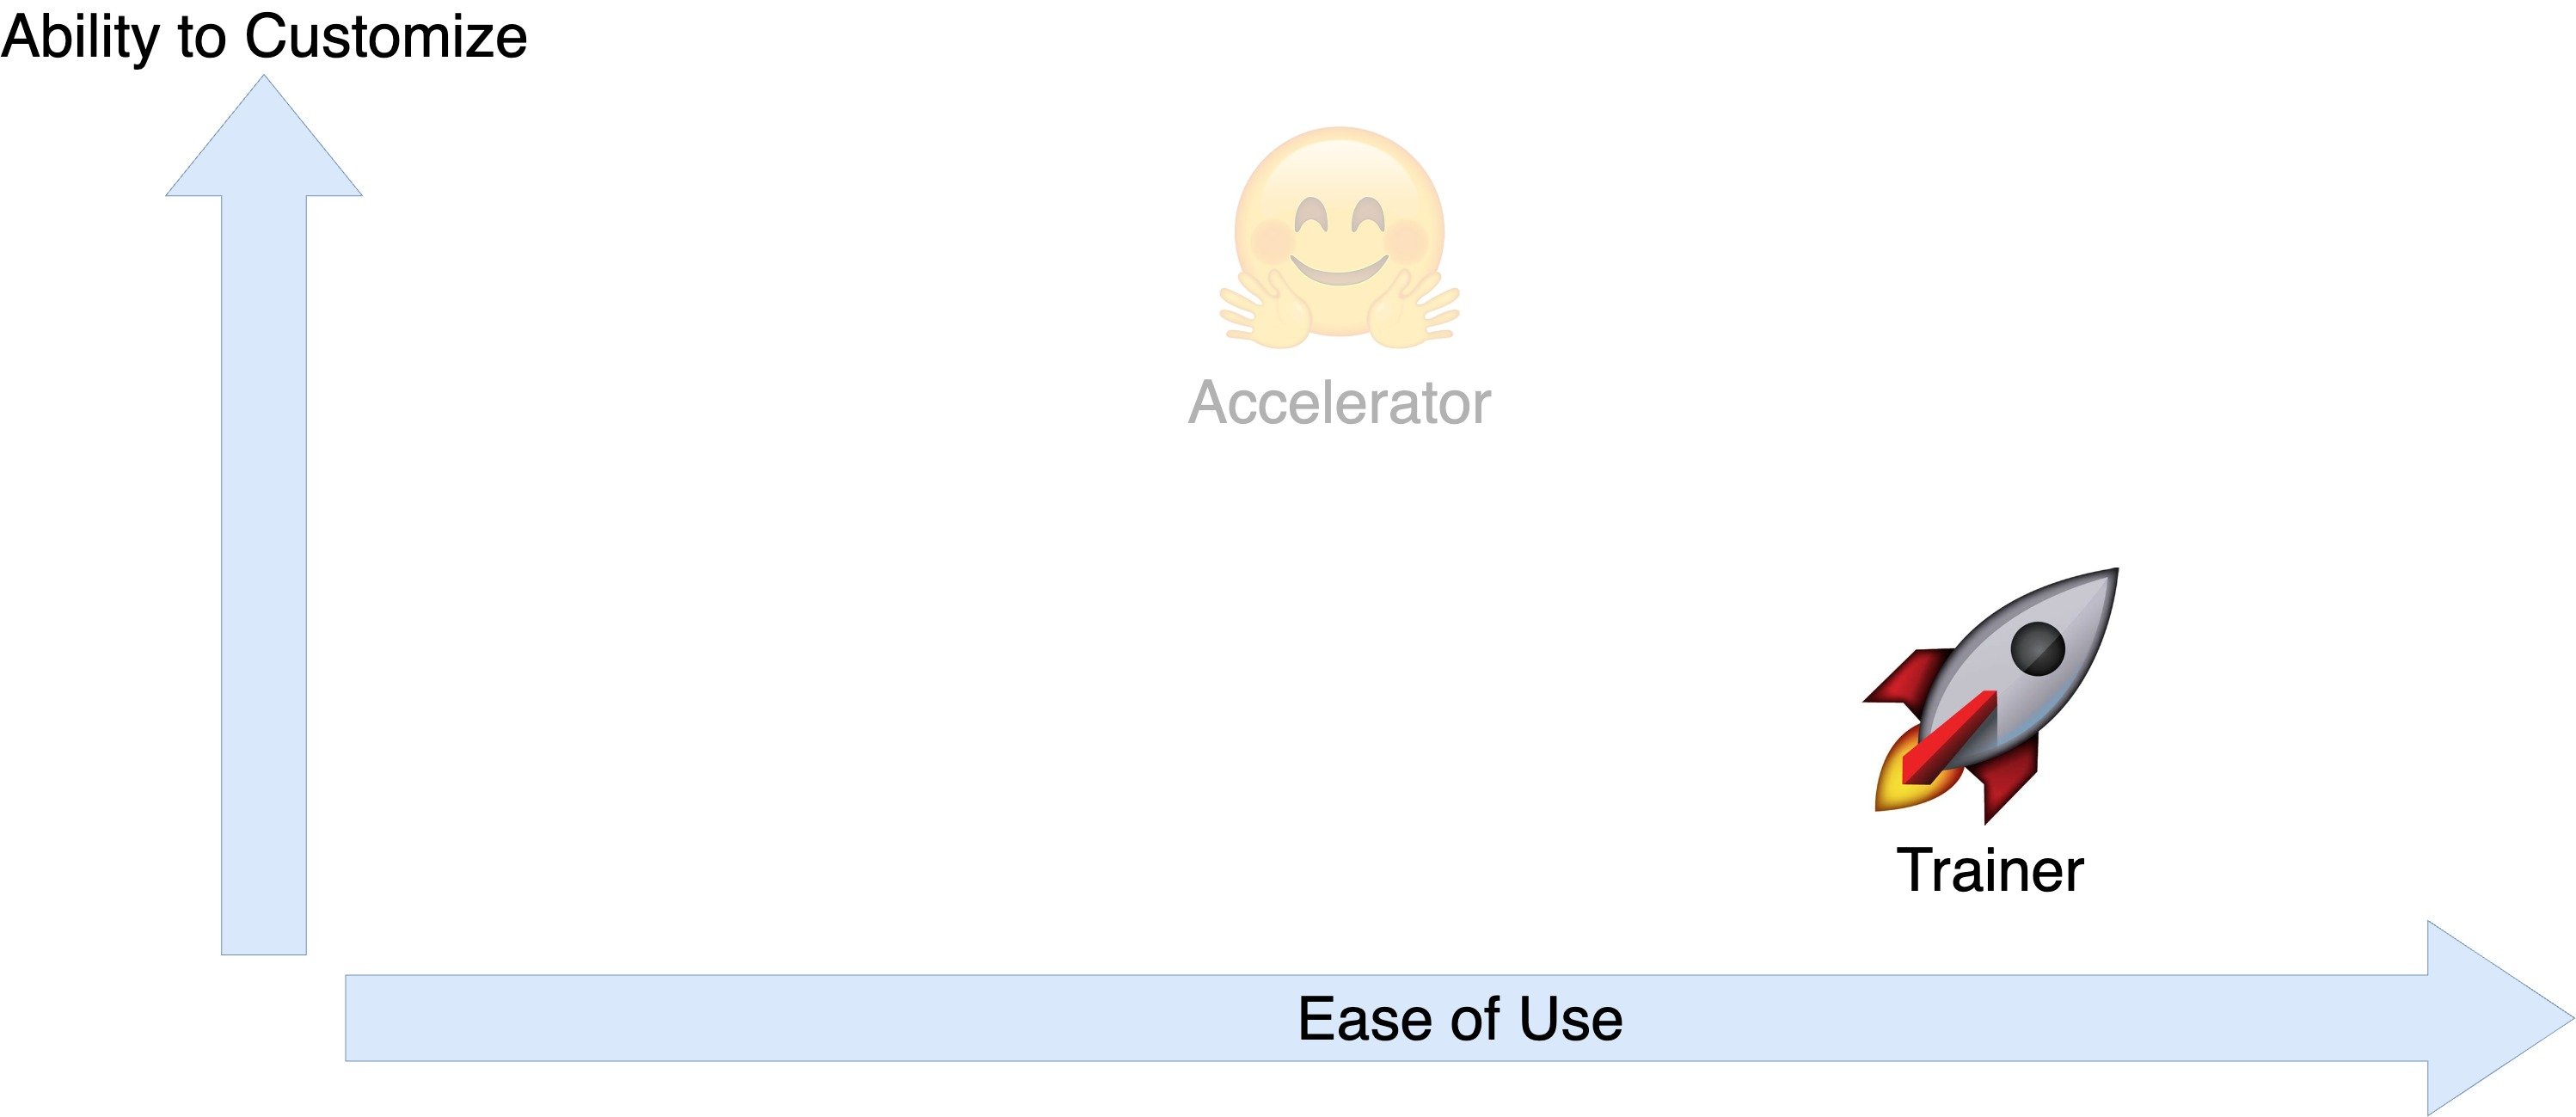
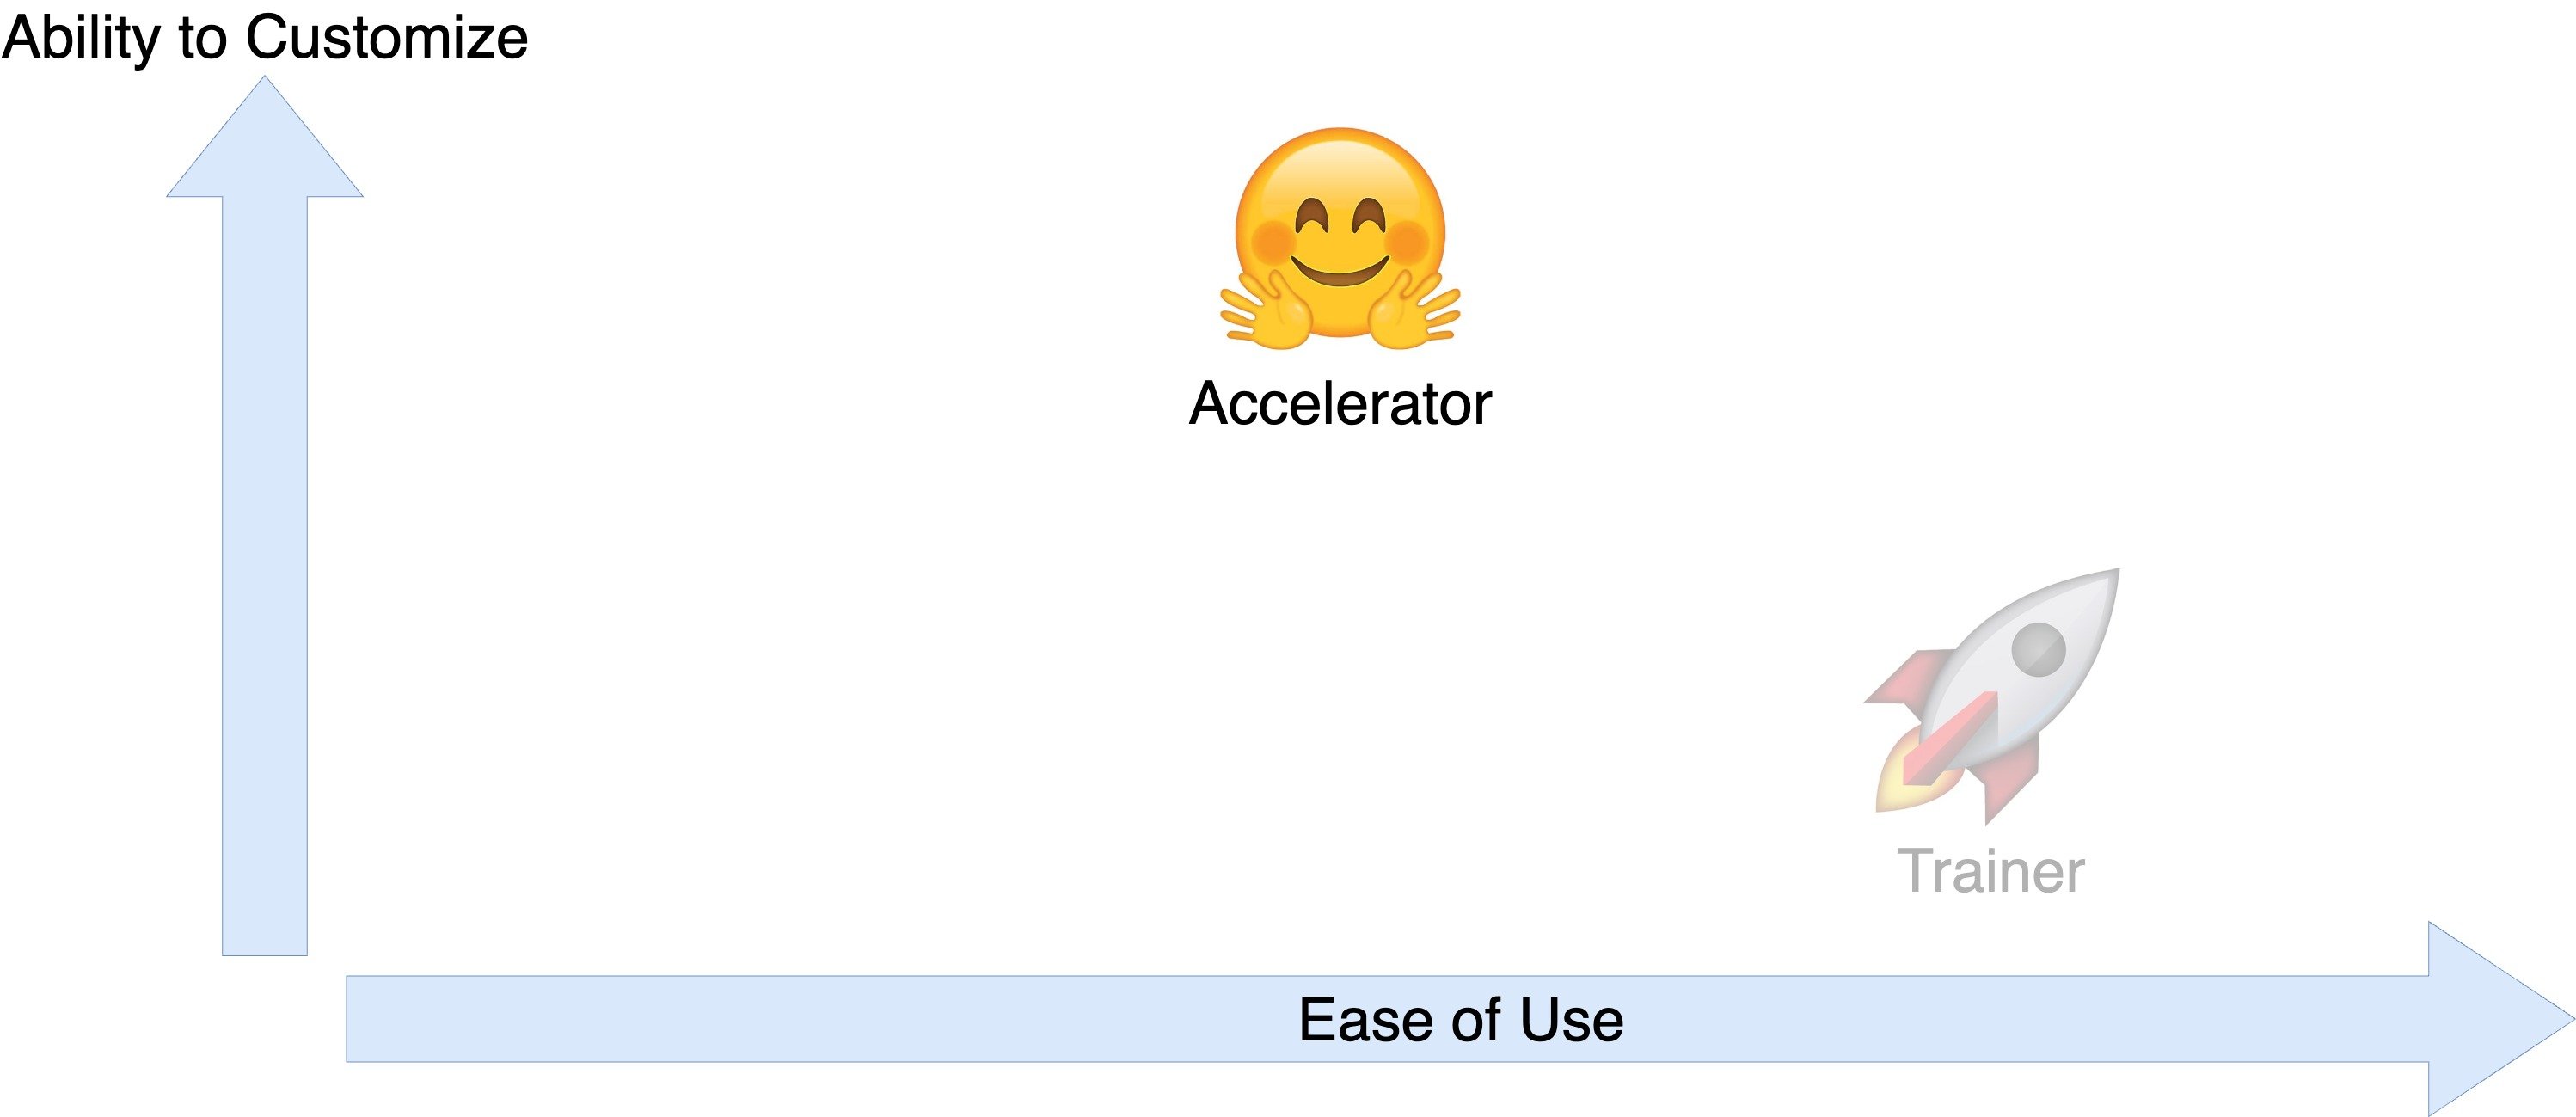
对比 Accelerator 与 Trainer 的易用性和可定制性。

使用 PyTorch 高效训练 AI 模型

Trainer 与 Accelerator

对比 Accelerator 与 Trainer 的易用性和可定制性。

使用 PyTorch 高效训练 AI 模型

在 Trainer 中使用梯度检查点

training_args = TrainingArguments(output_dir="./results",
                                  evaluation_strategy="epoch",
                                  gradient_accumulation_steps=4)


使用 PyTorch 高效训练 AI 模型

在 Trainer 中使用梯度检查点

training_args = TrainingArguments(output_dir="./results",
                                  evaluation_strategy="epoch",
                                  gradient_accumulation_steps=4,
                                  gradient_checkpointing=True)

trainer = Trainer(model=model, args=training_args, train_dataset=dataset["train"], eval_dataset=dataset["validation"], compute_metrics=compute_metrics)
trainer.train()
{'epoch': 1.0, 'eval_loss': 0.73, 'eval_accuracy': 0.03, 'eval_f1': 0.05}
使用 PyTorch 高效训练 AI 模型

从 Trainer 过渡到 Accelerator

对比 Accelerator 与 Trainer 的易用性和可定制性。

使用 PyTorch 高效训练 AI 模型

在 Accelerator 中使用梯度检查点

accelerator = Accelerator(gradient_accumulation_steps=2)


for index, batch in enumerate(dataloader):
    with accelerator.accumulate(model):
        inputs, targets = batch["input_ids"], batch["labels"]
        outputs = model(inputs, labels=targets)
        loss = outputs.loss
        accelerator.backward(loss)
        optimizer.step()
        lr_scheduler.step()
        optimizer.zero_grad()
使用 PyTorch 高效训练 AI 模型

在 Accelerator 中使用梯度检查点

accelerator = Accelerator(gradient_accumulation_steps=2)
model.gradient_checkpointing_enable()

for index, batch in enumerate(dataloader):
    with accelerator.accumulate(model):
        inputs, targets = batch["input_ids"], batch["labels"]
        outputs = model(inputs, labels=targets)
        loss = outputs.loss
        accelerator.backward(loss)
        optimizer.step()
        lr_scheduler.step()
        optimizer.zero_grad()
使用 PyTorch 高效训练 AI 模型

本地 SGD 提升通信效率


表示内存效率、通信效率和计算效率的图标。

使用 PyTorch 高效训练 AI 模型

什么是本地 SGD?

示意本地 SGD:在若干步后同步梯度的图。

  • 各设备并行计算梯度
使用 PyTorch 高效训练 AI 模型

什么是本地 SGD?

示意本地 SGD:在若干步后同步梯度的图。

  • 各设备并行计算梯度
  • 梯度同步:Driver 节点在各设备上更新模型参数
  • 本地 SGD:降低梯度同步频率
使用 PyTorch 高效训练 AI 模型

在 Accelerator 中使用本地 SGD


for index, batch in enumerate(dataloader):
    with accelerator.accumulate(model):
        inputs, targets = batch["input_ids"], batch["labels"]
        outputs = model(inputs, labels=targets)
        loss = outputs.loss
        accelerator.backward(loss)
        optimizer.step()
        lr_scheduler.step()
        optimizer.zero_grad()

使用 PyTorch 高效训练 AI 模型

在 Accelerator 中使用本地 SGD

from accelerate.local_sgd import LocalSGD

with LocalSGD(accelerator=accelerator, model=model, local_sgd_steps=8, 
              enabled=True) as local_sgd:
    for index, batch in enumerate(dataloader):
        with accelerator.accumulate(model):
            inputs, targets = batch["input_ids"], batch["labels"]
            outputs = model(inputs, labels=targets)
            loss = outputs.loss
            accelerator.backward(loss)
            optimizer.step()
            lr_scheduler.step()
            optimizer.zero_grad()

使用 PyTorch 高效训练 AI 模型

在 Accelerator 中使用本地 SGD

from accelerate.local_sgd import LocalSGD

with LocalSGD(accelerator=accelerator, model=model, local_sgd_steps=8, 
              enabled=True) as local_sgd:
    for index, batch in enumerate(dataloader):
        with accelerator.accumulate(model):
            inputs, targets = batch["input_ids"], batch["labels"]
            outputs = model(inputs, labels=targets)
            loss = outputs.loss
            accelerator.backward(loss)
            optimizer.step()
            lr_scheduler.step()
            optimizer.zero_grad()
            local_sgd.step()
使用 PyTorch 高效训练 AI 模型

Passons à la pratique !

使用 PyTorch 高效训练 AI 模型

Preparing Video For Download...